
Interviuri
Dr. Jaime Bland, Co-Fondator și CEO al Aquila Health – Seria de interviuri

 Adaugă Unite.AI la sursele tale preferate pe Google
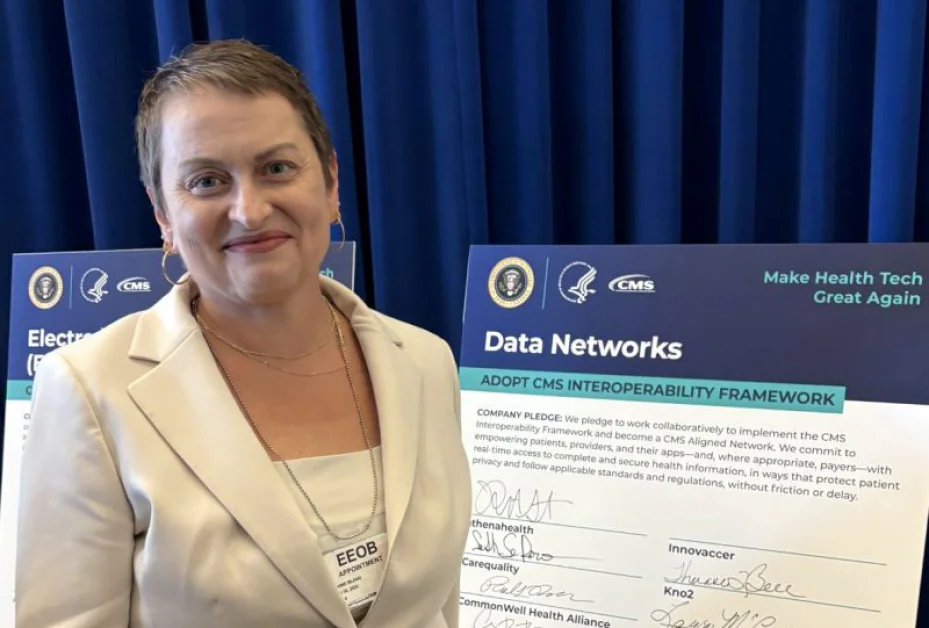
Dr. Jaime Bland, Co-Fondator și CEO al Aquila Health, este un lider în tehnologia sănătății, axat pe abordarea uneia dintre cele mai persistente provocări ale industriei: date fragmentate și inaccesibile. Ea a co-fondat Aquila Health pentru a construi o infrastructură de date unificată care să permită organizațiilor de sănătate să treacă dincolo de sistemele izolate, utilizând învățarea automată și analitica structurată pentru a genera informații acționabile, menținând în același timp supravegherea clinică. Lucrul ei se concentrează pe îmbunătățirea interoperabilității, pe facilitarea inteligenței sănătății la nivel de populație și pe sprijinirea detectării precoce a amenințărilor emergente la sănătate prin intermediul sistemelor integrate de date clinice, de revendicări și genomice.
Aquila Health este o platformă de date de sănătate condusă de inteligență artificială, proiectată pentru a uni surse de date disparate într-un singur sistem interoperabil care susține atât eficiența operațională, cât și analitica avansată. Platforma ingerează formate de date de sănătate de volum mare, cum ar fi HL7 și FHIR, permițând integrarea fără probleme între spitale, sisteme de sănătate publică și alte părți interesate. Prin combinarea abordărilor structurate de învățare automată cu un model de validare umană în buclă, Aquila se concentrează pe furnizarea de informații fiabile pentru managementul sănătății populației, detectarea anomaliilor și luarea deciziilor în timp real, mai degrabă decât să se bazeze exclusiv pe sistemele opace de inteligență artificială. Acest lucru plasează compania la intersecția dintre infrastructura de date și inteligența artificială aplicată, unde îmbunătățirea calității și accesibilității datelor este fundamentală pentru deblocarea întregului potențial al inteligenței sănătății.
Ați condus CyncHealth prin creștere masivă, extinzând interoperabilitatea la milioane de dosare de pacienți și multiple state, înainte de a fonda Aquila Health. Care au fost principalele limitări sau eșecuri sistemice pe care le-ați întâmpinat în această călătorie care v-au determinat să construiți Aquila de la zero?
La CyncHealth, am petrecut ani construind infrastructura pentru a conecta organizații de sănătate din Nebraska și Iowa. Am conectat peste 1.100 de locuri de îngrijire și milioane de dosare de pacienți, cuprinzând o populație de peste cinci milioane de vieți.
Ce am continuat să întâlnim, însă, a fost faptul că conectarea sistemelor și faptul de a face datele utilizabile sunt două probleme foarte diferite. De exemplu, am lucrat la crearea unui panou de supraveghere a supradozei de opioid care a coordonat datele pe care le-am primit de la multiple surse. A durat luni, cu sute de ore de lucru și coordonare între mulți stakeholderi, pentru a face acest singur punct de date inteligibil într-un context de sănătate publică și îngrijire a sănătății. Și, după toate acestea, imaginea a fost încă incompletă.
Această experiență a fost sămânța pentru Aquila. Modul tradițional de conectare a interfețelor fără a înțelege integritatea și calitatea datelor exportate nu va satisface nevoia odată cu progresele pe care le-am văzut în ultimii ani în ceea ce privește inteligența artificială. Când inteligența artificială poate realiza în câteva ore ceea ce obișnuia să dureze o echipă luni, și o face cu o calitate mai ridicată, la o fracțiune din cost, trebuie să folosiți această cunoaștere pentru a reconstrui dintr-o nouă fundație. Acesta este ceea ce am făcut cu Aquila, ne concentrăm pe instrumente moderne care reduc costul conectării, astfel încât să ne putem concentra pe finalizarea întregii imagini a sănătății, și nu doar pe datele derivate din sursele tradiționale de informații despre sănătate, ci pe imaginea completă.
Aquila a ieșit recent din faza de stealth cu o platformă axată pe unificarea datelor de sănătate fragmentate într-un singur strat pregătit pentru inteligență artificială. Care au fost principalele descoperiri tehnice care au făcut acest lucru posibil acum, în contrast cu doar câțiva ani în urmă?
Capacitățile de inteligență artificială au condus această schimbare aproape în întregime.
Am petrecut ani urmărind cum ingineri pricepuți reconciliau manual standardele de date, una câte una. A funcționat, dar acest model nu poate fi escaladat. Nu puteți angaja suficient de repede pentru a ține pasul cu volumul și varietatea datelor pe care le generează sănătatea.
Ceea ce este diferit acum este că inteligența artificială poate face munca de normalizare continuu la nivelul datelor, pe măsură ce informațiile trec prin sistem. Nu este un proces în lot care rulează peste noapte. Se întâmplă în timp real. Acest lucru schimbă ceea ce este posibil pentru clinicieni și echipele de sănătate publică, deoarece datele de care au nevoie sunt structurate și validate (rendite utilizabile) înainte de a ajunge la ele.
Clinicienii sunt obișnuiți să ia decizii fără imaginea completă a pacientului. Sănătatea publică este obișnuită să conducă programe fără date recente care să le susțină. Aquila schimbă peisajul și oferă viteza care face posibilă luarea deciziilor bazate pe date în întreaga sănătate.
Am construit TREUE™ ca fiind cadrul care organizează datele clinice derivate din registrele electronice de sănătate, laborator, sănătate publică, revendicări și date sociale într-o structură unificată. Inteligența artificială nu înlocuiește o bună guvernanță a datelor; o face scalabilă pentru prima dată.
V-ați concentrat pe faptul că adevărata provocare în inteligența artificială din sănătate nu este modelul în sine, ci datele. Care sunt cele mai critice lacune în infrastructura actuală de date de sănătate care împiedică inteligența artificială să furnizeze rezultate semnificative?
Industria discută despre modelul de inteligență artificială, dar modelul nu este partea grea.
Partea grea este că un pacient poate intra în trei unități medicale diferite într-o singură zi și poate apărea ca trei persoane diferite în trei sisteme diferite. Rezultatele de laborator nu se potrivesc cu notele clinice. Înregistrarea plătitorului are un identificator diferit decât înregistrarea spitalului, iar sănătatea publică utilizează un identificator complet diferit. Până când rezolvați toate acestea manual, fereastra clinică s-a închis.
Conexiunile tehnice puternice nu pot remedia înregistrări care sosesc incomplete sau în afara ordinii corecte. Inteligența artificială nu poate detecta un model care nu se află în date, și nu poate face o recomandare fiabilă dintr-un dosar care lipsește jumătate din informațiile istorice sau actuale pe care ar trebui să le conțină.
Lacuna nu este puterea de procesare, ci încrederea în datele subiacente. Acesta este ceea ce trebuie rezolvat mai întâi, și rezolvarea la scară este unde inteligența artificială poate să-și câștige într-adevăr locul.
Aquila se poziționează ca „stratul de pregătire a datelor” înainte de ingestia de inteligență artificială. Ne puteți ghida prin ceea ce face acest strat în practică, mai ales atunci când se confruntă cu intrări foarte eterogene, cum ar fi dosare clinice, date de revendicări și fluxuri în timp real?
Utilizând exemplul de mai devreme, luați în considerare ce sosește atunci când o întâlnire a pacientului generează date. Primim un mesaj HL7 de la spital, un dosar de revendicări de la asigurător, un rezultat de laborator de la un laborator de referință care utilizează un identificator diferit, și un raport de sănătate publică depus pe o cronologie complet diferită. Niciunul dintre acestea nu a fost proiectat pentru a fi reconciliat unul cu celălalt.
Stratul nostru de pregătire, TREUE™, este ceea ce stă între aceste intrări și orice aplicație de analitică sau inteligență artificială descendentă. Rolul său este să evalueze fiecare înregistrare pe măsură ce sosește, să se potrivească identităților între surse, să normalizeze formatele și să semnaleze ceea ce lipsește sau este inconsistent înainte ca datele să meargă mai departe.
În practică, acest lucru înseamnă că un clinician care examinează un pacient lucrează dintr-un dosar care a fost validat și aliniat între surse, mai degrabă decât să reconcilieze manual patru vederi diferite de sistem în timpul unei întâlniri de îngrijire. Pentru echipele de sănătate publică, acest lucru înseamnă că semnalele de izbucnire nu sunt întârziate de date care au sosit în formate diferite de la diferite jurisdicții.
Este vorba de lucrări de infrastructură. Nu este glamuros, dar nimic din ceea ce urmează nu funcționează fără asta.
Standardele de interoperabilitate, cum ar fi Resursele de Interoperabilitate Rapidă a Sănătății (FHIR) și Nucleul de Date al Sănătății din Statele Unite pentru Interoperabilitate (USCDI), au existat de ani de zile, însă fragmentarea persistă. Ce lipsește încă din perspectiva standardelor, și cum abordează Aquila aceste lacune într-un mod diferit?
FHIR și USCDI au oferit industriei un limbaj comun pentru schimbul de date. Acesta a fost un progres important.
Aici este lacuna: datele de sănătate nu provin dintr-un singur domeniu. Sistemele clinice, registrele de sănătate publică, laboratoarele și sursele de date sociale au fiecare cerințe de guvernanță, cronologii și definiții proprii pentru ceea ce înseamnă un câmp. FHIR nu spune cum să reconciliați un set de date de determinanți sociali cu un dosar clinic dintr-o altă jurisdicție.
Ceea ce adaugă TREUE™ este un cadru unificat pentru modul în care datele din toate aceste domenii pot fi organizate și validate împreună, respectând în același timp regulile de guvernanță care se aplică fiecărei surse. Rezultatul este date pe care le puteți analiza cu adevărat între domenii, și nu doar date care au fost transmise cu succes.
Aquila operează în medii cu consecințe ridicate, unde eșecul nu este o opțiune. Cum proiectați sisteme de inteligență artificială care echilibrează performanța în timp real cu cerințele stricte de guvernanță, auditabilitate și încredere?
Trebuie să construiți guvernanța în arhitectură înainte de a scrie prima linie de cod de aplicație. Nu ar trebui să fie un strat pe care îl adăugați ulterior.
În medii de sănătate și guvern, deciziile informate de aceste date afectează îngrijirea pacientului, răspunsul la izbucniri și modul în care resursele publice sunt alocate. Fiecare acțiune întreprinsă asupra datelor trebuie să fie trazabilă, iar accesul trebuie controlat strict. Sistemul trebuie să îndeplinească cerințele de conformitate ale mediilor în care operează.
Pentru Aquila, acest lucru înseamnă operarea într-o infrastructură de cloud de clasă guvernamentală, controlul accesului zero și practici de securitate aliniate cu standardele HIPAA și federale. Avem contracte active cu guverne de stat, agenții federale și organizații de sănătate, și aceste medii au cerințe de conformitate foarte diferite pe care platforma trebuie să le îndeplinească simultan.
Componenta umană în buclă este la fel de importantă. Inteligența artificială poate suprafețe semnale, dar experții clinici validează anomaliile înainte de a informa deciziile operaționale. Tehnologia face ca găsirea acestor semnale să fie mai rapidă. Nu înlocuiește judecata oamenilor care trebuie să acționeze asupra lor.
Platforma dvs. susține implementarea securizată a inteligenței artificiale pe dispozitiv și suveranitatea datelor. Cât de importantă devine descentralizarea în inteligența artificială din sănătate, mai ales având în vedere creșterea preocupărilor legate de confidențialitatea datelor și conformitatea regulamentară?
Devine esențială, și cred că industria abia începe să înțeleagă de ce.
Organizațiile de sănătate operează sub obligații stricte de confidențialitate. Datele sensibile ale pacienților nu pot fi centralizate și procesate într-un mediu partajat. Statele diferite au reguli diferite. Agențiile federale au reguli diferite. Datele internaționale de sănătate au un alt set de constrângeri. Orice arhitectură care necesită mutarea datelor sensibile într-o locație centrală va lovi repetat aceste obstacole.
Direcția care funcționează cu adevărat este generarea de informații mai aproape de locul în care datele deja există. Organizațiile pot contribui la analize partajate fără a ceda controlul asupra datelor lor subiacente. Acesta este ceea ce permit modelele federate.
Platforma noastră este construită pentru a opera într-un astfel de mediu reglementat și descentralizat – guvernanța care călătorește cu datele, mai degrabă decât a fi aplicată într-un singur punct. Este o arhitectură mai greu de construit, dar este cea care este de fapt compatibilă cu modul în care guvernanța datelor de sănătate funcționează în practică.
Multi startup-uri de inteligență artificială se bazează puternic pe modelele de cutie neagră, în timp ce Aquila incorporează validarea umană în buclă. Unde trageți linia între automatizare și supraveghere umană în sistemele clinice de inteligență artificială?
Am început cariera mea ca asistentă medicală. Această experiență mă face să gândesc despre unde se află inteligența artificială într-un mediu clinic și unde nu.
Inteligența artificială este foarte bună la găsirea de modele în seturi de date mari. Nu este bună la a ști ce înseamnă un model pentru un anumit pacient cu o anumită istorie într-un anumit context comunitar. Acesta este încă un apel de judecată umană.
Rolul corect al inteligenței artificiale în sistemele clinice este de a suprafețe semnale pe care un om le-ar putea pierde la volum, și nu de a înlocui raționamentul clinic care urmează. La Aquila, anomaliile și informațiile semnalizate de sistem merg la clinicieni și experți în domeniu pentru revizuire înainte de a informa deciziile operaționale. Tehnologia vă spune unde să căutați, și profesionistul vă spune ce înseamnă.
Unde cred că se află linia: automatizați detectarea, păstrați interpretarea cu oamenii care sunt responsabili pentru rezultat.
Aquila lucrează în sănătate publică, sisteme guvernamentale și industrii reglementate. Cum diferă cerințele pentru infrastructura de inteligență artificială între aceste medii comparativ cu implementările tradiționale de inteligență artificială din întreprinderi?
Într-o implementare tradițională de inteligență artificială a unei întreprinderi, de obicei lucrați în cadrul unui singur mediu de date al organizației, un set de reguli de guvernanță, un cadru de conformitate.
Mediile de sănătate publică și guvernamentale sunt structural diferite. Sunteți coordonator între multiple jurisdicții, multiple agenții, multiple medii clinice, care funcționează pe cronologii de raportare diferite și sub cadre legale diferite. Un spital într-un stat, o agenție de sănătate publică într-un alt stat, un program federal cu cerințe de date proprii. Toate acestea trebuie să schimbe date și să genereze informații fără ca vreo entitate să aibă acces necontrolat la înregistrările celeilalte.
Infrastructura trebuie să susțină procesarea de volum mare, menținând în același timp auditabilitatea strictă între toate aceste limite. Trebuie să se integreze cu formatele de mesagerie medicale legacy, deoarece aceste sisteme nu dispar. Și trebuie să funcționeze fiabil în medii în care downtime-ul nu este doar o problemă de afaceri, ci și una de siguranță a pacientului.
Această complexitate este motivul pentru care am început Aquila cu aceste medii, mai degrabă decât cu piața tradițională de întreprinderi. Dacă puteți construi o infrastructură care funcționează aici, funcționează peste tot.
Capacitățile de inteligență artificială continuă să progreseze mai repede decât cadrul de guvernanță. Care sunt responsabilitățile fondatorilor și constructorilor de platforme pentru a asigura că aceste sisteme sunt implementate în mod etic și sigur de la început?
Cred că responsabilitatea este una simplă, chiar dacă îndeplinirea ei nu este.
Dacă construiți inteligență artificială care afectează decizii clinice sau rezultate ale sănătății publice, nu puteți trata guvernanța ca pe un articol dintr-un plan de produs pe care îl veți aborda în cele din urmă. Trebuie să fie proiectată de la început.
Ce înseamnă acest lucru în practică: fiecare acțiune asupra datelor trebuie să fie auditabilă. Modelele trebuie să fie suficient de interpretabile, astfel încât un clinician să poată înțelege de ce a fost semnalizată o anomalie. Experții clinici trebuie să facă parte din procesul de revizuire, nu doar o gândire ulterioară. Și organizația trebuie să fie onestă cu privire la ceea ce sistemul poate și nu poate face în mod fiabil.
Am petrecut cariera mea în medii în care eșecurile datelor au consecințe reale pentru oameni reali. Acest lucru mă face să gândesc despre asta. Capabilitățile sunt în evoluție rapidă, și răspunderea pentru modul în care sunt implementate nu trebuie să fie lăsată în urmă. Fondatorii care construiesc aceste sisteme trebuie să țină acest standard pentru ei înșiși, nu să aștepte ca reglementarea să-l impună.
Mulțumim pentru discuția plină de insight. Citiitorii interesați să exploreze platforma și abordarea sa față de infrastructura de date de sănătate pot afla mai multe vizitând Aquila Health.




