Unghiul lui Anderson
Matrițare AI a imaginilor care înțelege scenele

 Adaugă Unite.AI la sursele tale preferate pe Google
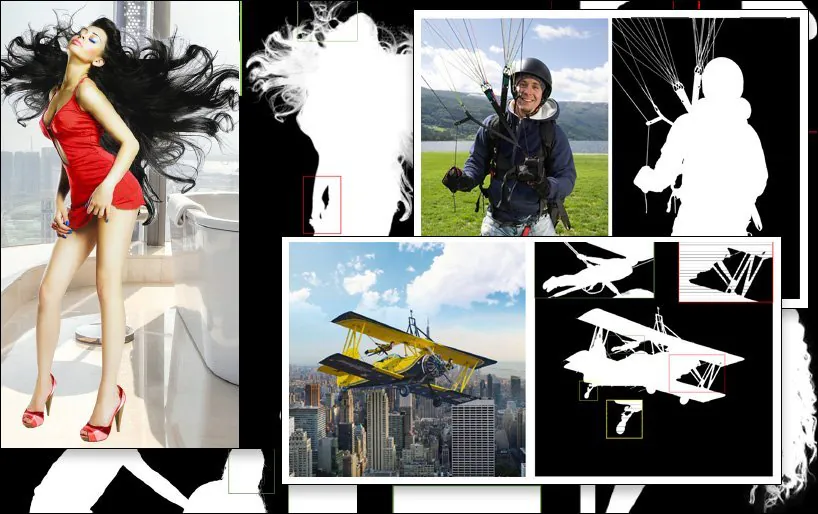
În documentarul extra care însoțește lansarea pe DVD din 2003 a filmului Alien3 (1992), legenda efectelor vizuale Richard Edlund a amintit cu groază „lupta de sumo” a extracției fotochimice a matrițelor, care a dominat munca în efecte vizuale între sfârșitul anilor 1930 și sfârșitul anilor 1980. Edlund a descris natura aleatorie a procesului ca „luptă de sumo”, în comparație cu tehnicile digitale de ecran albastru/verde care au preluat în primii ani 1990 (și el a revenit la această metaforă de atunci).
Extracția unui element din prim‑plan (cum ar fi o persoană sau un model de navă spațială) dintr-un fundal, pentru ca imaginea decupată să poată fi compusă pe o placă de fundal, se realiza inițial prin filmarea obiectului din prim‑plan în fața unui fundal uniform albastru sau verde.
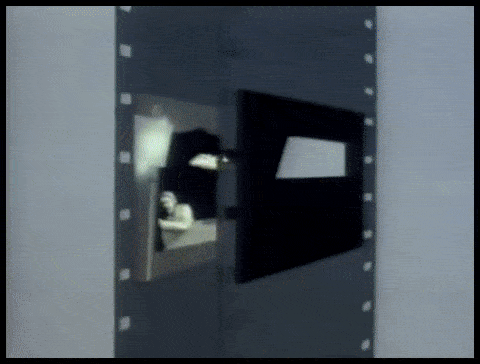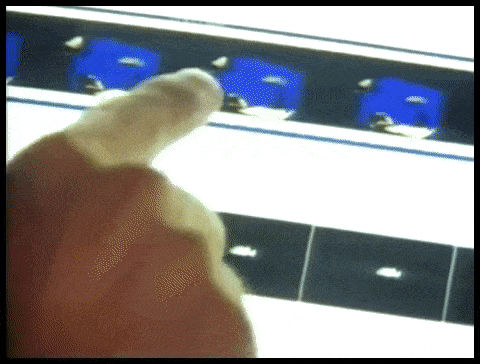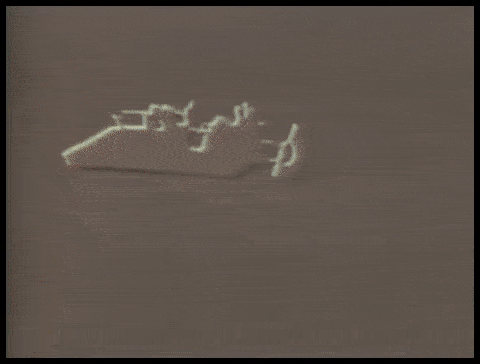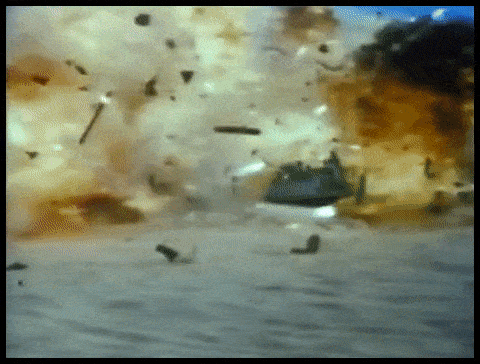
Procese laborioase de extracție fotochimică pentru o scenă VFX realizată de ILM pentru „Return of the Jedi” (1983).
În materialul rezultat, culoarea fundalului era apoi izolată chimic și folosită ca șablon pentru a tipări din nou obiectul din prim‑plan (sau persoana) într-un printer optic ca un obiect „plutitor” într-o celulă de film altfel transparentă.
Procesul era cunoscut sub denumirea de suprapunere de separare a culorii (CSO) – deși acest termen a ajuns în cele din urmă asociat mai mult cu efectele video rudimentare de ‘Chromakey’ din producțiile TV cu bugete reduse din anii 1970 și 1980, realizate cu mijloace analogice în loc de chimice sau digitale.

O demonstrație a suprapunerii de separare a culorii în 1970 pentru emisiunea britanică pentru copii „Blue Peter”. Source: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
În orice caz, fie pentru elemente de film, fie pentru video, materialul extras putea fi inserat în orice alt material.
Deși procesul de vapori de sodiu, mult mai scump și proprietar, al Disney procesul de vapori de sodiu (care se bază pe galben, în mod specific, și a fost de asemenea folosit pentru filmul horror al lui Alfred Hitchcock din 1963, The Birds) oferea o definiție mai bună și matrițe mai clare, extracția fotochimică rămânea anevoioasă și nesigură.

Procesul proprietar de extracție prin vapori de sodiu al Disney necesita fundaluri apropiate de capătul galben al spectrului. Aici, Angela Lansbury este suspendată de fire în timpul producției unei secvențe încărcate cu VFX pentru „Bedknobs and Broomsticks” (1971). Sursă Source
Dincolo de matrițarea digitală
În anii 1990, revoluția digitală a renunțat la chimicale, dar nu la necesitatea ecranelor verzi. Acum era posibil să se elimine fundalul verde (sau orice altă culoare) căutând pixelii în cadrul unei game de toleranță a acelei culori, în programe de editare a pixelilor precum Photoshop, și într-o nouă generație de suite de compoziție video care puteau elimina automat fundalurile colorate. Practic peste noapte, șaizeci de ani de istorie a industriei de imprimare optică au fost lăsate în trecut.
Ultimii zece ani de cercetare în vedere computerizată accelerată de GPU deschid extragerea matrițelor către o a treia eră, provocând cercetătorii să dezvolte sisteme capabile să extragă matrițe de înaltă calitate fără necesitatea ecranelor verzi. Pe Arxiv, lucrările legate de inovațiile în extragerea prim‑planului bazate pe învățarea automată apar săptămânal.
Punându-ne în imagine
Acest punct de interes academic și industrial în extracția AI a influențat deja spațiul consumatorului: implementări brute, dar funcționale, ne sunt familiare sub forma filtrelor Zoom și Skype care pot înlocui fundalurile din sufrageria noastră cu insule tropicale etc., în apelurile de videoconferință.
Totuși, cele mai bune matrițe necesită în continuare un ecran verde, așa cum a menționat Zoom miercuri trecută.

Stânga, un bărbat în fața unui ecran verde, cu părul bine extras prin funcția de fundal virtual al Zoom. Dreapta, o femeie în fața unei scene domestice obișnuite, cu părul extras algoritmic, mai puțin precis și cu cerințe de calcul mai mari. Sursă: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image Source: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Un altă postare de pe platforma de suport Zoom avertizează că extragerea fără ecran verde necesită, de asemenea, o putere de calcul mai mare în dispozitivul de captare.
Nevoia de a elimina fundalul
Îmbunătățirile în calitate, portabilitate și economie de resurse pentru sistemele de extragere a matrițelor „în sălbăticie” (adică izolarea persoanelor fără necesitatea ecranelor verzi) sunt relevante pentru mult mai multe sectoare și domenii decât doar filtrele de videoconferință.
Pentru dezvoltarea seturilor de date, recunoașterea facială, a capului complet și a corpului întreg îmbunătățită oferă posibilitatea de a se asigura că elementele de fundal inutile nu sunt antrenate în modelele de vedere computerizată ale subiecților umani; o izolare mai precisă ar îmbunătăți semnificativ tehnicile de segmentare semantică concepute pentru a distinge și asimila domenii (de ex. „pisică”, „persoană”, „barcă”), și ar îmbunătăți sistemele de sinteză a imaginii bazate pe VAE și pe transformere, cum ar fi noul DALL‑E 2 de la OpenAI; iar algoritmi de extragere mai buni ar reduce necesitatea rotoscopiei manuale costisitoare rotoscoping în lanțurile de producție VFX scumpe.
De fapt, ascensiunea metodologiilor multimodale (de obicei text/imagine), unde un domeniu precum „pisică” este codificat atât ca imagine, cât și cu referințe text asociate, pătrunde deja în procesarea imaginilor. Un exemplu recent este arhitectura Text2Live, care folosește antrenament multimodal (text/imagine) pentru a crea videoclipuri, printre nenumărate alte posibilități, de exemplu lebede de cristal și girafe de sticlă.
Matrițare AI conștientă de scenă
O mare parte a cercetărilor privind matrițarea automată bazată pe AI s-a concentrat pe recunoașterea limitelor și evaluarea grupărilor de pixeli dintr-o imagine sau cadru video. Totuși, noi cercetări din China propun un flux de extracție care îmbunătățește delimitarea și calitatea matriței prin valorificarea descrierilor bazate pe text ale unei scene (o abordare multimodală care a căpătat tracțiune în sectorul de cercetare în vedere computerizată în ultimii 3‑4 ani), pretinzând că a îmbunătățit metodele anterioare în mai multe moduri.

Un exemplu de extracție SPG‑IM (ultima imagine, în dreapta jos), comparat cu metodele anterioare concurente. Source: https://arxiv.org/pdf/2204.09276.pdf Source: https://arxiv.org/pdf/2204.09276.pdf
Provocarea pentru sub‑sectorul de cercetare în extracție este să producă fluxuri de lucru care necesită un minim absolut de adnotare manuală și intervenție umană – ideal, niciuna. Pe lângă implicațiile de cost, cercetătorii din noul articol observă că adnotările și segmentările manuale realizate de lucrători externalizați din diverse culturi pot face ca imaginile să fie etichetate sau chiar segmentate în moduri diferite, conducând la algoritmi inconsistenți și nesatisfăcători.
Un exemplu al acestui lucru este interpretarea subiectivă a ceea ce definește un „obiect din prim‑plan”:

Din noul articol: metodele anterioare LFM și MODNet („GT” semnifică Ground Truth, un rezultat „ideal” adesea obținut manual sau prin metode non‑algoritmice), au abordări diferite și variabil eficiente ale definiției conținutului din prim‑plan, în timp ce noua metodă SPG‑IM delimitează mai eficient „conținutul apropiat” prin contextul scenei.
Pentru a aborda această problemă, cercetătorii au dezvoltat un flux în două etape intitulat Situational Perception Guided Image Matting (SPG‑IM). Arhitectura encoder/decoder în două etape cuprinde Situational Perception Distillation (SPD) și Situational Perception Guided Matting (SPGM).

Arhitectura SPG‑IM.
Mai întâi, SPD pre‑antrenează transformările de caracteristici vizual‑textuale, generând descrieri adecvate pentru imaginile asociate. După aceasta, predicția măștii din prim‑plan este activată prin conectarea fluxului la o tehnică nouă de predicție a salienței.
Apoi, SPGM generează o matriță alfa estimată pe baza imaginii brute RGB de intrare și a măștii generate în primul modul.
Obiectivul este ghidarea prin percepție situațională, în care sistemul are o înțelegere contextuală a conținutului imaginii, permițându-i să încadreze – de exemplu – provocarea de a extrage părul complex dintr-un fundal, pe baza caracteristicilor cunoscute ale unei astfel de sarcini specifice.

În exemplul de mai jos, SPG‑IM înțelege că corzile sunt intrinseci unui „parasut”, unde MODNet nu reușește să păstreze și să definească aceste detalii. De asemenea, în exemplul de mai sus, structura completă a echipamentului de joacă este pierdută arbitrar în MODNet.
Noul articol poartă titlul Situational Perception Guided Image Matting și provine de la cercetătorii de la OPPO Research Institute, PicUp.ai și Xmotors.
Matrițe automate inteligente
SPG‑IM oferă, de asemenea, un Rețea de rafinare Adaptive Focal Transformation (AFT) care poate procesa detaliile locale și contextul global separat, facilitând „matrițe inteligente”.

Înțelegerea contextului scenei, în acest caz „fată cu cal”, poate facilita extragerea prim‑planului mai mult decât metodele anterioare.
‘Credem că reprezentările vizuale din sarcina vizual‑textuală, de ex. generarea de descrieri pentru imagini, se concentrează pe semnale semantice mai cuprinzătoare între a) obiect la obiect și b) obiect la mediul înconjurător, pentru a genera descrieri care pot acoperi atât informațiile globale, cât și detaliile locale. În plus, comparativ cu adnotarea costisitoare a pixelilor pentru matrițarea imaginilor, etichetele textuale pot fi colectate masiv la un cost foarte scăzut.’
Ramura SPD a arhitecturii este antrenată în comun cu decodorul textual bazat pe transformere VirTex al Universității din Michigan, care învață reprezentări vizuale din descrieri dens semantice.

VirTex antrenează în comun o rețea ConvNet și Transformere prin cupluri imagine‑descriere și transferă informațiile obținute către sarcini de vedere computerizată ulterioare, cum ar fi detectarea obiectelor. Source: https://arxiv.org/pdf/2006.06666.pdf Source: https://arxiv.org/pdf/2006.06666.pdf
Printre alte teste și studii de ablație, cercetătorii au comparat SPG‑IM cu metodele de ultimă generație bazate pe trimap Deep Image Matting (DIM), IndexNet, Matrițare de imagine conștientă de context (CAM), Atenție contextuală ghidată (GCA), FBA și Cartografiere semantică a imaginii (SIM).
Alte cadre anterioare testate au inclus abordări fără trimap LFM, HAttMatting și MODNet. Pentru o comparație corectă, metodele de testare au fost adaptate în funcție de metodologiile diferite; unde codul nu a fost disponibil, tehnicile din articol au fost reproduse din arhitectura descrisă.
‘SPG‑IM-ul nostru depășește cu mult toate metodele concurente fără trimap ([LFM], [HAttMatting] și [MODNet]). În același timp, modelul nostru arată o superioritate remarcabilă față de metodele de ultimă generație (SOTA) bazate pe trimap și ghidate prin mască, în ceea ce privește toate cele patru metrici pe seturile de date publice (adică Composition‑1K, Distinction‑646 și Human‑2K), și benchmark‑ul nostru Multi‑Object‑1K.’
‘Se poate observa în mod evident că metoda noastră păstrează detalii fine (de ex. vârfurile firelor de păr, texturi transparente și contururi) fără ghidarea unui trimap. În plus, comparativ cu alte modele concurente fără trimap, SPG‑IM-ul nostru poate menține o completitudine semantică globală superioară.’


Publicat prima dată pe 24 aprilie 2022.