Unghiul lui Anderson
O metodă de date forensice pentru o nouă generație de deepfakes

 Adaugă Unite.AI la sursele tale preferate pe Google

Deși crearea de deepfakes pentru persoane private a devenit o problemă publică crescândă și este din ce în ce mai mult interzisă în diferite regiuni, dovedirea faptului că un model creat de utilizator – cum ar fi unul care permite revenge porn – a fost special antrenat pe imagini ale unei anumite persoane rămâne extrem de dificilă.
Pentru a pune problema în context: un element cheie al unui atac de deepfake este acela de a pretinde în mod fals că o imagine sau un videoclip înfățișează o anumită persoană. Simplul fapt de a afirma că cineva dintr-un videoclip este identitatea #A, și nu doar un lookalike, este suficient pentru a crea prejudicii, și nu este necesară nicio inteligență artificială în acest scenariu.
Însă, dacă un atacator generează imagini sau videoclipuri cu ajutorul unor modele antrenate pe date reale ale unei persoane, sistemele de recunoaștere a feței de pe rețelele sociale și motoarele de căutare vor asocia automat conținutul fals cu victima – fără a necesita nume în postări sau metadate. Imaginile și videoclipurile generate de inteligența artificială singure asigură asocierea.
Cu cât aspectul unei persoane este mai distinct, cu atât devine mai inevitabil, până când conținutul fabricat apare în căutări de imagini și, în final, ajunge la victimă.
Față în față
Cel mai comun mod de a disemina modele axate pe identitate este în prezent prin Adaptare de rang scăzut (LoRA), în care utilizatorul antrenează un număr mic de imagini timp de câteva ore împotriva greutăților unui model de bază mult mai mare, cum ar fi Stable Diffusion (pentru imagini statice, în mare parte) sau Hunyuan Video, pentru deepfakes video.
Cele mai comune ținte ale LoRAs, inclusiv noua generație de LoRAs video, sunt celebritățile feminine, ale căror faimă le expune la acest tip de tratament cu mai puțină critică publică decât în cazul victimelor “necunoscute”, din cauza presupunerii că astfel de lucrări derivate sunt acoperite de “utilizare corectă” (cel puțin în SUA și Europa).

Celebritățile feminine domină listările LoRA și Dreambooth de pe portalul civit.ai. Cel mai popular LoRA actual are peste 66.000 de descărcări, ceea ce este considerabil, având în vedere că această utilizare a inteligenței artificiale este încă considerată o “activitate de nișă”.
Nu există un astfel de forum public pentru victimele non-celebrități ale deepfaking-ului, care apar în mass-media doar atunci când se desfășoară procese de urmărire penală sau când victimele vorbesc în reviste populare.
Însă, în ambele scenarii, modelele utilizate pentru a falsifica identitățile au “distilat” datele de antrenare atât de complet în spațiul latent al modelului, încât este dificil de identificat imaginile sursă care au fost utilizate.
Dacă ar fi posibil să se facă acest lucru într-un interval de eroare acceptabil, acest lucru ar permite urmărirea penală a celor care distribuie LoRAs, deoarece nu doar demonstrează intenția de a falsifica o anumită identitate (adică, cea a unei persoane “necunoscute”, chiar dacă malefactorul nu o numește în timpul procesului de defăimare), ci și expune încărcătorul la acuzații de încălcare a drepturilor de autor, acolo unde este aplicabil.
Ulterior, acest lucru ar fi util în jurisdicțiile în care reglementarea legală a tehnologiilor de deepfaking este lipsită sau în urmă.
Supraexpus
Obiectivul antrenării unui model de bază, cum ar fi modelul de bază de mai multe gigabiți pe care un utilizator ar putea să-l descarce de la Hugging Face, este ca modelul să devină bine generalizat și ductil. Acest lucru implică antrenarea pe un număr adecvat de imagini diverse și cu setări adecvate, și terminarea antrenării înainte ca modelul să “supraantreneze” datele.
Un model supraantrenat a văzut datele de atâtea ori (excesiv) în timpul procesului de antrenare, încât va tenda să reproducă imagini foarte asemănătoare, expunând astfel sursa datelor de antrenare.

Identitatea ‘Ann Graham Lotz’ poate fi reprodusă aproape perfect în modelul Stable Diffusion V1.5. Reconstrucția este aproape identică cu datele de antrenare (din imaginea de sus). Source: https://arxiv.org/pdf/2301.13188
Însă, modelele supraantrenate sunt de obicei abandonate de creatorii lor, mai degrabă decât distribuite, deoarece sunt, în orice caz, inadecvate pentru scopul propus. Prin urmare, acesta este un “avantaj” forensic puțin probabil. În orice caz, principiul se aplică mai mult antrenării scumpe și de volum mare a modelelor de bază, unde mai multe versiuni ale aceleiași imagini care au pătruns într-un set de date uriaș pot face ca anumite imagini de antrenare să fie ușor de invocat (a se vedea imaginea și exemplul de mai sus).
Lucrurile stau puțin diferit în cazul modelelor LoRA și Dreambooth (deși Dreambooth a căzut în dizgrație din cauza dimensiunilor sale mari de fișier). Aici, utilizatorul selectează un număr foarte limitat de imagini diverse ale unui subiect și le utilizează pentru a antrena un LoRA.

În stânga, ieșirea unui LoRA Hunyuan Video. În dreapta, datele care au făcut posibilă asemănarea (imagini utilizate cu permisiunea persoanei reprezentate).
Adesea, LoRA va avea un cuvânt-cheie antrenat, cum ar fi [numele celebrității]. Însă, foarte des, subiectul special antrenat va apărea în ieșirile generate chiar și fără astfel de prompturi, deoarece chiar și un LoRA bine echilibrat (adică, nu supraantrenat) este oarecum “fixat” pe materialul pe care a fost antrenat și va tenda să-l includă în orice ieșire.
Această predispoziție, combinată cu numărul limitat de imagini care sunt optime pentru un set de date LoRA, expun modelul la analiză forensică, așa cum vom vedea.
Demascarea datelor
Aceste chestiuni sunt abordate într-un nou articol din Danemarca, care oferă o metodologie pentru a identifica imaginile sursă (sau grupurile de imagini sursă) într-un atac de inferență a apartenenței (MIA) într-un mediu “cutie neagră”. Tehnica implică, printre altele, utilizarea unor modele antrenate special pentru a ajuta la expunerea datelor sursă prin generarea propriilor “deepfakes”:

Exemple de imagini “false” generate de abordarea nouă, la niveluri din ce în ce mai mari de îndrumare a clasificatorului (CFG), până la punctul de distrugere. Source: https://arxiv.org/pdf/2502.11619
Deși lucrarea, intitulată Atacuri de inferență a apartenenței pentru imagini cu fețe împotriva modelelor de difuzie latentă fine-tunate, este o contribuție interesantă și importantă la literatura din jurul acestui subiect, este și un articol inaccesibil și scris într-un stil ters, care necesită o decodificare considerabilă. Prin urmare, vom acoperi cel puțin principiile de bază din spatele proiectului aici, și o selecție a rezultatelor obținute.
În esență, dacă cineva fine-tunează un model de inteligență artificială pe imaginea dvs., metoda autorilor poate ajuta la demonstrarea acestui fapt, prin căutarea unor semne distinctive de memorizare în imaginile generate de model.
În primul rând, un model de inteligență artificială țintă este fine-tuneat pe un set de date de imagini cu fețe, făcându-l mai probabil să reproducă detalii din aceste imagini în ieșirile sale. Ulterior, un mod de atac al clasificatorului este antrenat utilizând imagini generate de inteligență artificială de la modelul țintă ca “exemple pozitive” (suspectate de a fi membre ale setului de date) și alte imagini dintr-un set de date diferit ca “exemple negative” (non-membre).
Prin învățarea diferențelor subtile dintre aceste grupuri, modelul de atac poate prezice dacă o imagine dată a fost parte a setului de date utilizat pentru fine-tuningul modelului țintă.
Atacul este cel mai eficient în cazurile în care modelul de inteligență artificială a fost fine-tuneat pe scară largă, ceea ce înseamnă că, cu cât un model este specializat, cu atât este mai ușor de detectat dacă anumite imagini au fost utilizate. Acest lucru se aplică în general modelelor LoRA proiectate pentru a recrea celebrități sau persoane private.
Autorii au descoperit, de asemenea, că adăugarea de filigrane vizibile la imaginile de antrenare face detectarea și mai ușoară – deși filigranele ascunse nu ajută prea mult.
În mod remarcabil, abordarea este testată într-un mediu “cutie neagră”, ceea ce înseamnă că funcționează fără acces la detaliile interne ale modelului, doar la ieșirile sale.
Metoda obținută este computațional intensivă, așa cum recunosc autorii; cu toate acestea, valoarea acestei lucrări constă în indicarea direcției pentru cercetări suplimentare și în demonstrarea faptului că datele pot fi extrase în mod realist la o toleranță acceptabilă; prin urmare, având în vedere natura sa seminală, nu este necesar să ruleze pe un smartphone la acest stadiu.
Metodă/Dată
Au fost utilizate mai multe seturi de date de la Universitatea Tehnică din Danemarca (DTU, instituția gazdă a celor trei cercetători) în studiu, pentru fine-tuningul modelului țintă și pentru antrenarea și testarea modului de atac.
Seturile de date utilizate au fost derivate din DTU Orbit:
DseenDTU Setul de imagini de bază.
DDTU Imagini extrase din DTU Orbit.
DseenDTU O partiție a DDTU utilizată pentru fine-tuningul modelului țintă.
DunseenDTU O partiție a DDTU care nu a fost utilizată pentru fine-tuningul niciunui model de generare de imagini și a fost utilizată în schimb pentru a testa sau antrena modelul de atac.
wmDseenDTU O partiție a DDTU cu filigrane vizibile utilizată pentru fine-tuningul modelului țintă.
hwmDseenDTU O partiție a DDTU cu filigrane ascunse utilizată pentru fine-tuningul modelului țintă.
DgenDTU Imagini generate de un model de difuzie latentă (LDM) care a fost fine-tuneat pe setul de imagini DseenDTU.
Seturile de date utilizate pentru fine-tuningul modelului țintă constau în perechi de imagini și texte, captionate de modelul de captionare BLIP (poate nu întâmplător unul dintre cele mai populare modele necenzurate din comunitatea casual de inteligență artificială).
BLIP a fost setat să adauge fraza ‘o poză de la DTU a unei’ la fiecare descriere.
De asemenea, au fost utilizate mai multe seturi de date de la Universitatea Aalborg (AAU), toate derivate din corpul VBN al AAU:
DAAU Imagini extrase din AAU vbn.
DseenAAU O partiție a DAAU utilizată pentru fine-tuningul modelului țintă.
DunseenAAU O partiție a DAAU care nu a fost utilizată pentru fine-tuningul niciunui model de generare de imagini, ci a fost utilizată în schimb pentru a testa sau antrena modelul de atac.
DgenAAU Imagini generate de un LDM fine-tuneat pe setul de imagini DseenAAU.
Echivalent cu seturile anterioare, fraza ‘o poză de la AAU a unei’ a fost utilizată. Acest lucru a asigurat că toate etichetele din setul de date DTU au urmat formatul ‘o poză de la DTU a unei (…)’, consolidând caracteristicile de bază ale setului de date în timpul fine-tuningului.
Teste
Au fost efectuate mai multe experimente pentru a evalua cât de bine au funcționat atacurile de inferență a apartenenței împotriva modelului țintă. Fiecare test a urmărit să determine dacă a fost posibil să se desfășoare un atac de succes în cadrul schemei prezentate mai jos, unde modelul țintă este fine-tuneat pe un set de date de imagini care a fost obținut fără autorizație.

Schema abordării.
Cu modelul țintă interogat pentru a genera imagini de ieșire, aceste imagini sunt ulterior utilizate ca exemple pozitive pentru antrenarea modelului de atac, în timp ce imagini suplimentare nelegate de setul de date sunt incluse ca exemple negative.
Modelul de atac este antrenat utilizând învățare supravegheată și este apoi testat pe imagini noi pentru a determina dacă au fost parte a setului de date utilizat pentru fine-tuningul modelului țintă. Pentru a evalua acuratețea atacului, 15% din datele de test sunt păstrate pentru validare.
Deoarece modelul țintă este fine-tuneat pe un set de date cunoscut, statutul real de membru al fiecărei imagini este deja stabilit atunci când se creează datele de antrenare pentru modelul de atac. Acest cadru controlat permite o evaluare clară a modului în care modelul de atac poate distinge între imagini care au fost parte a setului de date de fine-tuning și cele care nu au fost.
Pentru aceste teste, a fost utilizat modelul Stable Diffusion V1.5. Deși acest model mai vechi apare frecvent în cercetare din cauza nevoii de teste consistente și a corpusului extins de lucrări anterioare care îl utilizează, acesta este un caz de utilizare adecvat; V1.5 a rămas popular pentru crearea de LoRAs în comunitatea de hobbyiști Stable Diffusion pentru o perioadă lungă de timp, în ciuda multiplelor lansări de versiuni ulterioare, și chiar și în ciuda apariției Flux – deoarece modelul este complet necenzurat.
Modelul de atac al cercetătorilor a fost bazat pe Resnet-18, cu greutățile preantrenate ale modelului păstrate. Stratul final de 1000 de neuroni al lui ResNet-18 a fost înlocuit cu un strat complet conectat cu doi neuroni. Pierderea de antrenare a fost pierderea categorică cross-entropy, și a fost utilizat optimizerul Adam.
Pentru fiecare test, modelul de atac a fost antrenat de cinci ori utilizând semințe aleatoare diferite pentru a calcula intervale de încredere de 95% pentru metricile cheie. Clasificarea zero-shot cu modelul CLIP a fost utilizată ca bază.
(Vă rugăm să rețineți că tabela principală de rezultate din articolul original este concisă și neobișnuit de dificil de înțeles. Prin urmare, am reformulat-o mai jos într-un mod mai prietenos cu utilizatorul. Vă rugăm să faceți clic pe imagine pentru a o vedea într-o rezoluție mai bună)
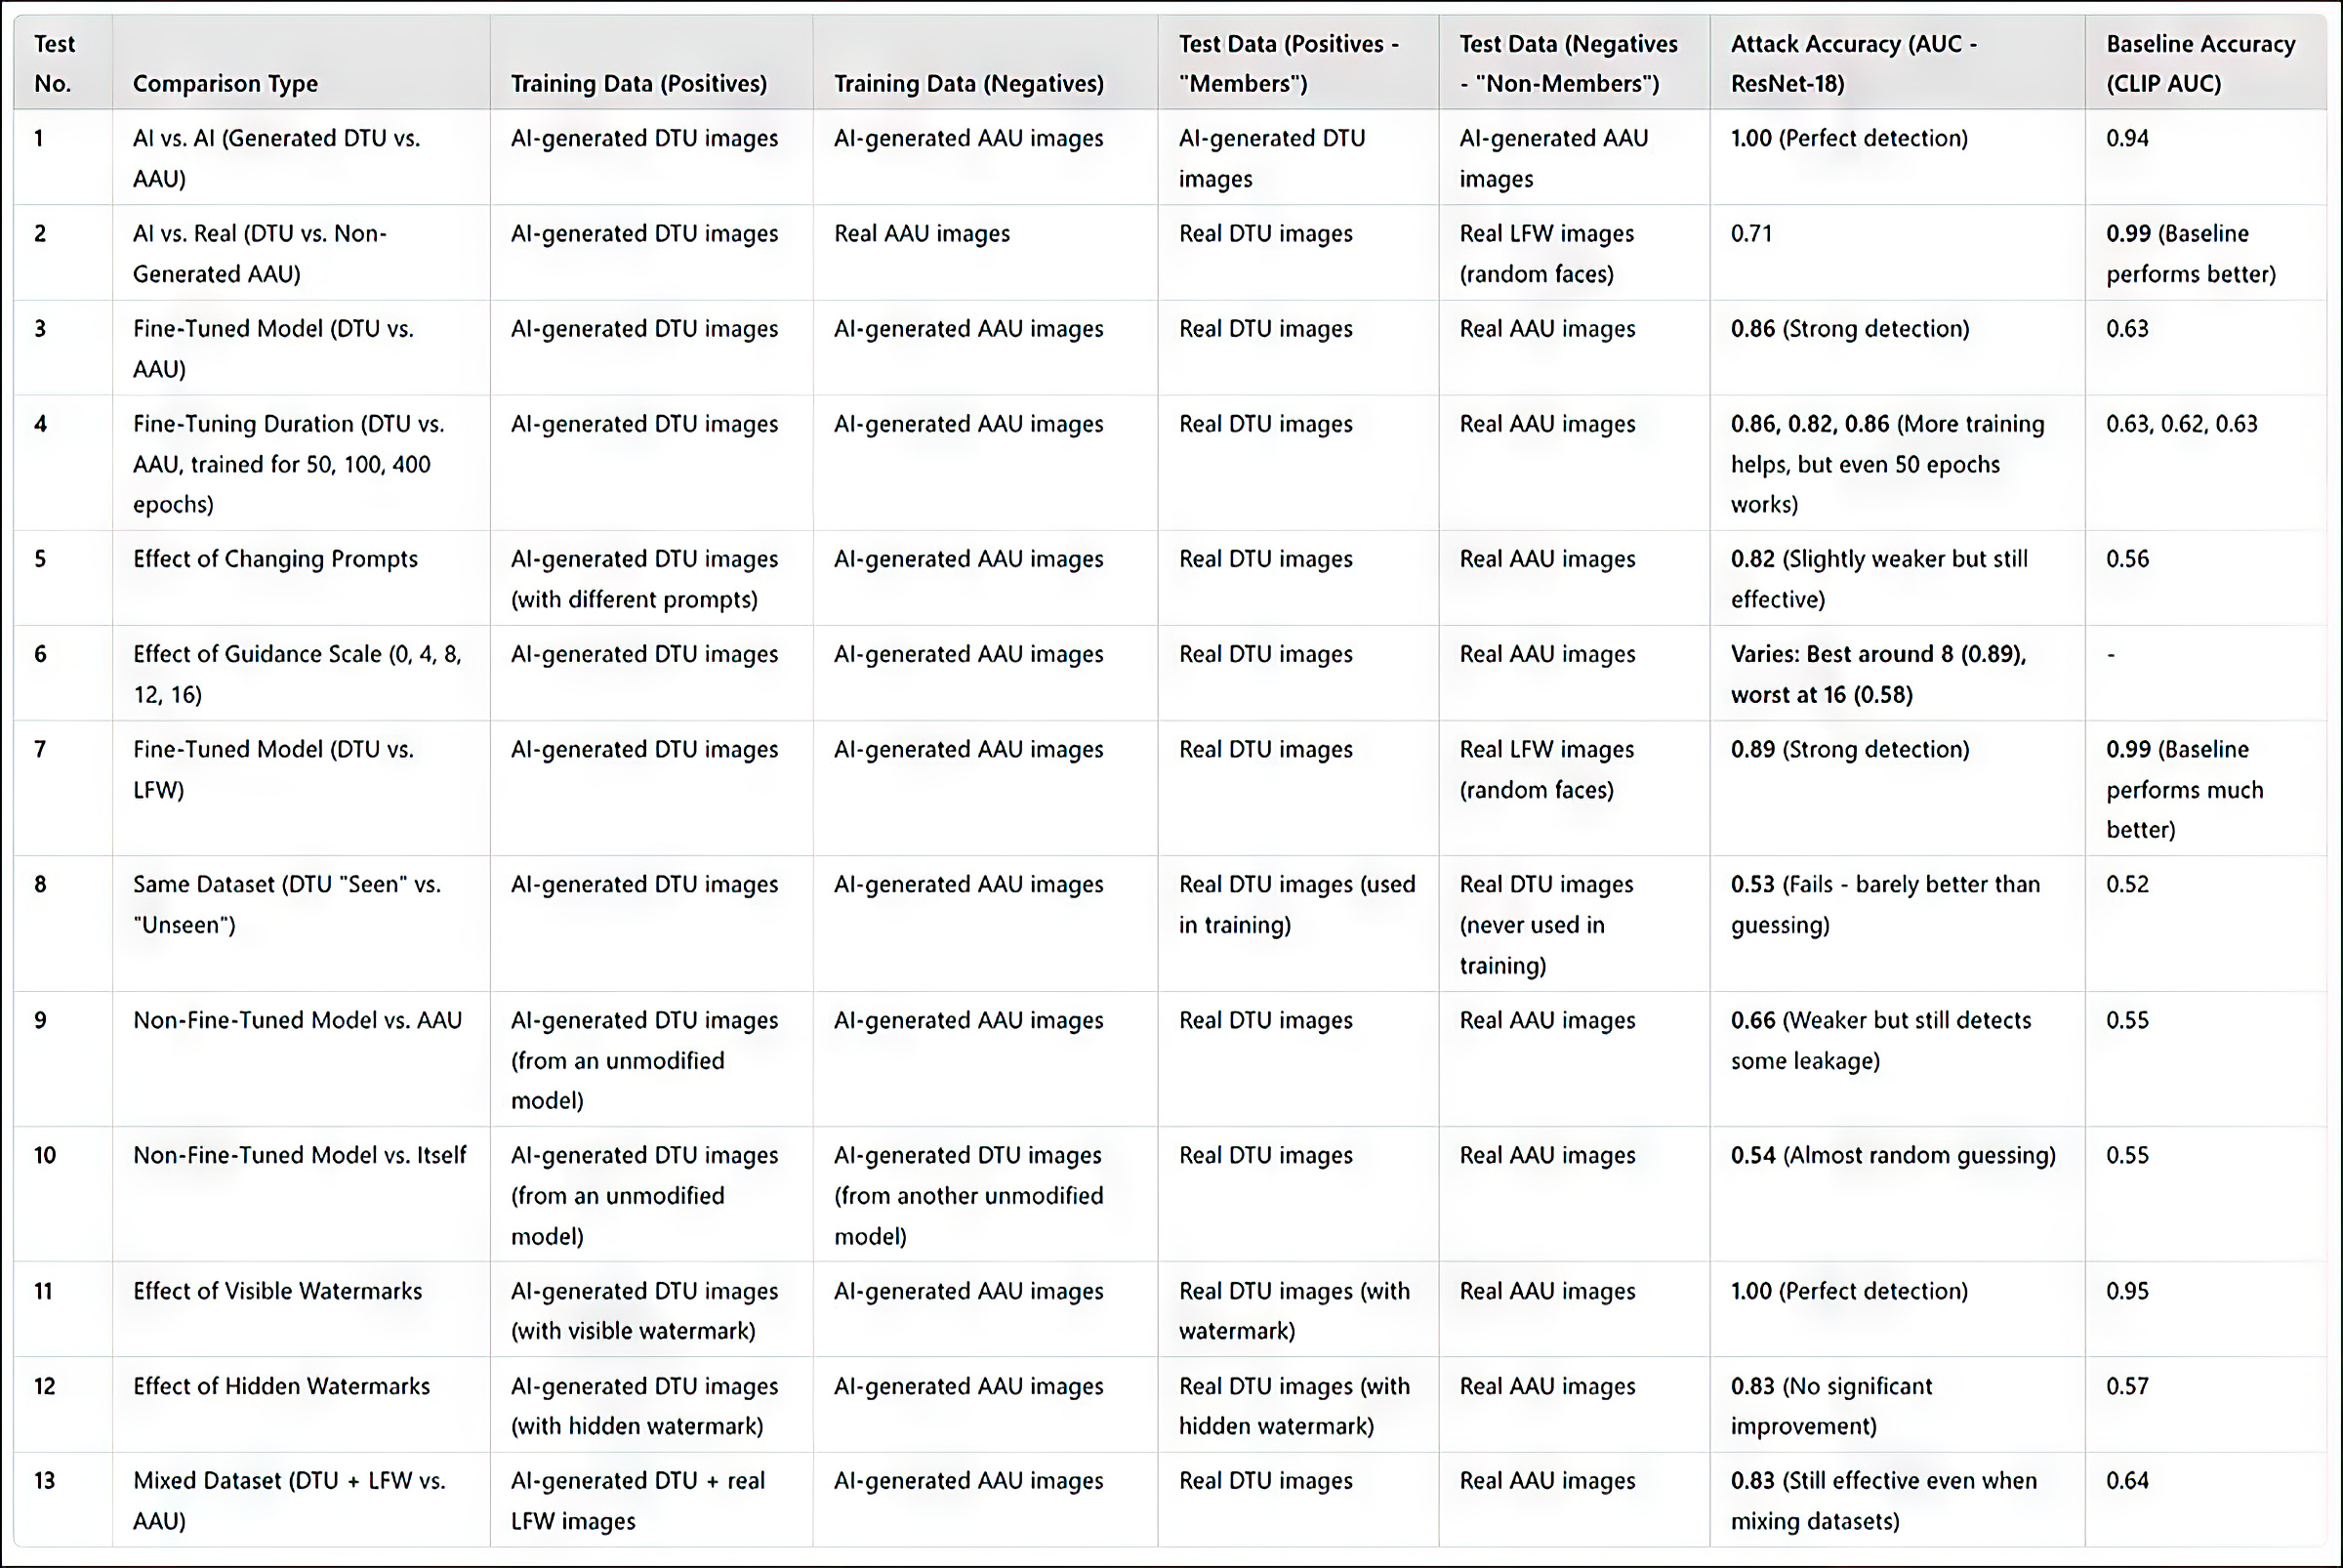
Rezumat al rezultatelor din toate testele. Faceți clic pe imagine pentru a o vedea într-o rezoluție mai bună
Metoda de atac a cercetătorilor s-a dovedit a fi cea mai eficientă atunci când a vizat modele fine-tuneate, în special cele antrenate pe un set specific de imagini, cum ar fi fața unei persoane. Cu toate acestea, în timp ce atacul poate determina dacă un set de date a fost utilizat, acesta se luptă să identifice imagini individuale din cadrul acelui set de date.
În termeni practici, acest lucru nu este neapărat un obstacol în calea utilizării unei abordări precum aceasta în mod forensic; în timp ce există relativ puțină valoare în a stabili că un set de date celebru, cum ar fi ImageNet, a fost utilizat într-un model, un atacator asupra unei persoane private (nu o celebritate) va tenda să aibă mult mai puțină alegere în ceea ce privește datele sursă și va trebui să exploateze pe deplin datele disponibile, cum ar fi albumele de pe rețelele sociale și alte colecții online. Acestea creează, în esență, un “hash” care poate fi descoperit prin metodele prezentate.
Articolul menționează că o altă modalitate de a îmbunătăți acuratețea este de a utiliza imagini generate de inteligență artificială ca “non-membre”, mai degrabă decât de a se baza doar pe imagini reale. Acest lucru previne rate de succes artificial de înaltă, care ar putea altfel induce în eroare rezultatele.
Un alt factor care influențează semnificativ detectarea, menționează autorii, este filigranarea. Atunci când imaginile de antrenare conțin filigrane vizibile, atacul devine foarte eficient, în timp ce filigranele ascunse oferă puțin sau deloc avantaj.

Figura din dreapta arată filigranul “ascuns” real utilizat în testele efectuate.
În final, nivelul de îndrumare în generarea de imagini pe baza textului joacă, de asemenea, un rol, cu echilibrul ideal găsit la o scară de îndrumare de aproximativ 8. Chiar și atunci când nu se utilizează niciun prompt direct, un model fine-tuneat va tenda să producă ieșiri care semănă cu datele sale de antrenare, consolidând eficacitatea atacului.
Concluzii
Este o rușine că acest articol interesant a fost scris într-un mod atât de inaccesibil, deoarece ar trebui să fie de interes pentru avocații pentru confidențialitate și cercetătorii de inteligență artificială amatori deopotrivă.
Deși atacurile de inferență a apartenenței ar putea dovedi a fi un instrument forensic interesant și rodnic, este posibil mai important ca această direcție de cercetare să dezvolte principii generale aplicabile, pentru a preveni sfârșitul în același joc de “whack-a-mole” care a apărut pentru detectarea deepfake-urilor în general, atunci când lansarea unui model mai nou afectează negativ detectarea și sistemele forensice similare. Deoarece există unele dovezi ale unui principiu director de nivel superior curățat în această nouă cercetare, putem spera să vedem mai multe lucrări în această direcție.
Primul publicat vineri, 21 februarie 2025