AGI og fremtidens AI
Hva er Turing‑testen og hvorfor er den viktig?

 Legg til Unite.AI blant dine foretrukne kilder på Google
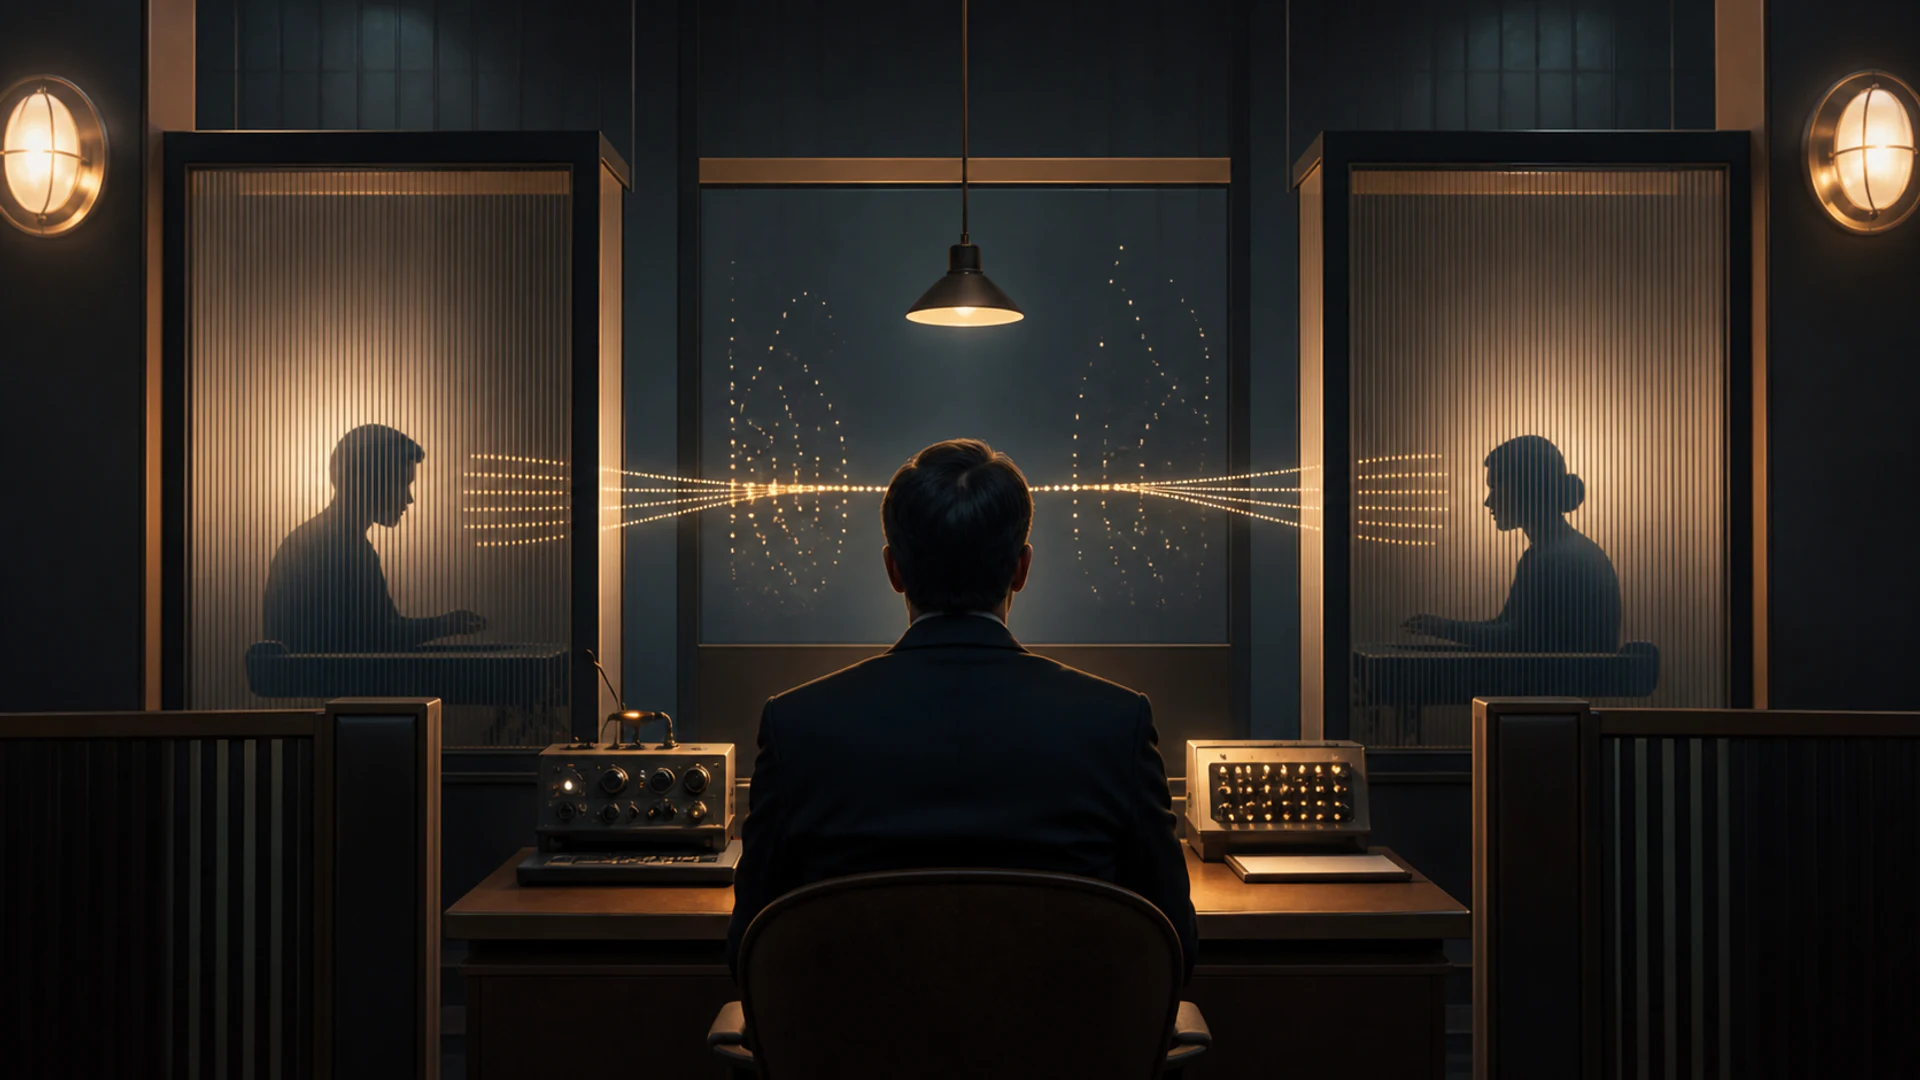
Turing‑testen vokste frem fra Alan Turings 1950‑artikkel «Computing Machinery and Intelligence». I stedet for å forsøke å definere tanke, foreslo Turing et etterligningsspill: en menneskelig etterforsker utveksler skriftlige meldinger med usette deltakere og avgjør hvem som er menneske og hvem som er maskin.
Testen forblir innflytelsesrik fordi den gjør et abstrakt filosofisk spørsmål om til en observerbar interaksjon. Den er også begrenset: å fremstå som menneske i en samtale er ikke det samme som å være sannferdig, kunnskapsrik, sikker, bevisst eller generelt intelligent.
Viktige poeng
- Turings originale etterligningsspill er en tekstbasert atferdstest, ikke en sjekkliste over interne kognitive egenskaper.
- Resultatene avhenger av evaluator, prompt, varighet, deltakerinstruksjoner og poengsettingsregel.
- En modell kan etterligne menneskelig samtale samtidig som den hallusinerer fakta eller mislykkes i enkle robusthetstester.
- Moderne evaluering trenger oppgavetall, adversarial testing, menneskelig gjennomgang og risikospesifikk evidens i tillegg til samtale.
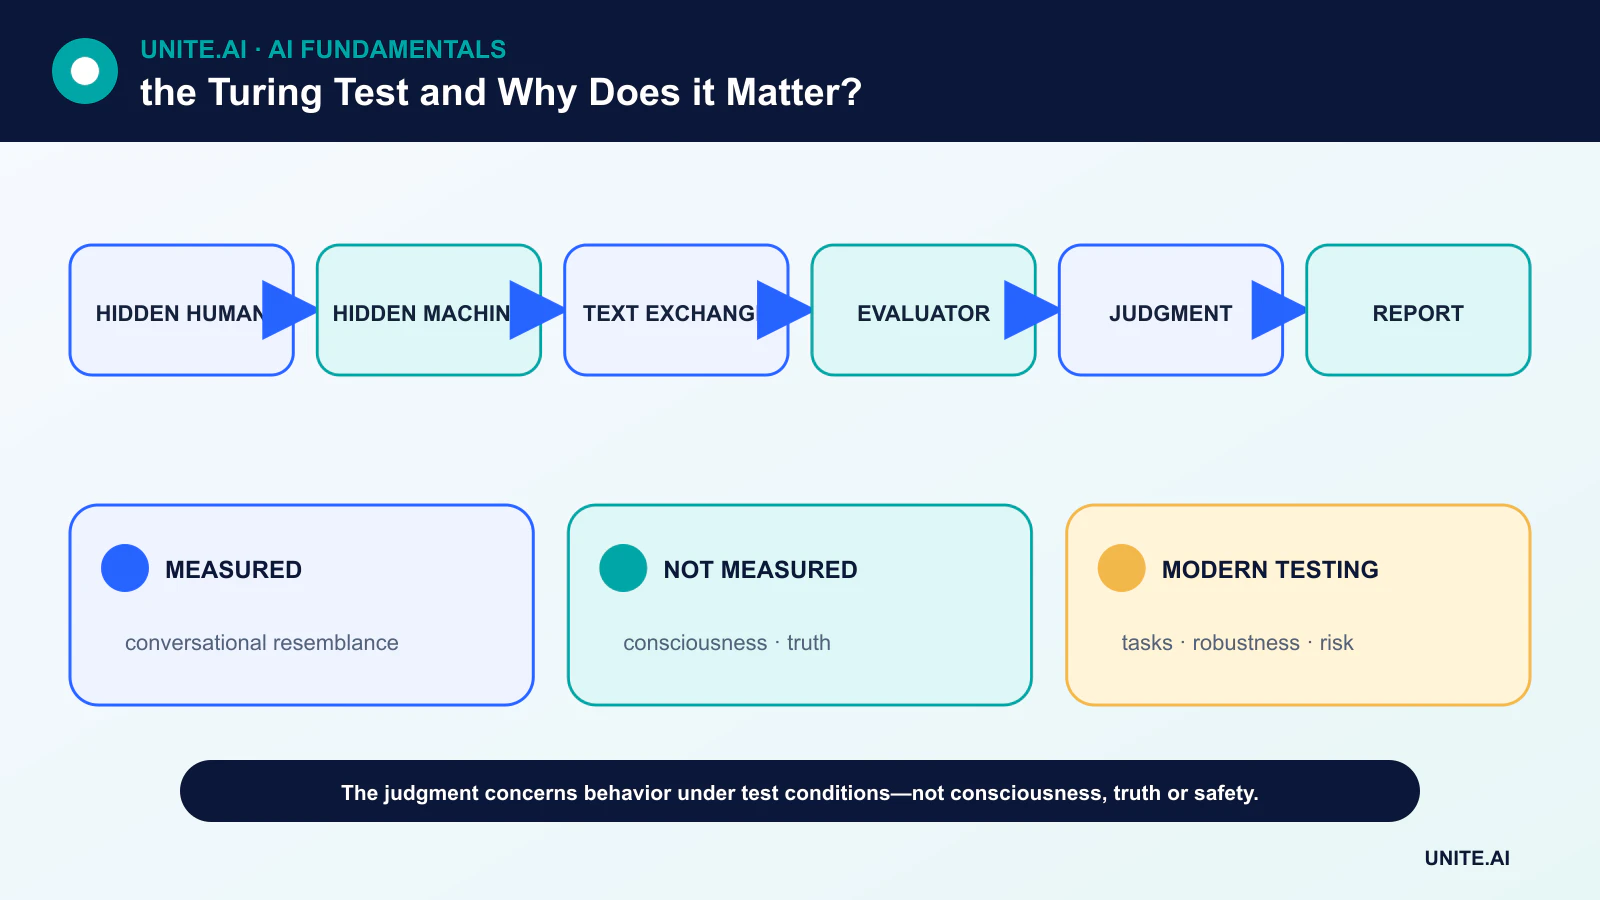
Turings etterligningsspill
I den opprinnelige oppsettet kommuniserte en etterforsker på avstand slik at stemme og utseende ikke avslørte identiteten. Turing spurte om en maskin kunne prestere godt nok i spillet til at en evaluator pålitelig ikke kunne skille den fra en person.
Denne operative innrammingen unngikk behovet for å fastsette én definisjon av tenkning. Den hevdet ikke at hver overbevisende utveksling beviser intelligens, og den spesifiserte heller ingen universell beståelsesgrense som gjelder for senere chatbot‑demonstrasjoner.
Hva et resultat egentlig måler
Et forsøk måler atferdsmessig uatskillelighet under definerte forhold. Korte samtaler, uerfarne dommere eller prompts valgt av systembyggeren kan gjøre oppgaven enklere. En grundig rapport bør avsløre valg av transkripsjoner, antall og bakgrunn for dommere, sammenligningsmennesker, tidsbegrensning og statistisk metode.
Et system kan også utnytte forventninger: unnvikelse, humor, typografiske feil og rollespill kan fremstå som menneskelig uten å demonstrere pålitelig resonnering. Omvendt kan et uvanlig formelt menneskelig svar feilklassifiseres som maskingenerert.
Hva Turing‑testen ikke fastslår
Testen måler ikke direkte bevissthet, subjektiv opplevelse, faktuell nøyaktighet, kausal forståelse eller moralsk handleevne. Den avslører ikke treningsdata, modellarkitektur eller feilmoduser utenfor samtalen. Den sier også lite om ikke‑språklig intelligens som fysisk manipulering.
Moderne språkmodeller er bygget med transformer‑nevrale nettverk og dyp læring, men deres flytende utdata kan fortsatt genereres fra lært statistisk struktur snarere enn en verifisert verdensmodell.
Hvordan moderne AI-evaluering utvider spørsmålet
Moderne evaluering bruker hold‑out‑oppgavesett, kalibrert usikkerhet, robusthetstester, red‑team‑testing, faktasjekker og studier av menneskelige preferanser. En tekstklassifiserings-metrik kan teste en definert atferd, mens scenario‑basert evaluering kan teste om et system følger retningslinjer under press.
Ingen enkelt benchmark fanger alle implementeringer. Testkontaminasjon kan oppblåse poeng, og statiske benchmarks oppmuntrer til overtilpasning. Evaluering bør gjentas etter hvert som modeller, data, prompts, verktøy og brukergrupper endres.
Hvorfor testen fortsatt er viktig
Turing‑testen forutså en kjernelære i AI‑evaluering: vurdere observerbar kapasitet i stedet for å stole på påstander om en intern essens. Den tvinger også oss til å spørre hvilke menneskelige atferder som teller som bevis og hvordan et eksperimentelt oppsett former en konklusjon.
Den beste moderne bruken er som et historisk og konseptuelt utgangspunkt. Å bestå et etterligningsspill kan være interessant, men beslutninger om implementering krever bevis knyttet til den faktiske oppgaven, berørte brukere og forutsigbare skader.
Hva Turing‑testen måler
Alan Turings etterligningsspill spurte om en etterforsker som kommuniserte via tekst pålitelig kunne skille en maskin fra en person. Det omformulerte en abstrakt debatt om hvorvidt maskiner tenker til et observerbart samtaleeksperiment. Testen avhenger av deltakere, varighet, protokoll, temaer og dommeregel; det finnes ingen enkelt universell poengsum. Å bestå betyr å levere menneskelignende svar under den oppsettet. Den måler ikke direkte faktuell nøyaktighet, resonnering, bevissthet, autonomi, persepsjon, legning, pålitelighet eller gunstig virkelighetsadferd.
Menneskelig etterligning kan belønne unnvikelse, persona, feil, humor eller manipulering. En dommer kan ta en menneske for en maskin eller bli påvirket av forventninger, språk og kulturell kontekst. Korte samtaler muliggjør triks som feiler ved lengre interaksjon. Omvendt kan et svært nyttig system for matematikk, oversettelse eller proteinmodellering mislykkes fordi det ikke later som om det er menneskelig. Testen måler derfor en sosial og språklig evne formet av evaluator, ikke en fullstendig rangering av intelligens.
Moderne språkmodeller og strengere evaluering
Store språkmodeller kan opprettholde flytende dialog ved å forutsi sekvenser fra bred treningsdata og senere finjustering, men flyt er svak evidens for sannhet eller forståelse. Minnede mønstre, verktøystøtte, skjulte prompts, latens og prøvetakingsinnstillinger påvirker resultatene. Kontrollerte evalueringer bør avsløre modell og protokoll, forhindre informasjonslekkasje, inkludere adversarial‑ og domene‑spørsmål, og vurdere usikkerhet og kildehenvisning. En demonstrasjon valgt fra vellykkede samtaler kan ikke anslå pålitelighet over hele bruksfordelingen.
Moderne evaluering er multidimensjonal: oppgave‑nøyaktighet, kalibrering, robusthet, langsiktig konsistens, sikkerhet, skjevhet, personvern, sikkerhet, effektivitet og menneskelige resultater. Atferdstester bør suppleres med prosessevidens, red‑team‑testing, reproduserbare benchmarks og overvåkning i virkeligheten. Benchmarks kan bli mettet eller komme inn i treningsdata, så private og oppdaterte testsett er nødvendige. For systemer som handler, bør verktøy‑tillatelser, gjenoppretting og konsekvenser evalueres separat fra samtalekvalitet.
Hvorfor testen fortsatt er viktig
Turing‑testen forblir historisk viktig fordi den fokuserer på atferd og vanskeligheten med å definere intelligens. Den reiser også vedvarende spørsmål om antropomorfisme og bedrag. Grensesnitt bør identifisere syntetiske agenter i stedet for å behandle feilidentifikasjon som suksess, spesielt i kritiske sammenhenger. Bruk testen som et filosofisk verktøy og en samtale‑evaluering, ikke som en sertifisering av generell intelligens eller personlighet. Det sentrale spørsmålet ved implementering er hva systemet pålitelig kan gjøre, med hvilket bevis og hvilke grenser, og hvem som er ansvarlig når det feiler.
Arbeidseksempel: en kontrollert samtale‑evaluering
Evaluatører sammenligner mennesker og flere AI‑systemer i tekstbaserte samtaler med fast varighet, temaer, språk og skjulte identiteter. Dommere registrerer om de tror hver deltaker er menneske og vurderer også faktasannhet, konsistens, hjelpsomhet, usikkerhet og manipulering. Flere dommere og samtaler estimerer variasjon, og protokollen hindrer modellutviklere i å velge gunstige transkripsjoner. Feilklassifisering av mennesker gir et nødvendig grunnlag for å tolke resultatet.
Et system som lurer dommere men lager oppdiktede fakta, blir ikke erklært generelt intelligent, mens en tydelig deklarert spesialmodell kan være svært nyttig selv om den mislykkes i etterligning. Resultatene inkluderer prompt, modell, sampler, verktøy‑tilgang og dommerkarakteristikker. Eksperimentet er innrammet som en test av menneskelignende samtale. Implementeringsbeslutninger bruker separate bevis for oppgaveløsning, sikkerhet, personvern og gjenoppretting, og grensesnittet identifiserer agenten i stedet for å gjøre bedrag til produktmål.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, inn‑ og utdata, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler et reproduserbart grunnlag og et versjonert evalueringssett før finjustering. Test vanlige tilfeller, grensetilstander, feilformet eller manglende input, distribusjonsforskyvning, avhengighetsavbrudd, misbruk, og grupper eller miljøer som sannsynligvis blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan gjenskape resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og avvikling. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑atferd, modell‑ eller regelversjon, avhengighetshelse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter implementering i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelseslæring, slettings‑ og oppbevaringsprosedyrer, samt et tydelig punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Har noen AI definitivt bestått Turing‑testen?
Det finnes ingen enkelt offisiell testmyndighet eller universelt akseptert protokoll. Offentlige demonstrasjoner bruker ulike regler, så påstander om å ha “bestått” er ikke direkte sammenlignbare.
Beviser det at en test mislykkes at et system er unintelligent?
Nei. Et spesialisert system kan være svært kapabelt uten å etterligne en menneskelig samtalestil.
Primære referanser