
Grunnleggende AI
Hva er AI-sikringsmekanismer? Hvordan produksjonssystemer kontrollerer modellens atferd
AI‑sikringsmekanismer er lagdelte tekniske og prosedyremessige kontroller som begrenser innganger, handlinger, utdata og eskalering rundt en modell eller agent. Denne guiden forklarer mekanismen, avveiningene, evalueringen og kontrollene som er relevante i praksis.

 Legg til Unite.AI blant dine foretrukne kilder på Google
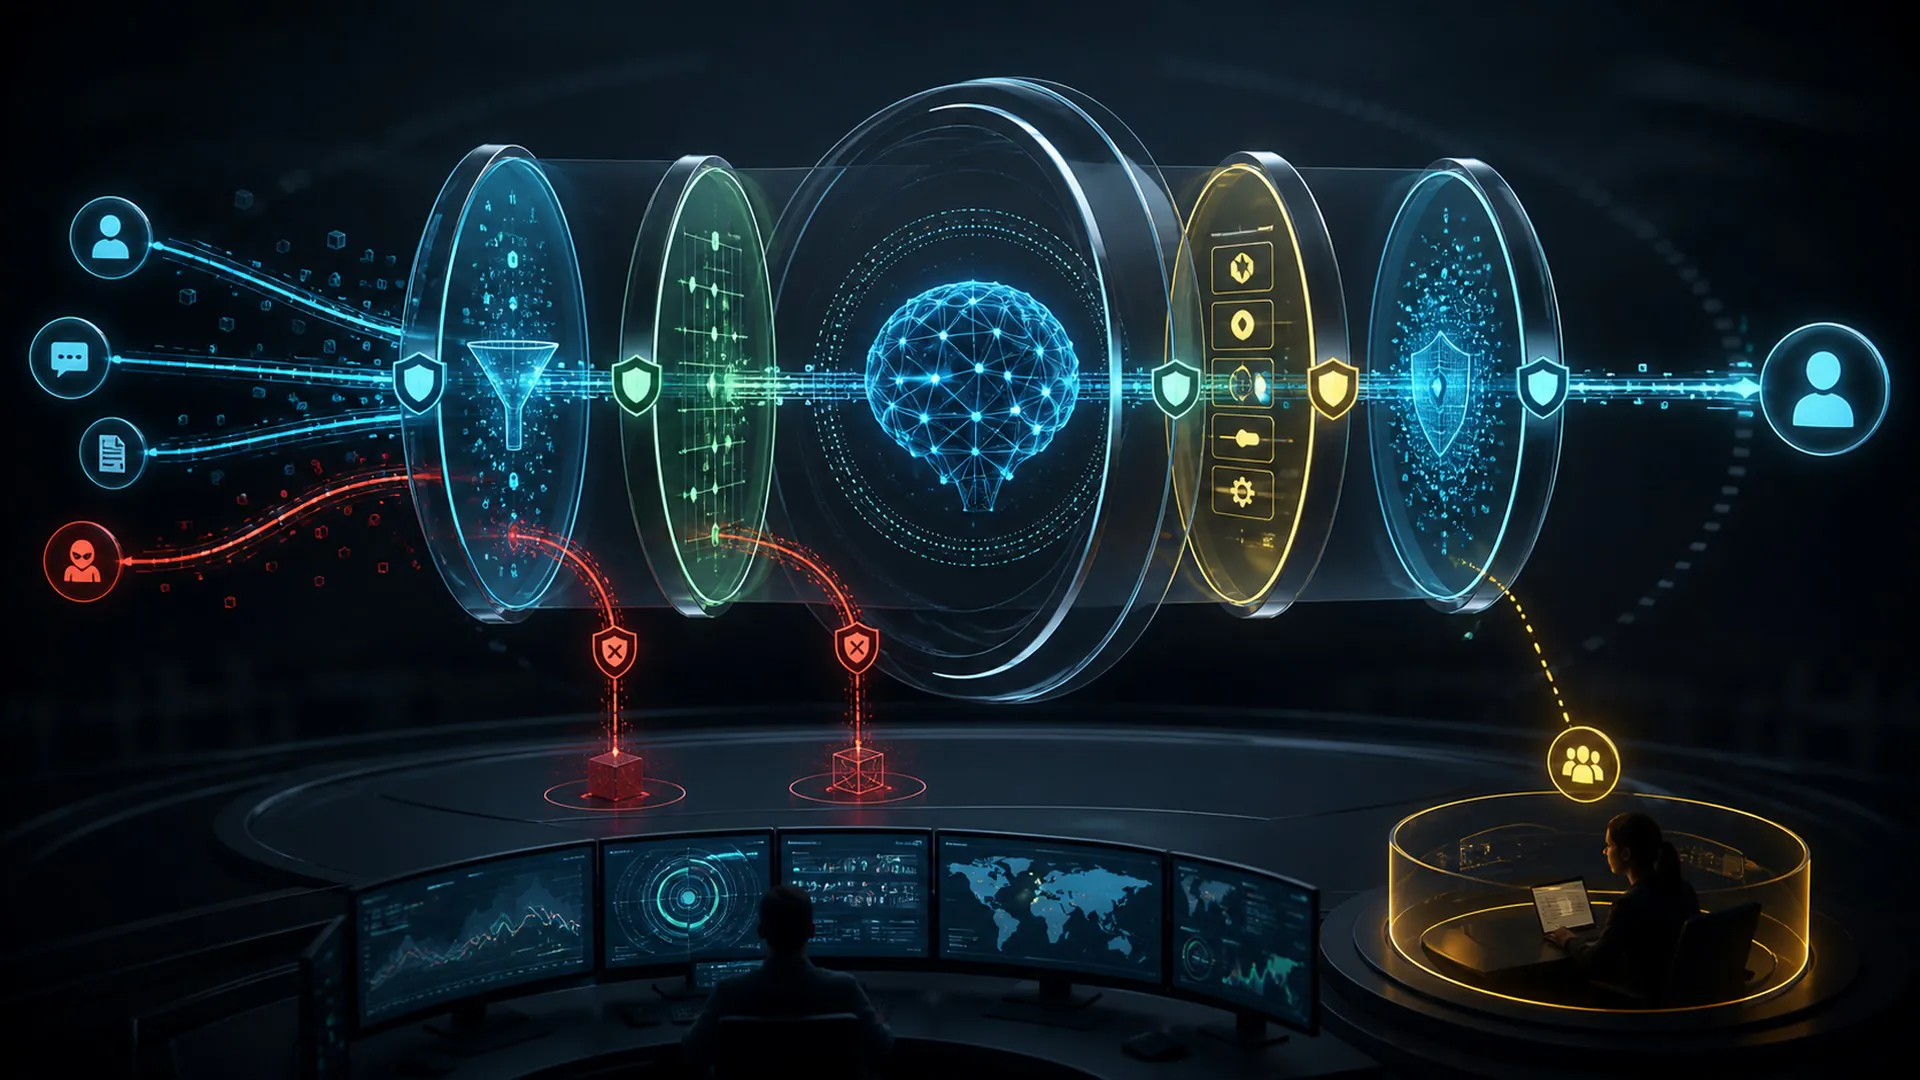
AI-sikringsmekanismer er lagdelte tekniske og prosedyriske kontroller som begrenser inndata, handlinger, utdata og eskalering rundt en modell eller en agent.
AI-sikringsmekanismer fortjener en presis forklaring fordi navnet identifiserer en bestemt informasjonsflyt, treningsvalg, kjøretidsmekanisme eller styringsgrense. Å behandle dem som et synonym for «avansert AI» gjør påstander umulige å teste. Denne guiden følger konseptet fra dets inndata og forutsetninger gjennom det observerbare resultatet, og tester deretter snarveien som mest sannsynlig blir forvekslet med det.
AI-sikringsmekanismer: Definisjon, grense og formål
AI-sikringsmekanismer er lagdelte tekniske og prosedyriske kontroller som begrenser inndata, handlinger, utdata og eskalering rundt en modell eller en agent. Definisjonen inneholder tre praktiske forpliktelser: det finnes en identifiserbar inndata, en transformasjon eller beslutning som er karakteristisk for AI-sikringsmekanismer, og et resultat som kan evalueres mot et angitt mål. Hvis ett av disse elementene mangler, kan betegnelsen beskrive en ambisjon snarere enn en implementert mekanisme.
Pålitelig AI krever bevis gjennom hele livssyklusen. En kontroll er meningsfull kun når dens eier, omfang, utløsere, forventet atferd og verifiseringsmetode er eksplisitte. For AI-sikringsmekanismer er dette systemperspektivet viktig fordi ytelsen kan bestemmes av omkringliggende data, grensesnitt, maskinvare, tillatelser og personer selv om den underliggende modellen forblir uendret. En nyttig forklaring skiller derfor modellens lærte atferd fra produktet som bestemmer når, hvor og med hvilken autoritet den atferden brukes.
Den nærmeste misvisende snarveien er en enkelt systemprompt som forventes å håndheve hver grense. Den kan dele et synlig trekk med AI-sikringsmekanismer, men den endrer den kausale historien: andre bevis ville fastslå suksess, andre ressurser ville dominere kostnadene, og andre kontroller ville forhindre skade. Grensen er derfor operasjonell snarere enn terminologisk.
Et femtrinns driftskart for AI-sikringsmekanismer
Diagrammet er et kompakt kausalt kart for AI-sikringsmekanismer, ikke en påstand om at hver implementering bruker fem programvarekomponenter. Noen systemer kombinerer trinn, og andre gjentar dem i en løkke. Kartet er fortsatt nyttig fordi det tvinger hver endring i informasjon eller autoritet til å ha en eier, en inndata, en utdata og en test.
1. Klassifiser forespørselen og gjeldende retningslinje: Inndata og forutsetninger i AI-sikringsmekanismer
I dette trinnet av AI-sikringsmekanismer må systemet klassifisere forespørselen og gjeldende retningslinje. Det relevante spørsmålet er ikke bare om den operasjonen skjer, men hvilken informasjon den bruker, hvilken tilstand den endrer, og hvilke bevis som viser at endringen var gyldig. En vurderer bør kunne skille operasjonen fra en enkelt systemprompt som forventes å håndheve hver grense og gjenskape resultatet under de samme angitte betingelsene.
Overgangen til dette AI-sikringsmekanismetrinnet begynner med det angitte målet og bør avsluttes med et resultat som kan støtte begrensning av kontekst, verktøy og datatilgang. Registrer usikkerhet, avviste alternativer, ressursbruk og enhver menneskelig eller programvarekontroll som er anvendt ved grensen. Denne sporet er der team kan oppdage om sikringsmekanismer kan blokkere legitimt arbeid, bli omgått, eller skape en falsk følelse av sikkerhet før den samme svakheten når en betydningsfull utdata.
2. Begrens kontekst, verktøy og datatilgang: Representasjon eller beslutning i AI-sikringsmekanismer
I dette trinnet av AI-sikringsmekanismer må systemet begrense kontekst, verktøy og datatilgang. Det relevante spørsmålet er ikke bare om den operasjonen skjer, men hvilken informasjon den bruker, hvilken tilstand den endrer, og hvilke bevis som viser at endringen var gyldig. En vurderer bør kunne skille operasjonen fra en enkelt systemprompt som forventes å håndheve hver grense og gjenskape resultatet under de samme angitte betingelsene.
Overgangen til dette AI-sikringsmekanismetrinnet begynner med klassifisering av forespørselen og gjeldende retningslinje og bør avsluttes med et resultat som kan støtte validering av foreslåtte handlinger før utførelse. Registrer usikkerhet, avviste alternativer, ressursbruk og enhver menneskelig eller programvarekontroll som er anvendt ved grensen. Dette sporet er der team kan oppdage om sikringsmekanismer kan blokkere legitimt arbeid, bli omgått, eller skape en falsk følelse av sikkerhet før den samme svakheten når en betydningsfull utdata.
3. Valider foreslåtte handlinger før utførelse: Distinkt transformasjon i AI Guardrails
I dette stadiet av AI guardrails må systemet validere foreslåtte handlinger før utførelse. Det relevante spørsmålet er ikke bare om operasjonen finner sted, men hvilken informasjon den bruker, hvilken tilstand den endrer, og hvilket bevis som viser at endringen er gyldig. En revisor bør kunne skille operasjonen fra et enkelt systemprompt som forventes å håndheve alle grenser og gjenskape resultatet under de samme oppgitte betingelsene.
Overgangen til dette AI guardrails-stadiet begynner med å begrense kontekst, verktøy og datatilgang og skal avsluttes med et resultat som kan støtte inspeksjon av utdata og endret tilstand. Registrer usikkerhet, avviste alternativer, ressursbruk og enhver menneskelig eller programvarekontroll som anvendes ved grensen. Denne sporingsinformasjonen er hvor team kan oppdage om guardrails kan blokkere legitimt arbeid, bli omgått, eller skape en falsk følelse av sikkerhet før den samme svakheten når et konsekvensielt resultat.
4. Inspiser utdata og endret tilstand: Begrensnings- og verifiseringsgrense i AI Guardrails
I dette stadiet av AI guardrails må systemet inspisere utdata og endret tilstand. Det relevante spørsmålet er ikke bare om operasjonen finner sted, men hvilken informasjon den bruker, hvilken tilstand den endrer, og hvilket bevis som viser at endringen er gyldig. En revisor bør kunne skille operasjonen fra et enkelt systemprompt som forventes å håndheve alle grenser og gjenskape resultatet under de samme oppgitte betingelsene.
Overgangen til dette AI guardrails-stadiet begynner med å validere foreslåtte handlinger før utførelse og skal avsluttes med et resultat som kan støtte eskalering, logging og forbedring fra hendelser. Registrer usikkerhet, avviste alternativer, ressursbruk og enhver menneskelig eller programvarekontroll som anvendes ved grensen. Denne sporingsinformasjonen er hvor team kan oppdage om guardrails kan blokkere legitimt arbeid, bli omgått, eller skape en falsk følelse av sikkerhet før den samme svakheten når et konsekvensielt resultat.
5. Eskaler, logg og forbedre fra hendelser: Utdata, tilbakemelding og stoppregel i AI Guardrails
I dette stadiet av AI guardrails må systemet eskalere, logge og forbedre fra hendelser. Det relevante spørsmålet er ikke bare om operasjonen finner sted, men hvilken informasjon den bruker, hvilken tilstand den endrer, og hvilket bevis som viser at endringen er gyldig. En revisor bør kunne skille operasjonen fra et enkelt systemprompt som forventes å håndheve alle grenser og gjenskape resultatet under de samme oppgitte betingelsene.
Overgangen til dette AI guardrails-stadiet begynner med å inspisere utdata og endret tilstand og skal avsluttes med et resultat som kan støtte overvåking eller en endelig beslutning. Registrer usikkerhet, avviste alternativer, ressursbruk og enhver menneskelig eller programvarekontroll som anvendes ved grensen. Denne sporingsinformasjonen er hvor team kan oppdage om guardrails kan blokkere legitimt arbeid, bli omgått, eller skape en falsk følelse av sikkerhet før den samme svakheten når et konsekvensielt resultat.
Les AI guardrails-kartet fremover for å forstå produksjon og bakover for å diagnostisere feil. Fremoveranalyse spør hvordan ett stadium leverer til det neste. Tilbakeanalyse starter fra et feilaktig, tregt, kostbart eller usikkert resultat og sporer hvilken tidligere antakelse som tillot det. Den omvendte veien er ofte der et team oppdager at den avgjørende feilen oppsto før modellen produserte noe.
Et praktisk AI Guardrails-eksempel
En finansassistent kan utarbeide en overføringsinstruksjon, men en deterministisk regel og en autorisert revisor må godkjenne utførelsen.
Dette eksemplet er informativt fordi AI guardrails kan knyttes til observerbare innganger, mellomliggende tilstander og et resultat, snarere enn å bli vurdert gjennom en polert demonstrasjon. En grundig test ville konstruere vanlige, vanskelige og bevisst misvisende tilfeller rundt scenariet, bevare en referanse uten teknikken, og registrere både gjennomsnittlig ytelse og alvorlighetsgraden av individuelle feil.
Endre én antakelse i AI guardrails-eksemplet og gjenta analysen. Fjern en påkrevd inngang, introduser et konfliktende signal, begrens beregning, endre brukerpopulasjonen, eller tving systemet til å avstå. En mekanisme som kun lykkes under én nøye arrangert demonstrasjon har ikke vist at den generaliserer til driftsmiljøet.
AI Guardrails vs. den mest vanlige snarveien
AI guardrails blir ofte redusert til ett enkelt systemprompt som forventes å håndheve alle grenser. Denne reduksjonen fjerner selve grensen som definerer konseptet. Det kan føre til at kjøpere sammenligner ulike produkter, forskere overdriver hva et eksperiment demonstrerer, og operatører overvåker feil signal etter utrulling.
| Linse | Praktisk svar |
|---|---|
| Definisjon | AI-sikringer er lagdelte tekniske og prosedyremessige kontroller som begrenser innganger, handlinger, utganger og eskalering rundt en modell eller en agent. |
| Forvirring | en enkelt systemprompt forventes å håndheve hver grense. |
| Risiko | sikringer kan blokkere legitimt arbeid, omgås, eller skape en falsk følelse av sikkerhet. |
Sammenligningen bør også identifisere analyseenheten. Et papir om AI-sikringer kan isolere en modell eller algoritme, mens en distribuert tjeneste legger til gjenfinning, ruting, caching, policy, identitet, brukergrensesnitt og overvåkning. To produkter kan bruke samme overskriftsbegrep mens de implementerer ulike deler av den stacken. Spør hvilken komponent som utfører den definerende transformasjonen og hvilke andre komponenter som er nødvendige for det rapporterte resultatet.
Hvorfor AI-sikringer er viktige i nåværende AI-systemer
AI-sikringer er viktige nå fordi AI-systemer får større kontekster, flere modaliteter, mer kjøretidsberegning, bredere verktøytilgang og dypere koblinger til organisatoriske beslutninger. Under disse forholdene kan det som tidligere så ut som en forskningsdetalj bestemme latens, sikkerhet, tilgjengelighet, miljøkostnad, produktkvalitet eller juridisk ansvar.
Den relevante målingen er ikke om AI-sikringer kan levere ett imponerende resultat. Det er om teknikken forbedrer et resultat som er viktig på tvers av representative forhold, og gjør det mer effektivt enn en enklere basislinje. Rapporter fordelinger, feilkategorier, hale‑latens, ressursbruk og berørte undergrupper i stedet for å komprimere hvert resultat til ett gjennomsnitt.
Overvåk både tekniske måleverdier og påvirkninger på mennesker. Dokumenter usikkerhet, bevar opphav, gjør eskalering mulig, og design gjenoppretting før systemet blir utsatt for endrede virkelige forhold. Når det anvendes spesifikt på AI-sikringer, gjør den disiplinen bevisene portable: et annet team kan vurdere om den påståtte gevinsten sannsynligvis vil overleve en annen modell, språk, maskinvareplattform, datasett, brukerpopulasjon eller risikotoleranse.
Fordeler AI-sikringer kan levere
Den sterkeste grunnen til å bruke AI-sikringer er at de kan adressere den tiltenkte flaskehalsen direkte. Avhengig av implementeringen kan fordelen vises som bedre forankring, en mer trofast representasjon, forbedret generalisering, lavere latens, redusert minnebevegelse, tydeligere ansvarlighet, eller en tryggere grense mellom et modellforslag og en reell handling.
Fordeler bør uttrykkes som beslutninger og målinger. «Mer intelligent» er ikke et akseptkriterium for AI-sikringer. Et nyttig mål kan spesifisere feilrate på vanskelige tilfeller, gjenoppretting etter motstridende bevis, kostnad på et prosentil av trafikken, tid for menneskelig gjennomgang, kalibrering, eller prosentandelen av handlinger som holdes innenfor en definert autoritetsgrense.
Feilmodusen som definerer AI-sikringer
Den sentrale begrensningen er at sikringer kan blokkere legitimt arbeid, omgås, eller skape en falsk følelse av sikkerhet. Denne feilen er ikke en ettertanke som skal listes opp når utviklingen er fullført. Den bør forme datainnsamling, arkitektur, tillatelser, evaluering, utgivelsesporter og overvåkning av AI-sikringer fra starten.
En kontroll for AI-sikringer er kun nyttig dersom den virker før en kostbar eller irreversibel konsekvens. Identifiser den tidligste observerbare forløperen til feilen, sett en terskel eller regel, tildel en ansvarlig eier, og test gjenoppretting. Avhengig av brukstilfellet kan gjenoppretting bety å avstå, falle tilbake til et enklere system, be om mer bevis, eskalere til en person, rulle tilbake en modell, eller stoppe en handling helt.
En evalueringsplan for AI-sikringer
Start evalueringen av AI‑sikringsmekanismer ved å formulere beslutningen som bevisene må støtte. Definer den opererende populasjonen, konsekvensen av et feil resultat, informasjonen som faktisk er tilgjengelig på beslutningstidspunktet, og det enkleste troverdige alternativet. Dette forhindrer at en benchmark blir målet bare fordi den er enkel å gjennomføre.
Bruk et urørt testsett for kontrollerte sammenligninger, og valider deretter AI‑sikringsmekanismer i et trinnvis operasjonsmiljø. Offline‑evaluering gjør varianter sammenlignbare; skyggemodus, kanarier, hastighetsbegrensninger eller godkjenningsporter viser hvordan reell trafikk, tilbakemeldingssløyfer og mennesker endrer atferd. Distribusjonsfasen bør ha en eksplisitt stoppbetingelse i stedet for å anta at hver forbedring fortjener full utrulling.
Versjoner inngangene som trengs for å reprodusere AI‑sikringsmekanismer: kilde‑data, forhåndsbehandling, tokeniserer eller enkoder, modellvekt, konfigurasjon, prompt eller policy, hentingsindeks, evalueringssett, maskinvare‑forutsetninger og tjenestekode etter behov. Uten sporbarhet kan et team ikke avgjøre om et endret resultat skyldes teknikken, miljøet eller en uoppdaget endring i pipeline.
Til slutt, spør hvilket funn som ville falsifisere påstanden om at AI‑sikringsmekanismer hjelper. Hvis ingen resultat kan reversere adopsjonsbeslutningen, er evalueringen markedsføring. Forhåndsbestemte akseptgrenser og et bevart bekreftelsessett gjør øvelsen til bevis.
Spørsmål å stille før du tar i bruk AI‑sikringsmekanismer
- Mål: Hvilket målbare flaskehals er AI‑sikringsmekanismer ment å løse?
- Mekanisme: Hvilken av de fem stadiene inneholder den særegne transformasjonen?
- Referansepunkt: Hvordan sammenlignes den med en enkelt system‑prompt som forventes å håndheve alle grenser, eller et annet enklere alternativ?
- Bevis: Hvilke vanlige, vanskelige, adversarielle og undergruppe‑tilfeller ble testet?
- Operasjoner: Hvilke latens‑, minne‑, beregnings‑, energi‑, vedlikeholds‑ og gjennomgangskostnader oppstår i skala?
- Risiko: Hvordan vil teamet oppdage at sikringsmekanismer kan blokkere legitimt arbeid, bli omgått, eller skape en falsk følelse av sikkerhet?
- Gjenoppretting: Kan systemet avstå, falle tilbake, rulle tilbake eller eskalere før skade oppstår?
Primærkilder for studier av AI‑sikringsmekanismer
Autoritative utgangspunkt for delen av AI‑stakken som omgir AI‑sikringsmekanismer inkluderer NIST AI Risk Management Framework, C2PA specifications, NIST Privacy Framework. Les dem sammen med dokumentasjonen for den eksakte modellen, datasettet, maskinvaren og jurisdiksjonen som er involvert. En generell kilde kan definere mekanismen, men kun implementasjons‑spesifikk evidens kan fastslå at en bestemt implementasjon er egnet.
Hva du bør huske om AI‑sikringsmekanismer
AI‑sikringsmekanismer er en definert mekanisme innenfor et større sosioteknisk system. Verdien kommer fra å forbedre et spesifikt resultat under eksplisitte betingelser, ikke fra selve betegnelsen. Det fem‑stadige kartet gjør informasjonsflyten synlig, sammenligningen identifiserer hva den ikke er, og kontrollstien viser hvor en ansvarlig operatør kan gripe inn.
Den praktiske regelen for AI‑sikringsmekanismer er å definere målet, sammenligne med et troverdig referansepunkt, teste den feilen som er viktigst, og beholde evidensen som trengs for å overvåke endringer. Når disse elementene er på plass, blir konseptet et ingeniør‑ og styringsvalg som kan evalueres. Uten dem forblir det kun et lovende navn knyttet til en ukjent operasjonsrisiko.


