
Andersons vinkel
Mot sanntids‑AI‑mennesker med Neural Lumigraph Rendering

 Legg til Unite.AI blant dine foretrukne kilder på Google
Til tross for den nåværende bølgen av interesse for Neural Radiance Fields (NeRF), en teknologi som kan lage AI‑genererte 3D‑miljøer og objekter, krever denne nye tilnærmingen til bildesyntes fortsatt svært lang treningstid, og mangler en implementering som muliggjør sanntids‑ og svært responsive grensesnitt.
Imidlertid tilbyr et samarbeid mellom noen imponerende aktører i industri og akademia et nytt perspektiv på denne utfordringen (generelt kjent som Novel View Synthesis, eller NVS).
Forskningsartikkelen, med tittelen Neural Lumigraph Rendering, hevder en forbedring av omtrent to størrelsesordener over dagens standard, og representerer flere steg mot sanntids‑CG‑rendering via maskinlærings‑pipelines.

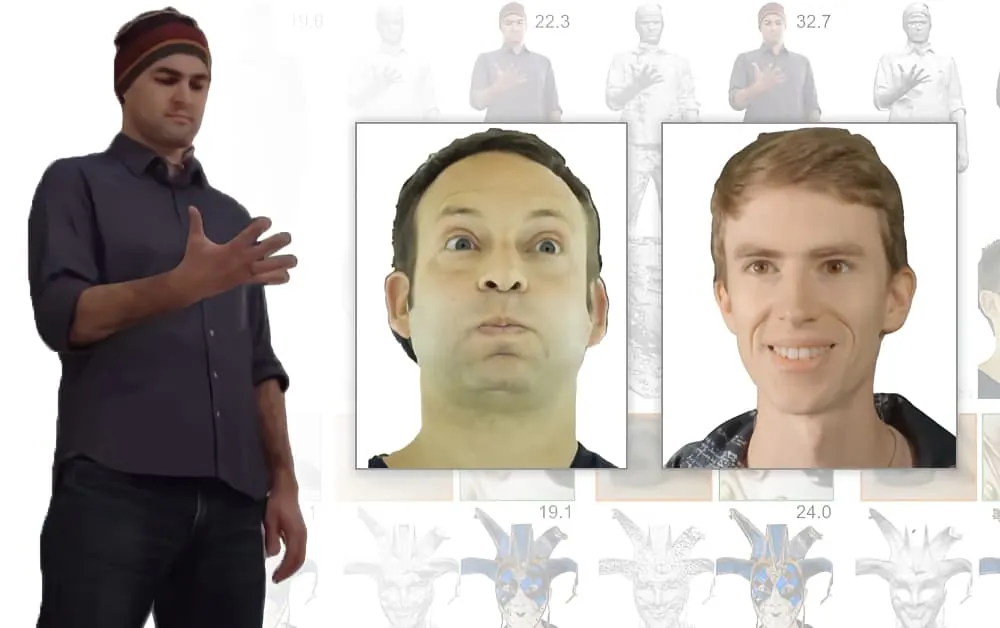
Neural Lumigraph Rendering (høyre) gir bedre oppløsning av blandingsartefakter og forbedret håndtering av okklusjon sammenlignet med tidligere metoder. Kilde.
Selv om krediteringen for artikkelen kun nevner Stanford University og holografisk skjermteknologiselskap Raxium (for tiden i stealth‑modus), inkluderer bidragsyterne en hovedmaskinlæringsarkitekt hos Google, en datamaskinforsker hos Adobe (ADBE ), og CTO hos StoryFile (som nylig fikk overskrifter med en AI‑versjon av William Shatner).
I forbindelse med den nylige Shatner‑offensiven ser det ut til at StoryFile bruker NLR i sin nye prosess for å lage interaktive, AI‑genererte enheter basert på egenskapene og historiene til enkeltpersoner.
StoryFile ser for seg bruk av denne teknologien i museumsutstillinger, nettbaserte interaktive fortellinger, holografiske skjermer, augmented reality (AR) og kulturarv‑dokumentasjon – og ser også ut til å vurdere potensielle nye bruksområder for NLR i rekrutteringsintervjuer og virtuelle dating‑applikasjoner:

Foreslåtte bruksområder fra en nettvideo av StoryFile.
Volumetrisk opptak for Novel View Synthesis‑grensesnitt og video
Prinsippet for volumetrisk opptak, på tvers av de mange artiklene som samles om temaet, er idéen om å ta stillbilder eller videoer av et motiv, og bruke maskinlæring til å ‘fylle inn’ de synspunktene som ikke ble dekket av det opprinnelige kamerautstyret.
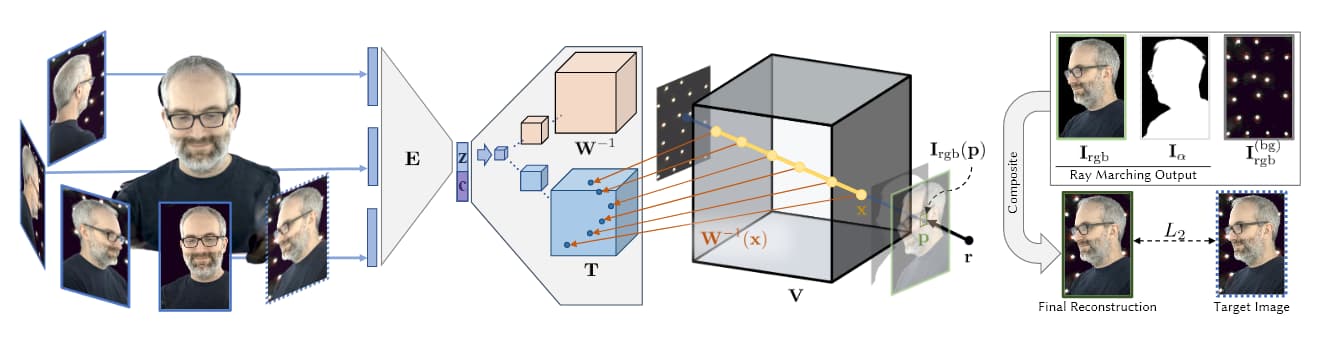
Kilde: https://research.fb.com/wp-content/uploads/2019/06/Neural-Volumes-Learning-Dynamic-Renderable-Volumes-from-Images.pdf
På bildet ovenfor, tatt fra Facebooks AI‑forskning fra 2019 (se nedenfor), ser vi de fire stadiene i volumetrisk opptak: flere kameraer tar bilder/opptak; en encoder/decoder‑arkitektur (eller andre arkitekturer) beregner og sammenkjedeler relativiteten mellom synspunktene; ray‑marching‑algoritmer beregner voxelene (eller andre XYZ‑romlige geometriske enheter) for hvert punkt i det volumetriske rommet; og (i de fleste nyere artikler) foregår trening for å syntetisere en komplett enhet som kan manipuleres i sanntid.
Det er denne ofte omfattende og datakrevende treningsfasen som hittil har holdt Novel View Synthesis utenfor sanntids‑ eller svært responsive opptak.
Faktumet at Novel View Synthesis lager et komplett 3D‑kart over et volumetrisk rom, gjør det relativt trivielt å sette sammen disse punktene til et tradisjonelt datagenerert nett, og dermed fange og artikulere en CGI‑person (eller ethvert annet relativt avgrenset objekt) i sanntid.
Tilnærminger som bruker NeRF baserer seg på punkt‑skyer og dybdekart for å generere interpolasjoner mellom de sparsomme synspunktene fra opptaksenhetene:
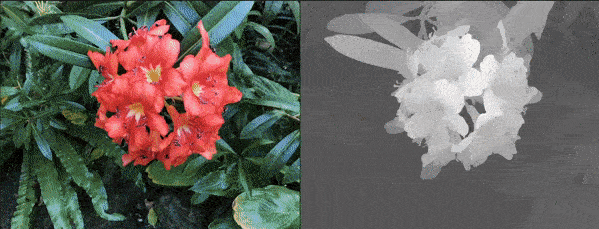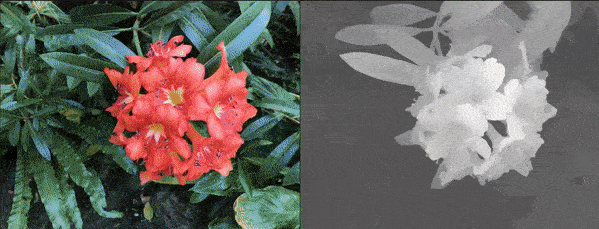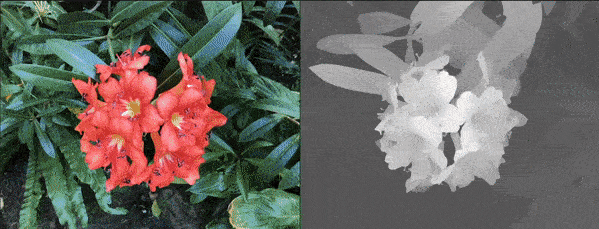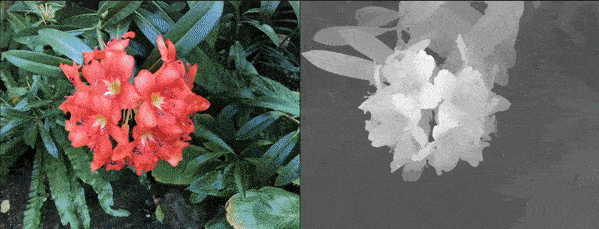
NeRF kan generere volumetrisk dybde gjennom beregning av dybdekart, i stedet for å generere CG‑nett. Kilde: https://www.youtube.com/watch?v=JuH79E8rdKc
Selv om NeRF er i stand til å beregne nett, bruker de fleste implementasjoner dette ikke for å generere volumetriske scener.
I kontrast baserer Implicit Differentiable Renderer (IDR)-tilnærmingen, publisert av Weizmann Institute of Science i oktober 2020, seg på utnyttelse av 3D‑nett‑informasjon som automatisk genereres fra opptaksarrayer:
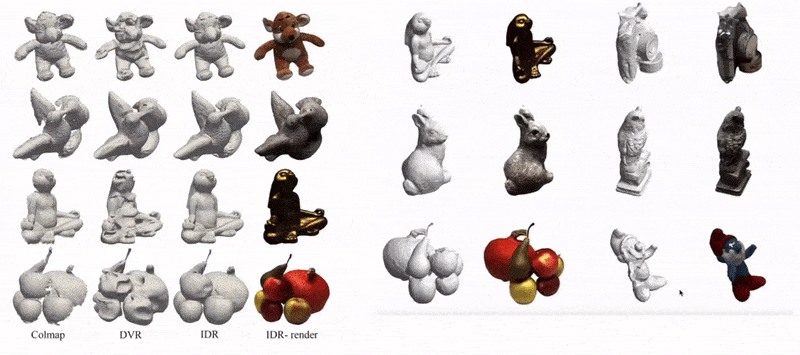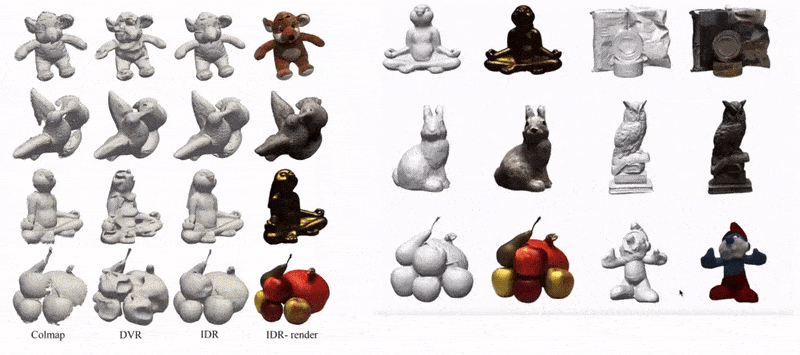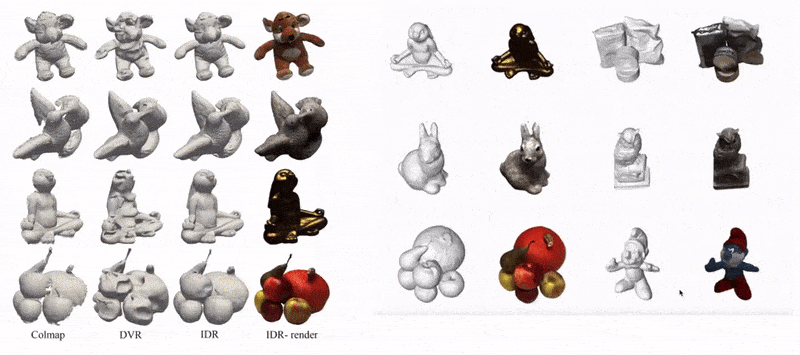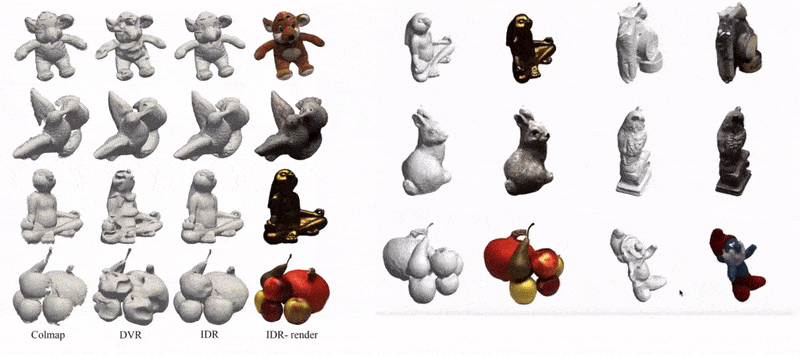
Eksempler på IDR‑opptak omgjort til interaktive CGI‑nett. Kilde: https://www.youtube.com/watch?v=C55y7RhJ1fE
Selv om NeRF mangler IDR‑s evne til formestimering, kan IDR ikke matche NeRF‑s bildekvalitet, og begge krever omfattende ressurser for å trene og samle (selv om nyere innovasjoner i NeRF begynner å løse dette).

NLRs tilpassede kamerautstyr med 16 GoPro HERO7 og 6 sentrale Back‑Bone H7PRO‑kameraer. For sanntids‑rendering opererer disse med minst 60 fps. Kilde: https://arxiv.org/pdf/2103.11571.pdf
I stedet bruker Neural Lumigraph Rendering SIREN (Sinusoidal Representation Networks) for å innlemme styrkene fra hver tilnærming i sin egen ramme, som er ment å generere output som er direkte brukbar i eksisterende sanntids‑grafikk‑pipelines.
SIREN har blitt brukt til lignende implementeringer det siste året, og representerer nå et populært API‑kall for hobby‑Colabs i bildesyntes‑samfunn; imidlertid er NLRs innovasjon å anvende SIREN på todimensjonal fler‑syns‑bilde‑veiledning, noe som er problematisk fordi SIREN ofte produserer over‑tilpasset i stedet for generalisert output.
Etter at CG‑nettet er ekstrahert fra bildene i arrayet, rasteriseres nettet via OpenGL, og vertex‑posisjonene i nettet kartlegges til de aktuelle pikslene, hvoretter blanding av de ulike bidragende kartene beregnes.
Det resulterende nettet er mer generalisert og representativt enn NeRFs (se bildet nedenfor), krever mindre beregning, og tilfører ikke overdreven detalj til områder (som glatt ansiktshud) som ikke kan dra nytte av det:

Kilde: https://arxiv.org/pdf/2103.11571.pdf
På den negative siden har NLR ennå ikke noen kapasitet for dynamisk belysning eller relighting, og output er begrenset til skyggekart og andre belysningsaspekter som er innhentet på tidspunktet for opptaket. Forskerne har til hensikt å adressere dette i fremtidig arbeid.
I tillegg innrømmer artikkelen at formene generert av NLR ikke er like nøyaktige som noen alternative tilnærminger, som Pixelwise View Selection for Unstructured Multi-View Stereo, eller Weizmann Institute‑forskningen nevnt tidligere.
Fremveksten av volumetrisk bildesyntese
Ideen om å lage 3D‑enheter fra en begrenset serie med bilder ved hjelp av nevrale nettverk går forut for NeRF, med visjonære artikler tilbake til 2007 eller tidligere. I 2019 produserte Facebooks AI‑forskningsavdeling en banebrytende forskningsartikkel, Neural Volumes: Learning Dynamic Renderable Volumes from Images, som først muliggjorde responsive grensesnitt for syntetiske mennesker generert av maskinlærings‑basert volumetrisk opptak.
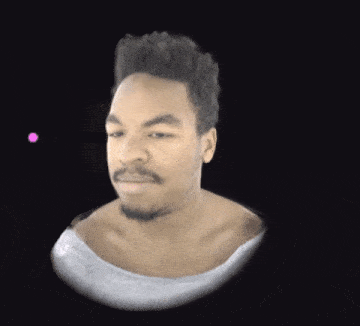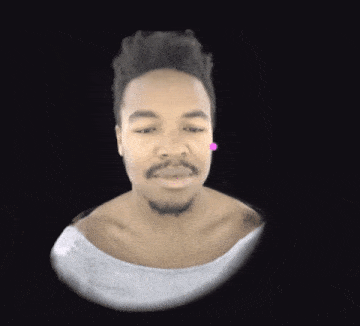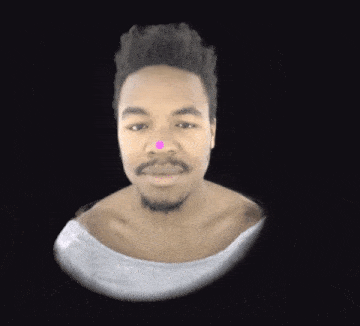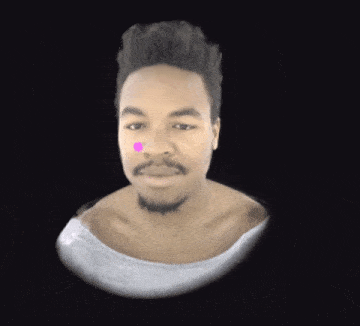
Facebooks 2019‑forskning gjorde det mulig å lage et responsivt brukergrensesnitt for en volumetrisk person. Kilde: https://research.fb.com/publications/neural-volumes-learning-dynamic-renderable-volumes-from-images/
til norsk Oversett til norsk. Skriv idiomatisk, publikasjonssikkert norsk for et profesjonelt webpublikum. Bevar kildens mening og fakta trofast uten å kopiere engelsk syntaks eller oversette ord for ord. Bruk moderne rettskrivning, grammatikk, tegnsetting, samsvar og etablert fagterminologi. Unngå falske venner, klønete kalkeer, hybridord, utdaterte diakritiske tegn og unødvendig uoversatt engelsk. Bevar kun ekte navn, merker, produkter, URL-er, kode og nøyaktige kortkodesymboler. Før du returnerer svaret, korrekturles stillegående hele oversettelsen for flyt, terminologikonsistens, manglende tekst, duplisert tekst og resterende kilde‑språk. Bruk moderne norsk bokmål og etablert norsk terminologi, samtidig som du holder en profesjonell, naturlig og SEO‑optimalisert redaksjonell tone.


