
Andersons vinkel
NeRF: Trening av droner i neurale lysmiljøer

 Legg til Unite.AI blant dine foretrukne kilder på Google

Forskere fra Stanford University har utviklet en ny metode for å trene droner til å navigere i fotorealistiske og svært nøyaktige miljøer, ved å utnytte den nylige interessen for Neural Radiance Fields (NeRF).
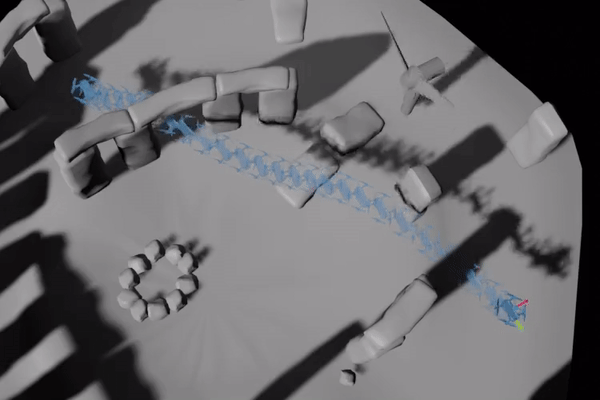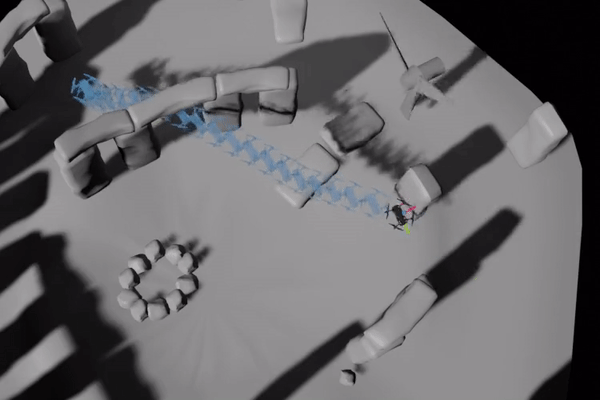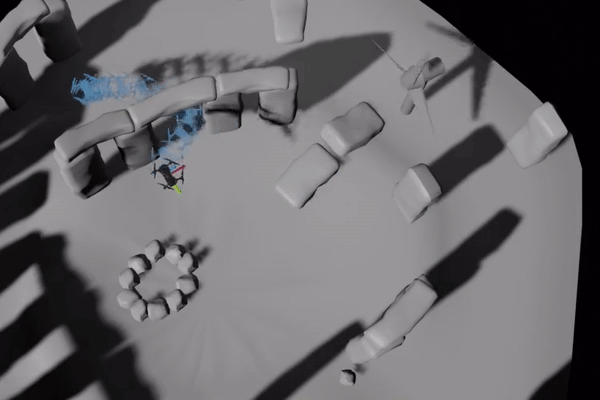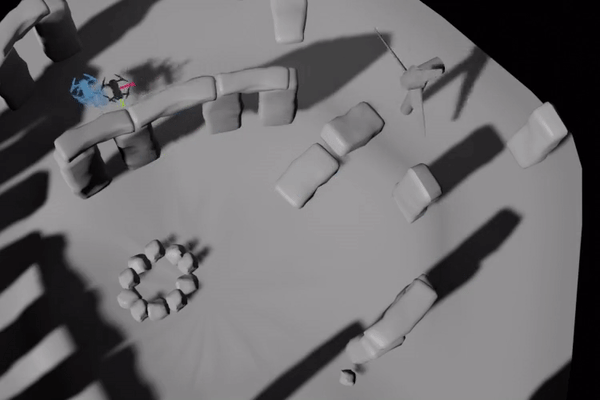
Droner kan trenes i virtuelle miljøer som er kartlagt direkte fra virkelige steder, uten behov for spesialisert 3D-scenerekonstruksjon. I dette bildet fra prosjektet, er vindforstyrrelse lagt til som en mulig hindring for dronen, og vi kan se at dronen midlertidig avviker fra sin bane og kompenserer i siste øyeblikk for å unngå en mulig hindring. Kilde: https://mikh3x4.github.io/nerf-navigation/
Metoden tilbyr mulighet for interaktiv trening av droner (eller andre typer objekter) i virtuelle scenarier som automatisk inkluderer voluminformasjon (for å beregne kollisjonsunngåelse), tekstur tegnet direkte fra virkelige bilder (for å hjelpe med å trene droners bilderekjennelsesnetverk på en mer realistisk måte), og virkelige lysforhold (for å sikre at en rekke lys-scenarier blir trent inn i nettverket, og unngå over-tilpasning eller over-optimisering til den opprinnelige snapshoten av scenen).
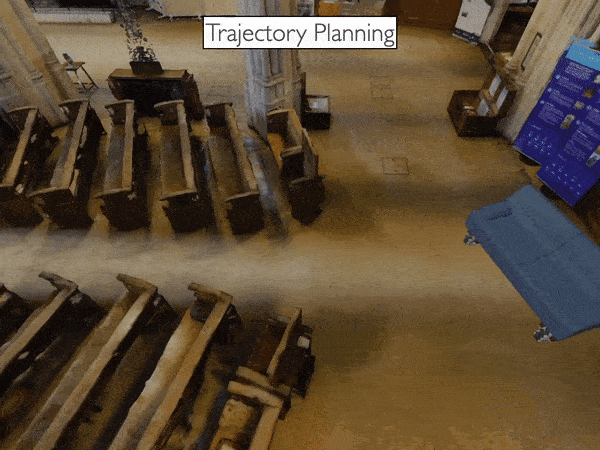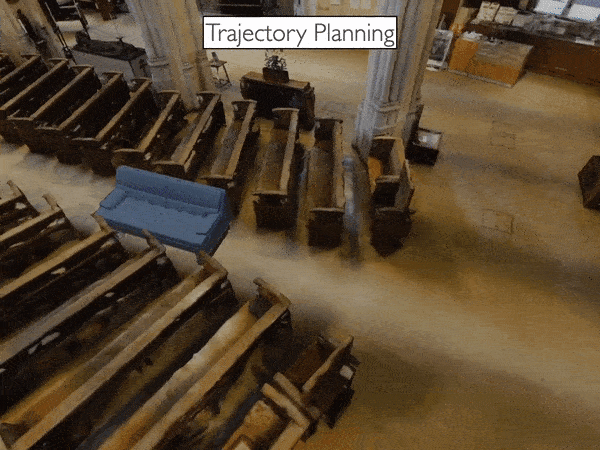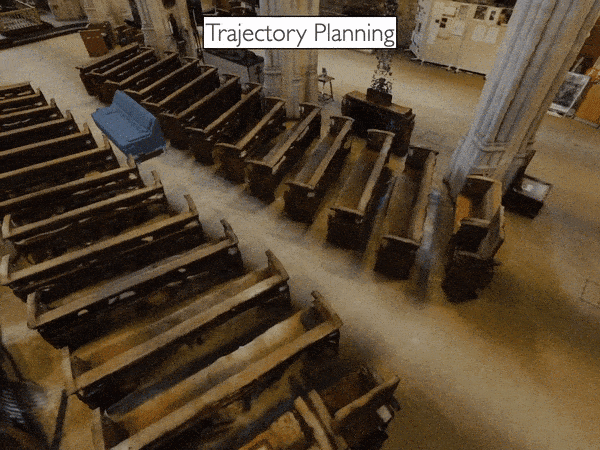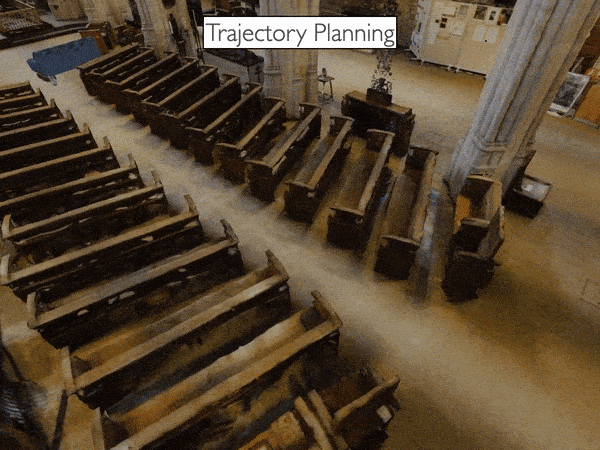
En couch-objekt navigerer gjennom et komplekst virtuelt miljø som ville ha vært svært vanskelig å kartlegge ved hjelp av geometri-fangst og omteksturering i tradisjonelle AR/VR-arbeidsflyter, men som ble rekonstruert automatisk i NeRF fra et begrenset antall bilder. Kilde: https://www.youtube.com/watch?v=5JjWpv9BaaE
Typiske NeRF-implementeringer har ikke med trajektor-mekanismer, siden de fleste NeRF-prosjektene de siste 18 månedene har konsentrert seg om andre utfordringer, som scenelys, refleks-avbildning, sammenslåing og adskillelse av fangete elementer. Derfor er den nye artikkelenes primære innovasjon å implementere et NeRF-miljø som et navigerbart rom, uten den omfattende utstyret og de arbeidskrevende prosedyrene som ville være nødvendig for å modellere det som et 3D-miljø basert på sensorfangst og CGI-rekonstruksjon.
NeRF som VR/AR
Den nye artikkelen heter Vision-Only Robot Navigation in a Neural Radiance World, og er et samarbeid mellom tre Stanford-avdelinger: Aeronautics and Astronautics, Mechanical Engineering, og Computer Science.
Arbeidet foreslår en navigasjonsramme som gir en robot en forhånds-trent NeRF-miljø, hvis volumtettlehet avgrenser mulige baner for enheten. Den inkluderer også en filter for å anslå hvor roboten er inne i det virtuelle miljøet, basert på bilderekjennelse av robotens onboard RGB-kamera. På denne måten kan en drone eller robot “hallusinere” mer nøyaktig hva den kan forvente å se i et gitt miljø.

Prosjektets trajektorioptimizer navigerer gjennom en NeRF-modell av Stonehenge som ble generert gjennom fotogrammetri og bilde-tolkning (i dette tilfelle, av mesh-modeller) til et neuralt lysmiljø. Trajektoriplanleggeren beregner en rekke mulige baner før den etablerer en optimal bane over buen.
Fordi et NeRF-miljø har fullstendig modellerte okklusjoner, kan dronen lære å beregne hindringer mer lett, siden neuralt nettverk bak NeRF kan kartlegge forholdet mellom okklusjoner og måten dronens onboard visjon-baserte navigasjonssystemer oppfatter miljøet. Den automatiske NeRF-genereringspipelinen tilbyr en relativt enkel metode for å lage hyper-realistiske treningsrom med bare noen få bilder.
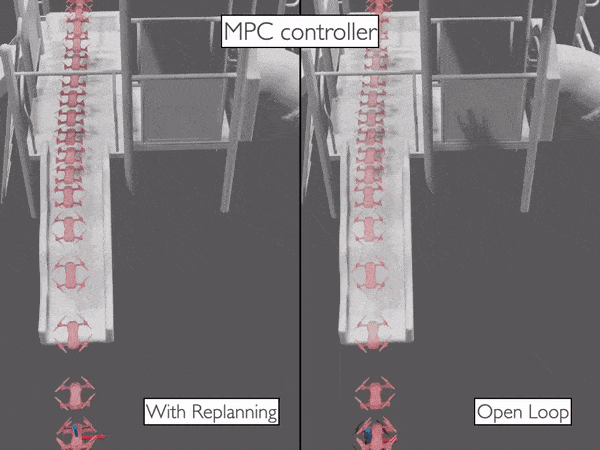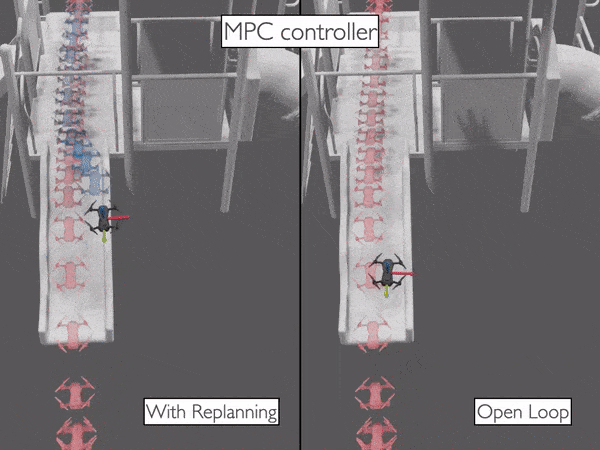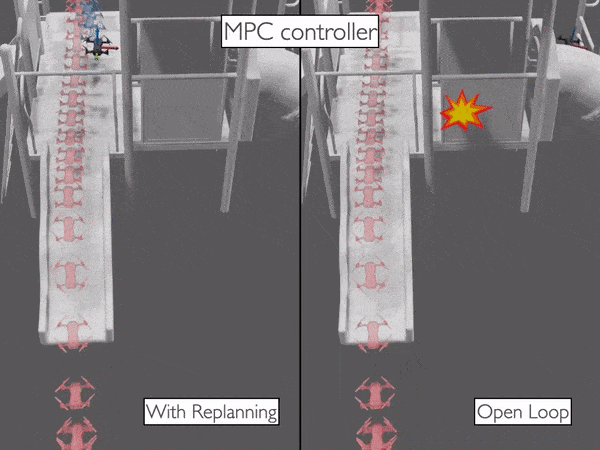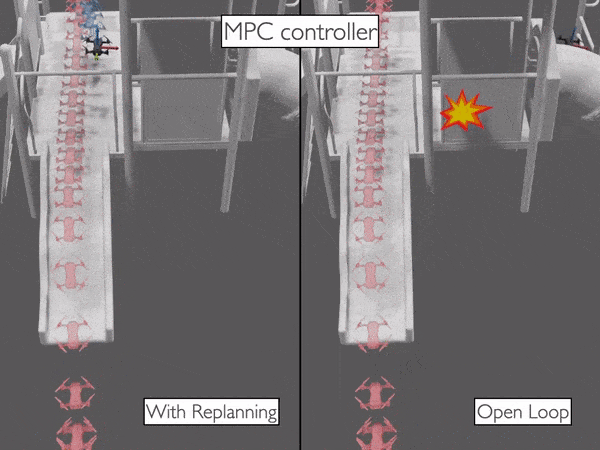
Den online omplanleggingsrammen som ble utviklet for Stanford-prosjektet muliggjør en resilient og fullstendig visjon-basert navigasjons-pipeline.
Stanford-initiativet er blant de første som vurderer mulighetene for å utforske et NeRF-rom i sammenheng med et navigerbart og immersivt VR-liknende miljø. Neurale lysfelt er en ny teknologi, og er for tiden gjenstand for flere akademiske innsats for å optimalisere deres høye beregningskrevende ressurser, samt å adskille de fangete elementene.
Nerf er ikke (egentlig) CGI
Fordi et NeRF-miljø er et navigerbart 3D-scenarie, har det blitt en misforstått teknologi siden det oppstod i 2020, ofte bredt oppfattet som en metode for å automatisere skapelsen av mesh og teksturer, i stedet for å erstatte 3D-miljøer som er kjent for seerne fra Hollywood VFX-avdelinger og de fantastiske scenariene i Augmented Reality og Virtual Reality-miljøer.

NeRF trekker ut geometri- og teksturinformasjon fra et svært begrenset antall bildeperspektiver, og beregner forskjellen mellom bildene som voluminformasjon. Kilde: https://www.matthewtancik.com/nerf
I virkeligheten er NeRF-miljøet mer som et “live”-renderrom, hvor en sammenslåing av piksel- og lysinformasjon blir beholdt og navigert i et aktivt og kjørende neuralt nettverk.
Nøkkelen til NeRFs potensiale er at det bare krever et begrenset antall bilder for å rekonstruere miljøer, og at de genererte miljøene inneholder all nødvendig informasjon for en høy-fidel rekonstruksjon, uten behov for tjenestene til modellører, teksturkunstnere, lys-spesialister og andre bidragsytere til “tradisjonell” CGI.
Semantisk segmentering
Selv om NeRF i virkeligheten utgjør “Computer-Generated Imagery” (CGI), tilbyr det en helt annen metode, og en svært automatisert pipeline. I tillegg kan NeRF isolere og “inkapsle” bevegelige deler av en scene, så de kan legges til, fjernes, akselereres og generelt fungere som separate deler i et virtuelt miljø – en kapasitet som er langt utenfor den nåværende tilstanden for “Hollywood”-tolkning av hva CGI er.
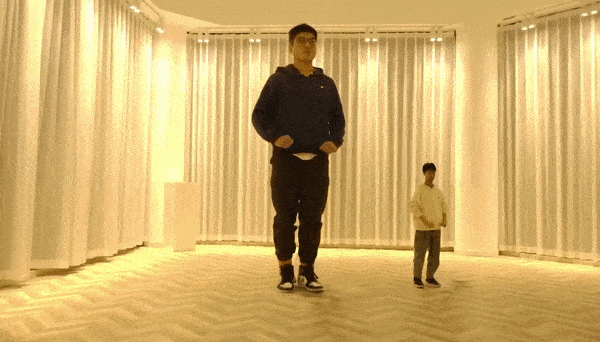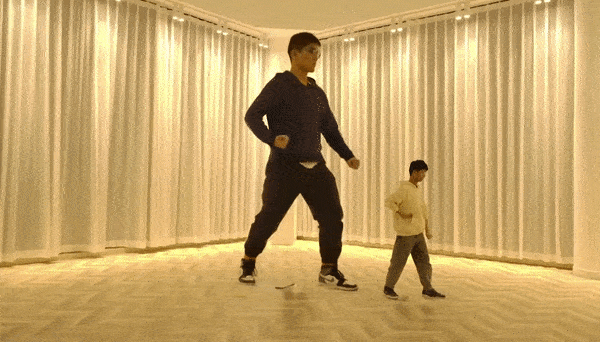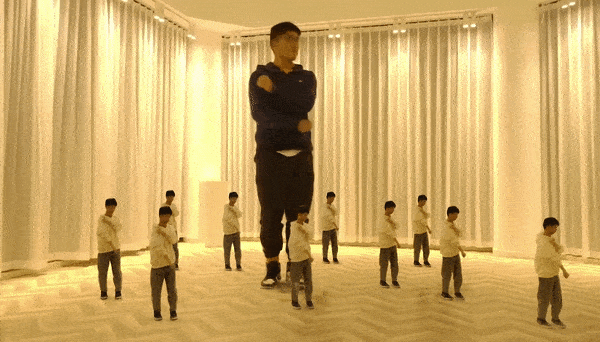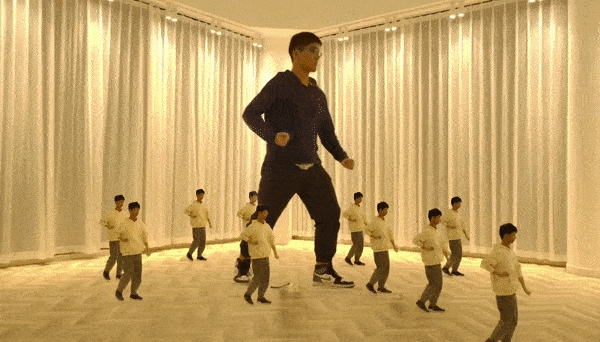
En samarbeid fra Shanghai Tech University, utgitt sommeren 2021, tilbyr en metode for å individuere bevegelige NeRF-elementer til “limende” deler for en scene. Kilde: https://www.youtube.com/watch?v=Wp4HfOwFGP4
Negativt, NeRFs arkitektur er en slags “svart boks”; det er for tiden ikke mulig å trekke ut et objekt fra et NeRF-miljø og direkte manipulere det med tradisjonelle mesh-baserte og bilde-baserte verktøy, selv om en rekke forskningsinnsats begynner å gjøre gjennombrudd i å dekonstruere matrisen bak NeRFs neurale nettverks live-renderringsmiljø.


