
Intervjuer
Mike Capps, medgrunnlegger og CEO av Diveplane – Intervju-serie

 Legg til Unite.AI blant dine foretrukne kilder på Google
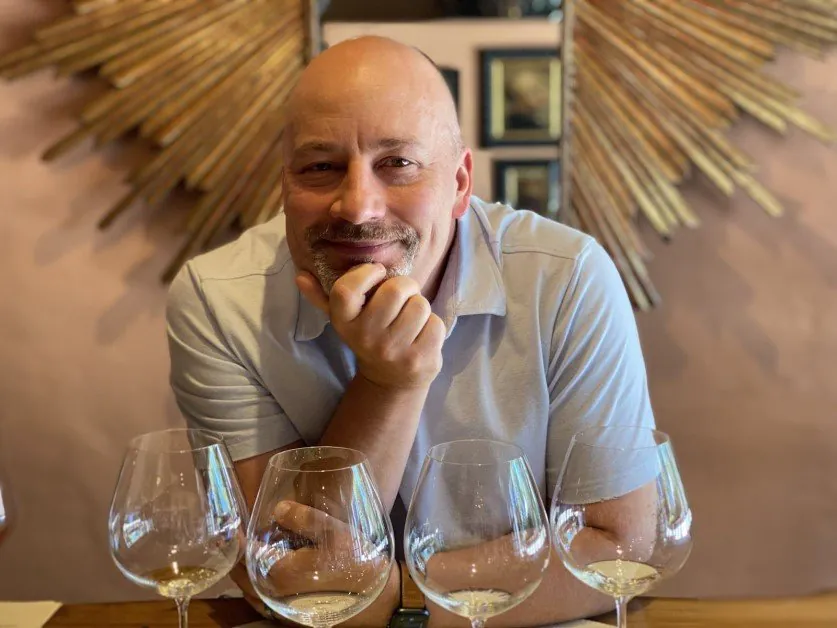
Dr. Michael Capps er en kjent teknolog og CEO av Diveplane Corporation. Før han var med på å grunnlegge Diveplane, hadde Mike en legendarisk karriere i videospillindustrien som president for Epic Games, skaperne av blockbuster-spillene Fortnite og Gears of War. Hans periode inkluderte hundre årets spill-priser, dusinvis av hovedforedrag på konferanser, en livsverk-pris og et vellykket forsvar av ytringsfriheten i videospill i USAs høyesterett.
Diveplane tilbyr AI-drevne forretningsløsninger over flere bransjer. Med seks patenter godkjent og flere under behandling, gir Diveplanes Forståelig AI full forståelse og åpenhet om beslutninger i støtte til etiske AI-politikker og strategier for personvern.
Du gikk av med pensjon fra en suksessfull karriere i videospillindustrien hos Epic Games, hva inspirerte deg til å komme ut av pensjon for å fokusere på AI?
Å lage spill var utrolig morsomt, men – på den tiden – ikke en ideell karriere når man hadde en ny familie. Jeg holdt meg beskjeftiget med styreverv og rådgivende roller, men det var ikke tilfredsstillende. Så lagde jeg en liste over tre store problemer som verden sto overfor som jeg kunne påvirke – og det inkluderte spredningen av “black-box” AI-systemer. Min plan var å bruke et år på hver å grave dypt, men noen uker senere, fortalte min briljante venn Chris Hazard meg at han hadde arbeidet hemmelig på en gjennomsiktig, fullt forklarlig AI-plattform. Og her er vi.
Diveplane ble startet med en misjon om å bringe menneskelighet til AI, kan du forklare hva dette betyr spesifikt?
Her bruker vi menneskelighet til å bety “menneskelighet” eller “medfølelse”. For å sikre at det beste av menneskeligheten er i din AI-modell, kan du ikke bare trene, teste litt og håpe det er ok.
Vi må nøye gå gjennom inndata, modellen selv og utdata fra modellen og sikre at det reflekterer det beste av vår menneskelighet. De fleste systemer trent på historiske eller virkelige data, vil ikke være korrekte første gangen og er ikke nødvendigvis upartiske heller. Vi tror at den eneste måten å rydde opp i fordommer i en modell – både statistiske feil og fordommer – er kombinasjonen av gjennomsiktighet, granskbarhet og menneskelig-forståelig forklaring.
Kjerne-teknologien i Diveplane kalles REACTOR, hva gjør denne til en ny tilnærming til å gjøre maskinlæring forståelig?
Maskinlæring innebærer vanligvis å bruke data til å bygge en modell som tar en bestemt type beslutning. Beslutninger kan inkludere vinkelen for å dreie hjulene for et kjøretøy, om å godkjenne eller avvise en kjøp eller merke det som svindel, eller hvilket produkt å anbefale til noen. Hvis du ønsker å lære hvordan modellen tok beslutningen, må du vanligvis spørre den mange lignende beslutninger og så prøve igjen å forutsi hva modellen selv kan gjøre. Maskinlærings-teknikker er enten begrensede i de innsiktene de kan tilby, avhengig av om innsiktene faktisk reflekterer hva modellen gjorde for å komme til beslutningen, eller ved å ha lavere nøyaktighet.
Å arbeide med REACTOR er ganske annerledes. REACTOR karakteriserer usikkerheten i dine data, og dine data blir modellen. I stedet for å bygge en modell per type beslutning, spør du bare REACTOR hva du ønsker den skal bestemme — det kan være noe som helst relatert til dataene — og REACTOR spør hva som er nødvendig for en bestemt beslutning. REACTOR kan alltid vise deg dataene den brukte, hvordan de henger sammen med svaret, alle aspekter av usikkerhet, kontrafaktisk resonnement og nesten alle andre spørsmål du ønsker å stille. Fordi dataene er modellen, kan du redigere dataene og REACTOR vil bli oppdatert øyeblikkelig. Den kan vise deg om det var noen data som så anomalt ut som gikk inn i beslutningen og spore hver redigering til dataene og deres kilde. REACTOR bruker sannsynlighetsteori hele veien ned, noe som betyr at vi kan fortelle deg måleenhetene for hver del av dens drift. Og til slutt kan du gjenskape og validere hver beslutning ved å bruke bare dataene som ledet til beslutningen og usikkerhetene, ved å bruke relativt enkle matematiske operasjoner uten å behøve REACTOR.
REACTOR kan gjøre all dette samtidig som den opprettholder høy konkurransedyktig nøyaktighet, spesielt for små og sparsomme datamengder.
GEMINAI er et produkt som bygger en digital kopi av en datamengde, hva betyr dette spesifikt og hvordan sikrer det personvern?
Når du matar GEMINAI en datamengde, bygger den en dyp kunnskap om den statistiske formen på dataene. Du kan bruke den til å lage en syntetisk kopi som ligner på struktur av de opprinnelige dataene, men alle postene er nytt laget. Men den statistiske formen er den samme. For eksempel vil gjennomsnittshjertefrekvensen til pasienter i begge sett være nesten den samme, likeså alle andre statistikker. Derfor vil noen data-analyse som bruker kopien gi samme svaret som de opprinnelige, inkludert trening av ML-modeller.
Og hvis noen har en post i de opprinnelige dataene, vil det ikke være noen post for dem i den syntetiske kopien. Vi fjerner ikke bare navnet – vi sikrer at det ikke finnes noen ny post som er “nær” deres post (og alle andre) i informasjonsrommet. Dvs. det finnes ingen post som er gjenkjennelig i både de opprinnelige og syntetiske settene.
Og det betyr at den syntetiske datamengden kan deles mye mer fritt uten noen risiko for å dele konfidensielle opplysninger på en uautorisert måte. Det spiller ingen rolle om det er personlige finansielle transaksjoner, pasienthelseinformasjon, sikkerhetsgraderte data – så lenge statistikken over dataene ikke er konfidensielle, er den syntetiske kopien ikke konfidensiell.
Hvorfor er GEMINAI en bedre løsning enn å bruke differensielt personvern?
Differensielt personvern er en samling teknikker som begrenser sannsynligheten for at et enkeltindivid påvirker statistikken mer enn marginalt, og er en grunnleggende del i nesten alle løsninger for personvern i data. Men når differensielt personvern brukes alene, må et personvernbudsjett for dataene håndteres, med tilstrekkelig støy lagt til hver forespørsel. Når dette budsjettet er brukt opp, kan dataene ikke brukes igjen uten å påføre personvernrisiko.
En måte å overvinne dette budsjettet på er å bruke det fulle personvernbudsjettet på en gang for å trene en maskinlæringsmodell til å generere syntetiske data. Tanken er at denne modellen, trent med differensielt personvern, kan brukes relativt trygt. Men korrekt anvendelse av differensielt personvern kan være vanskelig, spesielt hvis det er forskjellige datavolumer for forskjellige individer og mer komplekse relasjoner, som mennesker som bor i samme hus. Og syntetiske data produsert fra denne modellen er ofte sannsynlig å inkludere, ved en tilfeldighet, ekte data som en person kan hevde er deres eget fordi det er for likt.
GEMINAI løser disse problemene og mer ved å kombinere flere personvernteknikker når det syntetiserer dataene. Den bruker en praktisk form for differensielt personvern som kan håndtere en rekke datatyper. Den er bygget på vår REACTOR-motor, så den vet også sannsynligheten for at noen deler av dataene kan forveksles med hverandre, og syntetiserer dataene slik at de alltid er tilstrekkelig forskjellige fra de mest like opprinnelige dataene. I tillegg behandler den hvert felt, hver del av dataene som potensielt sensitive eller identifiserende, så den anvender praktiske former for differensielt personvern for felt som ikke tradisjonelt anses som sensitive, men som likevel kan unikt identifisere en person, som den eneste transaksjonen i en 24-timers butikk mellom 02:00 og 03:00. Vi omtaler ofte dette som kryssmakulering av informasjon for å beskytte personvernet.
GEMINAI kan oppnå høy nøyaktighet for nesten alle formål, som ligner på de opprinnelige dataene, men forhindrer at noen finner noen syntetiske data som er for likt de syntetiske dataene.
Diveplane var med på å grunnlegge Data & Trust Alliance, hva er denne alliansen?
Det er en absolutt fantastisk gruppe administrerende direktører i teknologiselskaper, som samarbeider for å utvikle og adoptere ansvarlige data- og AI-praksiser. Verdensklasse-organisasjoner som IBM, Johnson&Johnson, Mastercard (MA ), UPS, Walmart (WMT ) og Diveplane. Vi er veldig stolte av å ha vært en del av de tidlige fasene og også stolte over det arbeidet vi har gjort sammen på våre initiativer.
Diveplane har nylig samlet inn en suksessfull Series A-runde, hva vil dette bety for selskapets fremtid?
Vi har vært heldige å være suksessfulle med våre bedriftsprosjekter, men det er vanskelig å endre verden én bedrift om gangen. Vi vil bruke denne støtten til å bygge vårt team, dele vår melding og få Forståelig AI på så mange steder som mulig!
Er det noe annet du ønsker å dele om Diveplane?
Diveplane handler om å sikre at AI gjøres riktig mens det sprer seg. Vi handler om rettferdig, gjennomsiktig og forståelig AI, proaktivt viser hva som driver beslutninger og flytter oss bort fra “black-box-mentaliteten” i AI som har potensial til å være urettferdig, uetisk og fordomsfull. Vi tror at Forståelighet er fremtiden for AI, og vi er spente på å spille en avgjørende rolle i å drive det fremover!
Takk for det flotte intervjuet, lesere som ønsker å lære mer kan besøke Diveplane.



