
Andersons vinkel
Disney kombinerer CGI med nevralt rendering for å takle ‘uncanny valley’

 Legg til Unite.AI blant dine foretrukne kilder på Google
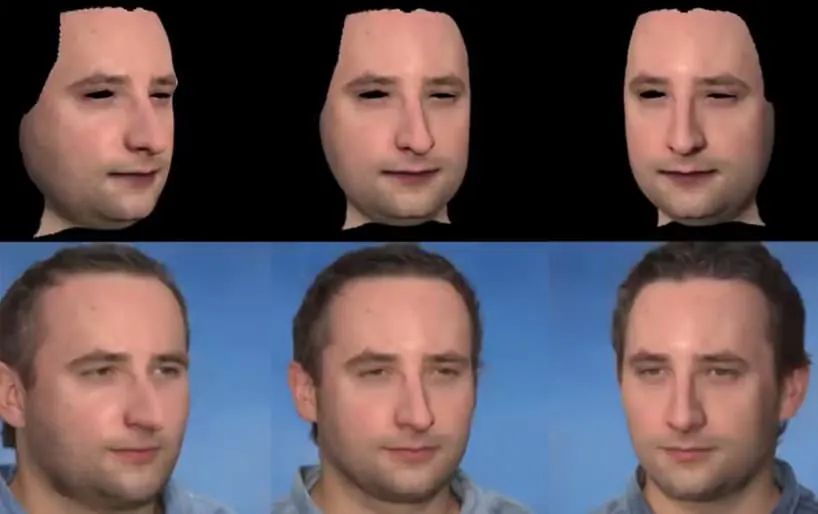
Disneys AI‑forskningsavdeling har utviklet en hybridmetode for ansiktsimulering av filmkvalitet, som kombinerer styrkene ved nevralt ansiktsrendering med konsistensen til en CGI‑basert tilnærming.
Det kommende papiret har tittelen Rendering with Style: Combining Traditional and Neural Approaches for High Quality Face Rendering, og er forhåndsvist i en ny 10‑minutters video på Disney Research YouTube‑kanal (innbedded på slutten av denne artikkelen*).
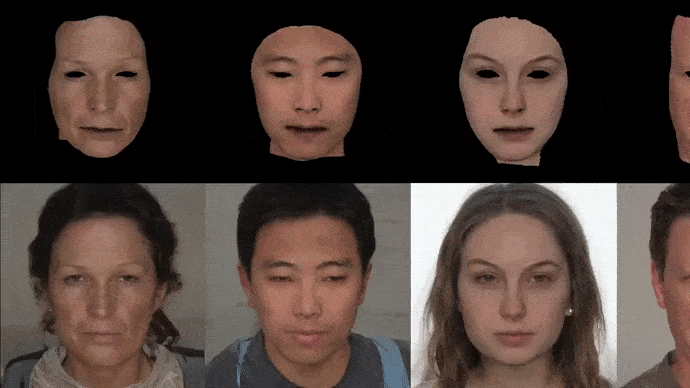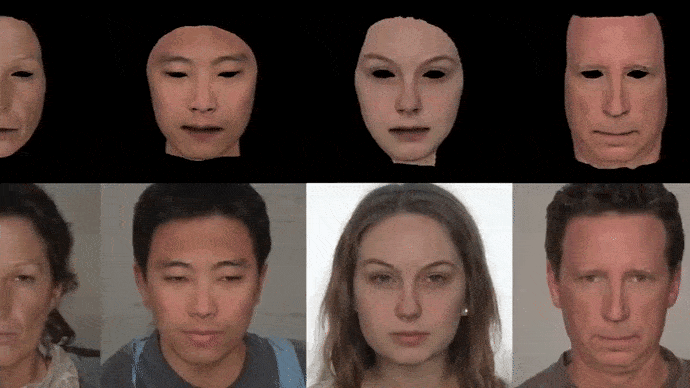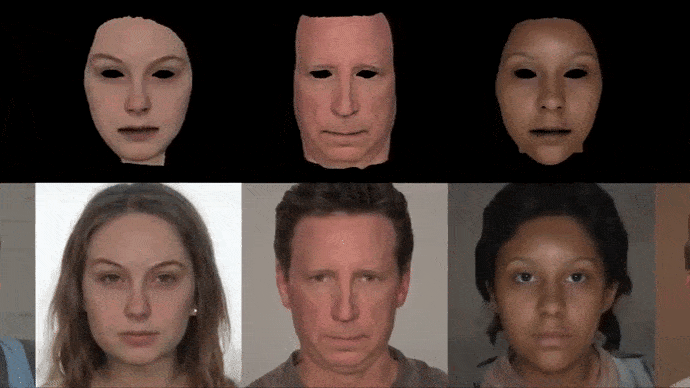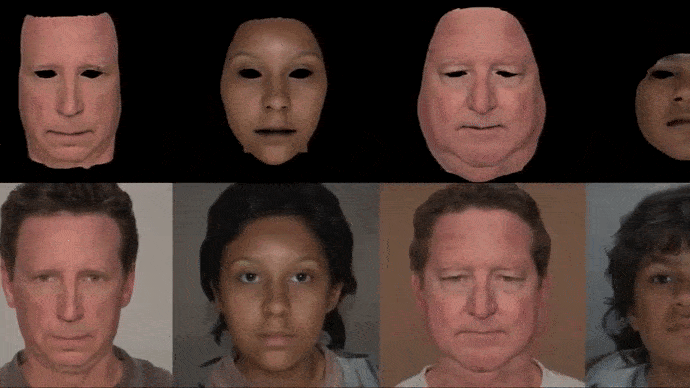
Meshes combined with neural facial renders. See video embed at end of article for better detail and quality. Source: https://www.youtube.com/watch?v=TwpLqTmvqVk
Som videoen påpeker, kan nevralt rendering av ansikter (inkludert deepfakes) produsere langt mer realistiske øyne og munninteriører enn CGI kan, mens CGI‑drevede ansiktsteksturer er mer konsistente og egnet for VFX‑produksjon på kinonivå.
Derfor eksperimenterer Disney med å la NVIDIA sin StyleGan2-generator håndtere de omkringliggende trekkene ved et ansikt og de ‘life‑critical’ elementene som øyne, mens konsistent CGI‑ansiktshud og relaterte elementer overlegges i resultatet.

From the video (see end of article), the architectural concept behind Disney’s hybrid approach, where an old-school CGI mesh, of the type used to recreate ‘young’ Carrie Fisher and the late Peter Cushing for Rogue One (2016), is integrated into neurally-rendered face environments.
Videoen gjør en implisitt referanse til den hyppige kritikken av den uautentiske og ‘uncanny valley’-effekten ved CGI‑gjenopprettingen av den avdøde britiske Star Wars-skuespilleren Peter Cushing i Rogue One (2016), og innrømmer:
‘[Det] er fortsatt et enormt gap mellom hva folk lett kan fange og rendre versus endelige fotorealistiske digitale dobbeltkopier, komplett med hår, øyne og indre munn. For å lukke dette gapet kreves det vanligvis mye manuelt arbeid fra dyktige kunstnere.’
I sannhet forsøker selv de mest moderne ansiktsfangstsystemene ikke engang å gjenskape øyne, munninteriører eller hår, som enten har autentisitetsproblemer i slike teknikker (øyne) eller problemer med tidsmessig konsistens (hår).

The video illustrates what VFX artists will get after a typical modern facial capture session. Eyes, hair, facial hair, and mouth interiors will all have to be handled by separate teams in the production pipeline, in addition to texturing and lighting.
Belysningskontroll
Den hybride tilnærmingen er også en fordel ved relighting – en betydelig utfordring for nevralt rendering av ansikter, siden CGI‑hudoverlegg kan relighters mye enklere.
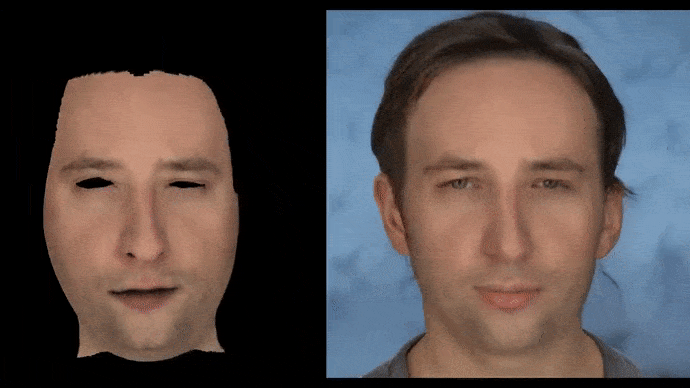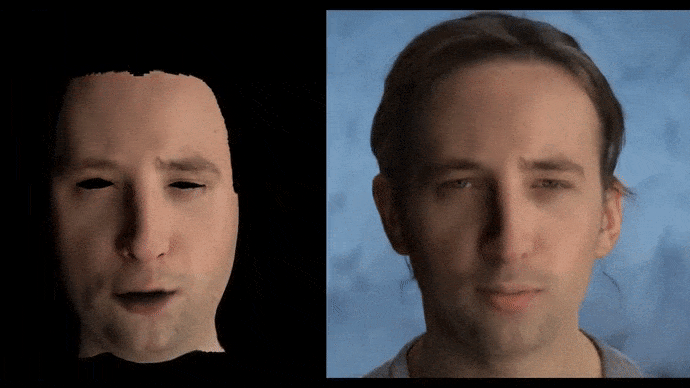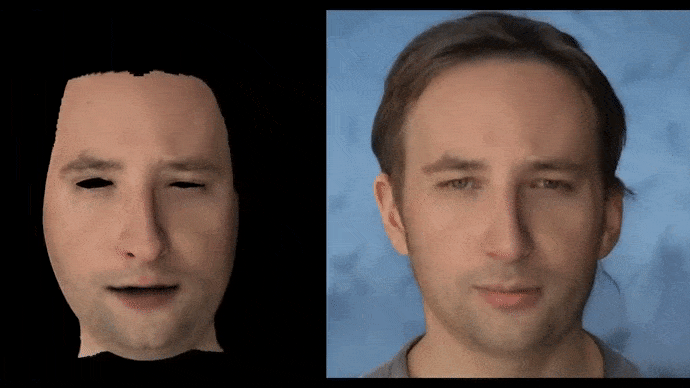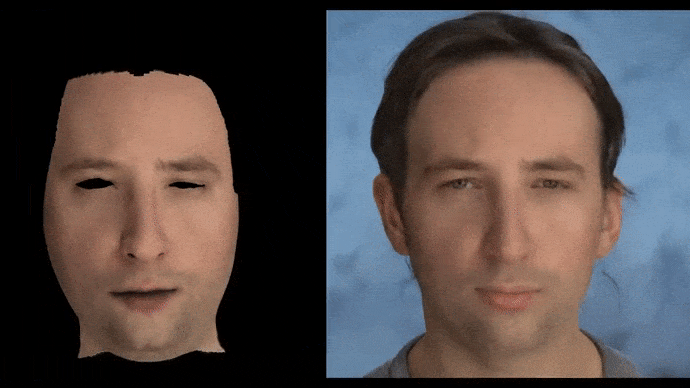
An animated version of the CGI/Neural approach.
I mer utfordrende miljøer, som utendørsopptak, har forskerne utviklet en metode for inpainting rundt en slags demilitarisert sone som omgir personen som blir ‘created’.

A black margin is generated to allow a ‘canvas’ for inpainting the outer parts of the identity and integrating the CGI skin into the combined CGI/neural output.
Videoen bemerker:
‘[Den] nevrale renderen samsvarer ikke perfekt med bakgrunnsbegrensningen – den er kun ment som en veiledning, siden optimalisering for realistiske menneskelige komponenter som hår, øyne og tenner er hovedmålet. Mer utfordrende er å prøve å opprettholde en konsistent identitet, mens miljøbelysningen endres.’
Lage CGI‑nettverk fra nevrale renderinger
Forskningsgruppen har også utviklet en variational autoencoder trent på en (uspesifisert) stor database med 3D‑ansiktsbilder, og hevder at den kan produsere ‘random but plausible’ 3D‑ansiktsnettverk fra sannhetsdata.
Det finnes begrensninger som må overvinnes, inkludert vanskeligheten med å få hår til å forbli tidsmessig konsistent i de nevrale renderings, og videoen (se nedenfor) viser flere eksempler på raskt muterende hår i en ellers konsistent panorering rundt et CGI/nevralt ansikt.
Tidsmessig konsistens i nevrale videorenderinger er et langt bredere problem enn bare Disneys, og det virker sannsynlig at senere iterasjoner av dette systemet kan ty til å legge til hår ‘in post’, eller andre mulige tilnærminger til hårgenerering i stedet for å håpe på at en ny nevralt basert metode til slutt løser det.
Bruk for datasettgenerering
Metoden foreslås også som en potensiell måte å generere syntetiske data på, og berike landskapet av ansiktsbilde‑sett, som de siste årene har blitt farlig monotont.

Disney envisages the new technique populating facial image datasets.
‘[Hvert] fotorealistisk resultat vi genererer har en underliggende tilsvarende geometri og utseendemapper, renderet fra ukjente kameravinkler med kjent belysning. Denne ‘ground truth’-informasjonen kan være avgjørende for trening av nedstrøms‑applikasjoner, som monokulær 3D‑ansiktsrekonstruksjon, ansiktsgjenkjenning eller sceneforståelse. Så hvert resultat‑render kan betraktes som en datasample, og vi kan generere mange varianter av mange ulike individer.’
‘[Videre] kan vi, selv for én person renderet i én uttrykk med én vinkel og belysning, generere tilfeldige variasjoner av det fotorealistiske renderet ved å variere randomiserings‑seed under optimaliseringen.’
Forskerne påpeker at denne mangfoldigheten i konfigurerbare resultater kan være nyttig ved trening av ansiktsgjenkjennings‑applikasjoner, og konkluderer:
‘[Vår] metode kan utnytte dagens teknologi for ansikts‑hudfangst, modellering og rendering, og automatisk skape komplette fotorealistiske ansiktsrender som matcher ønsket identitet, uttrykk og scenekonfigurasjon. Denne tilnærmingen har anvendelser innen film‑ og underholdnings‑rendering, sparer manuelt kunstnerarbeid, og også for datasettgenerering i ulike felt innen dyp læring.’
For en dypere titt på den nye tilnærmingen, sjekk ut den 10‑minutters videoen som ble publisert i dag:
* Den opprinnelige videolenken ble erstattet med en tilsynelatende identisk en 8 timer etter at denne artikkelen ble publisert. Jeg endret alle relevante lenker, ettersom det ikke finnes spor av den opprinnelige videoen.
8:24 GMT+2 – Videoen ble erstattet, da den ble byttet ut av Disney Research YouTube‑kanalen av en eller annen grunn.


