
Det beste
10 beste KI-verktøy for nettskraping (november 2026)

 Legg til Unite.AI blant dine foretrukne kilder på Google
Unite.AI kan motta betaling når du bruker lenker til produkter vi vurderer. Dette påvirker ikke våre redaksjonelle vurderinger. Les vår affiliateopplysning.
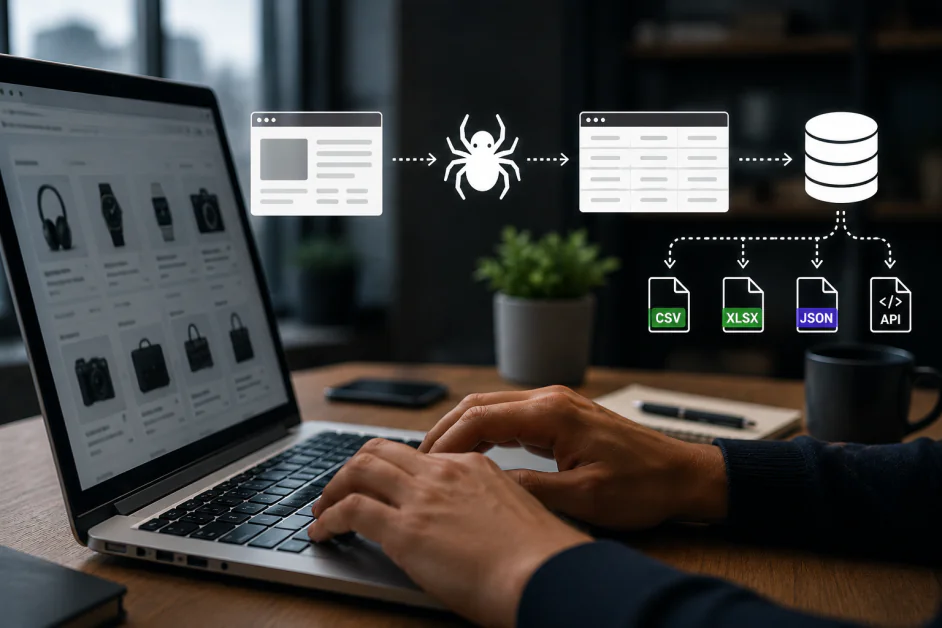
Hvilket KI-verktøy for nettskraping som passer best, avhenger av hva du vil gjøre etter at en side er lastet inn. En researchassistent trenger lesbart innhold og kildelenker. Et system for markedsinnsikt trenger ensartede dataoppføringer i stor skala. En interaktiv agent kan trenge en nettleser som kan klikke seg gjennom flere trinn og holde økten aktiv.
Denne guiden dekker ti verktøy for disse oppgavene, blant annet plattformer for datainnsamling i bedriftsskala, innholds-API-er, skrapeverktøy uten kode, tjenester for søkedata og administrerte nettlesere. Vi vurderer hvordan hvert produkt samler inn informasjon, hvem som kan vedlikeholde arbeidsflyten, og hvilke avveininger som er viktige når en prototype blir en tilbakevendende prosess.
Teamet vårt har evaluert alle løsningene i denne guiden uavhengig av hverandre og vurdert funksjonene, de praktiske styrkene, begrensningene og egnetheten for bruksområdene som gjenspeiles i rangeringene våre.
Sammenligning av de beste KI-verktøyene for nettskraping
| KI-verktøy | Best egnet for | Viktigste styrker |
|---|---|---|
| Bright Data | Datainnsamling i bedriftsskala og varierte datapipelines | Scraper APIs, Browser API, Scraper Studio, datasett, proxyer |
| Firecrawl | Nettinnhold for KI-applikasjoner | Søk, skraping, kartlegging, gjennomsøking, Markdown, JSON, Interact, MCP |
| Apify | Gjenbrukbare skrapejobber og orkestrering i skyen | Actors, Crawlee, tidsplaner, lagring, proxyer, API-er, MCP |
| Browse AI | Datainnsamling uten kode og overvåking av endringer | KI-assistert oppsett, roboter, varsler, tidsplaner, integrasjoner |
| SearchAPI | Strukturerte søkeresultater og lokalisert research | Google, Maps, shopping, video, KI-søketjenester, JSON |
| Octoparse | Visuell nettskraping med gjentakbar kjøring i skyen | Maler, AI Assistant, automatisk gjenkjenning, kjøringer i skyen, eksport |
| Browserless | Administrerte nettlesere for Puppeteer og Playwright | Nettlesere driftet i skyen, vedvarende økter, REST-API-er, MCP |
| ScrapingBee | Administrert datauthenting via et API for applikasjoner | KI-basert datauthenting, CSS/XPath, Markdown, JS-scenarioer, MCP |
| Oxylabs | Administrert innhenting fra krevende offentlige nettsteder | Web API /Scrape, gjengivelse, strukturert utdata, MCP |
| Diffbot | Automatisk datauthenting og innsikt i entiteter | Extract, standardskjemaer, Crawl, Knowledge Graph |
Slik velger du et KI-verktøy for nettskraping
Velg verktøy etter oppgaven
For en KI-kunnskapsbase bør du prioritere lesbar tekst, strukturerte data og bevarte kilde-URL-er. Til gjentakbar bedriftsresearch kan en visuell robot og varsler om endringer være viktigere enn et programmeringsgrensesnitt. For en interaktiv agent bør du se på kontinuitet i økten og nettleserkontroll. API-er for søkeresultater løser en annen oppgave: De leverer søkedata, mens innsamling av sidene det lenkes til, er et eget trinn.
Avklar hvem som har ansvaret for arbeidsflyten
En plattform uten kode lar en analytiker justere trinnene for datauthenting direkte. Et API gir utviklere et ryddig grensesnitt for å integrere datainnsamlingen i en applikasjon. En skyplattform for jobber legger til planlegging og lagring, mens en administrert nettleser lar teamet ditt stå for en større del av automatiseringslogikken. Det riktige valget legger vedlikeholdet i hendene på dem som forstår både kildenettstedene og hvilke data som kreves.
Budsjetter for nyttige dataoppføringer, ikke oppgitte antall forespørsler
Sammenlign kostnaden for en fullført jobb med feltene du trenger. Gjengivelse, premium-proxyer, nettleserens varighet, KI-basert datauthenting, lagring og gjentatte forsøk kan påvirke totalen. En gratis kreditt, en nettleserenhet og en søkeforespørsel er ulike måleenheter. Ved tilbakevendende arbeid bør du følge med på fullstendighet, duplikater, aktualitet og kostnad per brukbar dataoppføring, i tillegg til vellykkede svar.
De 10 beste KI-verktøyene for nettskraping
1. Bright Data
Bright Data er vår samlede anbefaling for organisasjoner som trenger flere måter å hente inn nettdata på innenfor én plattform. Utvalget omfatter ferdige Scraper API-er, forhåndsinnsamlede datasett, Scraper Studio, Web Unlocker og proxy-tjenester. Et team som arbeider med innsikt i netthandel, kan for eksempel bruke strukturerte datafeeder for kjente forhandlere og samtidig utvikle tilpasset datainnsamling for en spesialisert markedsplass. Denne bredden gjør løsningen særlig nyttig når dataprogrammet omfatter mer enn ett nettsted eller én avdeling.
For interaktive nettsider tilbyr Browser API nettlesere som utviklere kan styre med Puppeteer, Playwright eller Selenium. Tjenesten kombinerer nettleserkjøring med proxyadministrasjon og CAPTCHA-håndtering, mens støtte for Chrome DevTools hjelper utviklere med å undersøke økter som skaper problemer. Dette er nyttig når en arbeidsflyt krever navigering eller samhandling med siden før den ønskede informasjonen blir tilgjengelig, i stedet for bare å laste ned et eksisterende datasett.
Den viktigste avveiningen gjelder valg av produkter og kostnadsstyring. Nettlesertrafikk, skraperesultater og kjøp av datasett representerer ulike arbeidsmengder, så én enkelt veiledende pris kan ikke beskrive hele plattformen. Bright Data passer for team der noen har ansvar for innsamlingskvalitet, dekning av målene og kostnadene. Et prosjekt med snevert omfang kan komme raskere i produksjon med et enklere API for datauthenting.
Fordeler og ulemper
- Mange innsamlingsmuligheter samlet i én plattform
- Vertsbaserte nettlesere støtter etablerte automatiseringsbiblioteker
- Ferdige API-er og datasett gjør oppsettet raskere
- Ulike produkter krever separat kostnadsplanlegging
- Egendefinerte arbeidsflyter krever fortsatt teknisk oppfølging
2. Firecrawl
Firecrawl er vårt førstevalg for utviklere som gjør nettinnhold om til nyttig kontekst for en KI-applikasjon. Verktøyene for søk, skraping, kartlegging og gjennomgang dekker hele prosessen fra å finne en side til å samle innhold fra et nettsted. Markdown og strukturert JSON reduserer behovet for opprydding etter innhentingen. Dermed kan en forskningsassistent eller et kunnskapsbaseprodukt bruke mer tid på å besvare spørsmål og mindre tid på å fjerne navigasjonsmenyer fra rå HTML.
Det nåværende tilbudet Interact utvider plattformen med arbeid i nettleseren i sanntid. Agenter kan beskrive handlinger med naturlig språk eller kjøre nettleserkode, bevare tilstanden mellom kall og gjenbruke autentiserte profiler. Dette er et betydelig tillegg for sider der det kreves klikk, filtre eller innlogging før data kan hentes ut. Tilgang via MCP og kommandolinjen gjør også Firecrawl praktisk i arbeidsflyter for utvikling av agenter, ikke bare som et vanlig API for applikasjoner.
Firecrawl fungerer best når innhenting av innhold er den umiddelbare utfordringen, og applikasjonen allerede håndterer lagring og gjenfinning. Team må fortsatt definere grensene for gjennomgangen, bevare kilde-URL-er og skille mellom et manglende felt og et tomt felt. Åpen kildekode gir en alternativ utrullingsmulighet, men team bør vurdere funksjonene og driftskravene for utrullingen de velger, i stedet for å anta at skyversjonen og den selvadministrerte versjonen er identiske.
Fordeler og ulemper
- Markdown og JSON egner seg for KI-arbeidsflyter
- Interact støtter nettleseroppgaver som bevarer tilstanden
- Tilgang via API, MCP og CLI
- Innhentet innhold må fortsatt valideres
- Selvadministrerte utrullinger krever driftsarbeid
3. Apify
Apify er det sterkeste alternativet her for team som ønsker gjenbrukbare skrapeverktøy og et sted å drifte dem. Markedsplassen distribuerer Actors: pakkede programmer som tar imot inndata, kjøres i skyen og returnerer resultater. Eksisterende Actors kan effektivisere vanlige innsamlingsoppgaver, mens egendefinerte Actors gir utviklere mulighet til å bevare sin egen logikk for datauthenting. Dermed fungerer Apify som et nyttig bindeledd mellom et eksperiment og en repeterbar produksjonsjobb.
Plattformen håndterer også viktige driftsoppgaver, blant annet planlegging, lagring av resultater, proxytilgang, overvåking og integrasjoner. Utviklere kan dessuten bygge med Crawlee, biblioteket for gjennomgang og nettleserautomatisering med åpen kildekode. Apifys MCP-server gjør Actors tilgjengelige for KI-agenter, slik at det samme pakkede verktøyet kan brukes i en applikasjon, en planlagt arbeidsflyt eller en assistent uten at det må utvikles en egen skrapeløsning for hvert grensesnitt.
Valget av Actor fortjener like mye oppmerksomhet som valget av plattform. Ulike utgivere kan tilby forskjellig prising, vedlikehold, inndataalternativer og datakvalitet. En vellykket kjøring er heller ingen garanti for at alle forventede oppføringer ble samlet inn. Apify er mest attraktivt når noen har ansvar for jobbens skjema, overvåker endringer og budsjetterer for den valgte Actor-en og bruken av infrastrukturen. En manuell uthenting fra én enkelt side trenger sjelden så omfattende orkestrering.
Fordeler og ulemper
- Ferdige og egendefinerte Actors bruker samme plattform
- Planlegging, lagring og overvåking støtter repeterbare jobber
- MCP integrerer Actors i agentarbeidsflyter
- Vedlikehold og kvalitet varierer mellom Actors
- Kostnader for bruk og Actors må budsjetteres
4. Browse AI
Browse AI er vårt anbefalte valg for bedriftsbrukere som trenger tilbakevendende webdata uten å måtte utvikle et programvareprosjekt. Med dagens oppsett kan verktøyet lese en oppgitt side, foreslå en datastruktur og la brukeren gå gjennom eller justere feltene. Opplæring av roboter er fortsatt sentralt for å kunne hente ut data på en gjentakbar måte. Dette er en praktisk tilnærming for drifts- og markedsføringsteam som samler produktoppføringer, katalogoppføringer eller konkurrentinformasjon i velkjente tabeller.
Overvåking er en av verktøyets klare styrker. Roboter kan sjekke sider etter en tidsplan, oppdage nye elementer eller endringer og sende varsler som forklarer hva som er endret. Arbeidsflyter kan koble sammen innsamling fra flere sider, mens integrasjoner med API-er, webhooks og regneark gjør det enklere å sende resultatene til verktøyene teamet allerede bruker. En arbeidsflyt for priso overvåking kan dermed bli en løpende forretningsprosess i stedet for en rekke manuelle nettlesersjekker.
At verktøyet er lett tilgjengelig, fjerner ikke behovet for en tydelig definisjon av dataene. Brukerne bør avgjøre hvilke endringer som skal utløse et varsel, og kontrollere at paginering, innloggingstrinn og tomme resultater fungerer som de skal. Store redesign kan fortsatt kreve manuelt arbeid. Browse AI passer best når et bedriftsteam kan gjennomgå de uttrukne radene og vedlikeholde roboten. Utviklere som trenger nettleserlogikk med streng versjonskontroll, foretrekker kanskje en kodebasert tjeneste.
Fordeler og ulemper
- KI-assistert oppsett av felt gjør det enklere å komme i gang
- Planlagt overvåking fremhever viktige endringer
- Tilkoblinger til regneark, API-er og webhooks
- Store endringer på nettsteder kan kreve ny opplæring
- Kompleks logikk krever nøye utforming av arbeidsflyten
5. SearchAPI
SearchAPI er vårt spesialistanbefalte valg for å samle søkeresultater som strukturerte data. Google-API-et kan returnere resultatlenker og søkefunksjoner i JSON, slik at man slipper å vedlikeholde en parser for en resultatside som stadig endres. Den bredere katalogen omfatter kilder som Kart, shopping, nyheter, video og støttede KI-søkeopplevelser. Verktøyet er særlig nyttig når oppdagelse og synlighet i søk er selve dataproduktet, og ikke bare et springbrett til å gjennomsøke et annet nettsted.
Lokaliseringsmulighetene er en viktig del av dette. Parametere for sted, land, språk og enhet gjør det mulig for team å undersøke et marked ut fra en definert søkekontekst. En SEO-applikasjon kan spore et søk i én by, mens en forskningsassistent kan finne relevante kilder og ta vare på de returnerte lenkene for senere bruk. Dokumentasjon for hver enkelt søkemotor er viktig fordi tilgjengelige parametere og resultatfelt varierer mellom søkeproduktene.
SearchAPI bør velges ut fra søkemotorene og feltene arbeidsflyten faktisk trenger. Et søkeresultat inneholder ikke hele innholdet på den lenkede siden, og mer innholdsrike resultatvisninger følger ikke alle samme skjema. Team bør budsjettere for forespørselsvolumet, avklare kravene til gjennomstrømning og håndtere manglende resultatdeler på en god måte. For uthenting av data fra vilkårlige nettsteder eller en interaktiv nettleserøkt er et annet verktøy i denne guiden et bedre utgangspunkt.
Fordeler og ulemper
- Strukturerte resultater eliminerer vedlikehold av SERP-parsere
- Omfattende katalog over søkemotorer og relaterte tjenester
- Detaljerte lokaliseringsinnstillinger
- Søkeresultater erstatter ikke uthenting av data fra målsiden
- Felter og parametere varierer mellom søkemotorer
6. Octoparse
Octoparse viser frem AI Copilot og automatisering med menneskelig medvirkning. Video: Octoparse.
Octoparse passer godt for analytikere som vil utforme en skraper visuelt og deretter kjøre den gjentatte ganger. Den nåværende plattformen tilbyr ferdige maler, oppsett med AI Assistant og automatisk sidegjenkjenning i skrivebordsprogrammet. Brukerne kan finjustere den resulterende oppgaven i stedet for å begynne med nettleserkode. Denne fleksibiliteten er nyttig når man samler inn produktkataloger, kataloger eller oppføringer der rekkefølgen på sidene er like viktig som feltene på hver side.
Kjøring i skyen gjør en klargjort oppgave om til en tilbakevendende innsamlingsprosess uten at en personlig datamaskin må stå på. Planlegging, parallellkjøring, IP-rotasjon og eksportintegrasjoner gjør det enklere å håndtere større jobber enn det en skrivebordsprototyp kan klare. Den visuelle tilnærmingen er særlig attraktiv for team som kjenner kildenettstedene og datakravene sine, men ikke ønsker å vedlikeholde en egen tjeneste for nettleserautomatisering.
Octoparse belønner fortsatt grundig utforming av oppgaver. Paginering, endeløs rulling, skjematrinn og dupliserte poster kan endre betydningen av en tilsynelatende vellykket kjøring. Kvoter for skybruk og funksjoner i abonnementet bør passe til den planlagte tidsplanen og datamengden. Vi anbefaler verktøyet når et team ønsker større kontroll over uthentingstrinnene enn et raskt ettklikksverktøy gir, og har en navngitt ansvarlig som kan justere oppgaven når kildesidene endres.
Fordeler og ulemper
- Maler og KI-assistanse forenkler oppsettet
- Visuell redigering støtter detaljerte datauthentingsoppgaver
- Skykjøringer støtter planlagt datainnsamling
- Komplekse nettsteder krever at oppgaven finjusteres
- Skyfunksjoner avhenger av valgt abonnement
7. Browserless
Vi anbefaler Browserless til utviklere som vil styre en nettleser, men overlate hosting og skalering til en administrert tjeneste. Eksisterende skript for Puppeteer eller Playwright kan kobles til eksterne nettlesere, noe som gjør løsningen attraktiv for prosjekter som allerede har fungerende automatiseringskode. Dette er særlig nyttig når innsamlingen omfatter flere interaksjoner, et grensesnitt med mye JavaScript eller en økt som må vare lenger enn én enkel forespørsel.
Tjenesten tilbyr også REST-API-er for skraping, skjermbilder, PDF-er og egendefinerte nettleserfunksjoner. Den vertsbaserte MCP-serveren gjør nettleserverktøy tilgjengelige for AI-agenter, mens øktfunksjoner og autentiserte profiler støtter arbeidsflyter som krever kontinuitet. Browserless passer derfor både for utviklere som bygger egne datainnsamlere, og for agenter som trenger å navigere og hente informasjon gjennom en ekte nettleser.
Det viktigste å vurdere ved kjøp er hvordan nettleserbruken måles. Gratisnivået omfatter for tiden 1 000 enheter per måned og to samtidige nettlesere, ikke 1 000 garanterte skrapinger. Nettlesertiden bruker enheter, og det kommer tilleggskostnader for proxytrafikk og vellykkede CAPTCHA-løsninger; øktbegrensningene varierer etter abonnement. Teamene har fortsatt ansvaret for uttrekkslogikken og kontrollen av resultatene, så Browserless er mest aktuelt når kontroll over nettleseren er viktigere enn en visuell robotbygger.
Fordeler og ulemper
- Bevarer velkjente arbeidsflyter for Puppeteer og Playwright
- REST-API-er dekker skraping og eksport av sider
- Øktfunksjoner og MCP passer for interaktive agenter
- Nettlesertid og tillegg påvirker enhetsforbruket
- Egendefinerte datauttrekk krever fortsatt applikasjonslogikk
8. ScrapingBee
ScrapingBee er et godt valg for utviklere som ønsker en administrert skrapingsforespørsel i stedet for direkte kontroll over en nettleser som kjører over lengre tid. API-et kombinerer henting av nettsider og JavaScript-gjengivelse med proxyadministrasjon, mens data kan hentes ut ved hjelp av CSS- eller XPath-regler eller AI-instruksjoner. Denne kombinasjonen er nyttig når et prosjekt trenger strukturerte data fra flere nettsteder, men ikke ønsker å drifte sin egen nettleserpark.
JavaScript-scenarier kan klikke, rulle, skrive eller vente før dataene samles inn. Utdata i Markdown-format støtter AI-arbeidsflyter for innhold, og skjermbilder gjør det enklere å fange den gjengitte siden. Det nåværende produktet tilbyr også egne API-er for utvalgte mål, i tillegg til tilgang via CLI og MCP. En utvikler kan bruke eksplisitte uttrekksregler for stabile felt og uttrekk med naturlig språk når sidens struktur eller spørsmålet er mindre forutsigbart.
Forskjellen fra en vertsbasert nettleserplattform er praktisk: ScrapingBee legger vekt på forespørselen og resultatet den returnerer, mens en egendefinert applikasjon håndterer den større jobben. Koordinering av flere sider, deduplisering, oppdateringsplaner og validering av data må fortsatt håndteres et sted. Kredittforbruket varierer også med funksjonene som brukes, blant annet gjengivelse og proxyvalg. Vi anbefaler løsningen til applikasjonsteam som setter pris på et enkelt HTTP-grensesnitt, og som vil håndtere orkestreringen av datapipelinen i sin egen kode.
Fordeler og ulemper
- Velgerregler og AI-uttrekk gir fleksibilitet
- Gjengivelse og scenarier håndterer interaktive sider
- Markdown, CLI og MCP støtter AI-arbeidsflyter
- Avanserte forespørselsalternativer øker kredittforbruket
- Jobber med flere sider krever fortsatt orkestrering
9. Oxylabs
Oxylabs er et godt alternativ for team som ønsker administrert tilgang til krevende offentlige nettsteder og mulighet til å samle inn større datamengder. Den nåværende Web API-en omfatter /Scrape, som henter og strukturerer nettdata, med JavaScript-gjengivelse og tilgangshåndtering integrert i tjenesten. Produktutvalget omfatter også /Search og nettleserinfrastruktur, slik at team kan velge mellom flere tilnærminger avhengig av om oppgaven begynner med søk, datauttrekk eller interaksjon.
Målspesifikke alternativer hjelper vanlige søke- og handelsnettsteder med å returnere nyttige felt, mens tilkoblinger for agenter via MCP og Agent Skills integrerer datainnsamlingen i AI-arbeidsflyter. Oxylabs fortsetter også å dokumentere Classic Web Scraper API separat. Dette er viktig for eksisterende integrasjoner: Team som vedlikeholder Classic API, bør bruke den tilhørende dokumentasjonen i stedet for å anta at et eksempel for den nyere Web API-en kan brukes om hverandre.
Oxylabs er mest aktuelt når vanskelige mål, gjennomstrømning eller kostnadene ved å vedlikeholde tilgangsinfrastruktur gjør en administrert plattform verdt det. Applikasjonen må fortsatt definere ønsket skjema, hvor ferske dataene skal være, og hvordan ufullstendige poster skal håndteres. Før utrulling bør dere sørge for at valgt API-generasjon, målspesifikke alternativer og bruksmodell passer til den faktiske jobben. For et lite, manuelt datauttrekk kan en visuell skraper være et mer direkte valg.
Fordeler og ulemper
- Administrert infrastruktur for gjengivelse og tilgang
- Målrettede alternativer for strukturert datauttrekk
- Den nåværende Web API-en støtter agentintegrasjoner
- Klassiske og nåværende API-er krever ulike oppsett
- Utdataenes kvalitet må fortsatt kontrolleres i applikasjonen
10. Diffbot
Diffbot er vårt valg når det er viktigere å forstå informasjonen på en side enn å gjenskape oppsettet. Extract bruker datasyn og naturlig språkbehandling til å klassifisere sider og produsere strukturert JSON i henhold til standardskjemaer. For et team som samler inn artikler eller produkter fra mange kilder, kan dette redusere mengden nettstedsspesifikk kode for datauttrekk som trengs for å gjøre sidene om til sammenlignbare oppføringer.
Knowledge Graph dekker et beslektet, men separat behov: å arbeide med enheter som organisasjoner, personer og artikler som allerede er samlet inn fra det offentlige nettet. Oppføringer kan kombinere informasjon fra flere kilder og knytte enheter sammen gjennom meningsfulle relasjoner. Dette gjør Diffbot nyttig for berikelse, selskapsundersøkelser og analyse- og etterretningsapplikasjoner som trenger kontekst utover feltene som vises på én side.
Avveiningen handler om hvor godt løsningen passer med Diffbots datamodell. Standardisert datauttrekk er verdifullt når sidetypene og feltene samsvarer med oppgaven, men uvanlige felt eller spesialiserte samhandlinger kan fortsatt gjøre en annen tilnærming nødvendig. Team bør skille mellom å hente ut data fra nettadressene de har valgt, og å søke i en eksisterende kunnskapsgraf, og deretter vurdere dekning og hvor oppdaterte kildene er. Diffbot passer bedre for tekniske team som bygger normaliserte informasjonsprodukter, enn for brukere som bare trenger noen få rader kopiert til et regneark.
Fordeler og ulemper
- Automatisk klassifisering reduserer arbeidet med å lage parsere
- Standardskjemaer gjør det enklere å normalisere lignende sider
- Knowledge Graph gir kontekst om enheter
- Standardfeltene dekker kanskje ikke spesialiserte behov
- Datauttrekk og tilgang til kunnskapsgrafen dekker ulike arbeidsflyter
Ofte stilte spørsmål
Hva gjør et verktøy for nettskraping KI-drevet?
KI kan bidra til å identifisere felt, tolke sideinnhold, generere trinn for datauttrekk eller styre handlinger i nettleseren. Noen verktøy bruker KI under oppsettet, mens andre bruker det ved hvert datauttrekk. En tjeneste kan også støtte KI-applikasjoner ved å levere rent innhold uten å bruke en språkmodell for hver forespørsel. Velg funksjonen som løser innsamlingsbehovet ditt, i stedet for å stole på betegnelsen.
Hva er forskjellen mellom nettskraping og nettleserautomatisering?
Nettskraping samler inn informasjon. Nettleserautomatisering utfører handlinger på sider, for eksempel å åpne menyer, skrive inn et søk eller gå gjennom en arbeidsflyt med flere trinn. De brukes ofte sammen: En automatisert nettleser åpner den relevante sidetilstanden, og deretter henter et datauttrekk ut feltene. En direkte API-forespørsel er som regel enklere når slike samhandlinger ikke er nødvendige.
Hvilke verktøy passer best for et team uten teknisk kompetanse?
Browse AI er vår første anbefaling for enkel, gjentakende innsamling og overvåking av endringer. Octoparse er et godt alternativ når teamet ønsker mer visuell kontroll over oppgavetrinnene. Begge fungerer best når noen gjennomgår resultatene og forstår når kildenettstedet har endret seg.
Hva bør en KI- eller RAG-pipeline ta vare på fra et nettskrap?
Ta vare på kildenettadressen, innsamlingstidspunktet, sidetittelen og teksten eller de strukturerte feltene applikasjonen trenger. Markdown kan bevare en lesbar dokumentstruktur, mens JSON støtter definerte oppføringer. Fjern duplisert innhold, og unngå å blande navigasjonstekst med hovedinnholdet. Når opphavsinformasjonen bevares, blir det enklere å spore og oppdatere senere svar.
Når lønner det seg å bruke en administrert nettleser?
En administrert nettleser er nyttig når innsamlingen krever JavaScript-kjøring, flere samhandlinger eller kontinuitet i økten, og teamet vil unngå å drifte nettleserprosesser selv. Browserless er et målrettet alternativ for eksisterende Puppeteer- eller Playwright-kode. For én enkelt statisk side kan et enklere hente- eller datauttrekks-API bruke færre ressurser.
Er 1 000 gratisenheter det samme som 1 000 nettskrap?
Nei. Hver leverandør har egne regler for enheter og kreditter. Browserless måler nettlesertilkoblinger i intervaller på opptil 30 sekunder, og proxytrafikk og løsning av CAPTCHA-er bruker i tillegg enheter. Andre tjenester tar betalt ut fra forespørselsalternativer, oppføringer eller databehandling. Beregn kostnaden for hele arbeidsflyten i stedet for å likestille ulike gratiskvoter.
Kan man stole på resultatet av et KI-basert datauttrekk uten å kontrollere det?
Et gyldig JSON-svar kan likevel utelate en oppføring eller feiltolke et felt. Definer obligatoriske felt, kontroller datatyper og verdiområder, stikkprøvekontroller kildesidene og følg med på endringer i antall oppføringer. For gjentakende jobber er tydelige tilstander for feil og tomme resultater mer nyttige enn å behandle hvert svar som et komplett datasett.
Avsluttende tanker om KI-verktøy for nettskraping
Bright Data er vårt beste helhetsvalg for et bredt program for innsamling av webdata, mens Firecrawl er det beste utgangspunktet for å gjøre nettsider om til KI-klart innhold. Velg Apify når gjenbrukbare verktøy, planlagte jobber og drift i skyen står sentralt i prosjektet.
For bedriftsteam gjør Browse AI løpende overvåking lett tilgjengelig, mens Octoparse gir brukerne en visuell måte å finjustere mer omfattende datauthentingsoppgaver på. SearchAPI er spesialistvalget når resultatet må være strukturerte søkedata.
Browserless fortjener sin plass for utviklere som ønsker administrert nettleserkjøring med velkjente automatiseringsbiblioteker. ScrapingBee er et godt alternativ når en administrert forespørsel om datauthenting passer bedre til applikasjonen. Oxylabs egner seg for krevende innhenting fra det åpne nettet, mens Diffbot skiller seg ut med standardisert datauthenting og entitetsintelligens.
Det beste langsiktige valget er det som leverer informasjonen dere trenger, med en arbeidsflyt teamet kan vedlikeholde. Tilpass innsamlingsmetoden til oppgaven, ta vare på konteksten fra kildene, og vurder verdien ut fra hvor anvendelige resultatene er – ikke hvor mange sider dere har bedt om.




