
Intervjuer
Ben Koska, grunnlegger og CEO av SF Tensor – Intervju-serie

 Legg til Unite.AI blant dine foretrukne kilder på Google
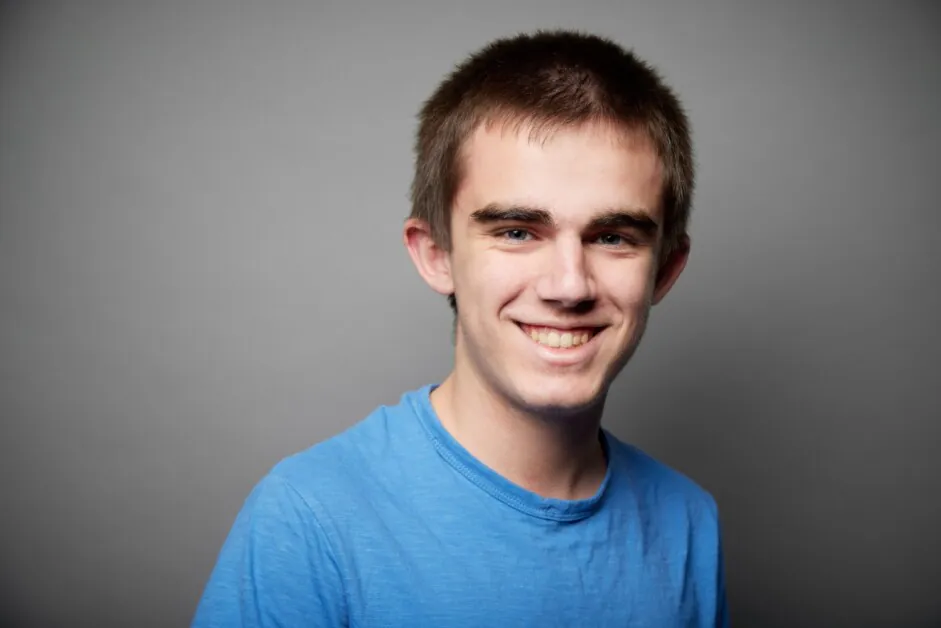
Ben Koska, grunnlegger og CEO av SF Tensor, er en AI-forsker og systemingeniør kjent for sitt arbeid med høy-ytelses beregning, kernel-optimisering og effektiv modelltrening. Hans bakgrunn omfatter utvikling av lav-nivå AI-infrastruktur, forbedring av trenings-gjennomstrømming og design av verktøy som gjør avansert modellutvikling tilgjengelig uten tungvinte ingenør-overhead. Han fokuserer på å bygge systemer som presser grensene for hastighet, bærekraft og pålitelighet på heterogene maskinvare.
SF Tensor er selskapet han leder for å gjøre denne filosofien til en praktisk plattform. Det introduserer en samlet programmeringsmodell, en kernel-optimizer og en tverr-sky-koordineringslag som er designet for å fjerne kompleksiteten av distribuert AI-arbeidsbelastning. Plattformen har som mål å gi ingeniører en ren, maskin-uavhengig miljø hvor de kan skrive en gang, distribuere overalt og automatisk oppnå høy ytelse. SF Tensors misjon er å gjøre AI-beregning dramatisk raskere, enklere å håndtere og fri fra leverandør-lås.
Du grunnla SF Tensor bare 19 år gammel, etter å ha ledet ingeniør-arbeid i flere startup-selskaper. Hva inspirerte deg til å ta på deg utfordringen med å gjøre om AI-infrastruktur så tidlig i din karriere?
Problemet vi løser er et som jeg bryr meg dypt om, fordi det er et som jeg selv har møtt. Når vi utviklet det som nå er SF Tensors kjerne-stakk, arbeidet vi ikke på et kommersielt prosjekt, det var faktisk et akademisk prosjekt. Vi hadde mottatt en bevilgning til å utføre noen veldig interessante forskning, men tilbrakte det meste av tiden vår med å håndtere infrastruktur og optimaliseringer, i stedet for å gjøre forskning. Vi fant ut at folk var universelt mer interessert i vår infrastruktur-teknologi, enn i vårt forskningsprosjekt.
SF Tensor tar på seg ett av de tøffeste problemene i AI — å bryte fri fra NVIDIAs CUDA-dominans. Hvordan nærmet du deg å designe et system som kunne oppnå sannt hardware-portabilitet uten å kompromittere ytelse
Til slutt handler all AI om enkle matematiske beregninger. Hver modell er i realiteten en samling av matematiske operasjoner som vi må beregne resultater for. Ved å behandle det primært som et matematisk problem i stedet for et datavitenskapelig problem, kan vi identifisere den minste mengden begrensninger på beregningene, og deretter generere millioner til milliarder av forskjellige måter å omdanne disse beregningene til maskinkode, og finne den raskeste. Dette er lettere sagt enn gjort, siden vi ikke kan faktisk kjøre millioner av forskjellige programmer for å finne den raskeste, så for å kutte ned vår søke-rom, måtte vi komme opp med en nøyaktig matematisk modell for å anslå hastigheten på en gitt program for en gitt maskinvare, som er en av de viktigste innovasjonene som gjør det mulig for oss å gjøre det vi gjør i dag.
Selskapets blogg fremhever innovasjoner rundt compiler-optimisering og tverr-sky-koordinering. Kan du forklare hvordan SF Tensors tilnærming skiller seg fra eksisterende rammeverk som PyTorch eller JAX?
Vi har ikke skrevet en teknisk blogg om det enda, men vi støtter faktisk rammeverk som PyTorch og JAX, og lar kode skrevet i disse rammeverkene bli optimert av vår stakk. Det er flere arkitektoniske beslutninger som JAX og PyTorch har tatt som skiller dem fra vår stakk, men den viktigste er at vi behandler hele modellen som en enkelt beregning som skal løses, i stedet for individuelle moduler som må bli individuelt og deretter felles optimert. For dette formål, i stedet for å bruke tradisjonelle compiler-optimiseringsteknikker og prøve å anvende hver enkelt optimalisering, skaper vi et søke-rom av millioner til noen ganger milliarder av potensielle kjerner og hevder at ingen menneske kan muligens komme opp med en sett av regler for å omdanne en gitt kode til den raskeste, så vi må i stedet bare skape hver kombinasjon og deretter identifisere den raskeste.
Mange startup-selskaper fokuserer på trenings-effektivitet, men du har betonet “infrastruktur-avgiften” — tiden forskerne mister med å håndtere beregning i stedet for å innovere. Hvordan adresse SF Tensor denne ubalansen?
Vi tror at begge problemene må løses, og mye av vårt arbeid går til å løse trenings-effektivitet, men det mest akutte problemet som vi kan løse nå uten å være avhengig av fremtidige innovasjoner er infrastruktur-avgiften, siden det er et problem som vi allerede har løst for oss selv.
Du har nevnt å oppnå opp til 80% reduksjon i trenings-kostnader. Hvilke spesifikke optimaliseringer eller arkitektoniske gjennombrudd gjør dette mulig?
Vår hele programvare-stakk er bygget på ideen om at en søke-basert compiler alltid vil slå menneske-lagde regler. Så langt, den største begrensningen på disse compilerne har vært faktum at det ikke er mulig å benchmark og rangere millioner eller selv milliarder av kjerner. Det var derfor nødvendig for oss å skape en matematisk modell av beregning som kan anslå tiden som en gitt beregning eller sett av beregninger vil ta på en gitt maskinvare. Ved å gjøre dette, er vi i stand til å utvide vår søke-rom og deretter kutte den ned, som er en nødvendighet hvis du vil finne den raskeste kjernen konsekvent.
Hvordan påvirker din bakgrunn i å bygge Emma-programmeringsspråket SF Tensors arkitektur og filosofi mot ytelse og abstraksjon?
Ikke fortell mine investorer, men i hjertet er jeg fortsatt en compiler-ingeniør. Jeg har alltid vært interessert i å finne forskjellige måter å gjøre ting bare litt raskere. I å utvikle Emma kastet vi ut hele compileren 4 eller 5 ganger; vi startet fra scratch, hver gang fordi vi møtte en optimalisering som vi ikke kunne implementere gitt de nåværende begrensningene, og tvang oss til å omkonstruere systemet til å bli enda mer generelt, samtidig som vi fortsatt kunne drope ned på det laveste nivået av optimalisering når det var nødvendig, ofte mot common principles of compiler and language design. Disse lærdommene og den resulterende arkitekturen kombinert nesten to år av hva som så ut som mindre optimaliseringer og feil veddemål har kommet sammen til et system som lar oss nå iterere raskere og optimalisere bedre enn noen av systemene som fulgte common principles, fordi disse prinsippene er fundamentalt designet for CPU-er, ikke GPU-er og AI-modeller.
Du har arbeidet med stor-skala trenings-løp på over 4 000 GPU-er — hva var noen av de største lærdommene fra å håndtere beregning på denne skalaen?
En stor en er at maskinvare-feil er mye mer vanlig og mye mer problematisk enn en kunne anta. Etter å ha brukt mye tid på å arbeide med tradisjonelle programmer og compiler, generelt sett gjør en datamaskin eksakt som den er fortalt, og hvis noe går galt, er det nesten alltid feil av personen som skrev koden. Med GPU-er, på den andre siden, er maskinvare-feil en vanlig hendelse, spesielt i distribuert trenings-løp på ekstremt store cluster. I tillegg til dette er det faktum at, i motsetning til CPU-er som generelt handler i en forholdsvis deterministisk og forutsigbar måte, GPU-er noen ganger uforklarlig gjør ting som å senke klokke-hastigheter uten noen åpenbar grunn, og sakte ned hele trenings-prosessen fordi en enkelt chip kjører saktere.
Y Combinator har støttet noen av de mest transformasjonelle infrastruktur-selskapene i teknologi. Hvordan har denne erfaringen formet din tilnærming til å skale SF Tensors produkt og visjon?
Da jeg gikk inn i Y Combinator tenkte jeg at veddemålet vi ville gjøre da var ambisiøst. Etter bare noen uker, hadde vår definisjon av ambisiøst forandret seg drastisk, og vi doblet ned på et enda større veddemål. For en annen, følelsen av fellesskap og læring som jeg kan ta opp telefonen eller sende en e-post til nesten hvilket som helst selskap eller person der ute og motta en respons og råd innen noen timer til dager, har forandret måten vi tenker på å løse problemer og omfavne en betydelig mer samarbeidende tilnærming.
Ser du fremover, har du uttrykt interesse for ikke-LLM-modeller, robotikk og syntetisk data. Hvordan passer disse områdene inn i din langsiktige visjon for selskapet?
LLM-er er absolutt en interessant teknologi og vil ha en integrerende del i hvordan verden ser ut i fremtiden, men grunnen til at de er så mye mer avanserte enn noen annen område av AI, skyldes hovedsakelig det faktum at det er mye penger som investeres i deres utvikling, og det er nok mennesker som samarbeider om problemet, så de har blitt ganske optimalisert. Hvis vi kan senke barrieren for inngang, og tillate forskere over hele landet og planeten, selv de med begrensede ressurser og liten eller ingen kunnskap i optimalisering, å utføre sin forskning så billig og effektivt som mulig, tror jeg vi vil se en helt ny generasjon av modeller dukke opp som vil løse problemer som LLM-er ikke er egnet for, enten fordi de interagerer med den fysiske verden eller fordi de er problemer som ikke kan uttrykkes korrekt i språk.
Hva tror du AI-infrastruktur-staken vil se ut som om fem år — og hvor ser du SF Tensors rolle innen den?
Om fem år håper jeg at mange flere selskaper vil ha utviklet og lansert sine egne spesialiserte chip, og at forskere vil kunne utnytte og bruke dem uten å måtte skrive kode spesifikt for dem, ideal sett uten å måtte vite at de eksisterer. Dette er fremtiden vi jobber mot, og som jeg tror vi vil ha en betydelig rolle i å forme.
Takk for det flotte intervjuet, lesere som ønsker å lære mer, kan besøke SF Tensor.


