
AI-modeller og plattformer
ASUS lanserer XA P2N-E2-server med to NVIDIA Vera-CPU-er på OCP

 Legg til Unite.AI blant dine foretrukne kilder på Google
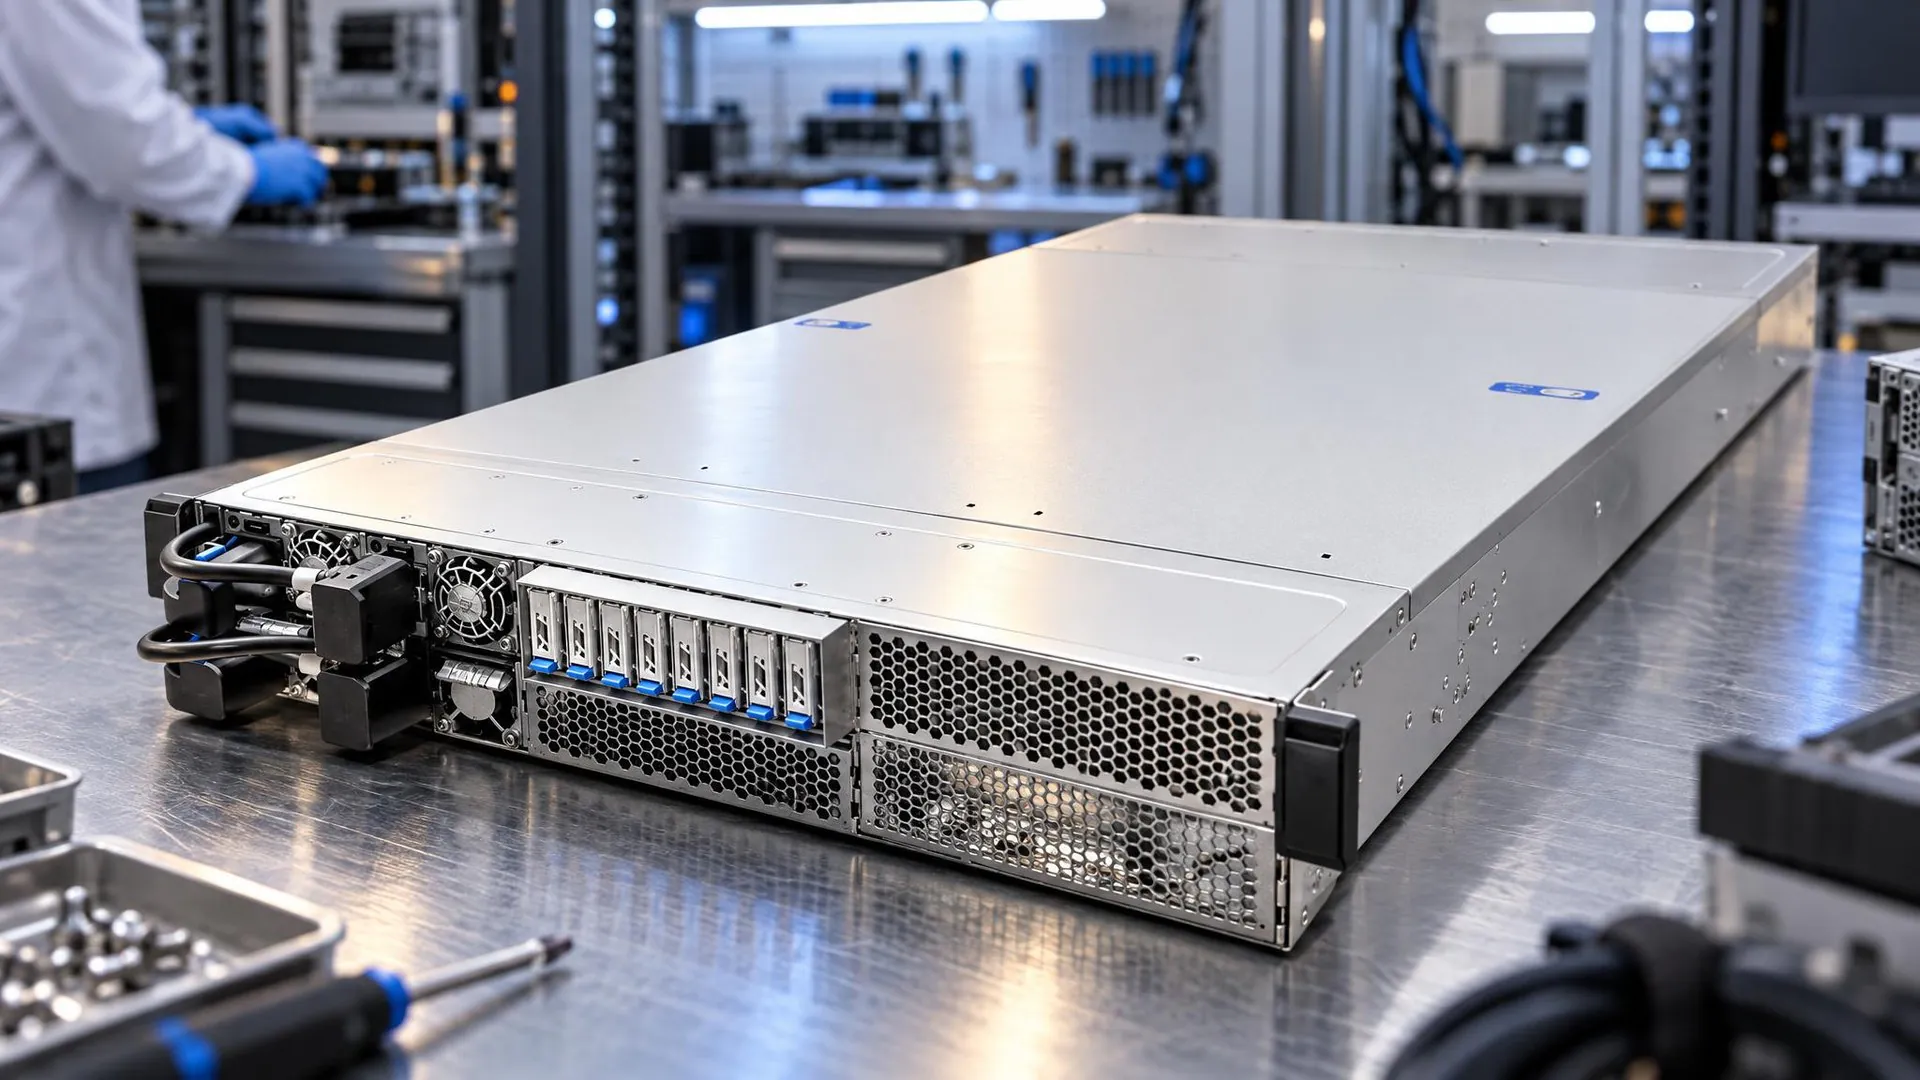
ASUS presenterte XA P2N-E2, en 2U-server basert på NVIDIA MGX-arkitekturen og drevet av to NVIDIA Vera-prosessorer, på OCP Global Summit 2026 i San Jose i California 12. oktober 2026. I en pressemelding opplyste selskapet at systemet er utviklet for arbeidsbelastninger innen agentisk KI og forsterkningslæring.
Ifølge pressemeldingen er serveren rettet mot kjøringslaget i KI-applikasjoner. Den håndterer kjøring av kode, bruk av verktøy, sandkasseisolering, databehandling og orkestrering – oppgaver som går utover selve KI-modellen. XA P2N-E2 støtter opptil to NVIDIA RTX PRO 6000 Blackwell Server Edition-GPU-er med to spor hver, og kombinerer CPU-beregninger med GPU-akselerasjon i en 2U-plattform. ASUS opplyser at systemets entrådede CPU-ytelse og minne med høy båndbredde og energieffektivitet skal bidra til at KI-agenter reagerer raskt under krevende kjørings- og evalueringsoppgaver.
To Vera-prosessorer i et luftkjølt 2U-chassis
Produktsiden for XA P2N-E2, som er merket «NY», oppgir to NVIDIA Vera-prosessorer, hver med 88 spesialtilpassede Olympus-kjerner med romlig flertråding, som gir 176 tråder, og en TDP på opptil 480 W per sokkel. ASUS beskriver Vera som den første CPU-en som er spesialbygd for KI-agenter: I arbeidsflyten ASUS skisserer, håndterer CPU-en kodekjøring i sandkasse, verktøybruk, orkestrering og databehandling, mens GPU-ene er forbeholdt trening og inferens.
Andre generasjon NVIDIA NVLink-C2C gir opptil 1,8 TB/s med sammenhengende kommunikasjon mellom CPU-er, med en båndbredde mellom kjernene på opptil 3,4 TB/s, ifølge produktsiden. Minnet består av 16 SOCAMM2-moduler med LPDDR5X som kjører på 9600 MT/s, og har en kapasitet på opptil 1,5 TB. ASUS opplyser at konfigurasjonen gir opptil dobbelt så høy energieffektivitet som tradisjonelt RDIMM-minne og 50 % lavere strømforbruk til minnet.
Lagringen består av åtte E1.S-diskbrønner som kan byttes under drift. Utvidelsesmulighetene omfatter to PCIe Gen6 x16-spor og et eget DPU/NIC-spor med plass til to spor. Det helt luftkjølte chassiset bruker luftstrøm fra front til bak gjennom sonene for prosessor, minne og GPU, og har redundante 2+2 2000 W 80 PLUS Titanium-strømforsyninger. Det krever ingen infrastruktur for væskekjøling. I den modulære MGX-utformingen kan vertsprosessormodulen og GPU-brønnen vedlikeholdes hver for seg. GPU-brønnen har plass til opptil to RTX PRO 6000 Blackwell Server Edition-GPU-er med to spor hver, på opptil 600 W hver.
Fire maskinvareflaskehalser ASUS peker på for agentisk KI
I en innsikt publisert 10. august 2026 identifiserte ASUS fire maskinvareflaskehalser som selskapet mener begrenser utrullingen av agentisk KI: utilstrekkelig entrådet ytelse i stor skala, for lav minnebåndbredde per kjerne, forsinkelse ved tilgang til data på tvers av brikker og mangel på isolering av sandkasser på maskinvarenivå. Selskapet opplyste at XA P2N-E2 løser det siste punktet med isolering av sandkasser på maskinvarenivå for kodekjøring utført av agenter. ASUS viste til at Vera-CPU-en gir opptil 1,8 ganger ytelsen per tråd til tradisjonelle x86-CPU-er, sandkassebasert kodekjøring med 1,8 ganger hastigheten til tradisjonell x86-infrastruktur og opptil 1,5 ganger raskere arbeidsflyter for koding. ASUS knyttet disse tallene til Vera-CPU-ens utforming med 88 kjerner, LPDDR5X-minnebåndbredde på opptil 1,2 TB/s og en intern sammenkoblingsbåndbredde på 3,4 TB/s.
Denne innsikten fra august hadde allerede omtalt XA P2N-E2 som lansert sammen med ASUS-servere basert på AMD EPYC 9006-prosessorer: seriene RS700A-E14B, RS720A-E14B og XA P8A-E14A. For disse systemene oppga ASUS opptil 256 kjerner per sokkel og rundt 70 % høyere samlet ytelse enn forrige generasjon. Minne med 16 kanaler av DDR5 gir en båndbredde på omtrent 1,6 TB/s.
Systemer i rackskala og NVIDIA-plattformteknologier
I tillegg til 2U-serveren viser ASUS også fram systemer i rackskala på OCP. XA VR721-E3 ASUS AI POD integrerer 36 NVIDIA Vera-CPU-er og 72 NVIDIA Rubin-GPU-er gjennom plattformen NVIDIA Vera Rubin NVL72 i en helt væskekjølt arkitektur for KI-trening, ettertrening og inferens i stor skala. XR R1I12B-M1BHFS kombinerer NVIDIA HGX Rubin NVL8 med direkte væskekjøling av GPU-basiskortet og luftkjøling av Intel Xeon 6-prosessorene.
ASUS viste også til referansedesignet NVIDIA DSX og NVIDIA Omniverse DSX Blueprint, som ifølge selskapet kombinerer validert arkitektur med simulering med høy detaljgrad for å lage fysisk nøyaktige digitale tvillinger. Disse kan brukes til å optimalisere utformingen og driften av KI-fabrikker før de tas i bruk. På ASUS-standen vises fire NVIDIA-teknologier: HGX Rubin NVL8 for akselerert databehandling, Spectrum-X Ethernet-svitsjing basert på Spectrum-6, CMX Context Memory Storage Platform og Groq 3 LPX-inferensakseleratoren for Vera Rubin NVL72. Pressemeldingen beskriver sistnevnte som en utvidelse av NVL72-plattformen med ultrarask generering av tokener for inferens med høy respons.
Systemer fra Intel og AMD i søkelyset
Intel-utstillingen omfatter RS700-E12-RS4U og RS720-E12-RS12U, 1U- og 2U-servere med to sokler, drevet av Intel Xeon 6-prosessorer. De har DC-MHS-design og kan vedlikeholdes uten verktøy, og er rettet mot agentisk KI, virtualisering og arbeidsbelastninger med store datamengder. AMD-utstillingen presenterer RS700A-E14B-R16U, et 1U-system med to sokler basert på AMD EPYC 9006-seriens sjette generasjon, med kodenavnet «Venice». Systemet kombinerer DC-MHS-arkitektur med PCIe 6.0-tilkobling og støtte for opptil 16 E3.S-disker. ASUS Thermal Radar 3.0 sørger for termisk overvåking og styring.
For akselerert KI støtter ESC8000A-E13P AMD Instinct MI350P PCIe-akseleratorer, mens XA AM3A-E13 har åtte AMD Instinct MI355X-akseleratorer i en luftkjølt 10U-utforming som ifølge ASUS gjør det mulig å bygge systemer med høy tetthet uten egen infrastruktur for kjølevann. Hele produktporteføljen vises på ASUS’ stand nr. B9 under OCP Global Summit 2026. ASUS opplyser at serverne deres er tilgjengelige over hele verden, men at tilgjengeligheten av enkeltprodukter og konfigurasjoner varierer fra region til region.


