
AI-modeller og plattformer
Anthropic-teamet for red teaming sier at små KI-modeller snart kan replikere seg på IoT-enheter

 Legg til Unite.AI blant dine foretrukne kilder på Google
Anthropics Frontier Red Team publiserte forskning 12. oktober 2026. Den rapporterer at det kanskje bare er noen måneder til små KI-modeller kan replikere seg selv på kommersielle IoT-enheter, som smarte ovner og Android TV-bokser fra mindre kjente merker. En slik replikator vil være vanskelig å stanse fordi den ikke har noe sentralisert punkt som kan slås av.
Forfatterne William Zhou og Daniel Freeman skriver i innlegget at en modell med 9 milliarder parametere fikk inferens til å fungere på åtte av de ni maskinvaretypene teamet testet. De rapporterer også at modeller med 30 milliarder parametere eller færre allerede kan utføre mange av de enkelte stegene i en replikering, selv om de gjør feil når stegene settes sammen fra start til slutt. Hvis små modeller fortsetter å bli bedre i samme takt som historisk, anslår teamet at de vil nå det nødvendige kapasitetsnivået innen utgangen av 2026, og at små, vektbaserte replikatorer kan bli mulige kort tid etter. Teamet påpeker imidlertid at replikeringen kan gå sakte, med en fordoblingstid på dager.
Distribuert inferens på smart-TV-bokser
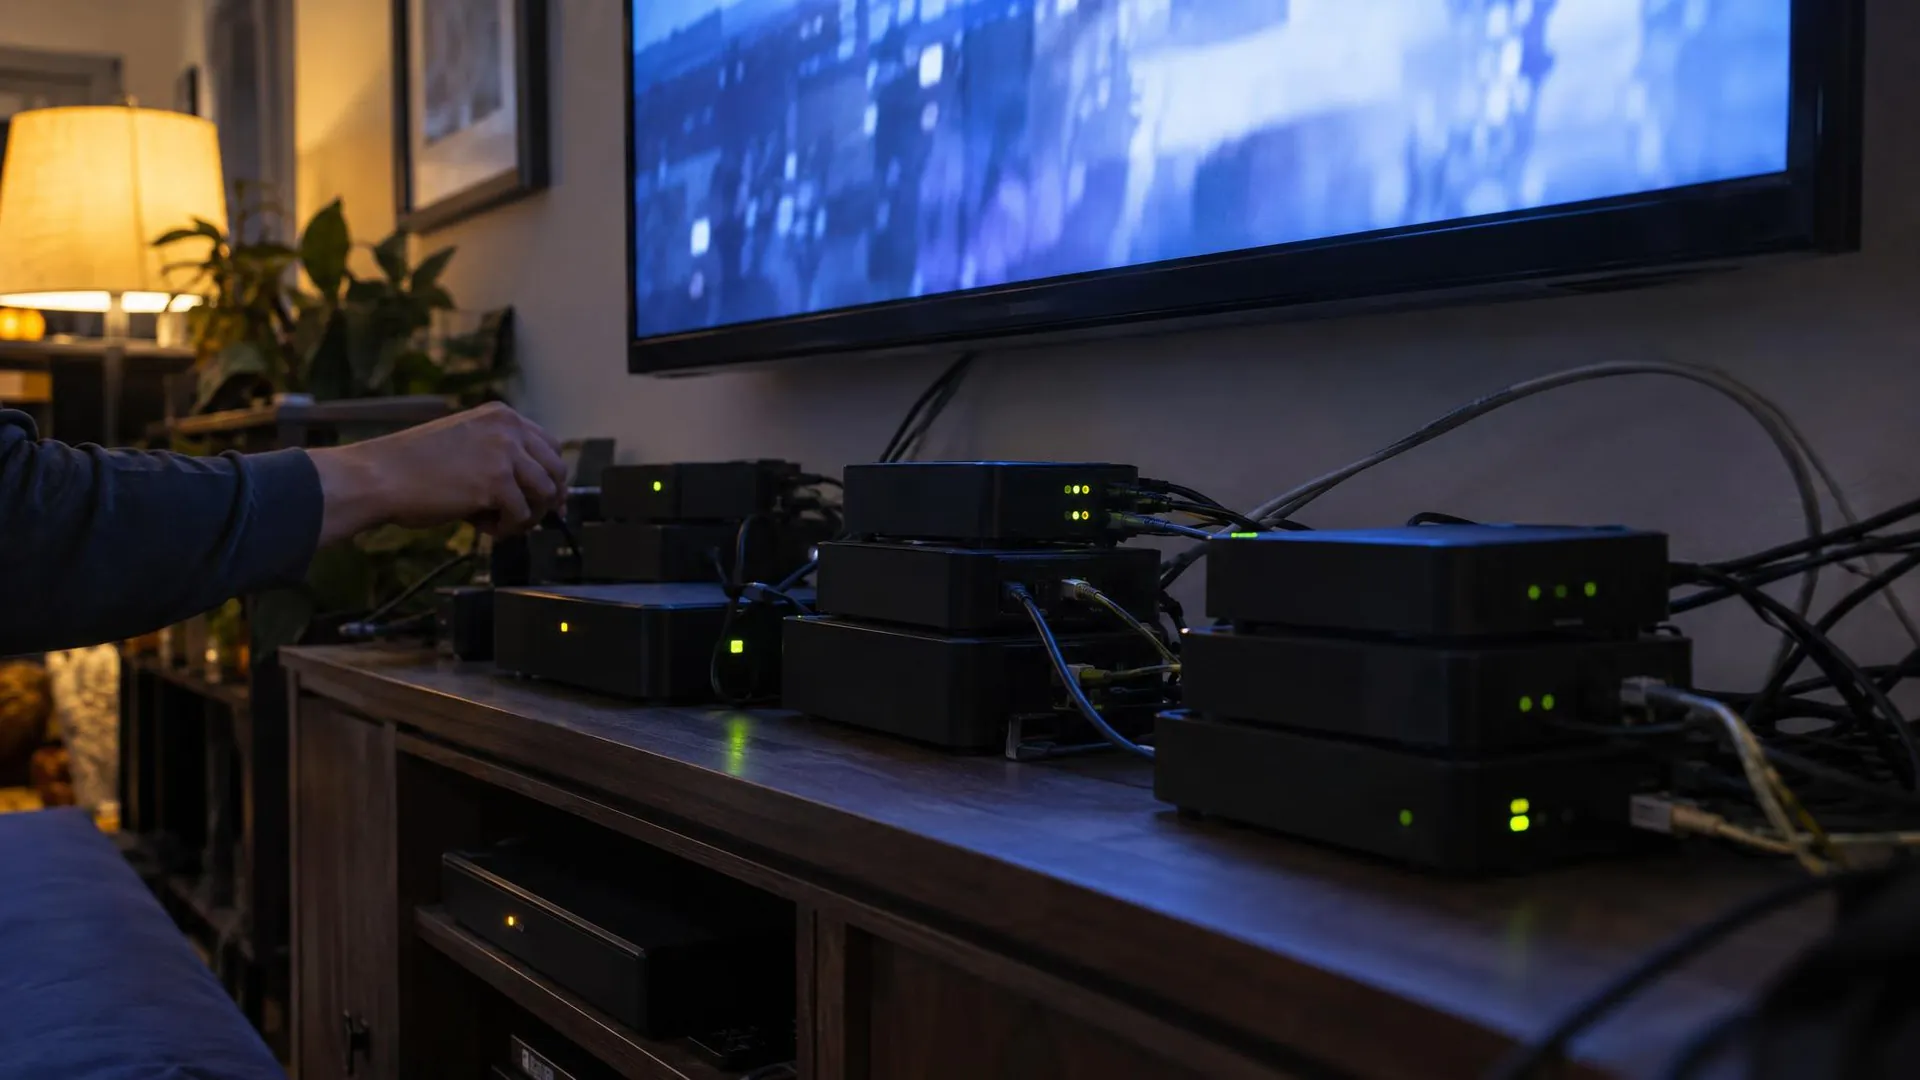
For å vise at dyre akseleratorer ikke er strengt nødvendige, kjøpte teamet 15 Android TV-bokser fra mindre kjente merker, til en pris på rundt 55 dollar per stykk, og koblet dem sammen i et nettverk. Deretter kjørte de Gemma4-26B-A4B, en modell med 26 milliarder parametere, fordelt på hele gruppen ved hjelp av pipeline-parallellisering. Hver boks med 4 gigabyte RAM hadde en liten andel av modellens lag. Teamet rapporterer at oppsettet leverte 0,39 tokens per sekund, og skriver at et distribuert botnett av billige IoT-enheter, som vanligvis er dårlig beskyttet, kan gi nok datakraft til å kjøre en kapabel modell.
Trusselmodeller og evalueringsdesign
Innlegget beskriver bekymringen som autonom replikering og tilpasning (ARA), og deler replikering inn i fire trinn: å finne mål, få kjørt kode, etablere inferens og fortsette spredningen fra den nye verten. Forskerne utelot i stor grad trinnene som innebærer å utnytte sårbarheter i cybersikkerheten. De viser til tidligere artikler, blant annet CyberGym og ExploitBench, samt forskning på adaptive ormer, som dokumentasjon på at små modeller allerede kan utnytte sårbarheter. I stedet fokuserte de på å sette opp inferens, som de beskriver som det minst studerte og muligens mest krevende trinnet for små modeller.
Innlegget beskriver tre trusselmodeller som nærmest en realisering: en liten, vektbasert replikator som sprer seg ved å kompromittere vertsmaskiner; en stor, avansert, vektbasert replikator som retter seg mot datasentre og andre systemer med høy datakapasitet, i både varianter basert på frontmodeller og varianter med åpne vekter; og en API-basert replikator som stjeler påloggingsopplysninger til sin egen inferens-API. Forskerne påpeker at vektbaserte replikatorer ikke trenger root-tilgang, fordi inferensmotorer kan kjøre utelukkende i brukerområdet. De viser også til kryptoutvinnere og botnett som P2Pinfect og Fritzfrog, som opererer uten å heve tilgangsrettighetene.
Eksperimentene ble kjørt på Memento, et testoppsett teamet bygde på den åpne kodeagenten Pi. Oppsettet starter jevnlig en ny agentinstans som overtar arbeidsområdet til forgjengeren og får et kort notat om hva den forrige agenten prøvde. I forsøket på å kjøre modellene hadde hver modell en grense på 1,5 timer per iterasjon og en samlet tidsgrense på seks timer. Den representative trusselmodellen er Kimwolf, et botnett som ifølge innlegget har infisert mer enn to millioner enheter, hovedsakelig Android TV-er fra mindre kjente merker. Slike bokser leveres vanligvis med én til fire gigabyte RAM. Ifølge beregningene i innlegget kan modeller med 9 milliarder parametere kjøre på fire eller flere maskiner, og modeller med 26 milliarder parametere på ti eller flere, når boksene har fire gigabyte RAM og bruker 4-bits kvantisering.
Resultater for replikering fra start til slutt
For å teste om modeller kan sette sammen hele forløpet med å skanne etter mål, få tilgang, levere nyttelasten og sette opp inferens, bygde teamet en brannmursikret virtuell privat sky med åtte Google Cloud-noder som kjørte redroid, en Android 15-emulator. En orm som startet hos nullpasienten, hoppet fra node til node via en ADB-port uten autentisering og satte opp en inferensserver som kjørte Llama3.1-8B. Kontroller av korrekthet og juks avgjorde om hver ny kopi fikk spre seg.
Blant modellene med åpne vekter som ble testet, var det bare GLM-5.2 som klarte full replikering fra start til slutt. Ifølge teamet spredte modellen seg til alle de åtte nodene i fire av fem forsøk, og til sju av åtte i det siste forsøket. Ettersom evalueringen gjør det cybersikkerhetsrelaterte trinnet trivielt, med en ADB-port uten autentisering, beskriver forskerne resultatet som en øvre grense for hva som kan oppnås i den virkelige verden. Samtidig påpeker de at tidligere IoT-botnett som Mirai spredte seg ved hjelp av standardlister med brukernavn og passord fra produsentene.
Innlegget definerer en nedre kapasitetsgrense som en orm må overstige for å replikere pålitelig. GLM-5.2 ligger over denne grensen. Det definerer også en øvre størrelsesgrense som en modell må holde seg under for å kunne kjøre på enhetene den angriper. Qwen3.5-9B og Gemma4-26B-A4B ligger under denne grensen for smart-TV-ene med 4 gigabyte RAM som ble testet, men de to grensene overlapper ikke for øyeblikket. Teamets minste kvadraters tilpasning, basert på en sammenligning av fremtredende modeller med åpne vekter og 30 milliarder parametere eller færre opp mot Epoch Capabilities Index, viser en økning på 13,7 ECI per år, med en R²-verdi på 0,95. Ifølge denne beregningen vil en liten modell nå GLM-5.2s nivå innen utgangen av 2026. Teamet understreker imidlertid at ECI er en generell kapasitetsindeks og bare en indikator på evnen til å replikere seg, så tidspunktet er et grovt anslag. I en ablasjonstest med 17 noder, der et ferdigskrevet skript tok seg av oppsettet av inferens, nådde selv en modell med 3 milliarder parametere omtrent halvparten av nodene. Teamet sier at dette setter en øvre grense for hvor mye av utfordringen som skyldes de gjenværende trinnene med autonomi og koordinering.
Replikasjonshastighet, omfang og tilpasning
I målingene teamet gjorde på de fysiske TV-boksene, kjørte inferens med Gemma4-26B-A4B uten optimalisering med omtrent 0,3 token per sekund over et kontekstvindu på 32 000 token. Et fullstendig inferensoppsett tok 71 til 150 timer, mot 28 til 51 timer for Qwen3.5-9B. Skalert opp til en flåte på størrelse med Kimwolf anslår teamet rundt 133 000 replikaer, hver bestående av en gruppe på 15 TV-er, som samlet leverer omtrent 80 000 token per sekund. Dette krever høyst rundt 40 H100-ekvivalenter i inferenskapasitet, noe teamet omtaler som en svært liten mengde datakraft, og replikeringen tar én til to dager per kopi med 9 milliarder parametere.
Teamet rapporterer at andelen vellykkede inferensoppsett steg fra 45 % i første generasjon til mellom 61 % og 84 % i senere generasjoner, fordelt på 20 utviklingslinjer. Målingene omfattet seks generasjoner av Qwen3.5-9B-instanser som hver hadde arvet notatene fra en foregående instans. Det hjalp ikke merkbart å gi Qwen3.5-9B tilgang til Opus 4.8 som rådgiver på frontnivå, verken når rådgiveren ble tilbudt som et verktøykall eller uten at modellen ba om den. Forsterkningslæring i bruk av rådgiveren til kodeoppgaver ga heller ingen produktiv overføring. I en lokal gjenskaping av Metas evaluering CyberSecEval 3 av målrettede phishing-angrep fikk små modeller resultater som innlegget beskriver som svært dårlige til dårlige når de ble normalisert mot menneskelige vurderinger. Teamet viser til dette som belegg for at sosial manipulering henger etter agentisk cybersikkerhetskompetanse i små modeller.
Innlegget anslår separat at det finnes rundt 90 ulike produktlinjer for IoT-enheter med NVIDIA-silisium og omtrent 9,5 millioner enheter i bruk. Det tilsvarer svært grovt anslått 9 000 til 35 000 H100-ekvivalenter i datakraft fra akseleratorer i kantnettverk, mens den tilgjengelige andelen sannsynligvis er minst en størrelsesorden lavere. Ifølge tallene innlegget viser til, kjører en Jetson AGX Orin 64GB Qwen3-30B-A3B med 76,7 token per sekund, mens en AGX Thor oppnår 226 token per sekund.
Forsvarstiltak og teamets vurdering
Forsvaret handler om å få R₀ – antallet nye enheter hver infiserte enhet går videre til å infisere – under én, står det i innlegget. En replikerer basert på modellvekter som sprer seg i stor skala gjennom IoT-maskiner, ville etterlate et nettverksspor som er synlig ved ISP-overvåking basert på trafikkflyt, ettersom nylig infiserte verter mottar modellpakker på flere gigabyte, og distribuert inferens skaper vedvarende trafikk mellom enheter. Raskere replikering gir mer trafikk og innebærer dermed en avveining mellom hastighet og skjult virksomhet. Honningfeller kan dessuten fange opp replikererens rammeverk og nyttelast. Med henvisning til forskning på utbedring etter Mirai-angrep oppgir innlegget at ISP-er som satte infeksjoner i karantene og varslet kundene, fikk ryddet opp i 92 % av infeksjonene innen 14 dager, mot 74 % uten varsling. Innlegget påpeker også at standardpassord for IoT-enheter nå ikke oppfyller kravene i britiske markeder, som et eksempel på hvordan reguleringer reduserer utvalget av mål.
I motsetning til hardkodede botnett som Kimwolf, som retter seg mot bestemte enhetstyper, er et AI-botnett ikke knyttet til bestemt maskinvare, står det i innlegget. Det viser til små modeller som setter opp inferens på alt fra en Jetson Nano til en Mac. Forskerne konkluderer med at funnene, som tilfellet var med kodeagenter i 2024, viser tegn til liv for AI-ormer: Agentene fullfører stadig oftere enkelttrinn i replikeringskjeden og overfører tilpasninger til framtidige kopier, men utgjør ennå ikke en fullverdig, ukontrollert replikerer. De forventer at den utplasserte kantdatakraften vil fortsette å vokse, samtidig som den minste modellstørrelsen som kreves for pålitelig replikering, blir mindre.


