
Beste
10 Beste Machine Learning Algoritmes

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Belangrijkste puntenTransformers hebben NLP gerevolutioneerd door parallelle verwerking en blijvend…
Meer weergeven
- Transformers hebben NLP gerevolutioneerd door parallelle verwerking en blijvend geheugen mogelijk te maken, in tegenstelling tot RNN's.
- GAN's dwingen generatoren om uiteenlopende oplossingen te verkennen door het achterwege laten van foutterugkoppeling van de discriminator.
- K-Nearest Neighbors uit 1951 presteert nog steeds beter dan moderne algoritmen bij het voorspellen van personeelsverloop.
Hoewel we leven in een tijd van buitengewone innovatie in GPU-versnelde machine learning, bevatten de nieuwste onderzoeksartikelen vaak algoritmes die decennia, soms zelfs 70 jaar oud zijn.
Sommigen zouden kunnen beweren dat veel van deze oude methoden meer onder de categorie ‘statistische analyse’ vallen dan machine learning, en de oorsprong van de sector terugdateren tot 1957, met de uitvinding van de Perceptron.
Gezien de mate waarin deze oude algoritmes de nieuwste trends en opzienbarende ontwikkelingen in machine learning ondersteunen en erin verweven zijn, is dit een betwistbare houding. Laten we dus eens kijken naar enkele van de ‘klassieke’ bouwstenen die ten grondslag liggen aan de nieuwste innovaties, evenals enkele nieuwere inzendingen die vroeg een bod doen om de AI-hall of fame te betreden.
1: Transformers
In 2017 leidde Google Research een onderzoekssamenwerking die resulteerde in het artikel Aandacht is alles wat je nodig hebt. Het werk schetste een nieuwe architectuur die aandachtsmechanismen van een ondersteunende rol in encoder/decoder- en recurrente netwerkmodellen naar een zelfstandige centrale technologie bevorderde.
De benadering werd Transformer genoemd, en is sindsdien een revolutionaire methode geworden in Natural Language Processing (NLP), waaronder het autoregressieve taalmodel en AI-boegbeeld GPT-3.

Transformers losten het probleem van sequentie-transductie op, ook wel ‘transformatie’ genoemd, dat zich bezighoudt met het verwerken van invoersequenties in uitvoersequenties. Een transformer ontvangt en beheert gegevens ook op een continue manier, in plaats van in sequentiële batches, waardoor een ‘persistentie van geheugen’ ontstaat die RNN-architecturen niet zijn ontworpen om te verkrijgen. Voor een gedetailleerder overzicht van transformers, zie ons referentieartikel.
In tegenstelling tot de Recurrent Neural Networks (RNN’s) die waren begonnen te domineren in ML-onderzoek in het CUDA-tijdperk, kon de Transformer-architectuur ook gemakkelijk geparallelliseerd worden, waardoor een veel groter corpus van gegevens kon worden aangepakt dan RNN’s.
Veelgebruikte toepassingen
Transformers veroverden de publieke verbeelding in 2020 met de release van OpenAI’s GPT-3, die een toen recordbrekend 175 miljard parameters had. Deze ogenschijnlijk verbluffende prestatie werd uiteindelijk overschaduwd door latere projecten, zoals de release in 2021 van Microsoft’s Megatron-Turing NLG 530B, die (zoals de naam al aangeeft) meer dan 530 miljard parameters heeft.

Een tijdslijn van hyperschaal Transformer NLP-projecten. Bron: Microsoft
Transformer-architectuur is ook overgestapt van NLP naar computerzicht, waardoor een nieuwe generatie van beeldsynthese-kaders zoals OpenAI’s CLIP en DALL-E mogelijk wordt, die tekst>beelddomeinmapping gebruiken om onvolledige beelden te voltooien en nieuwe beelden te synthetiseren uit getrainde domeinen, onder andere.
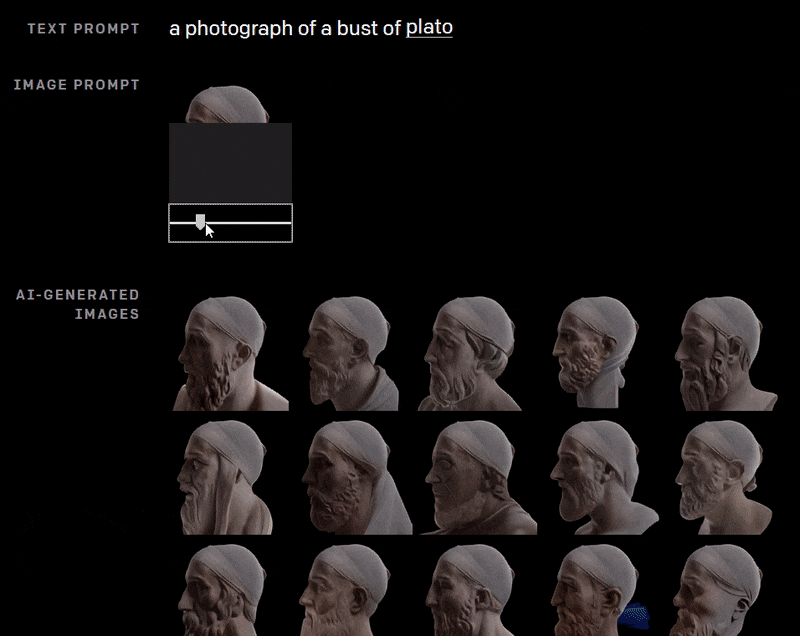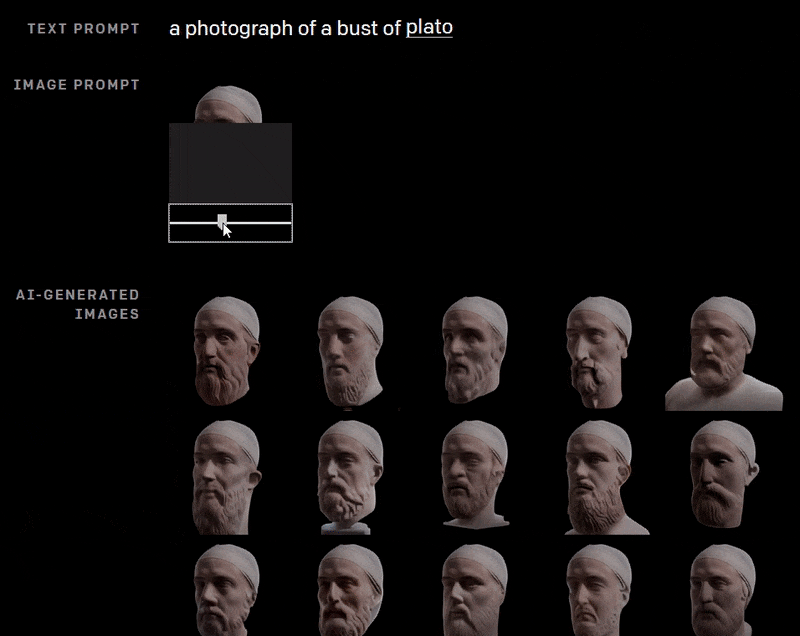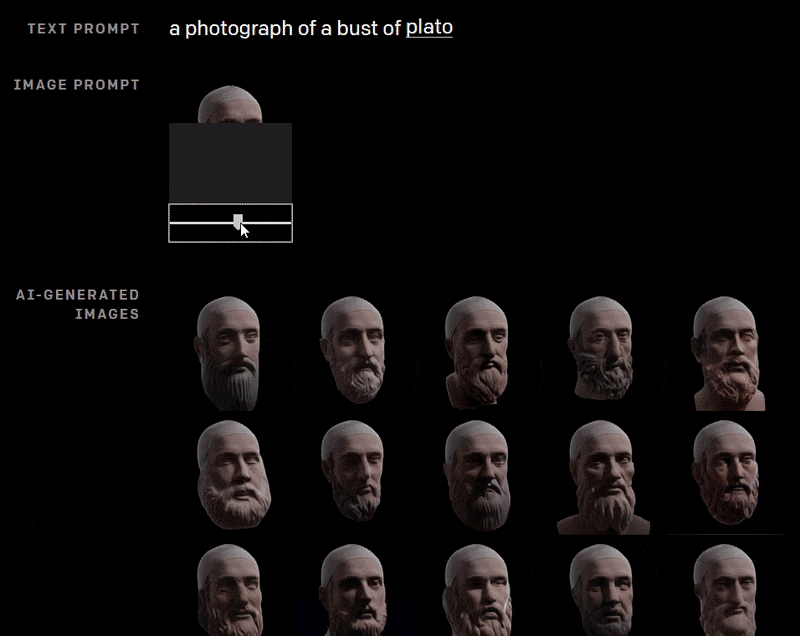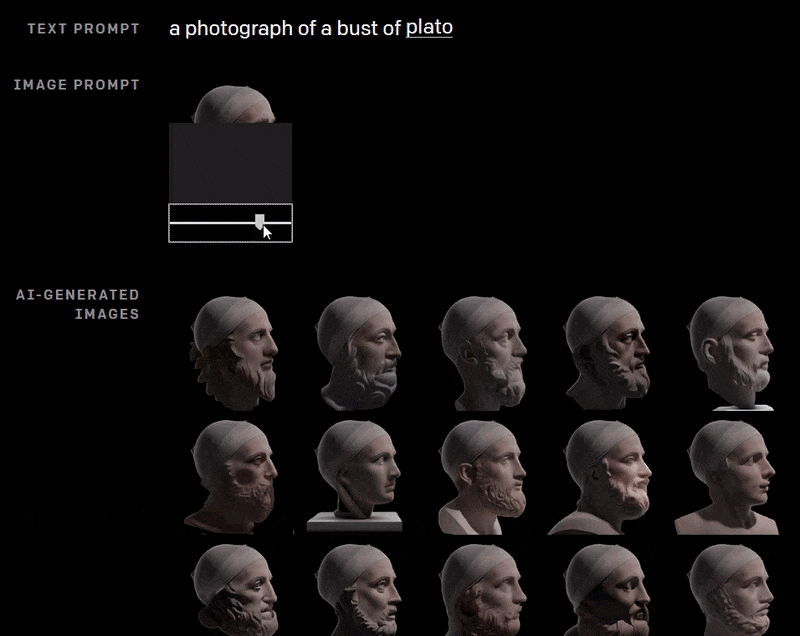
DALL-E probeert een gedeeltelijk beeld van een buste van Plato te voltooien. Bron: https://openai.com/blog/dall-e/
2: Generatieve adversariële netwerken (GAN’s)
Hoewel transformers buitengewone media-aandacht hebben gekregen met de release en adoptie van GPT-3, is het generatief adversarieel netwerk (GAN) een herkenbaar merk op zichzelf geworden en kan het uiteindelijk, net als deepfake, ook als werkwoord worden gebruikt.
Eerst voorgesteld in 2014 en voornamelijk gebruikt voor beeldsynthese, bestaat een generatief adversarieel netwerk architectuur uit een Generator en een Discriminator. De Generator doorloopt duizenden beelden in een dataset, waarbij het iteratief probeert ze te reconstrueren. Voor elke poging beoordeelt de Discriminator het werk van de Generator en stuurt de Generator terug om het beter te doen, zonder enig inzicht in de manier waarop de vorige reconstructie fout ging.

Bron: https://developers.google.com/machine-learning/gan/gan_structure
Dit dwingt de Generator om een veelvoud aan wegen te verkennen, in plaats van de mogelijke doodlopende steegjes te volgen die zouden zijn ontstaan als de Discriminator hem had verteld waar hij fout ging (zie #8 hieronder). Tegen de tijd dat de training is voltooid, heeft de Generator een gedetailleerde en uitgebreide kaart van de relaties tussen punten in de dataset.
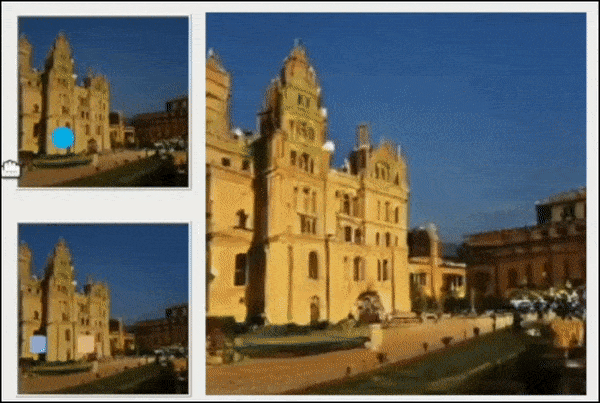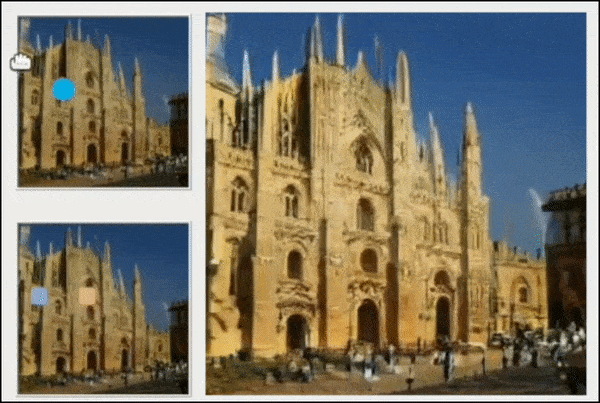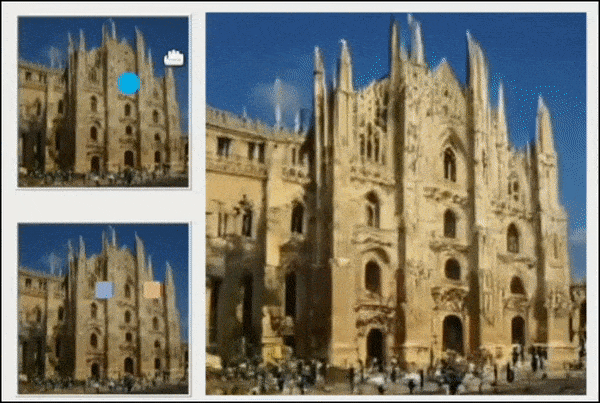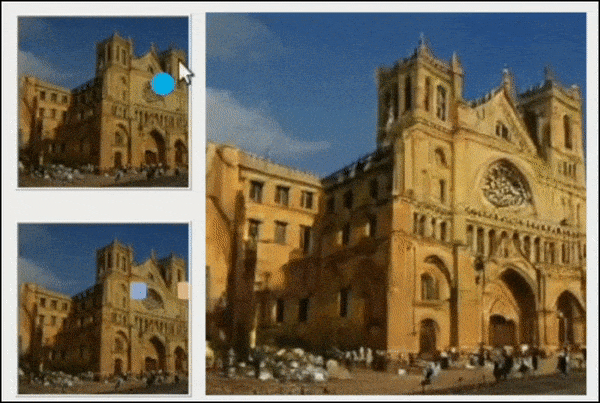
Uit het artikel Verbetering van GAN-evenwicht door ruimtelijke bewustzijn te vergroten: een nieuw kader doorloopt de soms mysterieuze latente ruimte van een GAN, waardoor responsieve instrumentatie voor een beeldsynthese-architectuur mogelijk wordt. Bron: https://genforce.github.io/eqgan/
Door analogie is dit het verschil tussen het leren van een enkele saaie reis naar centraal Londen, of het zorgvuldig verwerven van The Knowledge.
Het resultaat is een verzameling kenmerken op een hoog abstractieniveau in de latente ruimte van het getrainde model. De semantische indicator voor een kenmerk op een hoog abstractieniveau kan ‘persoon’ zijn, terwijl een afdaling door specificiteit gerelateerd aan het kenmerk andere geleerde kenmerken kan onthullen, zoals ‘man’ en ‘vrouw’. Op lagere niveaus kunnen de subkenmerken uiteenvallen in ‘blond’, ‘Kaukasisch’, enz.
Verstrengeling is een opvallend probleem in de latente ruimte van GAN’s en encoder/decoder-kaders: is de glimlach op een GAN-gegenereerd vrouwengezicht een verstrengeld kenmerk van haar ‘identiteit’ in de latente ruimte, of is het een evenwijdige tak?

GAN-gegenereerde gezichten van thispersondoesnotexist. Bron: https://this-person-does-not-exist.com/en
De afgelopen paar jaar hebben een groeiend aantal nieuwe onderzoeksinitiatieven in dit opzicht voortgebracht, wellicht de weg vrijmakend voor kenmerkniveau, Photoshop-achtige bewerking voor de latente ruimte van een GAN, maar op dit moment zijn veel transformaties effectief ‘alles of niets’-pakketten. Opvallend genoeg bereikt NVIDIA’s EditGAN-release van eind 2021 een hoog niveau van interpreteerbaarheid in de latente ruimte door semantische segmentatiemaskers te gebruiken.
Veelgebruikte toepassingen
Naast hun (eigenlijk vrij beperkte) betrokkenheid bij populaire deepfake-video’s, hebben beeld-/video-georiënteerde GAN’s de afgelopen vier jaar geprolifeerd, en hebben zowel onderzoekers als het publiek in verrukking gebracht. Het bijhouden van het duizelingwekkende tempo en de frequentie van nieuwe releases is een uitdaging, hoewel de GitHub-repository Awesome GAN Applications ernaar streeft een uitgebreide lijst te bieden.
Generatieve adversariële netwerken kunnen in theorie kenmerken afleiden uit elk goed geframed domein, inclusief tekst.
3: Ondersteuningsvector Machines (SVM)
Oorspronkelijk in 1963 ontstaan, is Ondersteuningsvector Machine (SVM) een kernalgoritme dat vaak voorkomt in nieuw onderzoek. Onder SVM worden vectoren de relatieve positie van datapunten in een dataset in kaart gebracht, terwijl ondersteuningsvectoren de grenzen tussen verschillende groepen, kenmerken of eigenschappen aangeven.

Ondersteuningsvectoren definiëren de grenzen tussen groepen. Bron: https://www.kdnuggets.com/2016/07/support-vector-machines-simple-explanation.html
De afgeleide grens wordt een hyperplane genoemd.
Op lage kenmerkniveaus is de SVM tweedimensionaal (afbeelding hierboven), maar waar er een hoger aantal herkende groepen of typen is, wordt het driedimensionaal.

Een dieper array van punten en groepen vereist een driedimensionale SVM. Bron: https://cml.rhul.ac.uk/svm.html
Veelgebruikte toepassingen
Omdat Ondersteuningsvector Machines effectief en agnostisch hoge dimensionale gegevens van veel soorten kunnen aanpakken, komen ze wijdverspreid voor in een verscheidenheid aan machine learning-sectoren, inclusief deepfake detectie, beeldclassificatie, haatzaaiende taalclassificatie, DNA-analyse en populatiestructuurvoorspelling, onder andere.
4: K-means-clustering
Clustering in het algemeen is een onbegeleide leerbenadering die ernaar streeft datapunten te categoriseren door dichtheidsschatting te gebruiken, waardoor een kaart van de verdeling van de onderzochte gegevens ontstaat.

K-means-clustering onthult segmenten, groepen en gemeenschappen in gegevens. Bron: https://aws.amazon.com/blogs/machine-learning/k-means-clustering-with-amazon-sagemaker/
K-means-clustering is de meest populaire implementatie van deze benadering, waarbij datapunten in distincte ‘K-groepen’ worden geleid, die demografische sectoren, online gemeenschappen of elke andere mogelijke geheime aggregatie kunnen aanduiden die in ruwe statistische gegevens verborgen liggen.

Clusters vormen in K-means-analyse. Bron: https://www.geeksforgeeks.org/ml-determine-the-optimal-value-of-k-in-k-means-clustering/
De K-waarde zelf is de bepalende factor in de bruikbaarheid van het proces, en in het vaststellen van een optimale waarde voor een cluster. Aanvankelijk wordt de K-waarde willekeurig toegewezen, en worden zijn kenmerken en vectorkenmerken vergeleken met die van zijn buren. Die buren die het meest op het datapunt met de willekeurig toegewezen waarde lijken, worden iteratief toegewezen aan zijn cluster totdat de gegevens alle groeperingen hebben opgeleverd die het proces toelaat.
De plot voor de kwadratische fout, of ‘kosten’ van verschillende waarden onder de clusters, zal een elleboogpunt voor de gegevens onthullen:

Het ‘elleboogpunt’ in een clustergrafiek. Bron: https://www.scikit-yb.org/en/latest/api/cluster/elbow.html
Het elleboogpunt is vergelijkbaar met de manier waarop verlies afvlakt tot verwaarloosbare rendementen aan het einde van een trainingsessie voor een dataset. Het vertegenwoordigt het punt waarop geen verder onderscheid tussen groepen zichtbaar zal worden, aangevend het moment om over te gaan tot latere fasen in de datapipeline, of om bevindingen te melden.
Veelgebruikte toepassingen
K-means-clustering is, om voor de hand liggende redenen, een primaire technologie in klantanalyse, aangezien het een duidelijke en verklarende methodologie biedt om grote hoeveelheden commerciële records om te zetten in demografische inzichten en ‘leads’.
Buiten deze toepassing wordt K-means-clustering ook gebruikt voor aardverschuivingvoorspelling, medische beeldsegmentatie, beeldsynthese met GAN’s, documentclassificatie, en stadsplanning, onder andere.
5: Willekeurig Bos
Willekeurig Bos is een ensemble leerbenadering die de resultaten van een verzameling beslissingsbomen middelt om een algehele voorspelling voor de uitkomst te maken.

Bron: https://www.tutorialandexample.com/wp-content/uploads/2019/10/Decision-Trees-Root-Node.png
Als je het zelfs maar een beetje hebt onderzocht, bijvoorbeeld door naar de Back to the Future-trilogie te kijken, is een beslissingsboom relatief eenvoudig te conceptualiseren: een aantal paden liggen voor je, en elk pad vertakt zich naar een nieuwe uitkomst die op zijn beurt weer verdere mogelijke paden bevat.
In reinforcement learning zou je kunnen terugtrekken van een pad en opnieuw beginnen vanaf een eerder standpunt, terwijl beslissingsbomen zich committeren aan hun reizen.
Daarom is het Willekeurig Bos-algoritme in wezen een verspreid wedden op beslissingen. Het algoritme wordt ‘willekeurig’ genoemd omdat het ad hoc selecties en observaties maakt om de mediaan som van de resultaten van de beslissingsboomarray te begrijpen.
Doordat het meerdere factoren in overweging neemt, kan een Willekeurig Bos-benadering moeilijker om te zetten in betekenisvolle grafieken zijn dan een beslissingsboom, maar is het waarschijnlijk veel productiever.
Beslissingsbomen zijn onderhevig aan overaanpassing, waarbij de verkregen resultaten specifiek zijn voor de gegevens en niet waarschijnlijk zullen generaliseren. De willekeurige selectie van datapunten door Willekeurig Bos bestrijdt deze neiging, waardoor het doorboort naar betekenisvolle en nuttige vertegenwoordigende trends in de gegevens.

Beslissingsboomregressie. Bron: https://scikit-learn.org/stable/auto_examples/tree/plot_tree_regression.html
Veelgebruikte toepassingen
Als met veel van de algoritmes in deze lijst, functioneert Willekeurig Bos meestal als een ‘vroege’ sorteermachine en filter van gegevens, en komt het daarom consistent voor in nieuwe onderzoeksartikelen. Enkele voorbeelden van Willekeurig Bos-gebruik zijn Magnetische Resonantie Beeldsynthese, Bitcoin-prijsvoorspelling, censussegmentatie, tekstclassificatie en creditcardfraude detectie.
Aangezien Willekeurig Bos een algoritme op laag niveau is in machine learning-architecturen, kan het ook bijdragen aan de prestaties van andere methoden op laag niveau, evenals visualisatiealgoritmes, waaronder Inductief Clustering, Kenmerktransformaties, classificatie van tekstdocumenten met behulp van schaarse kenmerken, en weergave van Pijplijnen.
6: Naïeve Bayes
In combinatie met dichtheidsschatting (zie 4 hierboven), is een naïeve Bayes-classificator een krachtig maar relatief lichtgewicht algoritme dat in staat is om waarschijnlijkheden te schatten op basis van de berekende kenmerken van gegevens.

Kenmerkrelaties in een naïeve Bayes-classificator. Bron: https://www.sciencedirect.com/topics/computer-science/naive-bayes-model
De term ‘naïef’ verwijst naar de veronderstelling in Bayes’ theorem dat kenmerken niet gerelateerd zijn, bekend als voorwaardelijke onafhankelijkheid. Als je dit standpunt inneemt, is het lopen en praten als een eend niet genoeg om te concluderen dat we te maken hebben met een eend, en worden geen ‘voor de hand liggende’ aannamen prematuur aangenomen.
Dit niveau van academische en onderzoeksrigoriteit zou overbodig zijn waar ‘gezond verstand’ beschikbaar is, maar is een waardevolle standaard wanneer men de vele ambiguïteiten en potentieel niet-gerelateerde correlaties die in een machine learning-dataset kunnen bestaan, doorloopt.
In een oorspronkelijk Bayesiaans netwerk zijn kenmerken onderhevig aan scorefuncties, waaronder minimale beschrijvingslengte en Bayesiaanse scoring, die beperkingen aan de gegevens kunnen opleggen in termen van de geschatte connecties tussen de datapunten en de richting waarin deze connecties stromen.
Een naïeve Bayes-classificator, daarentegen, werkt door te veronderstellen dat de kenmerken van een gegeven object onafhankelijk zijn, en gebruikt vervolgens Bayes’ theorem om de waarschijnlijkheid van een gegeven object te berekenen op basis van zijn kenmerken.
Veelgebruikte toepassingen
Naïeve Bayes-filters zijn goed vertegenwoordigd in ziektevoorspelling en documentcategorisatie, spamfiltering, sentimentclassificatie, aanbevelingssystemen, en fraudedetectie, onder andere toepassingen.
7: K-Dichtstburen (KNN)
Eerst voorgesteld door de School of Aviation Medicine van de Amerikaanse luchtmacht in 1951, en aangepast aan de stand van de techniek van de midden van de twintigste eeuw, is K-Dichtstburen (KNN) een slank algoritme dat nog steeds prominent voorkomt in academische papers en particuliere sector machine learning-onderzoeksinitiatieven.
KNN wordt de ‘luie leerling’ genoemd, omdat het uitputtend een dataset doorloopt om de relaties tussen datapunten te evalueren, in plaats van het trainen van een volwaardig machine learning-model.

Een KNN-groepering. Bron: https://scikit-learn.org/stable/modules/neighbors.html
Hoewel KNN architecturaal slank is, legt zijn systematische aanpak een opvallende vraag aan lees-/schrijfbewerkingen, en kan het gebruik ervan in zeer grote datasets problematisch zijn zonder adjuncttechnologieën zoals Principal Component Analysis (PCA), die complexe en hoogvolume datasets in representatieve groeperingen kan transformeren die KNN met minder moeite kan doorlopen.
Een recente studie evalueerde de effectiviteit en economie van een aantal algoritmes die werden belast met het voorspellen of een werknemer een bedrijf zou verlaten, en vond dat de 70-jarige KNN nog steeds superieur was aan modernere tegenstrevers in termen van nauwkeurigheid en voorspellingskracht.
Veelgebruikte toepassingen
Hoewel het een populaire eenvoud van concept en uitvoering heeft, is KNN niet vastgeroest in de jaren 50 – het is aangepast in een meer DNN-georiënteerde benadering in een voorstel van de Pennsylvania State University in 2018, en blijft een centraal vroeg stadiumproces (of post-processing analysetool) in veel complexere machine learning-kaders.
In verschillende configuraties is KNN gebruikt voor online handtekeningverificatie, beeldclassificatie, tekstmining, gewasvoorspelling, en gezichtsherkenning, naast andere toepassingen en incorporaties.

Een KNN-gebaseerd gezichtsherkenningssysteem in training. Bron: https://pdfs.semanticscholar.org/6f3d/d4c5ffeb3ce74bf57342861686944490f513.pdf
8: Markov Beslissingsproces (MDP)
Een wiskundig kader geïntroduceerd door de Amerikaanse wiskundige Richard Bellman in 1957, is het Markov Beslissingsproces (MDP) een van de meest basale blokken van reinforcement-learningarchitecturen. Een conceptueel algoritme op zichzelf, is het aangepast in een groot aantal andere algoritmes, en komt het vaak voor in de huidige oogst van AI/ML-onderzoek.
MDP verkent een gegevensomgeving door zijn evaluatie van zijn huidige staat (d.w.z. ‘waar’ het is in de gegevens) te gebruiken om te beslissen welk knooppunt van de gegevens het volgende moet verkennen.

Bron: https://www.sciencedirect.com/science/article/abs/pii/S0888613X18304420
Een basaal Markov Beslissingsproces zal de voorkeur geven aan een voordeel op korte termijn boven meer gewenste langetermijndoelen. Om deze reden wordt het meestal ingebed in de context van een meer omvattende beleidsarchitectuur in reinforcement learning, en wordt het vaak onderworpen aan beperkende factoren zoals verdisconteerde beloningen, en andere modificerende omgevingsvariabelen die het zullen voorkomen om naar een onmiddellijk doel te haasten zonder rekening te houden met de bredere gewenste uitkomst.
Veelgebruikte toepassingen
Het basisconcept van MDP is wijdverspreid in zowel onderzoek als actieve inzet van machine learning. Het is voorgesteld voor IoT-beveiligingsverdedigingssystemen, visserij, en marktvoorspelling.
Naast zijn voor de hand liggende toepasbaarheid op schaken en andere strikt sequentiële spellen, is MDP een natuurlijke kandidaat voor de procedurele training van robotica-systemen, zoals we kunnen zien in de video hieronder.
9: Termfrequentie-Inverse Documentfrequentie
Termfrequentie (TF) deelt het aantal keren dat een woord voorkomt in een document door het totale aantal woorden in dat document. Dus het woord zegel dat één keer voorkomt in een artikel van duizend woorden heeft een termfrequentie van 0,001. Op zichzelf is TF grotendeels nutteloos als indicator van het belang van een term, vanwege het feit dat zinloze artikelen (zoals a, en, de, en het) domineren.
Om een betekenisvolle waarde voor een term te verkrijgen, berekent Inverse Documentfrequentie (IDF) de TF van een woord over meerdere documenten in een dataset, en wijst een lage rating toe aan zeer frequent voorkomende stopwoorden, zoals artikelen. De resulterende kenmerkvectoren worden genormaliseerd tot gehele waarden, waarbij elk woord een passend gewicht wordt toegewezen.

TF-IDF weegt de relevantie van termen op basis van frequentie over een aantal documenten, met zeldzame voorkomen als indicator van relevantie. Bron: https://moz.com/blog/inverse-document-frequency-and-the-importance-of-uniqueness
Hoewel deze benadering voorkomt dat semantisch belangrijke woorden verloren gaan als uitbijters, betekent het omkeren van de frequentiegewicht niet automatisch dat een laagfrequente term niet een uitbijter is, omdat sommige dingen zeldzaam en waardeloos zijn. Daarom zal een laagfrequente term zijn waarde moeten bewijzen in de bredere architectuurcontext door te verschijnen (zelfs bij een lage frequentie per document) in een aantal documenten in de dataset.
Ondanks zijn leeftijd is TF-IDF een krachtige en populaire methode voor initiële filterpassen in Natural Language Processing-kaders.
Veelgebruikte toepassingen
Omdat TF-IDF minstens enige rol heeft gespeeld in de ontwikkeling van Google’s grotendeels occulte PageRank-algoritme in de afgelopen twintig jaar, is het zeer wijdverspreid geadopteerd als een manipulatieve SEO-tactiek, ondanks John Mueller’s afwijzing van zijn belang voor zoekresultaten in 2019.
Vanwege de geheimhouding rond PageRank is er geen duidelijk bewijs dat TF-IDF niet momenteel een effectieve tactiek is voor het stijgen in Google’s rankings. Brandende discussie onder IT-professionals onlangs geeft een populaire begrip aan, correct of niet, dat termenmisbruik nog steeds kan leiden tot verbeterde SEO-plaatsing (hoewel aanvullende beschuldigingen van monopoliemisbruik en excessieve advertentie de grenzen van deze theorie vertroebelen).
10: Stochastische Gradiëntafdalingsalgoritme
Stochastische Gradiëntafdalingsalgoritme (SGD) is een steeds populairdere methode voor het optimaliseren van de training van machine learning-modellen.
Gradiëntafdalingsalgoritme is op zichzelf een methode voor het optimaliseren en kwantificeren van de verbetering die een model maakt tijdens training.
In deze zin geeft ‘gradiënt’ aan een helling omlaag (in plaats van een kleur-gebaseerde gradatie, zie afbeelding hieronder), waarbij het hoogste punt van de ‘heuvel’, links, de start van het trainingsproces vertegenwoordigt. Op dit punt heeft het model de gegevens nog niet één keer volledig gezien en heeft het nog niet genoeg geleerd over de relaties tussen de gegevens om effectieve transformaties te produceren.

Een gradiëntafdalingsalgoritme op een FaceSwap-trainingsessie. We kunnen zien dat de training voor een tijdje in de tweede helft is geplateaut, maar uiteindelijk de daling langs de gradiënt heeft hervat richting een acceptabele convergentie.
Het laagste punt, rechts, vertegenwoordigt convergentie (het punt waarop het model zo effectief is als het ooit zal worden onder de opgelegde beperkingen en instellingen).
De gradiënt fungeert als een record en voorspeller voor de discrepantie tussen de foutpercentage (hoe nauwkeurig het model de gegevensrelaties momenteel in kaart heeft gebracht) en de gewichten (de instellingen die de manier beïnvloeden waarop het model zal leren).
Dit record van vooruitgang kan worden gebruikt om een leersnelheidsschema te informeren, een automatisch proces dat de architectuur vertelt om meer granulair en precies te worden naarmate de vage details in duidelijke relaties en mappings transformeren. In feite biedt gradiëntverlies een just-in-time kaart van waar de training naartoe moet gaan en hoe het moet procederen.
De innovatie van Stochastische Gradiëntafdalingsalgoritme is dat het de parameters van het model bijwerkt op elk trainingsvoorbeeld per iteratie, wat over het algemeen de reis naar convergentie versnelt. Vanwege de opkomst van hyperschaalgegevens in de afgelopen jaren is SGD in populariteit toegenomen als een mogelijke methode om de daaruit voortvloeiende logistieke problemen aan te pakken.
Aan de andere kant heeft SGD negatieve implicaties voor schaalaanpassing van kenmerken, en kan het meer iteraties vereisen om hetzelfde resultaat te bereiken, waardoor aanvullende planning en aanvullende parameters nodig zijn in vergelijking met reguliere Gradiëntafdalingsalgoritme.
Veelgebruikte toepassingen
Vanwege zijn configureerbaarheid, en ondanks zijn tekortkomingen, is SGD het meest populaire optimalisatiealgoritme geworden voor het aanpassen van neurale netwerken. Een configuratie van SGD die dominant wordt in nieuwe AI/ML-onderzoeksartikelen is de keuze van de Adaptive Moment Estimation (ADAM, geïntroduceerd in 2015) optimizer.
ADAM past de leersnelheid voor elke parameter dynamisch aan (‘adaptieve leersnelheid’), evenals het incorporeren van resultaten uit eerdere updates in de volgende configuratie (‘momentum’). Bovendien kan het worden geconfigureerd om later innovaties te gebruiken, zoals Nesterov Momentum.
Er zijn echter sommigen die beweren dat het gebruik van momentum ADAM (en soortgelijke algoritmes) kan versnellen naar een suboptimale conclusie. Zoals met de meeste van de voorhoede van de machine learning-onderzoekssector, is SGD een werk in uitvoering.
Publicatie 10 februari 2022. Gewijzigd 10 februari 20.05 EET – opmaak.


