
Andersons hoek
Een Machine Learning-systeem om een Artikel te Herschrijven terwijl U het Leest

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
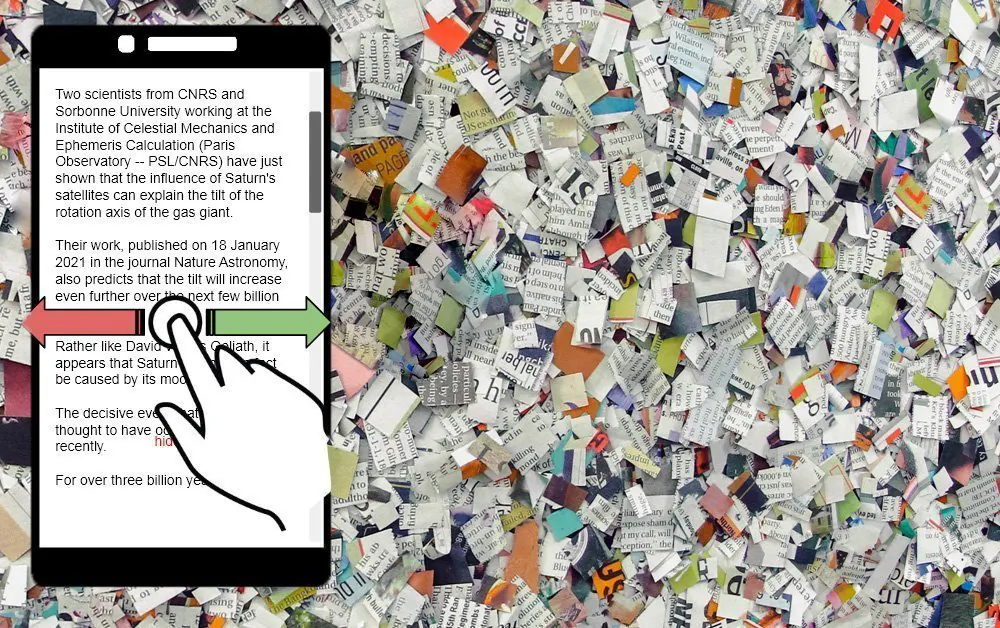
Nieuw onderzoek uit Canada stelt een methode voor om een artikel automatisch te herschrijven terwijl u het leest, op basis van Tinder-achtig ‘swipen’ of passieve observatie van de interactie van de lezer met de verschillende soorten inhoud die het artikel bevat.
Het systeem, getiteld Hone As You Read (HARE), wordt gepresenteerd in een paper van de Western University in Ontario, Canada, met bijbehorende Python-code op GitHub.
Het centrale idee van het project is dat een artikel verschillende soorten inhoud kan bevatten, die evolueren (net als deze) van de kop tot verdere details. Latere delen van een artikel kunnen verschillende soorten ondersteunend materiaal, gebruikscases of hypothesen of vermoedens over de gevolgen van het nieuws bevatten.
Onder HARE kunt u, als u niet van dat soort materiaal houdt, het wegstemmen op basis van een alinea per alinea, terwijl het systeem uw voorkeuren leert, zodat wanneer u naar beneden scrolt, soortgelijke inhoud als het materiaal dat u heeft ‘afgekeurd’ al is verwijderd of herschreven. Als u niet actief wilt deelnemen aan het trainen van het systeem, kan HARE uw keuzes afleiden door uw passieve interacties met het document te observeren.
Tinder-achtig Stemmen voor Vervelende Zinnen
In de onderstaande afbeelding zien we drie mogelijke soorten geïnferede categorisatie voor HARE, op basis van het expliciete of impliciete gedrag van de gebruiker. In het eerste geval (links) ‘swipet’ de gebruiker actief naar links (of rechts), in een Tinder-achtige stemgeste die goedkeuring of afkeuring uitdrukt voor de inhoud van de alinea of zin, of voor de stijl, complexiteit of toon.

Bron: https://arxiv.org/pdf/2105.02923.pdf
In het tweede geval (midden) gebruikt het systeem de verblijftijd als een maatstaf voor de interesse van de gebruiker, op basis van de positie en duur van de scroll-pauze.
In het derde geval (rechts) gebruikt HARE de smartphone-camera om de baan en verblijftijd van de kijklocatie van de kijker over de alinea’s van de zichtbare documenten te schatten.
De onderzoekers beweren dat een langere verblijftijd op een alinea kan aangeven dat de gebruiker meer geïnteresseerd is, hoewel dit logischerwijs niet het geval hoeft te zijn als de kijker moeite heeft om tekst te assimileren die mogelijk ingewikkeld of slecht geschreven is.

Gebruikersfeedback bewerkt, herschrijft of wist ongezien gedeelten van het artikel.
Voorverwerking van Inhoud naar de Voorkeuren van de Gebruiker
Het paper behandelt de gebruikerservaring van HARE op basis van een artikel, maar het is duidelijk dat de historische interactie van de gebruiker met documenten toelaat dat toekomstige leeservaringen worden aangepast, door consistent te herkennen welke soorten inhoud en door voorkeuren van de gebruiker te gebruiken voor nieuwe artikelen, zodat de noodzaak voor interactie afneemt naarmate de gebruiker minder en minder ‘ongewenste’ inhoud ziet.
HARE wordt gekarakteriseerd als een samenvattingsalgoritme, dat toelaat dat ongezien inhoud verderop op de pagina wordt herschreven in termen van stijl of concisie voordat de gebruiker er arriveert; maar het paper maakt duidelijk dat het ook proactief inhoud kan verwijderen op basis van gebruikersfeedback.
Voor testdoeleinden werd een corpus van 11.222 artikelen van de Britse Daily Mail krant gebruikt, en werd het systeem geëvalueerd via een testimplementatie op de Telegram-chat-app. Artikelen met minder dan tien alinea’s werden voor proefdoeleinden verworpen.

De Telegram HARE-app in een testfase met gebruikers.
De methodologie van de onderzoekers gebruikt K-Means clustering op SBERT zinsembeddings in de artikelen, met aanvankelijk willekeurige gewichten voor concepten.
Onder een breed scala aan algoritmen en benaderingen, heeft HARE drie vergelijkingsmodellen, waarvan de eerste (ORACLEGREEDY) toegang heeft tot eerdere gebruikersvoorkeuren, wat aangeeft dat het algoritme artikelen kan voorverwerken bij het laden, in plaats van interactief.
De andere modellen, ORACLESORTED en ORACLEUNIFORM, selecteren zinnen op basis van interessepeil of willekeurig door het artikel heen.
Inhoud Verwijderen en Herschrijven
Verwonderlijk genoeg overtrof ORACLEUNIFORM de controle-set, zelfs zonder toegang tot eerdere gebruikersinteresses. De onderzoekers beweren dat dit komt doordat het de hele artikel in één keer behandelt, ‘alleen de meest interessante zinnen kiezend’. De onderzoekers geven toe dat dit de beschikbare inhoud kan beperken tot zinnen die alleen met het meest belangrijke concept te maken hebben, logischerwijs andere tekst verwijderend die met gevolgen of evaluatie van het concept te maken heeft.
De extractieve samenvatters die in HARE worden gebruikt, zijn LexRank, SumBasic en TextRank.
HARE werd getest op 13 vrijwilligers over een periode van 70 trials en verschillende algoritmebenaderingen, en kon samenvattingen (herschreven/verwijderde tekst) bijwerken op een tijd tussen 1,3 milliseconden en 100 ms op een consumentenlaptop, afhankelijk van het model dat werd getest. De resultaten toonden aan dat de modellen die de meeste tekst verwijderden, niet goed presteerden, voornamelijk omdat dit de coherentie van de resterende tekst kan beïnvloeden.
Ethische Implicaties van Dynamische Artikelherschrijving
De onderzoekers erkennen ethische zorgen rondom technologieën van deze aard:
‘De HARE-taak is bedoeld voor het ontwerp van toekomstige gebruikersgerichte applicaties. Door ontwerp hebben deze applicaties de mogelijkheid om te controleren wat een gebruiker leest uit een bepaald artikel. Het is mogelijk dat, wanneer ze zonder voldoende zorg worden geïmplementeerd, deze tools de “echochamber”-effect kunnen verergeren die al wordt gegenereerd door geautomatiseerde nieuwsfeeds, zoekresultaten en online communities.’
Echter, ze merken ook op dat een dergelijk systeem in de toekomst kan worden gebruikt om het echochamber-effect te mitigeren door tekst te injecteren die alternatieve standpunten voorstelt die mogelijk niet aanwezig waren in het artikel. Ze merken op: ‘Het gewicht van deze factor kan worden aangepast om zowel een boeiende leeservaring als blootstelling aan een diversiteit aan ideeën te bieden.’
Diegenen die waarschijnlijk zullen profiteren van een dergelijk systeem, zijn volgens de onderzoekers, lezers die tijd willen besparen bij het opnemen van informatie, en content-uitgevers.
in het artikel. Ze merken op: ‘Het gewicht van deze factor kan worden aangepast om zowel een boeiende leeservaring als blootstelling aan een diversiteit aan ideeën te bieden.’ Diegenen die waarschijnlijk zullen profiteren van een dergelijk systeem, zijn volgens de onderzoekers, lezers die tijd willen besparen bij het opnemen van informatie, en content-uitgevers.


