
Anderson의 관점
신경 루미그래프 렌더링으로 실시간 AI 인간 구현

 Unite.AI를 Google의 선호 소스에 추가
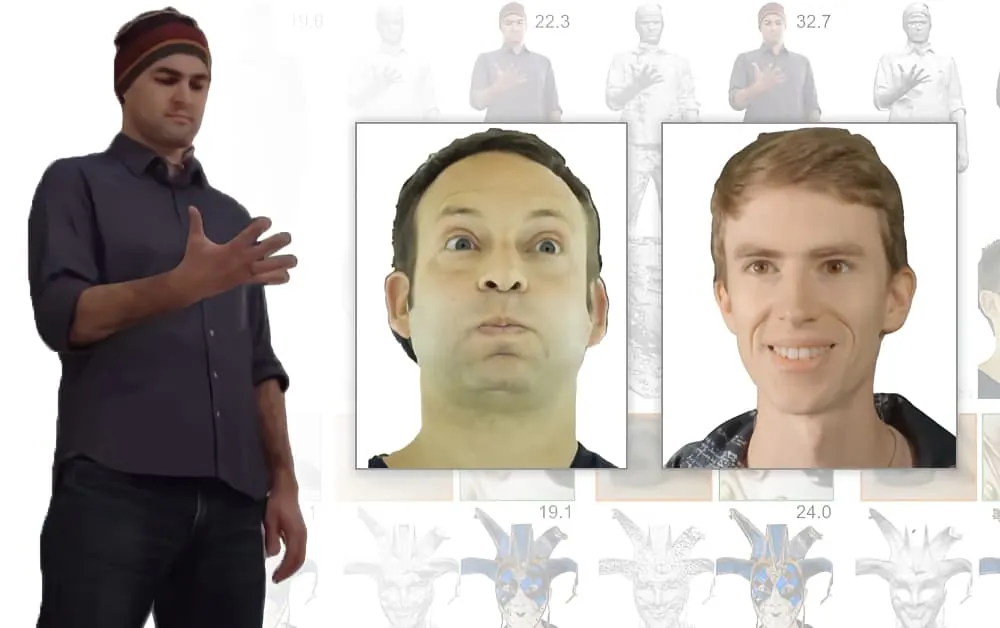
현재 신경 복사장(Neural Radiance Fields, NeRF)에 대한 관심이 급증하고 있음에도 불구하고, AI가 생성한 3D 환경 및 객체를 만들 수 있는 기술인 이 새로운 이미지 합성 접근 방식은 여전히 많은 학습 시간이 필요하고, 실시간으로 고반응 인터페이스를 가능하게 하는 구현이 부족합니다.
하지만 산업과 학계의 몇몇 인상적인 인물들의 협력이 이 과제에 대한 새로운 접근 방식을 제시합니다(일반적으로 Novel View Synthesis, 즉 NVS라고 불립니다).
연구 논문은 Neural Lumigraph Rendering이라는 제목으로, 최첨단 기술 대비 약 두 자릿수(100배) 정도의 향상을 주장하며, 머신러닝 파이프라인을 통한 실시간 CG 렌더링을 향한 여러 단계를 나타냅니다.

Neural Lumigraph Rendering (right) offers better resolution of blending artifacts, and improved handling of occlusion over previous methods. Source.
논문의 저자들은 스탠포드 대학교와 홀로그래픽 디스플레이 기술 회사인 Raxium(현재 스텔스 모드 운영)만을 언급하지만, 기여자에는 Google의 주요 머신러닝 아키텍트, Adobe의 컴퓨터 과학자 (ADBE ), 그리고 CTO인 StoryFile(최근 William Shatner의 AI 버전으로 헤드라인을 만든)가 포함됩니다.
최근 Shatner 관련 홍보와 관련하여, StoryFile은 개인의 특성 및 이야기를 기반으로 인터랙티브하고 AI가 생성한 엔터티를 만들기 위한 새로운 프로세스에 NLR을 활용하고 있는 것으로 보입니다.
StoryFile은 이 기술을 박물관 전시, 온라인 인터랙티브 내러티브, 홀로그래픽 디스플레이, 증강 현실(AR), 그리고 문화유산 문서화에 활용할 것을 구상하고 있으며, 또한 NLR을 채용 인터뷰와 가상 데이팅 애플리케이션 등 새로운 분야에 적용하는 방안을 모색하고 있는 것으로 보입니다.

Proposed uses from an online video by StoryFile.
볼류메트릭 캡처를 이용한 Novel View Synthesis 인터페이스 및 비디오
볼류메트릭 캡처의 원리는, 해당 주제에 관한 논문들이 축적됨에 따라, 정지 이미지나 비디오를 촬영한 뒤 머신러닝을 이용해 원래 카메라 배열이 커버하지 못한 시점들을 ‘채워 넣는’ 것입니다.
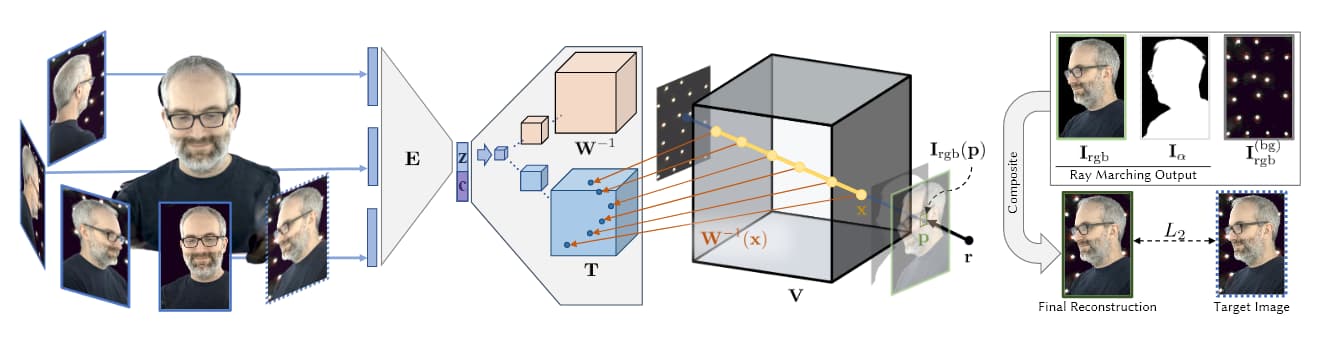
Source: https://research.fb.com/wp-content/uploads/2019/06/Neural-Volumes-Learning-Dynamic-Renderable-Volumes-from-Images.pdf
위 이미지(아래 Facebook의 2019 AI 연구에서 발췌)는 볼류메트릭 캡처의 네 단계를 보여줍니다: 다수의 카메라가 이미지/영상을 획득하고; 인코더/디코더 구조(또는 기타 구조)가 시점의 상대성을 계산·연결하며; 레이 마칭 알고리즘이 볼류메트릭 공간 내 각 점의 voxels(또는 기타 XYZ 공간 기하 단위)를 계산하고; (최근 논문들에서는) 훈련을 통해 실시간으로 조작 가능한 완전한 엔터티를 합성합니다.
이처럼 방대하고 데이터 집약적인 훈련 단계가 지금까지 Novel View Synthesis를 실시간 또는 고반응 캡처 영역에서 벗어나게 만든 주요 요인입니다.
Novel View Synthesis가 볼류메트릭 공간의 완전한 3D 지도를 생성한다는 사실은, 이러한 점들을 전통적인 컴퓨터 생성 메쉬로 쉽게 연결할 수 있음을 의미하며, 이를 통해 CGI 인간(또는 기타 상대적으로 제한된 객체)을 실시간으로 캡처하고 표현할 수 있습니다.
NeRF를 활용하는 접근 방식은 포인트 클라우드와 깊이 맵을 이용해 캡처 장치의 희소한 시점들 사이의 보간을 생성합니다:
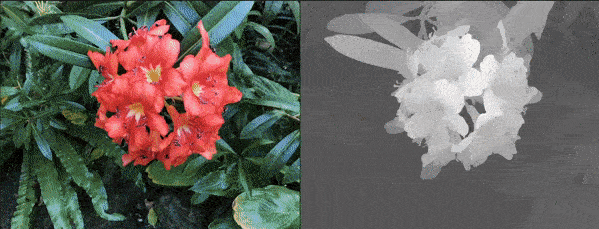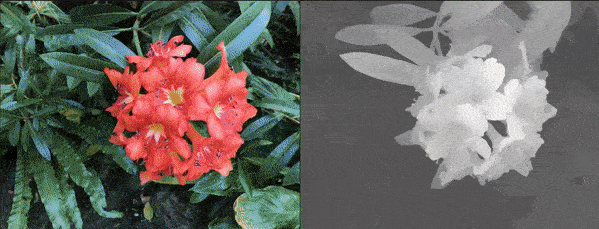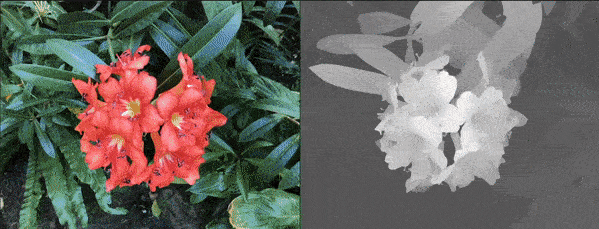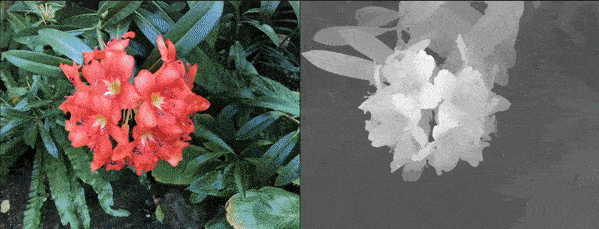
NeRF can generate volumetric depth through calculation of depth maps, rather than generation of CG meshes. Source: https://www.youtube.com/watch?v=JuH79E8rdKc
NeRF는 메시를 계산할 수 있지만, 대부분의 구현에서는 이를 활용해 볼류메트릭 장면을 생성하지 않습니다.
대조적으로, Implicit Differentiable Renderer(IDR) 접근 방식은 2020년 10월 Weizmann Institute of Science에서 발표되었으며, 캡처 배열에서 자동으로 생성된 3D 메쉬 정보를 활용하는 데 초점을 맞춥니다:
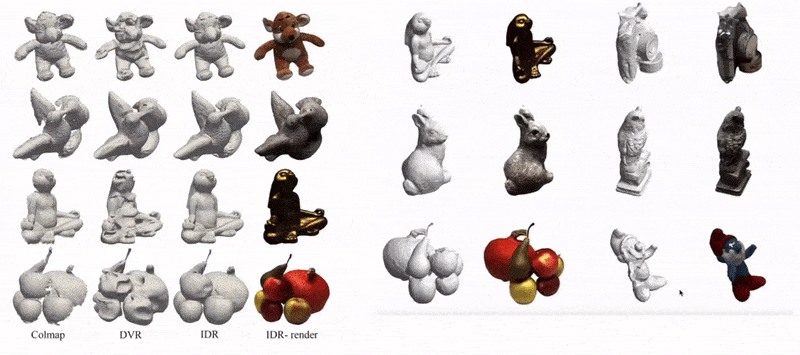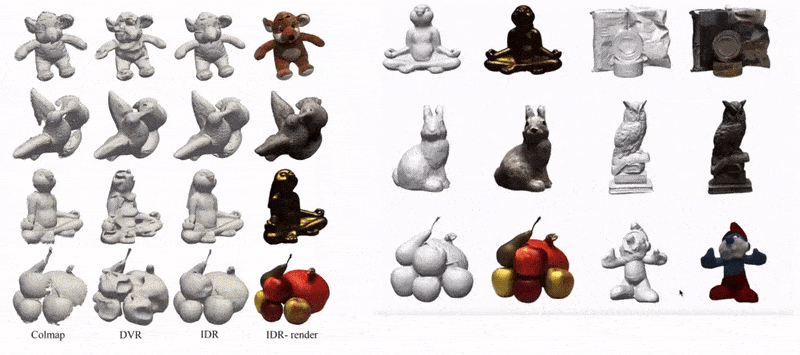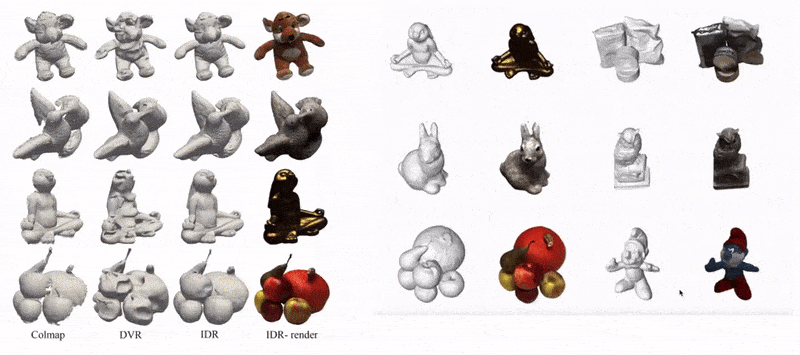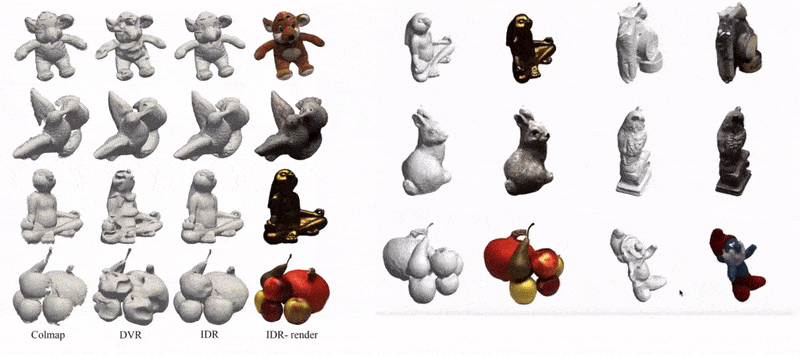
Examples of IDR captures turned into interactive CGI meshes. Source: https://www.youtube.com/watch?v=C55y7RhJ1fE
NeRF는 형태 추정에 있어 IDR의 능력이 부족하지만, IDR은 NeRF의 이미지 품질에 미치지 못하며, 두 방법 모두 훈련 및 데이터 정리에 많은 자원을 필요로 합니다(최근 NeRF의 혁신이 시작되어 이를 해결하려고 하고 있습니다).

NLR’s Custom camera rig featuring 16 GoPro HERO7 and 6 central Back-Bone H7PRO cameras. For ‘real time’ rendering, these operate at a minimum of 60fps. Source: https://arxiv.org/pdf/2103.11571.pdf
대신 Neural Lumigraph Rendering은 SIREN(Sinusoidal Representation Networks)을 활용해 각 접근 방식의 장점을 자체 프레임워크에 통합하며, 이를 통해 기존 실시간 그래픽 파이프라인에서 바로 사용할 수 있는 출력을 생성하고자 합니다.
SIREN은 지난 1년간 유사 구현에 활용되어 왔으며, 현재 이미지 합성 커뮤니티의 취미 개발자용 Colab에서 인기 있는 API 호출로 자리 잡았습니다; 그러나 NLR의 혁신은 SIREN을 2차원 다중 시점 이미지 감독에 적용하는 것으로, SIREN이 과적합된 출력을 생성하는 경향이 있어 일반화된 결과를 얻기 어렵다는 문제가 있습니다.
배열 이미지에서 CG 메쉬를 추출한 뒤, 해당 메쉬는 OpenGL을 통해 래스터화되고 메쉬의 정점 위치가 적절한 픽셀에 매핑됩니다. 이후 다양한 기여 맵들의 블렌딩이 계산됩니다.
결과 메쉬는 NeRF의 메쉬보다 더 일반화되고 대표적이며(아래 이미지 참조), 계산량이 적고, 이득을 얻기 어려운 부위(예: 매끄러운 얼굴 피부)에는 과도한 디테일을 적용하지 않습니다:

Source: https://arxiv.org/pdf/2103.11571.pdf
단점으로는 NLR이 아직 동적 조명이나 재조명 기능을 갖추지 못했으며, 출력이 캡처 시점에 얻은 섀도우 맵 및 기타 조명 요소에 제한됩니다. 연구진은 향후 작업에서 이를 해결할 계획입니다.
또한 논문은 NLR이 생성한 형태가 Pixelwise View Selection for Unstructured Multi-View Stereo와 같은 다른 접근 방식이나 앞서 언급한 Weizmann Institute 연구만큼 정확하지 않다고 인정합니다.
볼류메트릭 이미지 합성의 부상
신경망을 이용해 제한된 사진 시리즈로 3D 엔터티를 생성하는 아이디어는 NeRF보다 앞서며, 2007년 이전의 선구적인 논문들까지 거슬러 올라갑니다. 2019년 Facebook AI 연구 부서는 Neural Volumes: Learning Dynamic Renderable Volumes from Images라는 중요한 논문을 발표했으며, 이는 머신러닝 기반 볼류메트릭 캡처로 생성된 합성 인간에 대한 반응형 인터페이스를 최초로 구현했습니다.
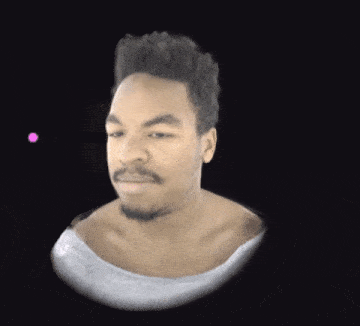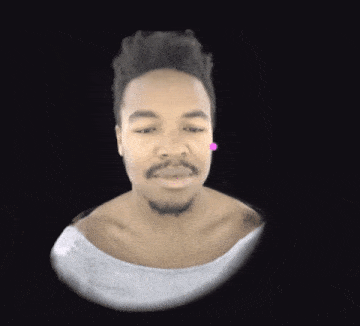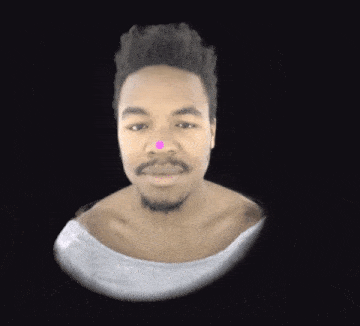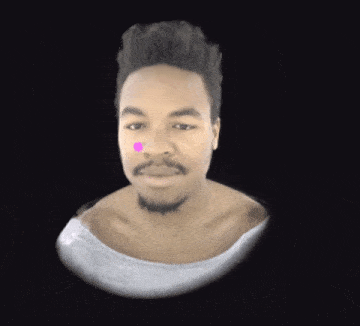
Facebook’s 2019 research enabled the creation of a responsive user interface for a volumetric person. Source: https://research.fb.com/publications/neural-volumes-learning-dynamic-renderable-volumes-from-images/


