
사상 리더
3가지 개인정보 보호 기법을 통한 기계학습 기술, 이번 δεCADE의 가장 중요한 문제 해결

 Unite.AI를 Google의 선호 소스에 추가
Persistent Systems (PERSISTENT.BO ) 의 기계학습 및 AI 연구자 Amogh Tarcar입니다.
전문가들은 데이터 개인정보 보호가 이번 δεCADE의 가장 중요한 문제가 될 것이라고 말합니다. 이는 특히 기계학습에서 알고리즘이大量의 데이터를 사용하는 경우에 더욱 중요합니다.
기계학습 모델링 기술은 전통적으로 여러 소스에서 데이터를 중앙 집중식으로 수집하여 사용했습니다. 그러나 이러한 기술은 개인정보 보호에 대한 여러 도전을 안겨줍니다. 다양한 소스에서 데이터를 수집하는 것은 HIPAA, GDPR, CCPA와 같은 규제 문제로 인해 더 이상 가능하지 않습니다. 또한 데이터를 중앙 집중식으로 수집하면 데이터 유출 및 보안 위협의 범위와 규모가 증가합니다.
이러한 도전을 극복하기 위해 개인정보 보호 기계학습(PPML)의 여러 기둥이 개발되었습니다. 여기에는 개인정보 위험을 줄이고 데이터가 합리적으로 안전하게 유지되도록 하는 특정 기술이 포함됩니다. 여기서 몇 가지 가장 중요한 기술을 살펴보겠습니다.
1. 연합학습
연합학습은 데이터 수집 문제를 뒤집는 기계학습 훈련 기술입니다. 데이터를 수집하여 단일 기계학습 모델을 생성하는 대신, 연합학습은 기계학습 모델 자체를 수집합니다. 이는 데이터가 출처 위치를 떠나지 않으며, 여러 당사자가 직접敏感한 데이터를 공유하지 않고도 공통의 기계학습 모델을 구축할 수 있도록 합니다.
작동 원리는 다음과 같습니다. 기본 기계학습 모델을 시작으로 클라이언트 노드에 공유합니다. 클라이언트 노드는 자신의 데이터를 사용하여 모델을 로컬로 훈련합니다. 모델 업데이트는 정기적으로 조정 노드에 공유되며, 조정 노드는 업데이트를 처리하여 새로운 글로벌 모델을 얻습니다. 이렇게 하면 데이터를 공유하지 않고도 다양한 데이터셋의 정보를 얻을 수 있습니다.

출처: Persistent Systems
의료 분야에서 이는 환자 데이터를 안전하게 유지하면서 연구자에게 집단의 지혜를 제공하는 강력한 도구입니다. 데이터를 수집하지 않음으로써 연합학습은 보안의 추가적인 계층을 생성합니다. 그러나 모델과 모델 업데이트는 여전히 취약점이 존재하면 보안 위험을 초래할 수 있습니다.
2. 차분 개인정보
기계학습 모델은 종종 멤버십 추론 공격의 대상이 됩니다. 예를 들어, 암 백신 개발을 위해 병원에 자신의 의료 데이터를 공유했다고 가정합니다. 병원은 데이터를 안전하게 유지하지만, 연합학습을 사용하여 공개적으로 사용 가능한 기계학습 모델을 훈련합니다. 몇 달 후, 해커들은 멤버십 추론 공격을 사용하여 모델 훈련에 자신의 데이터가 사용되었는지 여부를 확인합니다. 그런 다음 해커들은 이러한 정보를 보험 회사에 전달하여 암 발병 위험에 따라 보험료를 인상할 수 있습니다.
차분 개인정보는 기계학습 모델에 대한 적대적 공격이 모델 훈련에 사용된 특정 데이터 포인트를 식별하지 못하도록 합니다. 이는 모델 훈련 중에 “통계적 노이즈”를 추가하여 데이터 또는 기계학습 모델 매개변수를 섭동시킴으로써 달성됩니다. 이렇게 하면 공격을 실행하여 모델 훈련에 특정 개인의 데이터가 사용되었는지 여부를 확인하기가 어려워집니다.
예를 들어, Facebook은 최근 Opacus를 출시했습니다. Opacus는 PyTorch 모델을 차분 개인정보를 사용하여 훈련할 수 있는 고속 라이브러리입니다. 다음 애니메이션은 데이터를 가리기 위해 노이즈를 사용하는 방법을 보여줍니다.
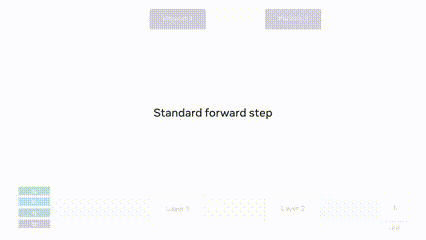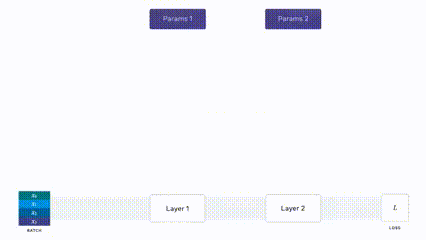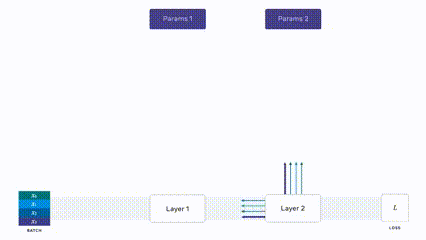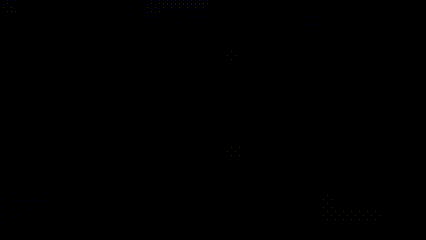
이 노이즈는 Epsilon이라는 매개변수에 의해 제어됩니다. Epsilon 값이 낮으면 모델은 완벽한 데이터 개인정보 보호를 제공하지만, 유틸리티와 정확도가 낮습니다. 반대로, Epsilon 값이 높으면 데이터 개인정보 보호가 낮아지지만 정확도가 높아집니다. 트릭은 데이터 개인정보 보호와 유틸리티를 모두 최적화하는 균형을 찾는 것입니다.
3. 호모모르픽 암호화
표준 암호화는 기계학습과 호환되지 않습니다. 데이터가 암호화되면 기계학습 알고리즘이 더 이상 데이터를 이해할 수 없습니다. 그러나 호모모르픽 암호화는 특정 계산을 수행할 수 있는 특별한 암호화 체계입니다.

출처: OpenMined
이 기술의 힘은 훈련이 완전히 암호화된 공간에서 발생할 수 있다는 것입니다. 이는 데이터 소유자를 보호할 뿐만 아니라 모델 소유자를 보호합니다. 모델 소유자는 암호화된 데이터에서 추론을 실행할 수 있지만 데이터를 볼 수는 없습니다.
연합학습에 적용하면 모델 업데이트의 융합이 완전히 암호화된 환경에서 발생하므로 멤버십 추론 공격의 위험이 크게 줄어듭니다.
개인정보 보호의 δεCADE
2021년을 시작하면서, 개인정보 보호 기계학습은 활발한 연구가 진행되는 새로운 분야입니다. 지난 δεCADE가 데이터를 분리하는 데 관한 것이었다면, 이번 데CADE는 연합학습, 차분 개인정보, 호모모르픽 암호화를 통해 기계학습 모델을 분리하는 데 관한 것입니다. 이는 개인정보 보호를 고려한 방식으로 기계학습 솔루션을 발전시키는 새로운 방법을 제공합니다.


