
AI 모델 및 플랫폼
연구팀, 뉴럴 네트워크를 비교하는 접근법 개발

 Unite.AI를 Google의 선호 소스에 추가
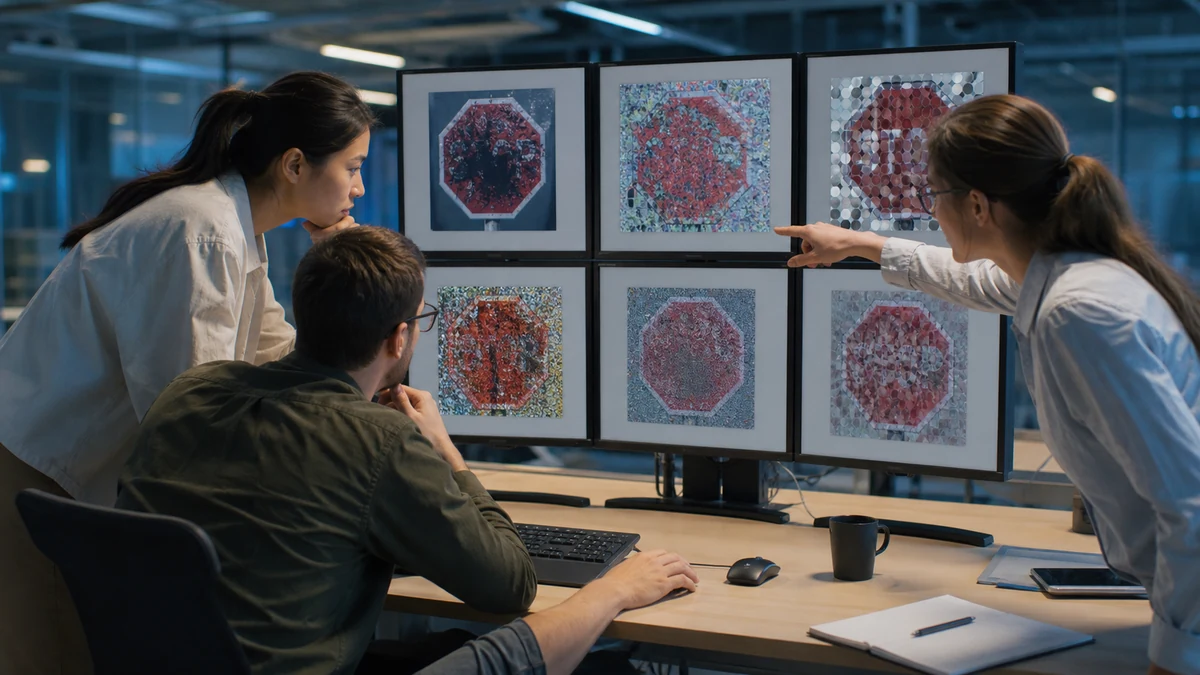
로스 알라모스 국립 연구소의 연구자 팀은 뉴럴 네트워크를 비교하기 위한 새로운 접근법을 개발했습니다. 팀에 따르면, 이 새로운 접근법은 인공 지능(AI)의 “블랙 박스” 안으로 들어가서 뉴럴 네트워크의 동작을 이해하는 데 도움이 됩니다. 데이터셋에서 패턴을 인식하는 뉴럴 네트워크는 얼굴 인식 시스템 및 자율 주행 자동차와 같은 다양한 응용 분야에서 사용됩니다.
팀은 그들의 논문, “If You’ve Trained One You’ve Trained Them All: Inter-Architecture Similarity Increases With Robustness,”를 인공지능의 불확실성에 관한 학회에서 발표했습니다.
헤이든 존스는 로스 알라모스 국립 연구소의 사이버 시스템 첨단 연구 그룹에서 연구원으로 일하며, 연구 논문의 제1저자입니다.
뉴럴 네트워크에 대한 더 나은 이해
“인공 지능 연구 커뮤니티는 뉴럴 네트워크가 하는 일을 언제나 완전히 이해하는 것은 아닙니다. 그들은 좋은 결과를 제공하지만, 우리는 어떻게 그리고 왜 그런 결과가 나왔는지 모릅니다,” 존스는 말했다. “우리의 새로운 방법은 뉴럴 네트워크를 비교하는 데 더 나은 일을 합니다. 이는 인공 지능의 바탕이 되는 수학을 더 잘 이해하는 데 중요한 단계입니다.”
새로운 연구는 또한 강건한 뉴럴 네트워크의 동작을 이해하는 데 도움이 될 것입니다.
뉴럴 네트워크는 높은 성능을 가지고 있지만, 또한 취약합니다. 작은 조건의 변화, 예를 들어 자율 주행 자동차가 처리하는 부분적으로 가려진 정지 표지는 뉴럴 네트워크가 표지를 잘못 식별하게 할 수 있습니다. 이 때문에 자동차가 끝내 멈추지 않을 수도 있으며, 이는 위험할 수 있습니다.
뉴럴 네트워크의 적대적 훈련
연구자들은 이러한 유형의 뉴럴 네트워크를 개선하기 위해 네트워크의 강건성을 향상시키는 방법을 조사했습니다. 접근법 중 하나는 네트워크를 훈련하는 동안 “공격”하는 것입니다. 여기서 연구자들은 의도적으로 훈련 중에 비정상성을 도입하여 AI가 이를 무시하도록 합니다. 이 과정은 적대적 훈련이라고 하며, 네트워크를 속이는 것을 더 어렵게 만듭니다.
팀은 새로운 네트워크 유사성 지표를 적대적 훈련을 받은 뉴럴 네트워크에 적용했습니다. 그들은 네트워크 구조와 상관없이, 공격의 크기가 증가함에 따라 적대적 훈련이 컴퓨터 비전 분야의 뉴럴 네트워크를 유사한 데이터 표현으로 수렴하게 만든다는 것을 발견했을 때 놀랐습니다.
“우리는 뉴럴 네트워크를 적대적 공격에 강건하도록 훈련하면, 이들이 같은 일을 하기 시작한다는 사실을 발견했습니다,” 존스는 말했다.
전문가들이 뉴럴 네트워크를 위한 완벽한 아키텍처를 찾으려 한 것은 이번이 처음이 아닙니다. 그러나 새로운 발견은 적대적 훈련이 갭을 크게 줄인다는 것을 보여줍니다. 이는 인공 지능 연구 커뮤니티가 그렇게 많은 새로운 아키텍처를 탐색할 필요가 없을 수 있다는 것을 의미합니다. 왜냐하면 적대적 훈련이 다양한 아키텍처를 유사한 솔루션으로 수렴시키기 때문입니다.
“강건한 뉴럴 네트워크들이 서로 비슷하다는 사실을 알아냄으로써, 강건한 인공 지능이 실제로 어떻게 작동할 수 있는지 더 쉽게 이해할 수 있게 되었습니다,” 존스는 말했다. “우리는 인간과 다른 동물에서 지각이 어떻게 발생하는지에 대한 힌트를 발견할 수도 있습니다.”



