
인터뷰
Omri Geller, Run:AI의 CEO & 공동 창립자 – 인터뷰 시리즈

 Unite.AI를 Google의 선호 소스에 추가
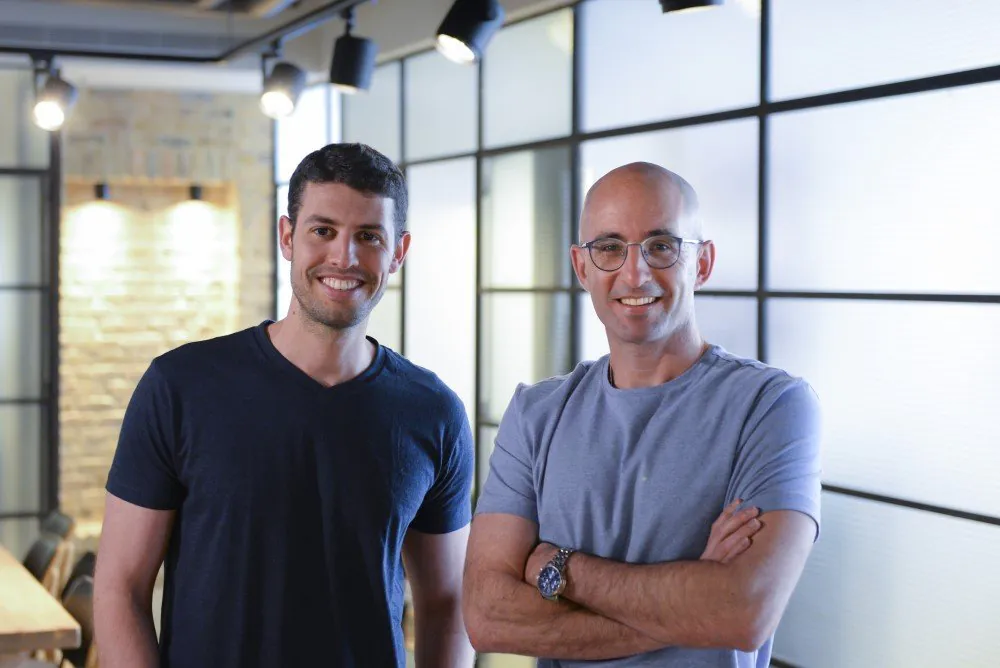
Omri Geller는 Run:AI의 CEO이자 공동 창립자입니다.
Run:AI는 GPU 컴퓨팅 리소스를 풀링하여 가시성과 리소스 우선순위 및 할당에 대한 제어를 제공함으로써 AI를 가상화하고 가속화합니다. 이는 AI 프로젝트가 비즈니스 목표에 매핑되고 데이터 과학 팀의 생산성이 크게 향상되도록 보장합니다. 이는 데이터 과학자들이 리소스 제한 없이 동시에 모델을 구축하고 훈련할 수 있도록 합니다.
당신은 처음에 인공 지능에 관심을 갖게 된 이유는 무엇입니까?
나는 텔 아비브 대학교에서 전기 및 전자 공학 학사 학위를 시작했을 때, 컴퓨팅 가능성의 다음 단계로 우리를 데려갈 수 있는 것에 대해 흥미로운 것을 발견했습니다. 그 때부터 나는 AI 연구 또는 AI를 세계에 적용하는 새로운 방법을 도입하는 회사 설립에 투자하고 싶었습니다.
당신은 항상 컴퓨터 하드웨어에 관심이 있었나요?
나는 6세 또는 7세 때 인텔 486 프로세서가 장착된 첫 번째 컴퓨터를 받았을 때, 모든 것이 어떻게 작동하는지 알아보기 위해 즉시 관심을 가졌습니다. 비록 나는 그것을真正로 이해하기에는 너무 어렸을 수도 있지만, 컴퓨터는 스포츠 외에도私の最大의 취미 중 하나가되었습니다. 이후로 나는 컴퓨터를 구축하고 작업했으며, 어린 시절의 열정 때문에 그 분야를 공부했습니다.
(INTC )Run:AI를 출시한 영감은 무엇입니까?
나는 매우 초기부터 AI 분야에 투자하고 싶었습니다. 최근 몇 년 동안 산업은 엄청난 성장과 함께 AI의 성장에 큰 발전을 이루었으며, 이는 컴퓨터 과학자와 하드웨어의 발전으로 가능했습니다. 나는 결국 회사를 설립할 것이며, 공동 창립자 Ronen Dar와 함께 혁신을 계속하고 기업에 AI를 더 많이 도입하는 것을 도와줄 것입니다.
Run:AI는 기계 학습 전문가가 GPU 리소스 할당에 대한 새로운 유형의 제어를 얻을 수 있도록 합니다. 어떻게 작동합니까?
우리는 기계 학습 엔지니어, 연구자 및 데이터 과학자가 유연한 방식으로 컴퓨팅 파워를 소비해야 한다는 것을 이해해야 합니다. 오늘날의 최신 계산은 매우 컴퓨팅 집약적이며, 데이터 과학에서 사용되는 새로운 워크플ロー도 있습니다. 이러한 워크플로는 실험을 실행하고 실험에 기반한 것입니다.
보다 효율적인 실험을 실행하기 위한 새로운 솔루션을 개발하기 위해, 우리는 이러한 워크플로우 경향을 시간에 걸쳐 연구해야 합니다. 예를 들어, 데이터 과학자는 하루에 8개의 GPU를 사용할 수 있지만, 다음 날에는 0개 또는 1개의 GPU를 오랜 기간 동안 사용할 수 있습니다. 그러나 100개의 실험을 동시에 실행하려면 100개의 GPU가 필요할 수 있습니다. 한 사용자의 워크플로우를 이해한 후, 우리는 이를 여러 사용자에게 확장할 수 있습니다.
전통적인 컴퓨팅에서는 사용자마다 특정 수의 GPU가 할당되며, 사용 중인지 여부에 관계없이 할당됩니다. 이러한 방법으로, 비싼 GPU는 아무도 사용하지 않는 상태로闲置되어 있기 때문에, GPU의 ROI가 낮아집니다. 우리는 회사의 재정 우선순위를 이해하고, 사용자의需求에 따라 리소스를 동적으로 할당할 수 있는 솔루션을 제공합니다. 유연한 시스템을 제공함으로써, 우리는 특정 사용자에게 필요할 때 추가 파워를 할당할 수 있으며, 다른 사용자에 의해 사용되지 않는 GPU를 사용하여 회사의 컴퓨팅 리소스에 대한 최대 ROI를 창출하고, AI 솔루션의 혁신 및 시장 출시 시간을 가속화할 수 있습니다.
Run:AI의 기능 중 하나는 정적 GPU 할당으로 생성된 블라인드 스폿을 줄이는 것입니다. 어떻게 이 작업을 수행합니까?
우리는 리소스 클러스터에 대한 가시성을 제공하는 도구를 가지고 있습니다. 이 도구를 사용하여, 블라인드 스폿이 있는지 확인하고,闲置 중인 GPU를 사용자에게 할당할 수 있습니다. 클러스터에 대한 가시성과 제어를 제공하는 동일한 도구는 또한 이러한 블라인드 스폿을 완화합니다.
최근 연설에서, 빌드 및 훈련 워크플로우 간의 구별에 대해 강조했습니다. Run:AI는 GPU 큐 관리 메커니즘을 사용하여 빌드 및 훈련 워크플로우 모두에 대한 리소스 관리를 어떻게 할당합니까?
AI 모델은 두 단계로 구축됩니다. 첫 번째 단계는 모델을 구축하는 단계로, 데이터 과학자가 실제 모델을 구축하기 위한 코드를 작성하는 단계입니다. 두 번째 단계는 모델이 완성된 후 특정 작업을 최적화하는 방법을 학습하고 “훈련”하는 단계입니다.
모델을 구축하는 데에는 많은 컴퓨팅 파워가 필요하지 않습니다. 그러나 모델을 테스트하고 완성하기 위해 더 강력한 처리 파워가 필요할 수 있습니다. 예를 들어, 엔지니어가 자동차를 조립한 후 엔진을 테스트하고 싶을 때와 같습니다. 이러한 각 단계에서 서로 다른需求으로 인해, Run:AI는 모델을 구축하거나 훈련하는 동안 GPU 할당을 허용합니다. 그러나 모델을 훈련하는 데에는 일반적으로 모델을 구축하는 데보다 더 많은 GPU 파워가 필요합니다.
Run:AI를 시스템에 통합하려는 AI 개발자는 원시 컴퓨팅 시간/리소스를 얼마나 절약할 수 있습니까?
Run.ai의 솔루션은 리소스의 디지털화를 약 2~3배로 개선할 수 있습니다. 이는 전체 생산성이 2~3배 더 좋아진다는 것을 의미합니다.
인터뷰에 감사드립니다. 더 많은 정보를 원하는 독자는 Run:AI를 방문할 수 있습니다.


