
AI 모델 및 플랫폼
LoRA, QLoRA 및 QA-LoRA: 저랭크 행렬 분해를 통한 대규모 언어 모델의 효율적인 적응

 Unite.AI를 Google의 선호 소스에 추가

대형 언어 모델(Large Language Models, LLM)은 인간과 같은 텍스트를 이해하고 생성하는 능력에서 독특한 지위를 차지했습니다. LLM의 강력한 성능은 그들의 거대한 크기에서 비롯되며, 종종 수십억 개의 매개변수를 가지고 있습니다. 그러나 이러한 거대한 규모는 모델을 특정 작업이나 도메인에 맞게 조정할 때 어려움을 겪을 수 있습니다. LLM을 관리하는 전통적인 방법은 모든 매개변수를 미세 조정하는 것이며, 이는 계산 및 재정적 부담을 가중시킵니다.
이전 기사에서 우리는 LLM을 특정 요구 사항에 맞게 미세 조정하는 방법에 대해 살펴보았습니다. 우리는 지시 기반 미세 조정, 단일 작업 미세 조정 및 매개변수 효율적인 미세 조정과 같은 다양한 미세 조정 방법에 대해 논의했습니다. 이러한 방법은 모두 고유한 접근 방식을 가지고 있으며, transformer 아키텍처는 LLM의 핵심입니다. 그러나 이러한 방법은 계산 및 메모리 요구 사항이 많아 실용적이지 않을 수 있습니다.

https://huggingface.co/blog/hf-bitsandbytes-integration
위 이미지는 다양한 대형 언어 모델의 매개변수 수를 나타냅니다. 특히, PaLM, BLOOM 등이 있습니다.
최근 몇 년 동안 더 큰 모델이 개발되었습니다. 그러나 이러한 거대한 모델을 표준 시스템에서 미세 조정하는 것은 전문적인 최적화 기술 없이 불가능합니다.
마이크로소프트가 논문에서 제안한 저랭크 행렬 적응(LoRA)은 이러한 문제를 완화하고 LLM을 더 접근하기 쉽고 조정하기 쉽게 만드는 것을 목표로 합니다.
(MSFT )LoRA의 핵심은 모델을 조정하는 데 필요한 매개변수의 수를 줄이는 것입니다. 전통적인 미세 조정 방법과 달리, LoRA는 모델의 가중치를 동결하고 transformer 아키텍처의 각 레이어에 학습 가능한 저랭크 행렬을 도입합니다. 이 접근 방식은 미세 조정 과정을 더 효율적으로 만듭니다.
LLM 조정 전략의 진화
LLM 조정의 역사에 대해 살펴보면, 여러 전략이 사용되어 왔습니다. 초기에는 미세 조정을 위한 전통적인 방법이 사용되었습니다. 그러나 모델의 크기가 커짐에 따라, 이러한 방법은 계산 요구 사항이 많아졌습니다.
다음 전략은 부분 미세 조정으로, 모델의 매개변수 중 일부만 미세 조정하는 방법입니다. 이 방법은 계산 부담을 줄이지만, 여전히 모델의 크기에 비해 효율적이지 못했습니다.
LoRA 소개
행렬의 랭크는 선형 독립인 행 또는 열의 수입니다. 원문 설명을 명확히 하면, 단지 서로 다른 행이나 열의 개수가 아니라 선형 독립성이 기준입니다.
- 전체 랭크 행렬: 랭크는 행렬의 행과 열 중 작은 쪽과 일치합니다.
- 저랭크 행렬: 랭크는 행렬의 행과 열 중 작은 쪽보다 작습니다.
대형 모델은 도메인에 대한 광범위한 이해를 가지고 있습니다. 그러나 특정 작업에 대한 미세 조정은 이러한 이해의 작은 부분만을 강조하는 경우가 많습니다. 여기서 LoRA가 빛을 발합니다. LoRA는 가중치 조정 행렬이 저랭크 행렬일 수 있다고 제안합니다. 따라서 LoRA는 이 행렬을 두 개의 작은 랭크 행렬로 분해하여 미세 조정 과정을 더 효율적으로 만듭니다.
Transformer에 LoRA 적용
LoRA는 신경망에서 특정 가중치 행렬에 초점을 맞춰서 훈련 부담을 줄입니다. Transformer 아키텍처에서, 일부 가중치 행렬은 자기 주의 메커니즘과 관련이 있으며, Wq, Wk, Wv, Wo가 해당하며, 다층 퍼셉트론(MLP) 모듈에도 추가로 두 가중치 행렬이 있습니다.

Transformers Architecture

Transformer Attention Heads
LoRA의 수학적 설명
LoRA의 수학적 원리를 살펴보겠습니다.
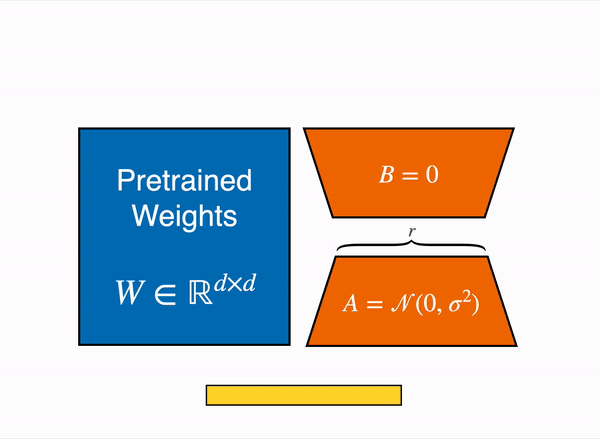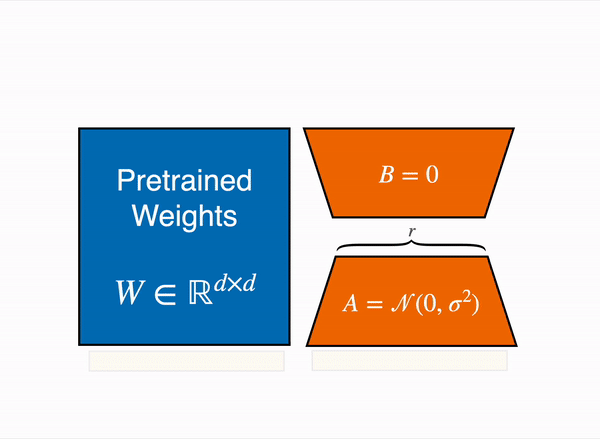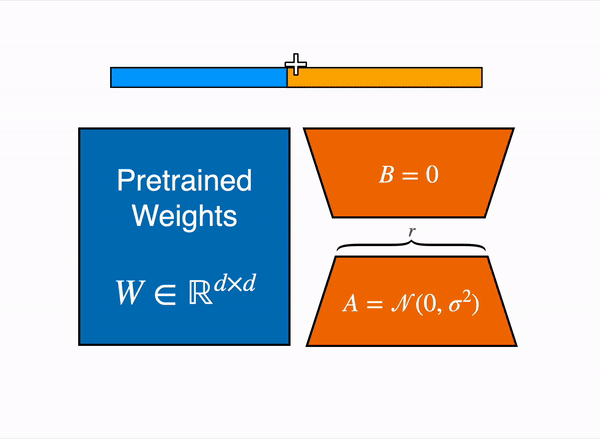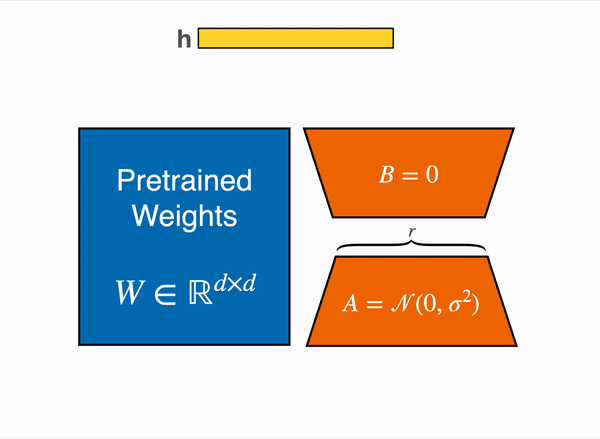
- 사전 훈련된 가중치 행렬 :
- 사전 훈련된 가중치 행렬에서 시작하며, 해당 행렬 의 크기는 입니다. 즉, 행렬의 행 수는 이고 열 수는 입니다.
- 저랭크 분해:
- 전체 행렬을 직접 갱신하는 대신, 행렬 의 갱신에 저랭크 분해를 사용하여 계산 부담을 줄입니다.
- 갱신량 는 기준 가중치 행렬 에 대한 것으로, 다음 두 행렬의 곱으로 나타낼 수 있습니다. 및 .
- 의 크기는
- 의 크기는
- 핵심은 랭크 가 두 차원 및 보다 훨씬 작아 계산 효율적인 표현이 가능하다는 점입니다.
- 훈련:
- 훈련 과정에서 는 변하지 않습니다. 이를 가중치 동결이라고 합니다.
- 반면 및 는 훈련 가능한 매개변수입니다. 훈련 중 조정되는 행렬은 및 이며 이를 통해 모델 성능을 개선합니다.
- 곱셈과 덧셈:
- 두 항 및 갱신량 (두 행렬의 곱, 즉 및 )에는 동일한 입력을 곱합니다. 입력은 입니다.
- 이 곱셈들의 결과를 서로 더합니다.
- 이 과정은 다음 식으로 요약됩니다. 여기서 는 갱신을 적용한 최종 출력이며 입력은 .
이 방법은 갱신량을 저랭크 분해로 표현하여 큰 가중치 행렬을 더 효율적으로 갱신하며, 계산 효율과 메모리 사용량에 이점을 제공합니다.
LORA
초기화 및 스케일링:
매개변수 초기화 방식은 학습의 효율과 효과에 큰 영향을 줍니다. 여기서는 다음 두 행렬을 이용한 가중치 갱신을 살펴봅니다. 및 :
- 행렬 초기화: 및 :
- 행렬 : 정규분포의 임의 값으로 초기화합니다. 가우시안 초기화는 대칭을 깨뜨리기 위한 것입니다. 같은 층의 뉴런도 초기 가중치가 다르면 서로 다른 특징을 학습할 수 있습니다.
- 행렬 : 0으로 초기화하므로 갱신량 는 훈련 시작 시 0입니다. 따라서 모델 행동이 갑자기 변하지 않으며 행렬 가 훈련 중 적절한 값을 학습하면서 모델이 점차 적응합니다.
- 다음 갱신량의 출력 스케일링: :
- 갱신량을 계산한 뒤, 갱신량 의 출력에 다음 계수를 적용합니다. 여기서 는 상수이며 스케일링으로 갱신 크기를 제어합니다.
- 스케일링은 특히 랭크 가 바뀔 때 중요합니다. 예를 들어 계산 비용을 더 들여 랭크를 높일 때 스케일링은 다른 많은 하이퍼파라미터를 함께 바꿀 필요를 줄이고 모델의 안정성을 유지하는 데 도움이 됩니다.
LoRA의 실제 영향
AI 커뮤니티는 이미지 모델을 특정 예술 스타일에 맞추는 데도 LoRA를 사용합니다. 영어 원문을 바로잡으면 다음 사례는 언어 모델이 아닌 이미지 모델 SDXL용 어댑터입니다. 이는 Greg Rutkowski의 예술 스타일을 모방하는 모델을 조정하는 데 특히 두드러졌습니다.
예를 들어, GPT-3 175B를 사용하는 경우, 개별적으로 미세 조정된 175B 매개변수를 가진 모델의 개별 인스턴스를 가지는 것은 매우 비용이 많이 듭니다. 그러나 LoRA를 사용하면 훈련 가능한 매개변수가 10,000배 줄어들고, GPU 메모리 사용량은 3분의 1로 줄어듭니다.

LoRa impact on GPT-3 Fine Tuning
LoRA는 LLM을 더 접근하기 쉽게 만들고, 이론적 발전과 실제 응용 사이의 격차를 좁히는 데 중요한 역할을 할 수 있습니다. 계산적 장벽을 완화하고 모델 조정을 더 효율적으로 만듦으로써, LoRA는 실제 시나리오에서 LLM을 더 폭넓게 사용하는 데 기여할 수 있습니다.
QLoRA (Quantized)
LoRA는 저장 공간을 줄이는 데 도움이 되지만, 여전히 모델을 로드하기 위해 대규모 GPU가 필요합니다. 여기서 QLoRA(Quantized LoRA)가 등장합니다. QLoRA는 LoRA와 Quantization을 결합하여 더 지능적인 접근 방식을 제공합니다.

Quantization
일반적으로, 가중치 매개변수는 32비트 형식(FP32)으로 저장되며, 각 요소는 32비트의 공간을 차지합니다. 만약 동일한 정보를 8비트 또는 4비트로 압축할 수 있다면? 이것이 QLoRA의 핵심 아이디어입니다. Quantization은 연속적인 무한한 값을 더 작은 집합의 이산적인 유한한 값으로 매핑하는 과정입니다. LLM의 경우, 모델의 가중치를 더 높은 정밀도의 데이터 형식에서 더 낮은 정밀도의 데이터 형식으로 변환하는 것을 의미합니다.

Quantization in LLM
QLoRA의 간단한 설명은 다음과 같습니다:
- 초기 Quantization: 먼저, LLM을 4비트로 Quantization하여 메모리 사용량을 크게 줄입니다.
- LoRA 훈련: 다음으로 더 높은 계산 정밀도에서 LoRA 어댑터를 훈련합니다. 영어 기사에는 FP32라고 되어 있지만, 원래 QLoRA 논문은 일반적으로 계산과 어댑터 매개변수에 BF16을 사용합니다. 기본 가중치는 4비트로 저장된 채 동결되며, 계산할 텐서만 역양자화하고 가중치 기울기는 LoRA 어댑터에 대해서만 계산합니다.
LoRA는 Hugging Face의 PEFT 라이브러리에서 사용할 수 있습니다. QLoRA는 bitsandbytes와 PEFT의 조합으로 활용하며, TRL은 LoRA를 지원하는 지도 미세 조정을 제공합니다. 이 라이브러리들은 사전 훈련 모델을 조정하여 특정 속성 지시에 따라 설득력 있고 일관된 제품 설명을 생성하는 등의 작업을 지원합니다.
영어 원문은 QLoRA 이후 어댑터 변환·병합의 어려움을 지적합니다. 모든 배포 방식이 전체 가중치를 항상 높은 정밀도로 저장해야 한다는 뜻은 아닙니다. 다음 QA-LoRA는 그룹 단위 연산을 통해 양자화와 적응을 결합하고 최종 가중치를 양자화된 모델로 통합하는 방법입니다.
제안된 해결책은 가중치 행렬을 더 작은 세그먼트로 나누고, 각 세그먼트에 Quantization과 저랭크 적응을 개별적으로 적용하는 것입니다. QA-LoRA라는 새로운 방법은 Quantization과 저랭크 적응의 이점을 결합하여 효율적이고 효과적인 모델을 제공합니다.
결론
이 기사에서 우리는 LLM의 거대한 매개변수 크기에서 비롯되는 문제를 살펴보았습니다. 우리는 전통적인 미세 조정 방법과 그에 따른 계산 및 재정적 부담에 대해 논의했습니다. LoRA는 미세 조정을 위한 새로운 접근 방식을 제공하며, 기본 모델 전체를 재훈련하지 않고 어댑터의 매개변수를 학습하여 미세 조정을 수행할 수 있습니다. 우리는 또한 QLoRA(Quantized LoRA)에 대해 간략히 소개했습니다. QLoRA는 LoRA와 Quantization을 결합하여 모델의 메모리 사용량을 줄이는 동시에 훈련 정밀도를 유지합니다. 이러한 기술을 통해, 실제 시나리오에서 LLM을 더 쉽게 사용하고, 이론적 발전과 실제 응용 사이의 격차를 좁힐 수 있습니다.

Matrix
이러한 전략은 특정 작업에 맞게 LLM을 조정하는 것과 미세 조정 및 배포 프로세스가 계산 및 저장 자원에 과도한 부담을 주지 않는 것을 균형 있게 조정하는 데 사용됩니다.


