
Anderson의 관점
AI가 과거 시대에 아이폰을 묘사하는 것을 멈추는 방법

 Unite.AI를 Google의 선호 소스에 추가
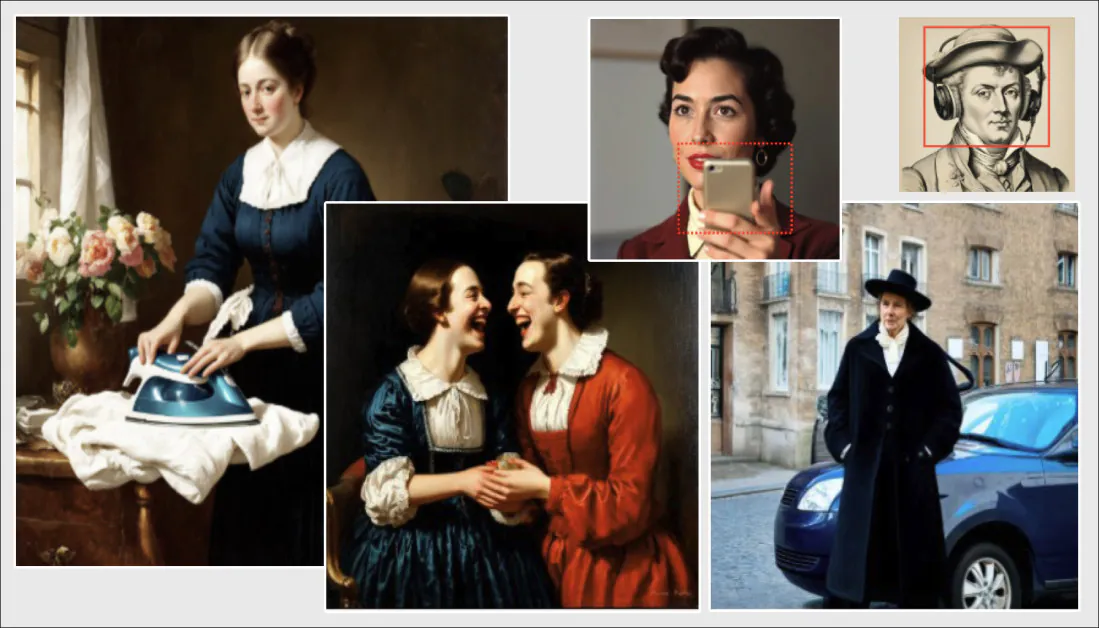
AI 이미지 생성기는 과거를 어떻게 그릴까? 새로운 연구에 따르면 모델은 18세기에 스마트폰을 떨어뜨리고, 1930년대 장면에 노트북을 넣으며, 19세기 가정에 진공청소기를 배치한다. 이는 모델이 역사를 어떻게 상상하며 맥락에 맞는 역사적 정확성을 가질 수 있는지 묻게 한다.
2024년 초 Google Gemini의 이미지 생성 기능은 제2차 세계대전 독일군을 역사적으로 가능성이 낮은 인구 구성으로 표현하는 등, 부적절한 맥락에 인구통계적 공정성을 강제했다는 비판을 받았다.

이는 편향을 바로잡으려는 시도가 역사적 맥락을 무시한 사례였고 곧 수정됐다. 하지만 확산 모델은 여전히 현대와 과거의 사물과 관습을 뒤섞는다.
원인 중 하나는 학습 데이터에서 함께 자주 등장한 특성이 출력에서도 결합되는 ‘얽힘’이다. 스마트폰이 대화나 듣기와 자주 함께 나오면, 모델은 역사적 시대가 지정돼도 해당 활동을 현대 기기와 연결한다. 이런 연관이 내부 표현에 자리 잡으면 활동과 현대 맥락을 분리하기 어렵다.
취리히대 연구진의 논문 Synthetic History: Evaluating Visual Representations of the Past in Diffusion Models은 잠재 확산 모델의 역사적 얽힘을 조사했다. 사실적인 사람을 만들 수 있는 모델도 과거 인물을 ‘과거다운’ 매체 양식으로 표현하는 경향이 있었다.

‘[역사적 시대]에 친구와 웃는 사람의 사실적 이미지’라는 프롬프트에서도 한 모델은 ‘흑백’이라는 부정 프롬프트를 무시하고, 1950년대와 1970년대 셀룰로이드 필름의 탁한 색조처럼 해당 시대의 매체 양식을 사용했다.
세 모델은 노래나 요리처럼 시대를 초월한 활동을 현대 장비와 결합하는 시대착오도 반복했다.

스마트폰은 사진과 통신의 개념에서 특히 분리하기 어렵다. Common Crawl 같은 초대형 데이터셋에 현대 기기 이미지가 압도적으로 많기 때문이다.

취약한 ‘진실’
연구는 역사 표현에서 인종과 성별의 과소대표처럼 문화적으로 민감한 문제도 다룬다. 나치 독일에 인종 평등을 강제하는 것은 모욕적인 역사 수정이지만, 전통적 표현을 복원한다며 역사를 다시 백인 중심으로 만들 위험도 있다.
브리저튼 같은 시대극은 인구통계적 정확성을 의도적으로 흐리고, 미래 학습 데이터에도 영향을 줄 수 있다. 동시에 서구 역사는 부와 백인에 치우쳐 수많은 주변부 이야기를 기록하지 않았다는 점도 고려해야 한다.
방법과 시험
연구진은 생성 모델이 역사 맥락을 해석하는 방식을 시험하기 위해 HistVis를 만들었다. 요리, 기도, 음악 감상 같은 보편적 활동 100개를 17세기부터 오늘날까지 10개 시대에 걸쳐 생성한 3만 장의 이미지로 구성됐다.

Stable Diffusion XL, Stable Diffusion 3, FLUX.1 세 모델을 사용했고, 시대만 변수로 두어 역사적 단서가 어떻게 부호화되거나 무시되는지 비교했다.
시각 양식 지배
프롬프트에 매체나 미학이 없어도 모델은 특정 세기를 특정 양식과 연결했다. 이를 측정하기 위해 VGG16 기반 CNN 분류기를 ImageNet으로 사전학습하고, WikiArt 파생 데이터의 범주별 1,500개 예로 미세조정했다. 이미지를 드로잉, 판화, 일러스트레이션, 회화, 사진의 다섯 범주로 나눴으며, 별도 채도 점수로 흑백 사진을 판별했다.

SDXL은 17·18세기를 주로 판화로, SD3와 FLUX.1은 회화로 표현했다. 20세기에는 SD3가 흑백 사진을 선호했고 SDXL은 현대 일러스트레이션을 자주 만들었다. 프롬프트를 바꿔도 경향이 지속돼, 시대와 양식의 연결이 깊이 학습됐음을 보여줬다.

연구진은 한 시대의 출력에서 가장 흔한 양식이 차지하는 비율을 ‘시각 양식 지배’(VSD)로 정의했다. 높은 점수는 한 양식이 지배함을, 낮은 점수는 다양성을 뜻한다.

17·18세기에는 SDXL의 판화, SD3와 FLUX.1의 회화가 강했고, 20·21세기에는 SD3와 FLUX.1이 사진으로 이동했다. 세 모델 모두 1910·1930·1950년대에 흑백 이미지를 강하게 선호했다.
사실성을 명시하고 흑백을 부정 프롬프트로 넣으면 일부 점수가 낮아지고 지배 양식이 바뀌었지만, 진정한 사실적 이미지는 드물었다. 양식 기본값이 깊이 박혀 있다는 뜻이다.
역사적 일관성
다음 분석은 시대에 맞지 않는 물체를 찾았다. 고정 금지 목록 대신 LLM과 VLM을 사용했다. GPT-4o가 시대와 활동마다 부적절할 물체 목록과 예/아니오 질문을 만들고, 다시 이미지를 살펴 답하게 했다.
예를 들어 ‘18세기에 음악을 듣는 사람’에서는 현대 오디오 기기를 후보로 삼아 “18세기에 존재하지 않은 헤드폰이나 스마트폰을 쓰고 있는가?”라고 묻는다.

표현이 다른 같은 물체를 중복 집계하지 않도록 퍼지 매칭으로 정규화했다. ‘빈도’는 시대·모델별로 물체가 얼마나 자주 나타났는지, ‘심각도’는 후보로 제시된 뒤 실제로 얼마나 일관되게 검출됐는지를 측정했다. 스마트폰이 10번 제안돼 10개 이미지에 나타나면 심각도는 1.0, 5개면 0.5다.

의복은 자주 등장하지만 분산돼 있었고, 오디오 장치와 다림질 도구는 빈도는 낮아도 일관성이 높았다. 모델이 시대보다 프롬프트의 활동에 더 반응한다는 신호다. SD3가 특히 19세기와 1930년대에 시대착오가 가장 많았고, FLUX.1과 SDXL이 뒤를 이었다.
탐지법을 인간 판단과 비교하기 위해 SD3 이미지 1,800장을 세 명씩 평가했다. 신뢰도 필터링 뒤 234명의 2,040개 판단을 사용했고, 자동 방법은 다수결과 72% 일치했다.

인구통계
마지막 분석은 시대별 인종과 성별 표현을 살폈다. HistVis 출력과 GPT-4o가 만든 거친 역사적 기대치를 비교했다. 이 기대치는 정답이 아니라 plausibility를 살피는 기준이다.
10만 장 이상으로 학습한 ResNet34 기반 FairFace 분류기로 성별과 인종을 검출했다. 낮은 신뢰도 결과를 제외하고 시대와 활동별로 평균냈으며, 5,000장에 DeepFace를 추가 적용해 강한 일치를 확인했다.

모델 출력이 언어모델의 기대에서 벗어난 정도를 과소대표와 과대표로 측정했다. FLUX.1은 요리처럼 여성 비중이 높을 것으로 예상되는 장면에서도 남성을 자주 과대표했다. SD3와 SDXL도 일, 교육, 종교에서 비슷했다. 백인 얼굴은 전반적으로 예상보다 많았으나 최근 시대로 갈수록 편향이 줄었다. 일부 범주에서는 비백인 표현이 갑자기 치솟아 역사 맥락보다 데이터셋 상관관계를 반영하는 것으로 보였다.

연구진은 텍스트-이미지 모델이 역사 시대를 미묘하게 이해하기보다 제한된 양식 부호에 의존하며, 각 시대를 하나의 시각 양식에 묶어 일차원적으로 묘사한다고 결론 내렸다. 사실적 인물 표현은 주로 20세기 이후에만 나타났고, 현대 물건이 전근대 장면에 자주 등장해 교육과 문화유산 용도의 신뢰성을 훼손했다.

결론
확산 모델 학습에서 새 개념은 잠재공간의 정해진 칸에 깔끔하게 들어가지 않는다. 등장 빈도와 관련 개념과의 근접성에 따라 군집을 만들며, 경험적 경계보다 전형적 맥락에 따라 느슨하게 조직된다.
따라서 범용 대규모 데이터에서 ‘역사적인 것’을 분리하기 어렵다. 많은 시대는 깊은 역사적 세부보다 그 시대를 기록한 매체의 외형으로 표현된다. 그래서 19세기 인물을 2025년 수준의 사실적 이미지로 만들려 해도 영화와 TV의 시각 관습으로 돌아가기 쉽다. 겹친 개념을 더 잘 분리하는 기술이 발전해야 이 간극을 줄일 수 있다.
2025년 5월 26일 월요일 최초 공개.
출처 및 관련 링크
- https://www.unite.ai/googles-multimodal-ai-gemini-a-technical-deep-dive/
- https://www.theguardian.com/technology/2024/feb/28/google-chief-ai-tools-photo-diversity-offended-users
- https://www.unite.ai/ai-bias-cultural-stereotypes-effects-limitations-mitigation/
- https://www.unite.ai/understanding-diffusion-models-a-deep-dive-into-generative-ai/
- https://archive.is/Sk6pb
- https://archive.is/72T3D
- https://commoncrawl.org/
- https://arxiv.org/pdf/2505.17064
- https://arxiv.org/pdf/2405.01286
- https://www.thenation.com/article/culture/bridgerton-racism-shonda-rhimes/
- https://www.theguardian.com/news/2021/apr/20/the-invention-of-whiteness-long-history-dangerous-idea
- https://arxiv.org/abs/2307.01952
- https://stability.ai/news/stable-diffusion-3
- https://www.unite.ai/a-new-contender-in-the-ai-space-black-forest-labs-and-the-flux-1-image-generator/
- https://www.unite.ai/what-are-convolutional-neural-networks/
- https://www.geeksforgeeks.org/vgg-16-cnn-model/
- https://www.image-net.org/
- https://www.unite.ai/a-full-guide-to-fine-tuning-large-language-models/
- https://www.kaggle.com/datasets/steubk/wikiart
- https://infoscience.epfl.ch/server/api/core/bitstreams/77f5adab-e825-4995-92db-c9ff4cd8bf5a/content
- https://www.unite.ai/what-is-prompt-engineering-in-ai-why-it-matters/
- https://github.com/seatgeek/fuzzywuzzy
- https://arxiv.org/abs/1908.04913
- http://pytorch.org/vision/main/models/generated/torchvision.models.resnet34.html
- https://www.cs.toronto.edu/~ranzato/publications/taigman_cvpr14.pdf


