
Anderson의 관점
GAN을 통한 전통적인 CGI 얼굴 렌더링

 Unite.AI를 Google의 선호 소스에 추가

핵심 포인트GAN 잠재 공간에서 정체성과 표현을 분리하는 것은 얼굴 비디오 합성의 핵심 미해결 과제로 남아 있다.
더 보기
- GAN 잠재 공간에서 정체성과 표현을 분리하는 것은 얼굴 비디오 합성의 핵심 미해결 과제로 남아 있다.
- SMPL 및 3DMM과 같은 파라메트릭 CGI 모델은 GAN의 통제 불가능한 잠재 코드에 질서를 부여하기 위해 점점 더 많이 사용되고 있다.
- 디즈니의 Rendering with Style 하이브리드 접근법은 전통적인 텍스처 맵과 GAN 생성 이미지를 병합하여 섬뜩한 결과를 만들어냈다.
의견 생성적 적대 신경망(GAN)이 처음으로 놀랍도록 사실적인 3D 얼굴을 만들어 낼 수 있음을 보여 주자, 사람의 얼굴이 등장하는 시간적으로 일관된 영상을 만드는 미개척 잠재력에 연구가 몰렸다.
GAN의 잠재 공간 어딘가에는 숨은 질서와 합리성이 있어야 할 듯했다. 잠재 코드에 담긴 초기 의미 논리가 동일한 얼굴을 여러 시점과 표현, 가령 표정 변화에 걸쳐 일관되게 생성하도록 해 준다면, 시간적으로 설득력 있는 딥페이크 영상 기법을 제공해 오토인코더를 크게 능가할 수 있을 것이었다.
GPU 제약 때문에 DeepFaceLab과 FaceSwap이 작동해야 하는 저해상도 환경에 비하면 고해상도 출력은 쉬운 일이 될 것이었다. 오토인코더 작업 흐름의 얼굴 교체 영역은 소수의 입력 이미지, 심지어 한 장만으로 이끄는 GAN의 생성 영역으로 바뀔 수 있었다.
교체 얼굴과 바탕 얼굴 사이의 불일치도 사라질 것이었다. 전체 이미지를 처음부터 만들기 때문이다. 여기에는 전통적인 오토인코더 딥페이크에서 어려운 머리카락, 턱선, 얼굴 윤곽의 바깥 가장자리도 포함된다.
GAN 얼굴 영상의 겨울
그러나 일이 그렇게 쉽지는 않았다. 결국 요인 분리가 핵심 문제로 드러났고 지금도 가장 큰 과제다. 오토인코더가 힘들게 하듯 수천 장의 참조 이미지를 모아 변화의 결과를 신경망에 가르치지 않고, 어떻게 한 사람의 얼굴 정체성을 유지하면서 자세나 표정을 바꿀 수 있을까?
이후 GAN 얼굴 재현과 합성 연구는 입력 정체성에 개인별 특성에 국한되지 않은 목적 지향적이고 일반적인 템플릿 기반 변환을 적용하는 방향을 생각했다. 예컨대 GAN이 아는 그 사람의 어떤 사진에도 없는 표정을 GAN 얼굴에 적용하는 것이다.

2022년 논문 Tensor-based Emotion Editing in the StyleGAN Latent Space는 FFHQ 데이터셋의 입력 얼굴에 템플릿 기반 표정을 적용한다. 출처: https://arxiv.org/pdf/2205.06102.pdf
획일적인 접근이 개인마다 고유한 얼굴 표정의 다양성을 담을 수 없다는 점은 분명하다. 잭 니컬슨이나 윌럼 더포처럼 독특한 미소를 평균 표정 잠재 코드로 충실하게 재현할 수 있을지 의문이다.

이 매력적인 라틴계 낯선 사람은 누구인가? GAN은 더 사실적이고 해상도가 높은 얼굴을 만들지만, 배우의 실제 사진 수천 장을 폭넓게 학습하는 DeepFaceLab과 달리 변환이 여러 실제 사진에 근거하지 않는다. 따라서 닮은 정도가 떨어진다. 배경에서는 DeepFaceLab 모델을 인기와 논란을 함께 얻은 소프트웨어의 스트리밍 구현인 DeepFaceLive로 가져온다. 예시는 https://www.youtube.com/watch?v=9tr35y-yQRY (2022) 및 https://arxiv.org/pdf/2205.06102.pdf에서 가져왔다.
최근 몇 년간 여러 GAN 표정 편집기가 제안되었다. 대부분 익숙하지 않은 인물을 다루므로, 독자는 원래 얼굴을 알지 못해 변환의 충실도를 판단하기 어렵다.

2020년 Cascade-EF-GAN으로 변환한 익숙하지 않은 인물들. 출처: https://arxiv.org/pdf/2003.05905.pdf
지난 3년 동안 가장 큰 관심과 인용을 얻은 GAN 얼굴 편집기는 아마 InterFaceGAN일 것이다. 카메라나 얼굴 각도에 해당하는 자세, 표정, 나이, 인종, 성별과 그 밖의 중요한 속성에 연결된 코드를 따라 잠재 공간을 탐색할 수 있다.
InterFaceGAN과 비슷한 프레임워크의 1980년대식 모핑은 나이 같은 적절한 잠재 코드를 통해 이미지를 역투영하면서 변환 경로를 보여 준다. 하지만 시간적으로 연속적인 영상을 만드는 관점에서 이런 방법은 지금까지 인상적인 재앙에 해당한다.
여기에 시간적으로 일관된 머리카락을 만드는 어려움을 더하면 GAN만으로 얼굴 영상 합성에 필요한 모든 것™을 얻기는 어렵다고 볼 수 있다. 잠재 코드 탐색과 조작에는 내장된 시간적 지침이 없다. 정지 영상을 생성하도록 설계되어 원래 영상 출력 기능이 없는 프레임워크에 그런 지침을 어떻게 넣을지도 불분명하다.
후속 연구는 요인 분리에 점진적인 개선을 가져왔다. 다른 연구들은 컴퓨터 비전 기법을 안내 계층으로 더했다. 예를 들어 2021년 말 논문 SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing은 의미론적 분할을 제어 수단으로 사용했다.
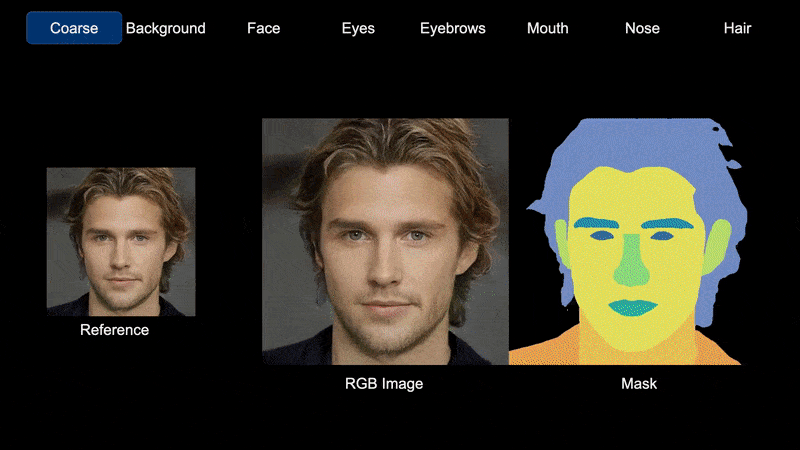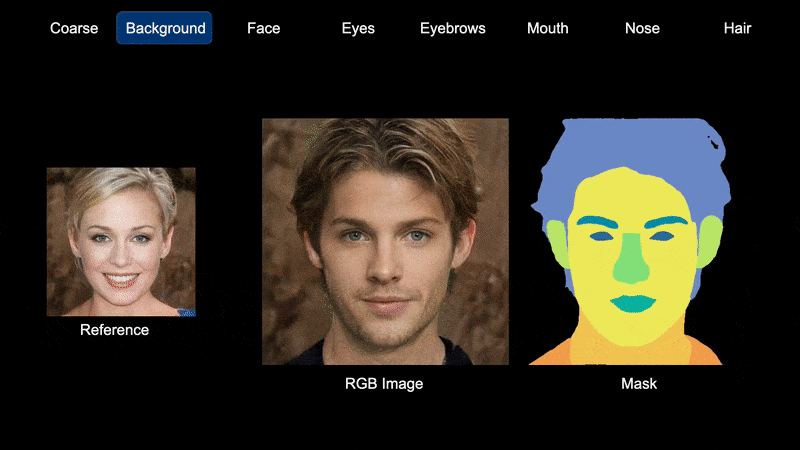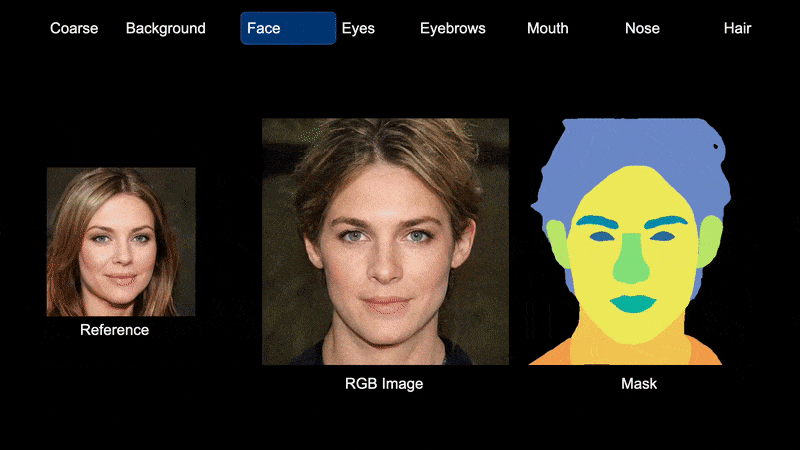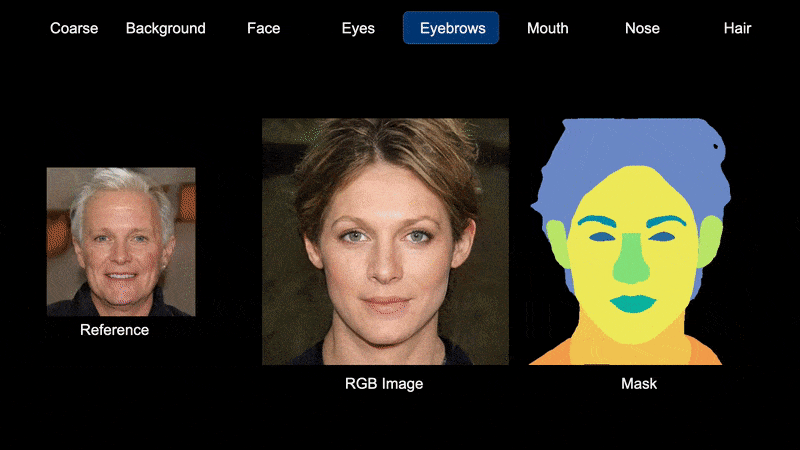
SemanticStyleGAN에서 잠재 공간을 제어하는 수단으로 쓰이는 의미론적 분할. 출처: https://semanticstylegan.github.io/
매개변수 기반 안내
GAN 얼굴 합성 연구는 인상적이지만 제어하기 어려운 잠재 코드에 질서를 부여하기 위해 전통적인 매개변수 기반 CGI 얼굴을 점점 더 활용하고 있다.
매개변수 기반 얼굴 기본 요소는 컴퓨터 비전 연구에서 20년 넘게 사용되었다. 최근 Skinned Multi-Person Linear Model(SMPL) CGI 요소의 활용이 늘면서 관심도 커졌다. 막스 플랑크 연구소와 ILM이 개척한 이 접근은 이후 Sparse Trained Articulated Human Body Regressor(STAR) 프레임워크로 개선되었다.

SMPL의 변형인 SMPL-X는 이미지에 나타난 인체 전체의 추정 자세에, 필요하면 표정까지 맞는 매개변수 기반 CGI 메시를 적용할 수 있다. 이 메시는 새로운 이미지 연산을 위한 체적 또는 지각적 지침으로 활용된다. 출처: https://arxiv.org/pdf/1904.05866.pdf
이 방향에서 가장 주목받은 발전은 디즈니의 2019년 Rendering with Style 프로젝트였다. 전통적인 텍스처 맵과 GAN 이미지를 결합해 더 나은 딥페이크 스타일 애니메이션을 만들고자 했다.

디즈니의 GAN 딥페이크 혼합 접근에서 만나는 기존 기술과 신기술. 출처: https://www.youtube.com/watch?v=TwpLqTmvqVk
디즈니는 전통적인 방식으로 렌더링한 CGI 요소를 StyleGAN2에 넣어 얼굴의 문제 영역을 채운다. 피부 질감처럼 영상 생성에서 시간적 일관성이 어려운 영역이 여기에 해당한다.

Rendering with Style 작업 흐름.
이 과정을 이끄는 매개변수 기반 CGI 머리는 사용자에 맞춰 조절할 수 있으므로, GAN 얼굴도 머리 자세와 표정 등 그 변화를 반영할 수 있다.
CGI의 제어 가능성과 GAN 얼굴의 자연스러운 사실감을 결합하려 했지만, 결과는 두 방식의 단점을 드러낸다. 머리카락 질감뿐 아니라 기본 얼굴 특징의 위치도 일관되게 유지하지 못한다.
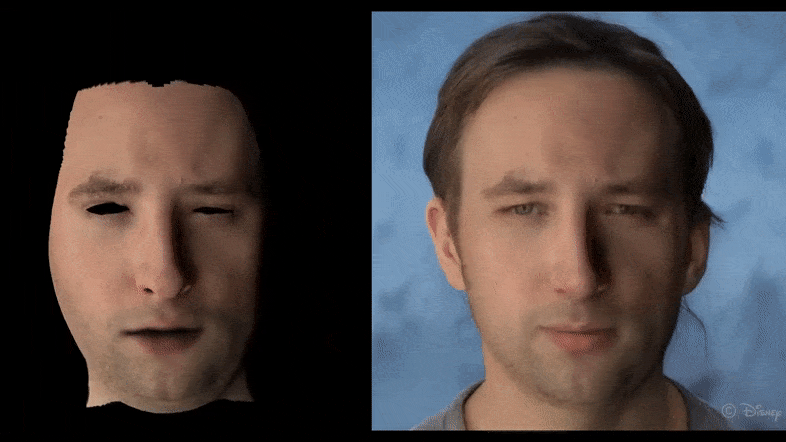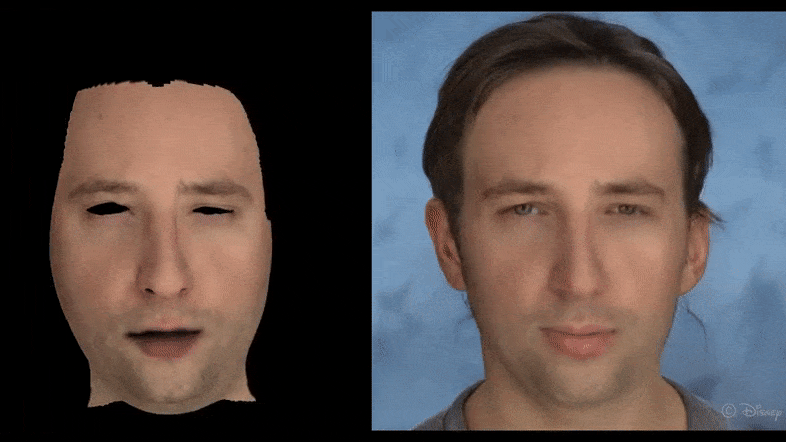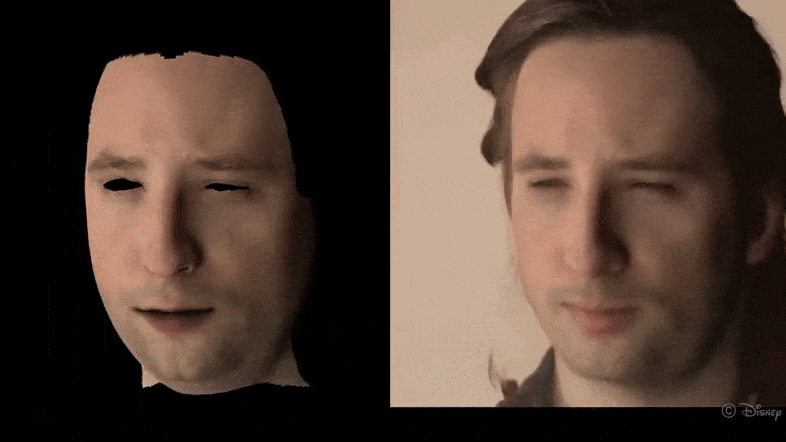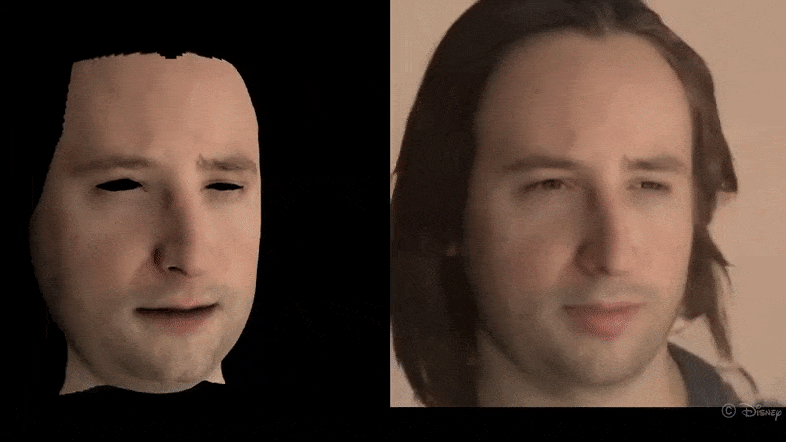
Rendering with Style에서 새로운 형태의 불쾌한 골짜기가 나타난다. 다만 원리에는 여전히 잠재력이 있다.
2020년 논문 StyleRig: Rigging StyleGAN for 3D Control over Portrait Images는 점점 널리 쓰이는 방법을 따른다. 3차원 변형 가능 얼굴 모델(3DMM)을 중간 매개로 사용해 StyleGAN의 특성을 바꾸며, 여기서는 RigNet이라는 새로운 리깅 네트워크가 이를 수행한다.

StyleRig의 잠재 공간 해석을 매개하는 3DMM. 출처: https://arxiv.org/pdf/2004.00121.pdf
그러나 이런 시도에서 흔히 그렇듯, 지금까지의 결과는 작은 자세 변화와 개인의 특성을 충분히 반영하지 않은 표정 및 정서 변화로 제한된다.

StyleRig는 제어 수준을 높이지만 시간적으로 일관된 머리카락은 여전히 해결되지 않은 문제다. 출처: https://www.youtube.com/watch?v=eaW_P85wQ9k
미쓰비시 리서치의 MOST-GAN도 비슷한 결과를 보인다. 2021년 논문은 비선형 3DMM을 요인 분리 구조로 사용하지만, 역동적이고 일관된 움직임을 얻는 데도 어려움을 겪는다.
제어와 요인 분리를 함께 시도하는 최신 연구는 One-Shot Face Reenactment on Megapixels로, 여기서도 매개변수 기반 3DMM 머리를 StyleGAN의 편리한 인터페이스로 활용한다.

One-Shot Face Reenactment의 MegaFR 흐름에서 신경망은 잠재 표현으로 역변환한 실제 이미지와 렌더링된 3DMM 모델의 매개변수를 결합해 얼굴을 합성한다. 출처: https://arxiv.org/pdf/2205.13368.pdf
OSFR는 Photoshop이나 After Effects 같은 선형 편집 흐름을 만들려는 GAN 얼굴 편집기 계열에 속한다. 사용자는 정체성에 해당하는 잠재 코드를 공간에서 찾아다니는 대신 원하는 이미지를 입력하고 변환을 적용할 수 있다.
하지만 매개변수 기반 표정은 여전히 포괄적이고 개인화되지 않은 표정 주입 방식이다. 따라서 결과가 나름의 방식으로 기묘하게 느껴지며, 항상 긍정적인 효과를 주지는 않는다.

OSFR에 주입된 표정.
이전 연구처럼 OSFR는 한 장의 이미지에서 원래에 가까운 자세를 추론하고, 비스듬한 얼굴을 정면 인물 사진으로 바꾸는 정면화도 수행할 수 있다.

새 논문에 설명된 OSFR 구현의 원본 이미지(위)와 추론된 정면 인물 사진.
이런 추론은 신경 방사장(NeRF)의 바탕이 되는 일부 사진측량 원리와 비슷하다. 다만 여기서는 한 장의 사진으로 기하 구조를 정해야 한다. NeRF는 3~4개 시점을 사용해 빠진 중간 자세를 추론하고 사람이 등장하는 탐색 가능한 신경망 3D 장면을 만든다.
(하지만 NeRF도 필요한 모든 것™은 아니다. 얼굴 영상 합성에서 마주하는 장애물은 GAN과 거의 완전히 다르다.)
GAN은 얼굴 영상 합성에 자리가 있을까?
한 장의 원본 이미지에서 역동적인 표정과 학습 분포 밖의 자세를 얻으려는 노력은 현재 GAN 얼굴 합성 연구의 연금술적 집착처럼 보인다. GAN이 지금으로서는 꽤 높은 해상도와 상대적으로 높은 충실도의 신경망 얼굴을 만들 수 있는 유일한 방식이기 때문이다. 오토인코더 딥페이크는 여러 실제 자세와 표정으로 학습할 수 있지만, 입출력 해상도가 VRAM에 제한되고 바탕 이미지가 필요하다. NeRF 역시 제한되며, 다른 두 방식과 달리 아직 얼굴 표정을 바꾸는 정립된 방법이 없고 전반적인 편집 가능성도 낮다.
정확한 CGI/GAN 얼굴 합성을 위해서는 여러 사진으로 구성된 정체성 개체를 잠재 공간에 조립하는 새로운 방법이 필요해 보인다. 그러면 한 사람의 정체성 코드는 관련 없는 자세 매개변수를 찾으러 잠재 공간 전체를 이동하는 대신, 그 사람의 관련 실제 사진을 변환의 참조로 사용할 수 있다.
그런 경우에도, 또는 오토인코더처럼 한 사람의 얼굴 이미지 집합으로 전체 StyleGAN을 학습해도, 부족한 의미 논리는 의미론적 분할이나 매개변수 기반 3DMM 얼굴 같은 보조 기술이 제공해야 할 가능성이 높다. 적어도 이 경우에는 활용할 자료가 더 많아질 것이다.


