
Anderson의 관점
기계 학습 시스템을 사용하여 읽는 동안 기사를 다시 작성하는 방법

 Unite.AI를 Google의 선호 소스에 추가
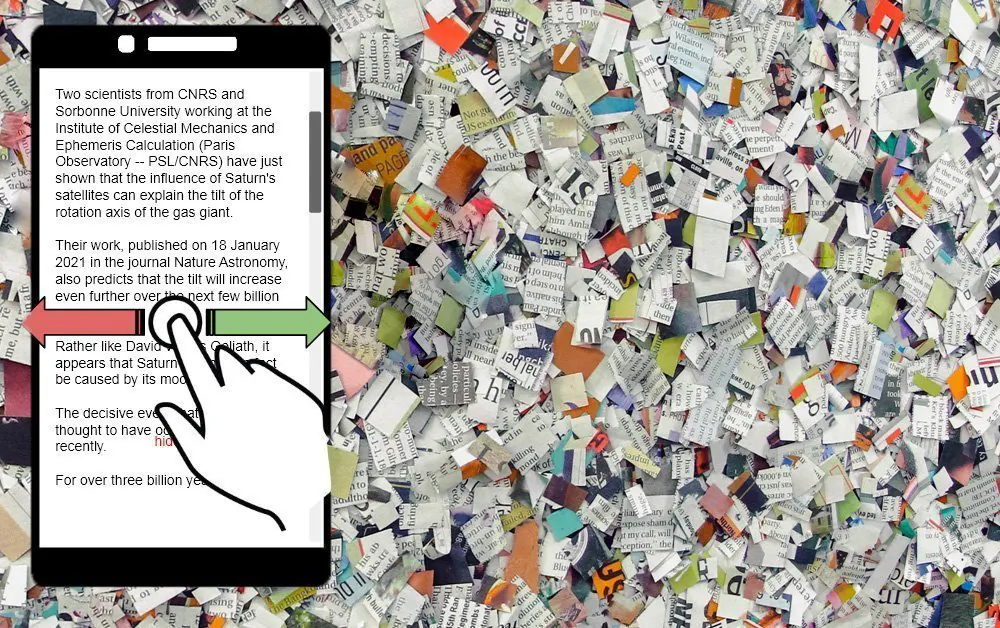
캐나다의 새로운 연구는 Tinder 스타일의 ‘스와이프’ 또는 기사의 다양한 종류의 콘텐츠와의 상호 작용을 수동으로 관찰하여 기사를 자동으로 다시 작성하는 방법을 제안합니다.
시스템, Hone As You Read (HARE)는 캐나다 온타리오 주 웨스턴 대학교의 논문에서 제시되며, 해당 Python 코드는 GitHub에서 확인할 수 있습니다.
프로젝트의 핵심 아이디어는 기사에 다양한 종류의 콘텐츠가 포함되어 있으며, 헤드라인에서부터 세부 사항까지 발전할 수 있다는 것입니다. 기사의 후반부에는 다른 종류의 지원 자료, 사용 사례 또는 가설 또는 추측이 포함될 수 있습니다.
HARE에서 해당 종류의 자료를 싫어한다면, 시스템이 사용자의 선호도를 학습하면서 단락별로 투표할 수 있습니다. 따라서 사용자가 스크롤을 내리면, ‘다운보팅’한 자료와 유사한 콘텐츠가 이미 제거되거나 다시 작성되어 있습니다. 사용자가 시스템을 교육하는 데 적극적으로 참여하지 않으려면, HARE는 문서와의 수동 상호 작용을 관찰하여 사용자의 선택을 추론할 수 있습니다.
기사에서 불쾌한 문장에 대한 Tinder 스타일 투표
아래 이미지는 사용자의 명시적 또는 암시적 행동에 따라 HARE를 위한 세 가지 가능한 유형의 추론 분류를 보여줍니다. 첫 번째 경우(왼쪽), 사용자는 Tinder 스타일의 제스처로 문장 또는 단락의 콘텐츠, 스타일, 복잡성 또는 음성에 대한 승인 또는 불쾌를 표현합니다.

출처: https://arxiv.org/pdf/2105.02923.pdf
두 번째 경우(중앙), 시스템은 사용자의 관심을 측정하기 위한 지표로停留 시간을 사용합니다.
세 번째 경우(오른쪽), HARE는 스마트폰 카메라를 사용하여 문서의 단락에 대한 사용자의 시선 경로와停留 시간을 추정합니다.
연구자들은 특정 단락에 대한停留 시간이 증가하면 사용자의 관심도 증가할 수 있다고 주장합니다. 그러나 논리적으로 복잡하거나 잘못 작성된 텍스트를 이해하려고 하는 경우에는 그렇지 않을 수 있습니다.

사용자 피드백은 아직 보이지 않는 기사의 일부를 편집, 다시 작성 또는 삭제합니다.
사용자의 선호도에 따라 콘텐츠를 사전 처리
이 논문은 HARE의 사용자 경험을 기사별로 다룹니다. 그러나 사용자의 문서와의 역사적인 상호 작용은 미래의 읽기 경험을 사용자 지정할 수 있도록 허용합니다. 즉, 사용자는 일관된 방식으로 콘텐츠 유형을 인식하고 새 기사에 템플릿화된 사용자 선호도를 적용하여 상호 작용의 필요성이 줄어듭니다.
HARE는 요약 알고리즘으로서, 사용자가 도착하기 전에 스타일 또는 간결성으로 다시 작성된 콘텐츠를 포함하는 요약기를 허용합니다. 그러나 논문은 사용자 피드백에 따라 콘텐츠를 사전 제거할 수도 있음을 명확히 합니다.
테스트 목적으로 시스템은 코퍼스를 사용하여 11,222개의 기사를 사용했습니다. 또한 Telegram 채팅 앱에서 테스트 배포를 통해 평가했습니다. 10단락 미만의 기사는 테스트 목적으로 폐기되었습니다.

사용자와 함께 테스트 단계의 Telegram HARE 앱.
연구자들의 방법론은 K-Means 클러스터링을 사용하여 SBERT 문장 임베딩을 적용합니다. 초기에는 무작위로 설정된 가중치를 사용합니다.
다양한 알고리즘과 접근 방식 중에서 HARE는 세 가지 비교 모델을 특징으로 합니다. 첫 번째 모델(ORACLEGREEDY)은 이전 사용자 선호도에 접근할 수 있으며, 이는 알고리즘이 상호 작용적으로 아닌 로드 시에 기사를 사전 처리할 수 있음을 나타냅니다.
다른 모델인 ORACLESORTED와 ORACLEUNIFORM는 각각 관심도 수준 또는 무작위로 기사 전체에서 문장을 선택합니다.
콘텐츠 제거 및 다시 작성
놀랍게도, ORACLEUNIFORM은 제어 집합을 능가했음에도 불구하고 이전 사용자 관심에 대한 접근 권한이 없습니다. 연구자들은 이것이 전체 기사를 한 번에 다루기 때문이라고 주장합니다. ‘가장 흥미로운 문장만을 선택’합니다. 연구자들은 이것이 가장 중요한 개념만 다루는 문장으로 콘텐츠를 제한할 수 있으며, 논리적으로 다른 텍스트를 제거할 수 있음을 인정합니다.
HARE에서 사용되는 추출적 요약기는 LexRank, SumBasic, 및 TextRank입니다.
HARE는 13명의 자원봉사자와 70번의 시도 및 다양한 알고리즘 접근 방식을 통해 테스트되었습니다. 또한 소비자급 랩톱에서 1.3밀리초에서 100ms 사이에서 요약(다시 작성된/삭제된 텍스트)을 업데이트할 수 있었습니다. 결과는 가장 많은 텍스트를 제거한 모델이 잘 수행되지 않았으며, 이는 남은 텍스트의 일관성을 영향을 미칠 수 있음을 보여주었습니다.
동적 기사 다시 작성의 윤리적 영향
연구자들은 이러한 기술에 대한 윤리적 우려를 인정합니다:
‘HARE 태스크는 미래의 사용자용 응용 프로그램을 설계하기 위한 것입니다. 설계에 따라 이러한 응용 프로그램은 주어진 기사에서 사용자가 읽을 수 있는 콘텐츠를 제어할 수 있습니다. 이러한 도구가 충분한 주의 없이 배포될 경우, 자동화된 뉴스 피드, 검색 결과 및 온라인 커뮤니티에서 이미 생성된 “에코 체임버” 효과를 악화시킬 수 있습니다.’
그러나他們也指出, 이러한 시스템은 미래의 응용 프로그램에서 대체 관점을 제안하는 텍스트를 주입하여 에코 체임버 효과를 완화하는 데 사용될 수 있습니다. 그들은 다음과 같이 관찰합니다. ‘이 요인의 가중치는 흥미로운 읽기 경험과 아이디어의 다양성을 제공하도록 조정될 수 있습니다.’
연구자들은 이러한 시스템으로부터 이익을 얻을 수 있는 사용자는 정보를 수신하는 데 시간을 절약하고자 하는 독자와 콘텐츠 발행자라고 주장합니다.


