
Interviste
Zaid Al Hamani, Amministratore Delegato e Fondatore di Boost Security – Serie di Interviste

 Aggiungi Unite.AI alle tue fonti preferite su Google
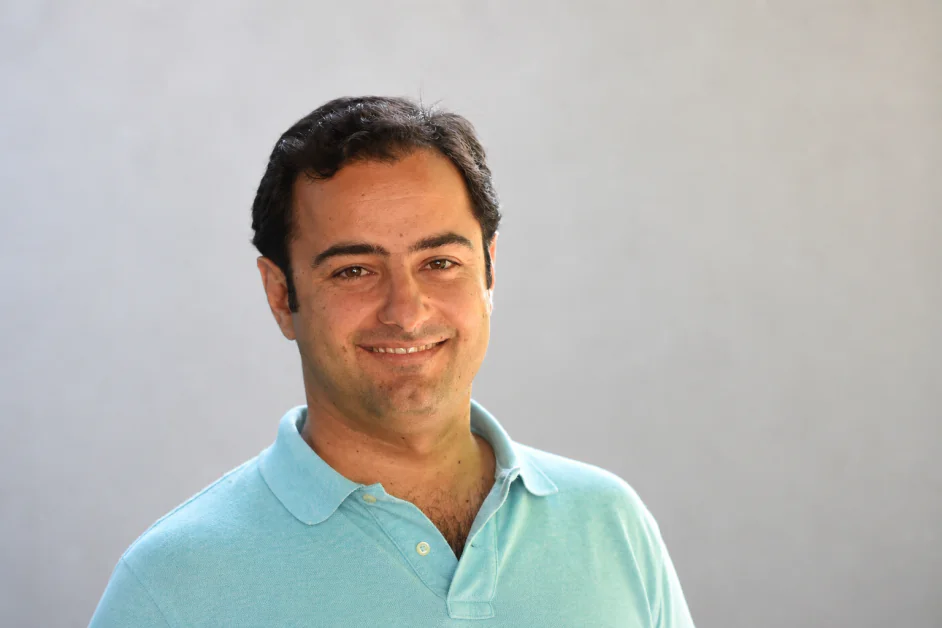
Zaid Al Hamani, Amministratore Delegato e Fondatore di Boost Security, è un leader nel settore della sicurezza informatica e del DevSecOps con oltre due decenni di esperienza nella costruzione e gestione di operazioni tecnologiche globali. Dal momento della fondazione di Boost Security nel 2020, si è concentrato sulla modernizzazione di come le organizzazioni proteggono lo sviluppo del software, attingendo a ruoli precedenti tra cui VP della sicurezza delle applicazioni in Trend Micro e Co-Fondatore/Amministratore Delegato di IMMUNIO. In precedenza, ha ricoperto posizioni di leadership senior in Canonical, guidando iniziative di prodotto, ingegneria e supporto globale, e in SITA, dove ha gestito operazioni IT su larga scala e critiche per la missione. La sua carriera riflette una solida esperienza nel costruire team, ottimizzare sistemi e promuovere pratiche di sicurezza moderne.
Boost Security è un’azienda di sicurezza informatica che si concentra sulla protezione della moderna catena di approvvigionamento del software attraverso una piattaforma DevSecOps orientata agli sviluppatori. La sua tecnologia si integra direttamente nei pipeline CI/CD per rilevare, prioritizzare e risolvere automaticamente le vulnerabilità, riducendo il carico di lavoro manuale e mantenendo la velocità di sviluppo. Unificando la sicurezza delle applicazioni e della catena di approvvigionamento in un unico sistema, la piattaforma fornisce una visibilità completa su codice, dipendenze e infrastrutture, aiutando le organizzazioni a rafforzare la resilienza in ambienti cloud-native complessi.
Ha guidato in precedenza la sicurezza delle applicazioni in Trend Micro e ha co-fondato IMMUNIO. Cosa l’ha portato a fondare Boost Security e quale lacuna nel mercato era in grado di identificare per primo?
IMMUN.IO era una delle prime aziende RASP a essere fondata – e la nostra esperienza fino a quel punto era che i WAF come tecnologia di sicurezza runtime erano impossibili da mantenere e non molto efficaci. Avevamo immaginato un modo in cui i WAF sarebbero stati sostituiti con una soluzione più precisa e più facile da mantenere – strumentando l’applicazione.
Era il 2012, DevOps era ancora agli inizi, la maggior parte dei team non era ancora Agile e Kubernetes non era ancora una cosa.
Trend Micro ha acquisito IMMUN.IO nel 2017. A quel punto, c’erano molte più pratiche DevOps: pipeline CI/CD, pratiche di sviluppo Agile, cicli di rilascio più rapidi, cloud, ecc. I team di sviluppo del software erano migliori nel costruire software e nel consegnarlo più velocemente. La sicurezza, tuttavia, era ancora rotta:
- Le scansioni sono troppo lente o i risultati arrivano troppo tardi
- I risultati sono troppo complessi per gli sviluppatori da mettere in atto
- C’era un tasso di falsi positivi generalmente inaccettabile
- Molti nuovi tipi di artifact non venivano scansionati: codice infrastrutturale, contenitori, API, ad esempio
Produrre software velocemente era più facile. Produrre software sicuro velocemente era ancora difficile.
Quello era il problema originale che ci siamo posti come obiettivo di risolvere. Fare in modo che DevSecOps funzioni nel mondo reale; è possibile far sì che un team di sviluppo del software aggiunga facilmente la sicurezza nel ciclo di vita di sviluppo, alla velocità necessaria per gli standard di velocità attuali? È possibile rendere la copertura ampia – dove una piattaforma è tutto ciò di cui hai bisogno? È possibile far sì che gli sviluppatori non solo adottino la tecnologia, ma la amino e vedano i benefici? È possibile farla scalare in modo che non sia necessario avere eserciti di professionisti della sicurezza per tenere il passo con la quantità di codice scritto…
Abbiamo aiutato le aziende a iniettare la sicurezza nel ciclo di vita di sviluppo durante l’era DevOps. Quello era passare da 1 a 10. Ora siamo nell’era della codifica agente – dove gli agenti scrivono una quantità enorme di codice – ma è fondamentalmente lo stesso problema – velocità e volume di codice sono passati da 10 a 100; e ci proponiamo di continuare la stessa traiettoria.
Ha sostenuto che il ciclo di vita di sviluppo del software (SDLC) ha fondamentalmente spostato l’attenzione a monte. Qual è stato il momento in cui ha realizzato che gli approcci tradizionali di DevSecOps non erano più sufficienti?
È stato osservare come gli attaccanti stavano effettivamente penetrando. Continuavamo a vedere lo stesso modello: un flusso di lavoro di GitHub Actions esposto che nessuno aveva revisionato dal momento in cui il repository era stato forkato, un token con accesso cloud di produzione incorporato in una configurazione del runner, un lavoro CI legittimo sequestrato per distribuire payload di attaccanti. Questi sono diventati noti come attacchi “living off the pipeline” perché l’avversario utilizza la propria automazione contro di te, con credenziali che il team di sicurezza aveva già approvato.
Lo stack di DevSecOps che avevamo costruito nel corso di un decennio non aveva risposta per quello. SAST scansiona il codice sorgente dell’applicazione. SCA scansiona le dipendenze dell’applicazione. Entrambi suppongono che la pipeline in esecuzione sia attendibile. Nel frattempo, la pipeline stessa è un file YAML con comandi shell, accesso alla rete e credenziali sensibili, e quasi nessuno la revisiona.
Quando diventa il percorso più facile, puoi spedire codice perfettamente pulito e comunque consegnare agli attaccanti il tuo cloud.
Come dovrebbero le aziende ripensare il ciclo di vita di sviluppo del software in un mondo in cui gli agenti di intelligenza artificiale generano codice in modo continuo invece di farlo gli sviluppatori passo dopo passo?
Dobbiamo tutti smettere di pensare al ciclo di vita di sviluppo del software come a una sequenza di punti di controllo. Gli agenti di intelligenza artificiale hanno compresso il tempo tra “qualcuno ha scritto questo” e “questo è in produzione” da settimane a minuti. Il vecchio modello presumeva un ritmo umano tra la revisione del codice, SAST, SCA e deploy, ma siamo oltre questo punto.
La sicurezza deve vivere dove opera l’agente: sulla macchina dello sviluppatore, all’interno del contesto della prompt, nelle connessioni dell’agente ai server MCP e ai modelli esterni. Prima che il codice raggiunga la pipeline, avete già perso l’opportunità di plasmarlo. L’agente ha già estratto la dipendenza. Il modello ha già visto la credenziale. Spostare i controlli a monte, dove effettivamente si svolge il lavoro.
Molte organizzazioni trattano ancora gli strumenti di codifica dell’intelligenza artificiale come semplici strati di produttività. Perché ritiene che rappresentino una nuova superficie di attacco piuttosto che solo un’estensione dei flussi di lavoro esistenti?
Trattare uno strumento di codifica dell’intelligenza artificiale come uno strato di produttività è come trattare un giovane sviluppatore con accesso root come uno strato di produttività. L’etichetta è tecnicamente accurata, ma non fornisce alcun quadro utile per pensare a cosa potrebbe andare storto.
Un agente di codifica legge il filesystem, raschia le variabili d’ambiente per il contesto, recupera dipendenze da registri pubblici, apre connessioni in uscita a provider di modelli remoti e server MCP, ed esegue comandi shell. Ognuna di queste azioni richiedeva in precedenza un intervento umano. Ora accadono in millisecondi, con gli stessi privilegi dello sviluppatore che ha lanciato l’agente.
Quella compressione fonde i confini di fiducia che erano separati: l’autorità dello sviluppatore, ciò che uno strumento esterno può recuperare e ciò che il codice non attendibile può eseguire. Ciò crea nuove opportunità per gli attaccanti e punti ciechi che i difensori non possono nemmeno vedere, tanto meno difendere.
Boost inquadra il laptop dello sviluppatore come il nuovo piano di controllo. Quali rischi esistono nel punto di terminazione che i team di sicurezza stanno attualmente trascurando?
Il più grande è l’inventario. La maggior parte dei team di sicurezza non può dire quali agenti di intelligenza artificiale sono in esecuzione su quali laptop, a quali server MCP quegli agenti sono connessi o quali estensioni IDE stanno raschiando il contenuto del repository in questo momento. EDR non ha visibilità nel livello dell’agente; SIEM non può vedere cosa fanno quegli agenti a livello locale.
Sotto di esso si trova il pasticcio delle credenziali. Abbiamo costruito uno strumento open-source chiamato Bagel in parte per rendere questo concreto. Un laptop dello sviluppatore tipico contiene token GitHub con accesso in scrittura ai repository di produzione, credenziali cloud che possono avviare infrastrutture, token npm o PyPI che possono pubblicare per milioni di utenti e chiavi del servizio di intelligenza artificiale che gli attaccanti rivendono. Nessuna di queste è protetta nel modo in cui un runner CI è protetto. La stessa macchina che detiene quelle credenziali naviga anche nel web e installa estensioni casuali di VS Code.
Accoppiare i due e si ha la superficie di attacco reale. Un’estensione non attendibile in esecuzione con privilegi di sviluppatore in un ambiente pieno di chiavi cloud è il bersaglio con il più alto guadagno nell’impresa moderna. La maggior parte dei team non ha ancora iniziato a guardare.
Ha evidenziato la “trappola del contesto”, dove gli agenti di intelligenza artificiale possono accedere a file locali, variabili d’ambiente e configurazioni. Quanto è diffuso il rischio di perdita di dati sensibili attraverso le prompt e perché è così difficile da rilevare?
Sufficientemente diffuso da considerarlo lo stato predefinito di qualsiasi ambiente di sviluppatore non gestito. Ogni agente di codifica che abbiamo ispezionato recupera il contesto locale in modo aggressivo. Leggono i file dot, le variabili d’ambiente, i file recenti, a volte interi alberi di directory, e inviano quel contesto a un modello remoto. Gli strumenti sono progettati per funzionare in questo modo; il recupero del contesto aggressivo è ciò che li rende utili.
Il problema di rilevamento inizia perché il traffico da una perdita appare identico all’utilizzo normale del prodotto. È TLS per api.openai.com o api.anthropic.com. Proviene da un’applicazione aziendale approvata. Il DLP standard vede uno sviluppatore che utilizza lo strumento di intelligenza artificiale per cui l’azienda ha appena acquistato una licenza. Non vede che una delle stringhe in quella prompt è una chiave segreta AWS che l’agente ha recuperato da un file .env dimenticato in una directory fratello.
Lo si coglie solo ispezionando le prompt prima che lascino il laptop, che è esattamente dove quasi nessuno stack di sicurezza è attualmente posizionato.
Ha menzionato gli attacchi alla catena di approvvigionamento a velocità di macchina. Può guidarci attraverso uno scenario realistico in cui un agente di intelligenza artificiale introduce una vulnerabilità più velocemente di quanto gli strumenti di sicurezza tradizionali possano identificarla?
Ecco uno che abbiamo visto variazioni ripetute. Uno sviluppatore chiede a un agente di aggiungere una funzionalità che necessita di una libreria di retry HTTP. L’agente suggerisce un nome di pacchetto. Il pacchetto ha un nome plausibile ma non esiste effettivamente su npm. Entro un’ora, un attaccante lo registra, lo popola con logica di retry funzionante più uno script di post-installazione che legge ~/.aws/credentials e pubblica il contenuto su un webhook. L’agente esegue npm install senza controllare, perché gli agenti non controllano la reputazione. La credenziale è già stata compromessa prima che lo sviluppatore esegua anche il codice.
L’attacco in sé non è tecnicamente sofisticato, ma la sicurezza della catena di approvvigionamento tradizionale è costruita intorno a vulnerabilità note in pacchetti noti: CVE, SBOM, analisi delle licenze. Quel framework non ha nulla da dire su un pacchetto che non esisteva quando è stata eseguita l’ultima scansione, è stato creato specificamente per corrispondere a un’allucinazione dell’intelligenza artificiale e viene ingestito prima che eventuali aggiornamenti dei feed di minaccia.
La finestra da pubblicazione a compromissione è ora misurata in minuti. Qualsiasi controllo eseguito dopo il fatto è troppo tardi.
Stanno diventando le dipendenze allucinate una delle maggiori minacce nello sviluppo guidato dall’intelligenza artificiale e quali passi pratici possono intraprendere le organizzazioni per difendersi?
Lo sono già. Gli attaccanti monitorano attivamente gli strumenti di intelligenza artificiale popolari per allucinazioni e registrano i nomi dei pacchetti suggeriti entro pochi minuti. I ricercatori, alcuni anni fa, quando è iniziato, lo chiamavano slopsquatting e il nome è rimasto. Una volta che un nome di dipendenza viene allucinato frequentemente, sedersi su di esso è un attacco alla catena di approvvigionamento passivo con sforzo quasi zero.
Le difese pratiche appaiono diverse da quelle che la maggior parte dei team attualmente ha. Inizia con l’ingestione. Blocca pacchetti typosquattati e di recente registrazione al momento dell’esecuzione di npm install o pip install, sulla macchina dello sviluppatore, prima che qualcosa colpisca il disco. La rilevazione post-mortem in CI non aiuta quando uno script di post-installazione ha già esfiltrato una credenziale. Quindi fornisce all’agente delle barriere operative all’interno. Inietta l’elenco delle dipendenze approvate direttamente nel contesto dell’agente, in modo che il modello veda cosa è consentito prima di generare una suggestione. Chiedere agli sviluppatori di scrivere “prompt sicure” non è una strategia. Se state diventando strategici, significa che la sicurezza stabilisce il confine, l’agente lo eredita. E inizia a tracciare un Bill of Materials dell’intelligenza artificiale. La maggior parte dei team non può dire quali agenti, modelli e pacchetti stanno toccando quali repository. Non puoi difendere ciò che non puoi inventariare.
Ha detto che la sicurezza non può più iniziare a CI/CD. Cosa assomiglia a una pipeline di sicurezza moderna quando la protezione deve iniziare prima nel processo di sviluppo?
Se la sicurezza inizia a CI/CD, avete ceduto l’intera fase pre-commit a un ambiente che non controllate. L’agente ha già ingestito il contesto, la vostra credenziale potrebbe già essere nei log di qualcun altro. State scansionando un cadavere.
Una pipeline moderna inizia sul laptop. Ciò significa inventariare gli agenti e le estensioni in esecuzione lì, validare a quali server MCP e modelli quegli agenti sono autorizzati a parlare, sanificare ciò che lascia la macchina e bloccare pacchetti dannosi prima che vengano installati. Da lì, la politica segue il lavoro nell’IDE. Iniettiamo gli standard di sicurezza direttamente nella finestra di contesto dell’agente in modo che il codice generato rimanga all’interno delle barriere operative fin dal primo token. La pipeline stessa non scompare. Il suo ruolo diventa la verifica: confermare che i controlli a monte sono stati applicati.
La pipeline stessa non scompare. Il suo ruolo diventa la verifica: confermare che i controlli a monte sono stati applicati.
Mentre le organizzazioni continuano ad adottare agenti di codifica dell’intelligenza artificiale, quali sono i cambiamenti più critici che devono apportare oggi per assicurare che i loro ambienti di sviluppo rimangano sicuri nei prossimi anni?
L’errore più grande è proteggere solo ciò che viene commitato. Il rischio interessante ora vive nelle otto ore prima di un commit. Dramma non visto può svolgersi sul laptop, nella prompt o nell’installazione del pacchetto. Se i vostri strumenti iniziano con la PR, state proteggendo la metà sbagliata del flusso di lavoro.
Strettamente correlato: smettere di trattare gli agenti di codifica dell’intelligenza artificiale come software di produttività. Sono utenti non umani con accesso shell, privilegi di scrittura del repository e connessioni di rete in uscita. Governateli come governate qualsiasi altra identità privilegiata, con un inventario, capacità approvate e log di audit.
L’ultimo spostamento è più difficile culturalmente. La maggior parte degli strumenti di “sicurezza dell’intelligenza artificiale” attuali presenta i risultati e li invia agli esseri umani. Gli esseri umani non possono triare alla velocità con cui gli agenti generano. Qualsiasi cosa adottiate deve risolvere i problemi automaticamente all’interno del flusso di lavoro, con ragionamento tracciabile, o diventerà un altro cruscotto che nessuno legge.
Grazie per la grande intervista, i lettori che desiderano saperne di più possono visitare Boost Security.


