
Interviste
Simon Poghosyan, Fondatore e Amministratore Delegato di GSpeech – Serie di Interviste

 Aggiungi Unite.AI alle tue fonti preferite su Google
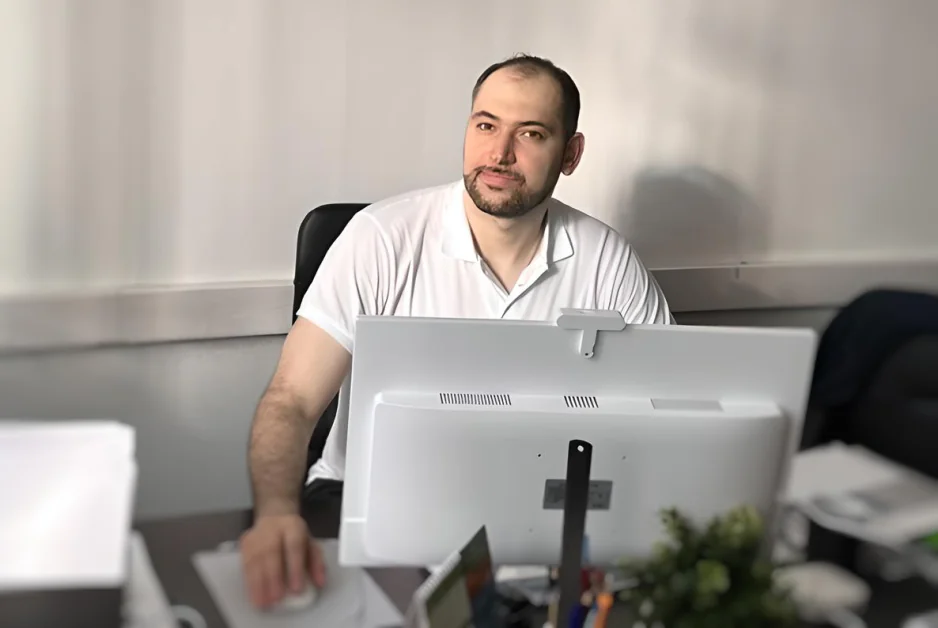
Simon Poghosyan è il fondatore e amministratore delegato di GSpeech, una piattaforma web basata su intelligenza artificiale che aiuta a rendere il contenuto online più accessibile convertendo il testo in audio naturale in oltre 70 lingue. Con una formazione in progettazione VLSI e un forte interesse per la programmazione e l’esperienza utente, Simon ha creato GSpeech per semplificare il modo in cui i siti web possono offrire contenuti vocali.
Oggi, GSpeech genera circa 200 milioni di caratteri di audio al mese e viene utilizzato in oltre 70 paesi, con i suoi lettori audio personalizzabili che servono oltre 200.000 riproduzioni mensili. Dopo aver superato i 1 miliardo di caratteri di audio generati in totale, GSpeech continua a crescere rapidamente. La piattaforma è progettata per essere facile da integrare – richiede solo una riga di codice – e supporta creatori, educatori e aziende nel rendere il loro contenuto più inclusivo e coinvolgente.
GSpeech viene utilizzato anche su tutte le nostre pagine in inglese, è possibile ascoltare questo articolo e vedere come GSpeech si esegue facendo clic sul pulsante di riproduzione.
La tua formazione in progettazione VLSI (Very Large Scale Integration) e la tua prima esperienza di programmazione hanno gettato le basi per una solida formazione tecnica. Cosa ti ha ispirato a passare dalla microelettronica alla creazione di software basato su intelligenza artificiale, e come ciò ha portato alla creazione di GSpeech?
La mia passione per la risoluzione dei problemi è iniziata al liceo, guidata da un amore per la matematica e la fisica. Ciò mi ha portato a conseguire una laurea (2009) e un master (2011) in progettazione VLSI presso l’Università di Stato per l’Ingegneria dell’Armenia, in collaborazione con Synopsys Armenia. Lo studio della fisica mi ha insegnato la precisione e il pensiero analitico, ma è stato durante il mio secondo anno che ho scoperto la programmazione – iniziando con il linguaggio Pascal – e mi sono immediatamente innamorato di essa. Il mio amico e io completavamo gli incarichi di lavoro appena li ricevevamo, anche se avevamo sei mesi per finirli. Poi, per divertimento, iniziavamo a fare gli incarichi degli altri studenti.
Questa passione mi ha portato più a fondo nello sviluppo del software. Ho iniziato con la creazione di siti web, poi ho costruito il mio CMS. Dopo aver completato diversi progetti in automazione dei processi e progettazione di architetture di gestione dei dati, mi sono reso conto di quanto amassi costruire soluzioni digitali per interfacce web. Attraverso il progetto 2GLux, ho collaborato con Edvard Ananyan – creatore del popolare servizio di traduzione GTranslate e un amico di scuola del Quant Gymnasium. Mi ha introdotto agli ecosistemi di WordPress e Joomla, e il concetto di GSpeech è nato con lui. Quel lavoro iniziale ha portato alla prima versione del nostro strumento, che ha consentito agli utenti di ascoltare il testo su una pagina web, piantando il seme per ciò che sarebbe diventato una piattaforma di intelligenza artificiale completa. Entro il 2023, ho fondato Smarts Club LLC per scalare GSpeech in una soluzione di audio intelligente globale, supportando 70+ lingue. La lode dell’Unione per l’Umanità per il ruolo di GSpeech nel migliorare la piattaforma di impegno civico accessibile riflette la mia missione di colmare le lacune digitali attraverso l’intelligenza artificiale – una visione radicata nei miei primi giorni di programmazione.
GSpeech è iniziato originariamente come strumento per supportare gli utenti con disabilità visiva. Come la missione iniziale ha influenzato l’evoluzione della piattaforma in una soluzione di testo-vocale completa basata su intelligenza artificiale?
L’attenzione all’accessibilità ha guidato lo sviluppo di audio di alta qualità in tempo reale, la traduzione in 70+ lingue e l’integrazione senza problemi con i siti web tramite un semplice snippet di codice. Questa missione ha portato a funzionalità come lettori audio personalizzabili, pannelli di selezione della lingua e della voce, riproduzione consapevole del contesto, download audio e statistiche dettagliate sull’utilizzo – compresi dati di paese, città, dispositivo e analisi della riproduzione nel tempo – tutte progettate per rendere il contenuto più inclusivo e coinvolgente. Dopo aver scritto oltre 100.000 righe di codice, ho lanciato la console cloud di GSpeech nel 2023 – una soluzione scalabile che bilancia l’inclusività con funzionalità avanzate, consentendo alle aziende e ai creatori di rendere il loro contenuto accessibile, multilingue e interattivo in tutta la rete.
Quali sono stati alcuni dei più grandi sfidi tecnici che hai affrontato durante lo sviluppo della console cloud di GSpeech?
Una delle sfide più grandi nello sviluppo della console cloud di GSpeech è stata la progettazione di un’architettura scalabile per la generazione di audio di alta qualità in tempo reale. Ciò ha richiesto soluzioni innovative per recuperare contenuti pertinenti dal web, elaborare l’audio sui nostri server e archiviarlo nella nuvola per una consegna rapida e affidabile. L’implementazione di misure di sicurezza robuste, come la crittografia e i controlli di accesso, è stata critica per proteggere il contenuto dinamico e generato dall’utente.
Un altro ostacolo è stata l’attivazione della traduzione in tempo reale utilizzando motori neurali avanzati. Abbiamo dovuto assicurarci che le traduzioni fossero a bassa latenza e accurate, costruendo un’interfaccia intuitiva che consentisse agli utenti di selezionare lingue e profili vocali preferiti per la riproduzione, dando priorità al comfort e alla personalizzazione dell’utente. Infine, abbiamo sviluppato un creatore di modelli di audio con多pli viste di lettura personalizzabili, consentendo agli utenti di progettare lettori unici e visivamente attraenti adattati ai loro siti web. Bilanciare flessibilità, prestazioni ed facilità d’uso su dispositivi diversi è stata una sfida gratificante.
Con la traduzione in tempo reale in 70+ lingue e oltre 230 voci naturali. Come assicuri la qualità della voce e mantieni l’accuratezza in un insieme di lingue così diverso?
Per mantenere una qualità della voce coerente, integriamo più modelli di testo-vocale (TTS) avanzati che vengono continuamente ottimizzati e aggiornati. Questi motori multilingue gestiscono contenuti misti con alta accuratezza. Stiamo inoltre lanciando oltre 100 nuove vibrazioni vocali per offrire agli utenti opzioni ancora più espressive e naturali. Ogni mese, GSpeech genera oltre 200 milioni di caratteri di audio, servendo utenti in oltre 70 paesi, con i nostri lettori online utilizzati oltre 200.000 volte al mese – e in crescita. Questa scala assicura un feedback costante e test di prova nel mondo reale, che informa direttamente i nostri controlli di qualità e ottimizzazioni.
Posso chiederti di spiegare come GSpeech sfrutta l’intelligenza artificiale e l’apprendimento automatico per offrire una sintesi vocale realistica? Come ti tieni al passo con i rapidi progressi nella tecnologia vocale neurale?
GSpeech utilizza intelligenza artificiale e apprendimento automatico avanzati, integrando più modelli di testo-vocale all’avanguardia per produrre una sintesi vocale realistica. Questi modelli, ottimizzati per naturalità e supporto multilingue, elaborano input di testo per generare audio di alta qualità con intonazione e ritmo realistici, anche per contenuti misti. Miglioriamo l’esperienza utente offrendo stili vocali personalizzabili per lingue diverse. Abbiamo anche integrato alias TTS, che consentono agli utenti di definire regole personalizzate per come vengono rese determinate parole o frasi in audio – ad esempio, sostituendo termini specifici per ottenere una pronuncia o una fraseologia più precisa. Per stare al passo con la tecnologia vocale neurale, valutiamo e integriamo costantemente gli ultimi progressi, collaboriamo con leader del settore e pianifichiamo di sviluppare modelli proprietari in futuro, assicurando che GSpeech rimanga all’avanguardia dell’innovazione della sintesi vocale.
Quanto sono importanti la regolazione della voce, il controllo del tono e la personalizzazione della riproduzione per i tuoi utenti – e qual è il caso d’uso di cui sei più orgoglioso in cui queste funzionalità brillano veramente?
La regolazione della voce, il controllo del tono e la personalizzazione della riproduzione sono fondamentali per i nostri utenti, consentendo loro di creare stili vocali unici e di alta qualità adattati alle loro esigenze specifiche, dalle notizie e dai blog ai contenuti di apprendimento accessibili. L’integrazione continua di oltre 100 nuove vibrazioni vocali migliora ulteriormente questo, offrendo agli utenti una flessibilità senza precedenti per creare vere e proprie voci personalizzate. Sono più orgoglioso di GSpeech Studio, una nuova piattaforma di editing e generazione audio che sto sviluppando. Consente agli utenti di creare più canali audio, mescolare musica di sottofondo ed esportare voci professionali, consentendo ai creatori di produrre audio di alta qualità per applicazioni diverse. Una lettera di uno studente con disabilità visiva che ringrazia GSpeech per avergli consentito di studiare in modo indipendente attraverso audio personalizzati, mi ha toccato profondamente. Questo caso d’uso mostra come queste funzionalità rendano il contenuto accessibile e trasformativo, un obiettivo che ho perseguito fin dai miei primi giorni di programmazione.
GSpeech offre integrazioni senza problemi con WordPress, Shopify , Wix e altro. Qual è stata la tua strategia per rendere la piattaforma plug-and-play per creatori e aziende in diversi ecosistemi?
La nostra strategia per le integrazioni plug-and-play di GSpeech con piattaforme come WordPress, Shopify e Wix si è concentrata sulla semplicità, sulla compatibilità e sulla scalabilità. Abbiamo sviluppato plugin e snippet di codice leggeri e modulari che si integrano senza problemi, richiedendo un setup minimo – spesso solo pochi clic. Ciò significa che migliaia di articoli e blocchi di contenuto dinamico possono acquisire immediatamente il supporto vocale – senza sforzo manuale. Offriamo lettori altamente flessibili e progettati con cura che si adattano ai dispositivi, compresi dispositivi mobili, tablet e desktop. I nostri lettori non sono solo personalizzabili, ma anche ottimizzati per accessibilità e coinvolgimento dell’utente. Per WordPress, abbiamo incorporato il pannello di controllo cloud di GSpeech direttamente nel pannello di amministrazione tramite il nostro plugin, semplificando la gestione per gli utenti. La documentazione dettagliata e i pannelli intuitivi guidano gli utenti non tecnici attraverso l’installazione e la personalizzazione. Test regolari assicurano prestazioni coerenti in diversi ecosistemi, consentendo ai creatori e alle aziende di aggiungere facilmente la funzionalità di testo-vocale basata su intelligenza artificiale.
Guardando indietro il percorso dal 2012 ad oggi, qual è stato il più grande traguardo per te personalmente o professionalmente nella costruzione di GSpeech?
Il più grande traguardo per GSpeech è stata la generazione di 1 miliardo di caratteri di audio di alta qualità, dimostrando il nostro impatto globale sull’accessibilità. Altrettanto significativo è stato il feedback che abbiamo ricevuto da organizzazioni come l’Unione per l’Umanità, che ha elogiato GSpeech per aver migliorato la piattaforma di impegno civico accessibile, e da proprietari di blog che l’hanno definito un “cambiamento di gioco” per il coinvolgimento degli utenti. Oltre 110 recensioni a 5 stelle su piattaforme come WordPress e AppSumo nei mesi recenti riflettono questa crescente fiducia.
GSpeech viene ora utilizzato anche dal dipartimento di statistica regionale di Namangan in Uzbekistan – un’istituzione governativa con un traffico significativo e visibilità a livello nazionale. Vedere un ente pubblico adottare la nostra tecnologia in modo così ampio è stato un traguardo significativo e un potente segno di fiducia nella nostra soluzione.
Come cristiano e persona che serve nella chiesa armena, cerco anche di sostenere altre iniziative basate sulla fede quando possibile. Spesso offro GSpeech gratuitamente a siti web cristiani come modo per aiutarli a diffondere il loro messaggio in modo più efficace e rendere le Scritture più accessibili attraverso l’audio. È il mio piccolo contributo a qualcosa di più grande. Allo stesso tempo, sono onorato di lavorare con ministeri dedicati come The Cord – una congregazione messianica e prezioso cliente di GSpeech – la cui missione e contenuto riflettono il potere delle Scritture in azione.
Questi momenti – quando la tecnologia diventa un ponte per la fede, la comprensione e l’inclusione – mi ricordano perché abbiamo costruito GSpeech in primo luogo.
Qual ruolo vedi GSpeech svolgere nel futuro dei media digitali, in particolare mentre il contenuto audio e le interfacce vocali diventano più dominanti?
Mi immagino GSpeech come un leader nel rendere i media digitali più accessibili e coinvolgenti, consentendo l’accesso vocale basato su intelligenza artificiale al web. Il nostro obiettivo è trasformare l’intera esperienza online, in modo che i siti web diventino naturalmente interattivi, inclusivi e multilingue per default. Con solo una riga di codice, i proprietari di siti web possono trasformare migliaia di articoli in contenuti vocali. Guardando avanti, stiamo sviluppando GSpeech Studio in una piattaforma potente e unica per la generazione e l’editing audio, consentendo agli utenti di creare contenuti vocali multilivello con musica di sottofondo, effetti e regolazione precisa. Vogliamo rendere il web veramente udibile, intuitivo e universalmente accessibile.
GSpeech è stato recentemente lanciato su AppSumo e ha già ottenuto una valutazione quasi perfetta dai primi adottanti. Qual è stato il significato della risposta della comunità di AppSumo per te, e come intendi costruire su questo slancio in futuro?
Il lancio su AppSumo ha introdotto GSpeech a milioni di persone, e la sua valutazione quasi perfetta è incredibilmente gratificante. Gli utenti, come quelli che gestiscono corsi online, elogiano i nostri strumenti intuitivi e il supporto rispondente, facendo eco al feedback dell’Unione per l’Umanità. Un proprietario di blog ha definito le nostre voci “autenticamente coinvolgenti” e le traduzioni “impressionanti”. Il loro feedback positivo conferma il valore della nostra soluzione di testo-vocale basata su intelligenza artificiale e alimenta la mia passione per il progetto. Sostenere i clienti durante il lancio ha anche generato nuove idee, in particolare per GSpeech Studio, che è stato ispirato dalle richieste degli utenti per funzionalità di editing e esportazione audio avanzate. In futuro, intendo costruire su questo slancio ascoltando attivamente la nostra comunità, integrando il loro feedback e sviluppando funzionalità innovative per migliorare l’accessibilità e il coinvolgimento, assicurando che GSpeech continui a evolversi come strumento trasformativo per creatori e aziende.
Infine, qual consiglio daresti a giovani sviluppatori o imprenditori che desiderano costruire strumenti accessibili e basati su intelligenza artificiale nel panorama tecnologico in rapida evoluzione di oggi?
Ai giovani sviluppatori e imprenditori, il mio consiglio è di mettere il cuore nel proprio lavoro e identificare un problema reale in cui offrire una soluzione unica e intelligente. Inizia con piccoli passi, ascolta attentamente il feedback dei clienti – ti guideranno nel percorso. Tratta gli utenti come amici fidati, dai il tuo meglio e mantieni la pazienza. Abbraccia le tecnologie di intelligenza artificiale come potenti alleati; quando utilizzate saggiamente, amplificano la tua capacità di creare strumenti accessibili e di impatto. Costruisci con passione, persistenza e impegno per fare la differenza, e creerai soluzioni che veramente contano.
Grazie per la grande intervista, abbiamo scelto la soluzione GSpeech per il nostro sito web a causa della facile integrazione. Per saperne di più, visita GSpeech.


