
Interviste
Omri Geller, CEO & Co-Founder di Run:AI – Serie di Interviste

 Aggiungi Unite.AI alle tue fonti preferite su Google
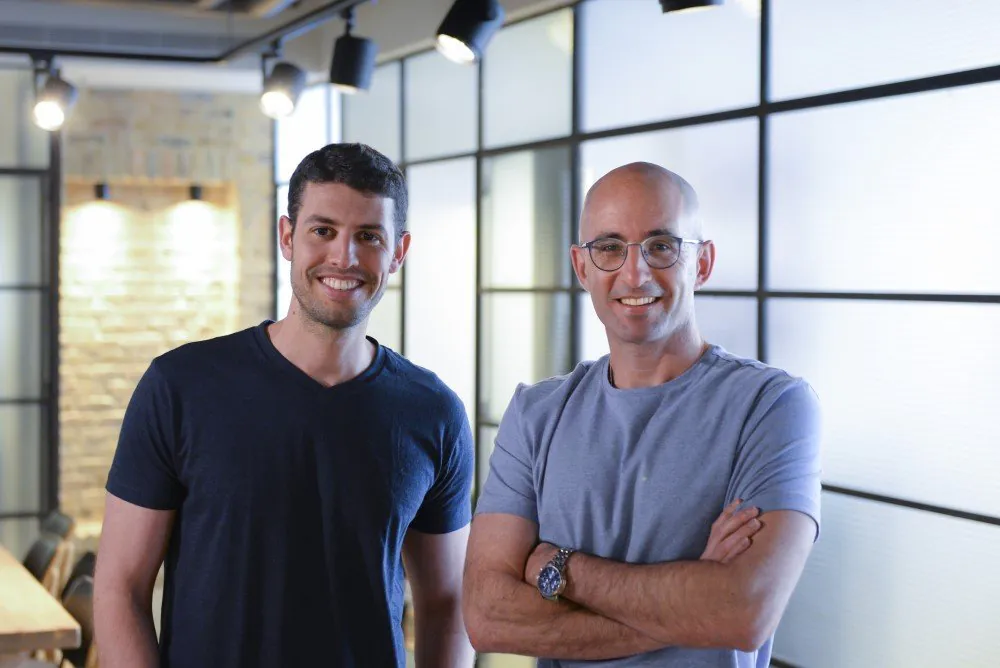
Omri Geller è il CEO e Co-Founder di Run:AI
Run:AI virtualizza e accelera l’AI raggruppando le risorse di calcolo GPU per garantire la visibilità e, in ultima analisi, il controllo sulla priorità e l’allocazione delle risorse. Ciò garantisce che i progetti di AI siano mappati sugli obiettivi aziendali e producano un miglioramento significativo nella produttività dei team di data science, consentendo loro di costruire e addestrare modelli concorrenti senza limitazioni di risorse.
Cosa ti ha inizialmente attirato verso l’Intelligenza Artificiale?
Quando ho iniziato il mio corso di laurea in Ingegneria Elettrica ed Elettronica all’Università di Tel Aviv, ho scoperto cose affascinanti sull’AI che sapevo mi avrebbero aiutato a fare il prossimo passo nelle possibilità di calcolo. Da lì, sapevo che volevo investirmi nello spazio AI. Che fosse nella ricerca sull’AI o nell’apertura di un’azienda che avrebbe aiutato a introdurre nuovi modi per applicare l’AI al mondo.
Hai sempre avuto un interesse per l’hardware dei computer?
Quando ho ricevuto il mio primo computer con un processore Intel (INTC ) 486 a sei o sette anni, ero immediatamente interessato a capire come funzionava tutto, anche se probabilmente ero troppo giovane per capirlo veramente. Oltre allo sport, i computer sono diventati uno dei miei più grandi hobby crescendo. Da allora, ho costruito computer, lavorato con loro e ho continuato a studiare in questo campo a causa della passione che avevo da bambino.
Qual è stata la tua ispirazione dietro il lancio di Run:AI?
Sapevo fin dall’inizio che volevo investirmi nello spazio AI. Negli ultimi due anni, l’industria ha visto una crescita tremenda nell’AI, e gran parte di questa crescita è venuta da scienziati informatici come me e da hardware che poteva supportare più applicazioni. È diventato più chiaro per me che avrei inevitabilmente fondato un’azienda – e insieme al mio co-fondatore Ronen Dar – per continuare a innovare e aiutare a portare l’AI a più aziende.
Run:AI consente ai specialisti di apprendimento automatico di ottenere un nuovo tipo di controllo sull’allocazione delle risorse GPU costose. Puoi spiegare come funziona?
Ciò che dobbiamo capire è che gli ingegneri di apprendimento automatico, come i ricercatori e gli scienziati dei dati, devono consumare potenza di calcolo in modo flessibile. Non solo i calcoli più recenti sono molto intensivi in termini di calcolo, ma ci sono anche nuovi flussi di lavoro che vengono utilizzati nella scienza dei dati. Questi flussi di lavoro si basano sul fatto che la scienza dei dati si basa sull’esperimento e sull’esecuzione di esperimenti.
Per sviluppare nuove soluzioni per eseguire esperimenti più efficienti, dobbiamo studiare queste tendenze del flusso di lavoro nel tempo. Ad esempio: uno scienziato dei dati utilizza otto GPU in un giorno, ma il giorno successivo potrebbe utilizzarne zero, o potrebbe utilizzarne una per un lungo periodo di tempo, ma poi averne bisogno di 100 perché vuole eseguire 100 esperimenti in parallelo. Una volta che capiamo questo flusso di lavoro per ottimizzare la potenza di calcolo di un utente, possiamo iniziare a scalare per più utenti.
Con il calcolo tradizionale, un numero specifico di GPU viene assegnato a ogni utente, senza tenere conto se sono in uso o no. Con questo metodo, spesso le costose GPU rimangono inattive senza che nessun altro possa accedervi, risultando in un basso ROI per la GPU. Capiamo le priorità finanziarie di un’azienda e offriamo soluzioni che consentono l’allocazione dinamica di quelle risorse in base alle esigenze degli utenti. Offrendo un sistema flessibile, possiamo assegnare potenza extra a un utente specifico quando richiesto, utilizzando le GPU non in uso da altri utenti, creando il massimo ROI per le risorse di calcolo di un’azienda e accelerando l’innovazione e il tempo di mercato delle soluzioni AI.
Una delle funzionalità di Run:AI è che consente la riduzione dei punti ciechi creati dall’allocazione statica di GPU. Come si ottiene ciò?
Abbiamo uno strumento che ci dà la completa visibilità nel cluster di risorse. Utilizzando questo strumento, possiamo osservare e capire se ci sono punti ciechi e poi utilizzare quelle GPU inattive per gli utenti che necessitano di allocazione. Lo stesso strumento che fornisce visibilità nel cluster e controllo sul cluster assicura anche che quei punti ciechi vengano mitigati.
Nel tuo recente discorso, hai evidenziato alcune distinzioni tra flussi di lavoro di costruzione e formazione, puoi spiegare come Run:AI utilizzi un meccanismo di gestione della coda GPU per allocare la gestione delle risorse per entrambi?
Un modello di AI viene costruito in due fasi. La prima è la fase di costruzione, in cui uno scienziato dei dati sta scrivendo il codice per costruire il modello effettivo, allo stesso modo in cui un ingegnere costruirebbe un’auto. La seconda è la fase di formazione, in cui il modello completato inizia a imparare e viene “addestrato” per ottimizzare una specifica attività. Simile a quando qualcuno impara a guidare l’auto dopo che è stata assemblata.
Per costruire il modello stesso, non è necessaria molta potenza di calcolo. Tuttavia, alla fine potrebbe aver bisogno di una potenza di elaborazione più forte per iniziare test interni più piccoli. Ad esempio, il modo in cui un ingegnere vorrebbe eventualmente testare il motore prima di installarlo. A causa di queste esigenze diverse durante ogni fase, Run.AI consente l’allocazione di GPU indipendentemente dal fatto che stiano costruendo o formando il modello, tuttavia, come menzionato in precedenza, è generalmente necessario un uso più elevato di GPU per la formazione del modello mentre se ne richiede meno per costruirlo.
Quanto tempo di calcolo grezzo/risorse può essere risparmiato dagli sviluppatori di AI che desiderano integrare Run.AI nei loro sistemi?
Le nostre soluzioni in Run.ai possono migliorare la digitalizzazione delle risorse, di circa due o tre volte, significando 2-3 volte maggiore produttività complessiva.
Grazie per l’intervista, i lettori che desiderano saperne di più possono visitare Run:AI.


