
Angolo di Anderson
La soluzione unica di DALL-E 2 ai doppi significati

 Aggiungi Unite.AI alle tue fonti preferite su Google
Punti chiaveDALL-E 2 将像 'bat' 这样的歧义词拆分成一幅图像中的多个物体。
Vedi di più
- DALL-E 2 将像 'bat' 这样的歧义词拆分成一幅图像中的多个物体。
- 这种语义错误随着基于CLIP的模型在更大数据集上训练而加剧。
- 超过80%的包含同音异义词的DALL-E 2图像显示出非预期的双重解读。
Chiunque abbia imparato l’italiano ha imparato presto a prestare attenzione al contesto quando descrive una scopa, perché la parola italiana per questo oggetto domestico quotidiano ha un secondo significato come verbo estremamente inappropriato sul lavoro*. Sebbene impariamo presto a districare la mappatura semantica e (apposita) applicabilità delle parole con più significati, questa non è una capacità che sia facile da trasmettere a sistemi di sintesi di immagini iperscalari come DALL-E 2 e Stable Diffusion, perché si basano sul modulo di pre-formazione del linguaggio-immagine contrastivo di OpenAI (CLIP), che tratta gli oggetti e le loro proprietà in modo più lasco (ma che sta guadagnando sempre più terreno nello spazio di sintesi di immagini e video di diffusione latente).
Studiando questo deficit, una nuova collaborazione di ricerca dell’Università Bar-Ilan e dell’Istituto di intelligenza artificiale Allen offre uno studio approfondito sulla misura in cui DALL-E 2 è incline a tali errori semantici:

Doppi significati divisi in più interpretazioni in DALL-E 2 – sebbene qualsiasi sistema di diffusione latente possa produrre tali esempi. Nell’immagine in alto a destra, rimuovendo ‘gold’ dal prompt cambia la specie di pesce, mentre nel caso del ‘passaggio pedonale’, è necessario specificare esplicitamente la superficie stradale per rimuovere l’associazione duplicata. Fonte: https://export.arxiv.org/pdf/2210.10606
Gli autori hanno scoperto che questa tendenza a interpretare le parole e le frasi in modo doppio sembra non essere solo comune a tutti i modelli di diffusione guidati da CLIP, ma che peggiora man mano che i modelli vengono addestrati su quantità sempre maggiori di dati. Lo studio nota che le versioni ‘ridotte’ dei modelli di testo-immagine, compreso DALL-E Mini (ora Craiyon), producono questi tipi di errori con molta minore frequenza, e che Stable Diffusion si sbaglia anche meno – sebbene solo perché, molto spesso, non segue il prompt per niente, il che è un altro tipo di errore.

Il semplice prompt ‘date’ costringe DALL-E 2 a invocare due dei diversi significati della parola, mentre la parola ‘fan’ si divide anche in due delle sue mappe semantiche, e, nella terza immagine, la frase ‘cone’ trasforma in modo affidabile il cibo non specificato nel prompt in gelato, che è associato al ‘cone’.
Spiegando come eseguiamo separazioni lessicali efficienti, lo studio afferma:
‘Mentre i simboli – così come le strutture di frase – possono essere ambigui, una volta che un’interpretazione è stata costruita, l’ambiguità è già stata risolta. Ad esempio, mentre la parola inglese ‘bat’ in ‘a flying bat’ può essere interpretato come un bastone di legno o un animale, le nostre possibili interpretazioni della frase sono o di un bastone di legno volante o di un animale volante, ma mai entrambi allo stesso tempo. Una volta che la parola ‘bat’ è stata utilizzata nell’interpretazione per denotare un oggetto (ad esempio un bastone di legno), non può essere riutilizzata per denotare un altro oggetto (un animale) nella stessa interpretazione.’
DALL-E 2, lo studio osserva, non è vincolato in questo modo:

‘A bat is flying over a baseball stadium’ – la prima immagine è dallo studio, le altre tre ottenute semplicemente alimentando lo stesso prompt in DALL-E 2.
Questa proprietà è stata denominata sensibilità alle risorse.
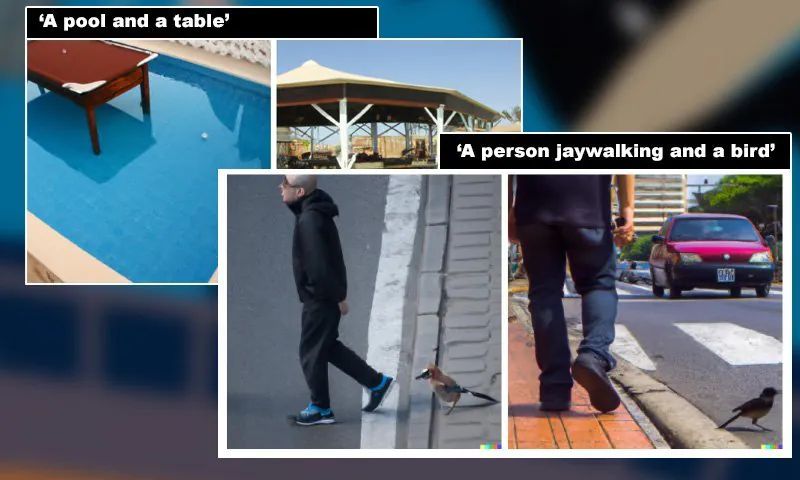
Lo studio identifica tre comportamenti aberranti esibiti da DALL-E 2: che una parola o una frase possa essere interpretata e di fatto biforcuta in due entità distinte, rappresentando un oggetto o un concetto per ciascuno nella stessa scena; che una parola possa essere interpretata come un modificatore di due entità diverse (vedi gli esempi ‘pesce d’gold’ e altri sopra); e che una parola possa essere interpretata contemporaneamente come un modificatore e un’entità alternativa – esemplificato dal prompt ‘a seal is opening a letter’:

‘A seal is opening a letter’ – la prima illustrazione è dallo studio, le tre adiacenti, riproduzioni identiche da DALL-E 2. Gli esempi fotorealistici in basso avevano il testo aggiuntivo ‘photo, Canon50, 85mm, F5.6, award-winning photo’.
Gli autori identificano due modi di fallimento per i modelli di diffusione in questo senso: che i risultati dei prompt dell’utente con parole ambigue spesso esibiranno la parola concretizzata insieme a una manifestazione del concetto; e trasferimento improprio di concetti, dove le proprietà di un oggetto si trasferiscono impropriamente a un altro oggetto rappresentato.
‘Prese insieme, i fenomeni che esaminiamo forniscono prove per le limitazioni nella capacità linguistica di DALLE-2 e aprono strade per future ricerche che scoprirebbero se queste derivano da problemi con la codifica del testo, il modello generativo o entrambi. Più in generale, l’approccio proposto può essere esteso ad altri scenari in cui il processo di decodifica viene utilizzato per scoprire il bias induttivo e le carenze dei modelli di testo-immagine.’
Utilizzando 17 parole che faranno si che DALL-E 2 divida l’input in più output, gli autori hanno osservato che la duplicazione omonima si è verificata in oltre l’80% di 216 immagini rappresentate.
I ricercatori hanno utilizzato coppie di stimoli-controlli per esaminare la misura in cui un linguaggio specifico e forse eccessivamente dettagliato è necessario per fermare queste duplicazioni. Per i test di entità-proprietà, sono state create 10 coppie e gli autori notano che i prompt di stimolo provocano la proprietà condivisa nel 92,5% dei casi, mentre il prompt di controllo la provoca solo nel 6,6% dei casi.
‘[Per] dimostrare, considera una zebra e una strada, qui, la zebra è un’entità, ma modifica la strada, e DALLE-2 genera costantemente attraversamenti pedonali, forse a causa della somiglianza delle strisce della zebra con un passaggio pedonale. E in linea con la nostra congettura, il controllo una zebra e una strada di ghiaia specifica un tipo di strada che di solito non ha passaggi pedonali, e in effetti, tutti i nostri campioni di controllo per questo prompt non contengono un passaggio pedonale.’





