
Il meglio
10 migliori strumenti di scraping web basati sull’IA (novembre 2026)

 Aggiungi Unite.AI alle tue fonti preferite su Google
Unite.AI può ricevere un compenso quando utilizzi link a prodotti da noi recensiti. Ciò non influenza le nostre valutazioni editoriali. Leggi la nostra informativa sulle affiliazioni.
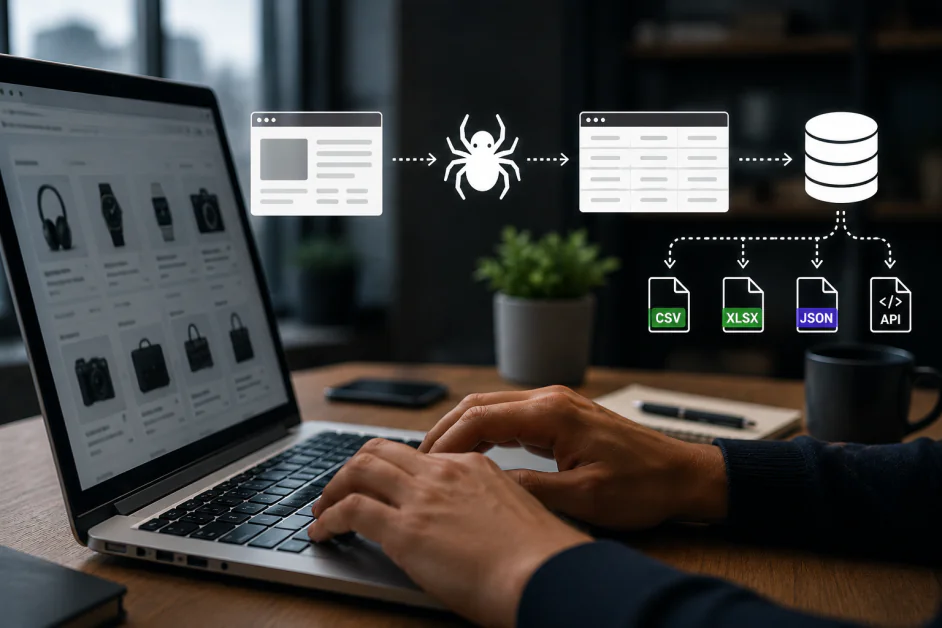
Il miglior strumento di scraping web basato sull’IA dipende da ciò che si vuole fare dopo il caricamento di una pagina. Un assistente di ricerca ha bisogno di contenuti leggibili e di link alle fonti. Un sistema di market intelligence necessita di dati coerenti su larga scala. Un agente interattivo potrebbe aver bisogno di un browser in grado di eseguire diversi passaggi e mantenere attiva la sessione.
Questa guida presenta dieci strumenti per queste attività: piattaforme di raccolta dati per aziende, API di contenuti, strumenti di scraping senza codice, servizi di dati di ricerca e browser gestiti. Valutiamo come ciascun prodotto raccoglie le informazioni, chi può gestire il flusso di lavoro e quali compromessi considerare quando un prototipo diventa un processo ricorrente.
Il nostro team ha valutato in modo indipendente ogni soluzione presentata in questa guida, esaminandone le funzionalità, i punti di forza pratici, i limiti e l’idoneità ai casi d’uso rappresentati nella nostra classifica.
Confronto tra i migliori strumenti di scraping web basati sull’IA
| Strumento di IA | Ideale per | Punti di forza principali |
|---|---|---|
| Bright Data | Raccolta dati aziendale e pipeline di dati diversificate | API Scraper, Browser API, Scraper Studio, dataset, proxy |
| Firecrawl | Contenuti web per applicazioni di IA | Ricerca, scraping, mappatura, scansione, Markdown, JSON, interazione, MCP |
| Apify | Attività di scraping riutilizzabili e orchestrazione nel cloud | Actors, Crawlee, pianificazioni, archiviazione, proxy, API, MCP |
| Browse AI | Raccolta dati senza codice e monitoraggio delle modifiche | Configurazione assistita dall’IA, robot, avvisi, pianificazioni, integrazioni |
| SearchAPI | Risultati di ricerca strutturati e ricerche localizzate | Google, Maps, shopping, video, interfacce di ricerca basate sull’IA, JSON |
| Octoparse | Scraping visivo con esecuzione ripetibile nel cloud | Modelli, Assistente IA, rilevamento automatico, esecuzioni nel cloud, esportazioni |
| Browserless | Browser gestiti per Puppeteer e Playwright | Browser ospitati, sessioni persistenti, API REST, MCP |
| ScrapingBee | Estrazione gestita tramite un’API applicativa | Estrazione basata sull’IA, CSS/XPath, Markdown, scenari JS, MCP |
| Oxylabs | Recupero gestito di dati da siti web pubblici difficili da consultare | API web /Scrape, rendering, output strutturato, MCP |
| Diffbot | Estrazione automatica e analisi delle entità | Estrazione, schemi standard, scansione, Knowledge Graph |
Come scegliere uno strumento di scraping web basato sull’IA
Scegliere lo strumento in base al lavoro
Per una base di conoscenza basata sull’IA, dai priorità a testo leggibile, output strutturato e conservazione degli URL delle fonti. Per le ricerche aziendali ripetitive, un robot visuale e gli avvisi sulle modifiche possono essere più importanti di un’interfaccia di programmazione. Per un agente interattivo, valuta la continuità della sessione e il controllo del browser. Le API dei risultati di ricerca risolvono un problema diverso: forniscono dati di ricerca, mentre la raccolta delle pagine collegate è un passaggio separato.
Stabilire chi gestisce il flusso di lavoro
Una piattaforma senza codice consente a un analista di modificare direttamente le fasi di estrazione. Un’API offre agli sviluppatori un’interfaccia semplice per integrare la raccolta dati in un’applicazione. Una piattaforma di attività nel cloud aggiunge pianificazione e archiviazione, mentre un browser gestito lascia al team una maggiore responsabilità per la logica di automazione. La scelta giusta affida la manutenzione alle persone che conoscono sia i siti web di origine sia il formato richiesto per i dati.
Pianificare il budget in base ai dati utili, non alle richieste dichiarate
Confronta il costo di un’attività completata con i campi di cui hai bisogno. Rendering, proxy premium, durata dell’utilizzo del browser, estrazione basata sull’IA, archiviazione e tentativi ripetuti possono modificare il costo totale. Un credito gratuito, un’unità di browser e una richiesta di ricerca sono misure diverse. Per le attività ricorrenti, insieme alle risposte riuscite, tieni traccia della completezza, dei duplicati, dell’aggiornamento dei dati e del costo per ogni record utilizzabile.
I 10 migliori strumenti di scraping web basati sull’IA
1. Bright Data
Bright Data è la nostra raccomandazione complessiva per le organizzazioni che hanno bisogno di diversi metodi per acquisire dati dal web attraverso un’unica piattaforma. La sua offerta comprende API Scraper pronte all’uso, dataset raccolti in precedenza, Scraper Studio, Web Unlocker e servizi proxy. Un team di e-commerce intelligence, per esempio, può usare feed strutturati per i rivenditori più noti e, al contempo, creare procedure di raccolta personalizzate per un marketplace specializzato. Questa ampiezza di soluzioni è particolarmente utile quando il programma di raccolta dati si estende oltre un singolo sito web o reparto.
Per le pagine interattive, Browser API ospita browser che gli sviluppatori possono controllare con Puppeteer, Playwright o Selenium. Combina l’esecuzione del browser con la gestione dei proxy e la risoluzione dei CAPTCHA, mentre il supporto a Chrome DevTools aiuta gli ingegneri a esaminare le sessioni problematiche. È utile quando un flusso di lavoro richiede di navigare o interagire con una pagina prima che le informazioni desiderate siano disponibili, invece di limitarsi a scaricare un dataset esistente.
Il principale compromesso riguarda la scelta dei prodotti e la gestione dei costi. Il traffico del browser, i risultati dello scraping e l’acquisto di dataset corrispondono a carichi di lavoro diversi, quindi un unico prezzo indicativo non può descrivere l’intera piattaforma. Bright Data è adatto ai team che hanno una persona responsabile della qualità della raccolta, della copertura delle fonti e della spesa. Un progetto circoscritto potrebbe arrivare più rapidamente in produzione con un’API di estrazione più semplice.
Pro e contro
- Ampia scelta di opzioni di raccolta in un’unica piattaforma
- I browser ospitati supportano librerie di automazione consolidate
- Le API e i dataset già pronti riducono i tempi di configurazione
- I diversi prodotti richiedono una pianificazione separata dei costi
- Le pipeline personalizzate richiedono comunque una supervisione tecnica
2. Firecrawl
Firecrawl è la nostra scelta per gli sviluppatori che trasformano i contenuti web in contesto utile per un’applicazione di IA. I suoi strumenti di ricerca, scraping, mappatura e scansione coprono l’intero percorso, dalla scoperta di una pagina alla raccolta dei contenuti di un sito web; Markdown e JSON strutturato riducono il lavoro di pulizia necessario dopo il recupero. Un assistente di ricerca o un prodotto basato su una base di conoscenze può così dedicare più tempo a rispondere alle domande e meno a rimuovere i menu di navigazione dall’HTML grezzo.
La funzionalità Interact, attualmente disponibile, estende la piattaforma alle operazioni in tempo reale tramite browser. Gli agenti possono descrivere le azioni in linguaggio naturale o eseguire codice nel browser, mantenere lo stato tra una chiamata e l’altra e riutilizzare profili autenticati. È un’aggiunta importante per le pagine che richiedono clic, filtri o un accesso prima dell’estrazione. L’accesso tramite MCP e riga di comando rende inoltre Firecrawl adatto ai flussi di sviluppo degli agenti, non soltanto all’uso come API applicativa tradizionale.
Firecrawl dà il meglio quando il problema immediato è acquisire contenuti e l’applicazione dispone già di sistemi di archiviazione e recupero. I team devono comunque definire i limiti della scansione, conservare gli URL delle fonti e distinguere un campo mancante da uno vuoto. Il codice open source offre un’ulteriore modalità di distribuzione, ma i team dovrebbero valutare le funzionalità specifiche e i requisiti operativi della modalità scelta, senza presumere che le versioni ospitata e autogestita siano identiche.
Pro e contro
- Markdown e JSON sono adatti alle pipeline di IA
- Interact supporta attività del browser con stato persistente
- Accesso tramite API, MCP e CLI
- I contenuti recuperati devono comunque essere convalidati
- Le installazioni autogestite richiedono attività operative
3. Apify
Apify è la scelta migliore in questo contesto per i team che vogliono strumenti di scraping riutilizzabili e una piattaforma su cui gestirli. Il suo marketplace distribuisce Actors: programmi preconfezionati che accettano input, vengono eseguiti nel cloud e restituiscono risultati. Gli Actors già disponibili possono accelerare le attività di raccolta più comuni, mentre gli Actors personalizzati consentono agli sviluppatori di mantenere la propria logica di estrazione. Apify rappresenta così un utile ponte tra un esperimento e un’attività di produzione ripetibile.
La piattaforma offre funzionalità operative importanti, tra cui pianificazione, archiviazione dei risultati, accesso ai proxy, monitoraggio e integrazioni. Gli sviluppatori possono anche lavorare con Crawlee, la libreria open source di Apify per la scansione web e l’automazione dei browser. Il server MCP di Apify mette gli Actors a disposizione degli agenti di IA, così lo stesso strumento preconfezionato può servire un’applicazione, una pipeline pianificata o un assistente senza dover realizzare uno scraper separato per ciascuna interfaccia.
La scelta degli Actors merita la stessa attenzione riservata alla scelta della piattaforma. I diversi editori possono proporre prezzi, manutenzione, opzioni di input e qualità dei risultati differenti. Inoltre, il completamento corretto di un’esecuzione non dimostra che siano stati raccolti tutti i record previsti. Apify è particolarmente interessante quando una persona è responsabile dello schema dell’attività, monitora le modifiche e pianifica il budget per l’Actor selezionato e l’uso dell’infrastruttura; una raccolta manuale su una sola pagina raramente richiede un’orchestrazione così articolata.
Pro e contro
- Actors già pronti e personalizzati condividono la stessa piattaforma
- Pianificazione, archiviazione e monitoraggio supportano attività ripetibili
- MCP integra gli Actors nei flussi di lavoro degli agenti
- Manutenzione e qualità degli Actors variano
- È necessario pianificare il budget per l’uso e i costi degli Actors
4. Browse AI
Browse AI è la nostra scelta consigliata per le aziende che hanno bisogno di raccogliere dati dal web con regolarità senza dover sviluppare un progetto software. La configurazione attuale può leggere una pagina fornita dall’utente, proporre una struttura per i dati e consentire all’utente di esaminare o modificare i campi. L’addestramento dei robot resta fondamentale per rendere ripetibile l’estrazione. È un approccio pratico per i team operativi e di marketing che raccolgono in tabelle familiari schede di prodotti, voci di directory o informazioni sulla concorrenza.
Il monitoraggio è uno dei suoi punti di forza. I robot possono controllare le pagine secondo una pianificazione, individuare aggiunte o modifiche e inviare avvisi che spiegano che cosa è cambiato. I flussi di lavoro possono collegare la raccolta di dati tra più pagine, mentre le integrazioni con API, webhook e fogli di calcolo consentono di trasferire i risultati agli strumenti già usati dal team. Un flusso di lavoro per il monitoraggio dei prezzi può quindi diventare un processo aziendale continuativo, anziché una serie di controlli manuali nel browser.
La facilità d’uso non elimina la necessità di definire chiaramente i dati. Gli utenti dovrebbero stabilire quali modifiche giustificano un avviso e verificare che la paginazione, i passaggi di accesso e i risultati vuoti funzionino correttamente. Anche i cambiamenti sostanziali alla struttura di un sito possono richiedere un intervento. Browse AI è la scelta migliore quando un team aziendale può esaminare i dati estratti e gestire il robot; gli sviluppatori che hanno bisogno di una logica per il browser con versioni rigorosamente controllate potrebbero preferire un servizio basato sul codice.
Vantaggi e svantaggi
- La configurazione dei campi assistita dall’IA abbassa la soglia di accesso
- Il monitoraggio pianificato mette in evidenza le modifiche rilevanti
- Collegamenti a fogli di calcolo, API e webhook
- I cambiamenti sostanziali ai siti possono richiedere un nuovo addestramento
- La logica complessa richiede una progettazione attenta dei flussi di lavoro
5. SearchAPI
SearchAPI è la nostra scelta specializzata per raccogliere risultati di ricerca sotto forma di dati strutturati. La sua API di Google può restituire in formato JSON i link ai risultati e le funzionalità di ricerca, evitando di dover mantenere un parser per una pagina dei risultati che cambia nel tempo. Il catalogo più ampio comprende fonti come Maps, shopping, notizie, video e le esperienze di ricerca basate sull’IA supportate. È particolarmente utile quando la scoperta e la visibilità nei risultati di ricerca costituiscono il prodotto dei dati, anziché essere un passaggio preliminare alla scansione di un altro sito web.
La localizzazione è un aspetto importante di questa soluzione. I parametri relativi a posizione, paese, lingua e dispositivo consentono ai team di analizzare un mercato in uno specifico contesto di ricerca. Un’applicazione SEO può monitorare una query in una determinata città, mentre un assistente di ricerca può individuare fonti pertinenti e conservare i link restituiti per consultarli in seguito. La documentazione specifica per ciascun motore è importante, perché i parametri disponibili e i campi dei risultati variano da un prodotto di ricerca all’altro.
SearchAPI va scelto in base ai motori e ai campi effettivamente necessari nel flusso di lavoro. Un risultato di ricerca non contiene tutti i contenuti della pagina collegata e le interfacce dei risultati più ricche non seguono tutte lo stesso schema. I team dovrebbero prevedere il volume delle richieste, verificare i requisiti di capacità di elaborazione e gestire con criterio le sezioni mancanti nei risultati. Per estrarre dati da siti web qualsiasi o per una sessione interattiva nel browser, è meglio partire da un altro strumento di questa guida.
Vantaggi e svantaggi
- I risultati strutturati eliminano la necessità di mantenere parser per le SERP
- Ampio catalogo di motori di ricerca e motori correlati
- Controlli dettagliati per la localizzazione
- I risultati di ricerca non sostituiscono l’estrazione dei dati dalle pagine di destinazione
- Campi e parametri variano da un motore all’altro
6. Octoparse
Octoparse illustra il suo AI Copilot e l’automazione con intervento umano. Video: Octoparse.
Octoparse è adatto agli analisti che vogliono progettare visivamente uno scraper e poi eseguirlo più volte. La piattaforma attuale offre modelli pronti all’uso, la configurazione tramite AI Assistant e il rilevamento automatico delle pagine nell’applicazione desktop. Gli utenti possono perfezionare l’attività risultante, senza dover partire dal codice per il browser. Questa flessibilità è utile per raccogliere cataloghi di prodotti, directory o inserzioni, dove la sequenza delle pagine conta tanto quanto i campi presenti in ciascuna pagina.
L’esecuzione nel cloud trasforma un’attività preparata in un processo di raccolta continuativo, senza dover tenere acceso il computer personale. La pianificazione, l’elaborazione parallela, la rotazione degli IP e i collegamenti per l’esportazione aiutano a gestire lavori più ampi, andando oltre i prototipi realizzati su desktop. L’approccio visivo è particolarmente interessante per i team che conoscono i siti web di origine e i requisiti dei dati, ma non vogliono gestire un servizio personalizzato di automazione del browser.
Per usare Octoparse al meglio è comunque necessario progettare con attenzione le attività. La paginazione, lo scorrimento infinito, i passaggi dei moduli e i record duplicati possono cambiare il significato di un’esecuzione apparentemente riuscita. Le quote del cloud e le funzionalità del piano dovrebbero essere adeguate alla frequenza e al volume previsti. Lo consigliamo ai team che vogliono controllare i passaggi di estrazione più di quanto consenta uno strumento rapido con un solo clic, purché una persona sia responsabile di modificare l’attività quando cambiano le pagine di origine.
Vantaggi e svantaggi
- I modelli e l’assistenza dell’IA semplificano la configurazione
- La modifica visiva consente di creare attività di estrazione dettagliate
- Le esecuzioni nel cloud consentono la raccolta pianificata
- I siti complessi richiedono di perfezionare l’attività
- Le funzionalità cloud dipendono dal piano selezionato
7. Browserless
Consigliamo Browserless agli sviluppatori che vogliono controllare un browser affidandone hosting e scalabilità a un servizio gestito. Gli script esistenti per Puppeteer o Playwright possono collegarsi a browser remoti, una caratteristica che lo rende interessante per i progetti che dispongono già di codice di automazione funzionante. È particolarmente utile quando la raccolta richiede diverse interazioni, un’interfaccia ricca di JavaScript o una sessione che deve durare più di una singola richiesta.
Il servizio mette inoltre a disposizione API REST per lo scraping, gli screenshot, i PDF e le funzioni browser personalizzate. Il server MCP ospitato rende disponibili strumenti per il browser agli agenti IA, mentre le funzionalità di gestione delle sessioni e i profili autenticati supportano i flussi di lavoro che richiedono continuità. Browserless è quindi adatto sia agli sviluppatori che creano un sistema personalizzato per raccogliere dati, sia agli agenti che devono navigare e acquisire informazioni tramite un browser reale.
Il principale aspetto da valutare prima dell’acquisto è il modo in cui viene conteggiato l’utilizzo del browser. Al momento, il piano gratuito include 1.000 unità al mese e due browser simultanei, non 1.000 scraping garantiti. Il tempo di utilizzo del browser consuma unità; il traffico proxy e la risoluzione dei CAPTCHA con esito positivo comportano costi aggiuntivi. I limiti delle sessioni variano in base al piano. I team restano responsabili della logica di estrazione e dei controlli sui risultati: Browserless è quindi particolarmente interessante quando il controllo del browser conta più di uno strumento visuale per creare robot.
Vantaggi e svantaggi
- Consente di mantenere i flussi di lavoro abituali con Puppeteer e Playwright
- Le API REST coprono lo scraping e l’esportazione delle pagine
- Le funzionalità di gestione delle sessioni e MCP sono adatte agli agenti interattivi
- Il tempo di utilizzo del browser e i componenti aggiuntivi incidono sul consumo di unità
- L’estrazione personalizzata richiede comunque logica applicativa
8. ScrapingBee
ScrapingBee è un’ottima scelta per gli sviluppatori che preferiscono una richiesta di scraping gestita al controllo diretto di un browser in esecuzione prolungata. La sua API combina il recupero delle pagine e il rendering JavaScript con la gestione dei proxy; per l’estrazione si possono usare regole CSS o XPath oppure istruzioni in linguaggio naturale basate sull’IA. Questa combinazione è utile quando un progetto deve ottenere dati strutturati da diversi siti web senza dover gestire un proprio parco di browser.
Gli scenari JavaScript possono fare clic, scorrere la pagina, digitare o attendere prima che vengano raccolti i dati. L’output in Markdown supporta i flussi di lavoro basati sui contenuti per l’IA, mentre gli screenshot consentono di acquisire la pagina renderizzata. Il prodotto attuale offre anche API dedicate a determinate fonti, oltre all’accesso tramite CLI e MCP. Gli sviluppatori possono usare regole di estrazione esplicite per i campi stabili e ricorrere all’estrazione in linguaggio naturale quando la struttura della pagina o la richiesta sono meno prevedibili.
La differenza rispetto a una piattaforma con browser ospitato è concreta: ScrapingBee si concentra sulla richiesta e sul risultato restituito, mentre l’applicazione personalizzata gestisce il lavoro più ampio. Il coordinamento tra più pagine, la rimozione dei duplicati, la pianificazione degli aggiornamenti e la convalida dei record devono comunque essere gestiti altrove. Anche il consumo di crediti varia in base alle funzionalità utilizzate, tra cui il rendering e le opzioni proxy. Lo consigliamo ai team di sviluppo che apprezzano un’interfaccia HTTP semplice e vogliono gestire l’orchestrazione della propria pipeline di dati nel codice.
Vantaggi e svantaggi
- Le regole basate su selettori e l’estrazione con l’IA offrono flessibilità
- Il rendering e gli scenari consentono di gestire le pagine interattive
- Markdown, CLI e MCP supportano i flussi di lavoro basati sull’IA
- Le opzioni avanzate per le richieste aumentano il consumo di crediti
- I processi che coinvolgono più pagine richiedono comunque un’orchestrazione
9. Oxylabs
Oxylabs è un’ottima soluzione per i team che desiderano un accesso gestito a siti web pubblici difficili da raggiungere e la possibilità di aumentare i volumi di raccolta. L’attuale Web API include /Scrape, un servizio per recuperare e strutturare dati web, con rendering JavaScript e gestione dell’accesso integrati. L’offerta comprende anche /Search e un’infrastruttura per i browser, così i team possono scegliere tra diversi approcci in base al fatto che l’attività inizi con la ricerca, l’estrazione o l’interazione.
Le opzioni specifiche per le diverse fonti consentono di ottenere campi utili dai principali motori di ricerca e siti di e-commerce, mentre le connessioni agli agenti tramite MCP e Agent Skills integrano la raccolta nei flussi di lavoro basati sull’IA. Oxylabs continua inoltre a documentare separatamente la propria Classic Web Scraper API. Questa distinzione è importante per le integrazioni esistenti: i team che gestiscono la Classic API devono consultare la documentazione corrispondente, senza presumere che un esempio più recente per la Web API sia intercambiabile.
Oxylabs è la scelta più adatta quando la difficoltà di accesso alle fonti, il volume di dati da elaborare o il costo di gestione dell’infrastruttura di accesso giustificano il ricorso a una piattaforma gestita. L’applicazione deve comunque definire lo schema desiderato, l’intervallo di aggiornamento e la gestione dei record incompleti. Prima di avviare il servizio, occorre verificare che la generazione dell’API scelta, le opzioni per le fonti e il modello di utilizzo siano adeguati al lavoro effettivo. Per una piccola estrazione manuale, uno strumento di scraping visuale può essere più adatto.
Vantaggi e svantaggi
- Infrastruttura gestita per il rendering e l’accesso
- Opzioni di estrazione strutturata specifiche per obiettivo
- L’API Web attuale supporta le integrazioni con gli agenti
- Le API classiche e quelle attuali richiedono configurazioni distinte
- La qualità dei risultati richiede comunque verifiche a livello applicativo
10. Diffbot
Diffbot è la nostra scelta quando capire le informazioni presenti in una pagina è più importante che riprodurne l’impaginazione. Extract usa la visione artificiale e l’elaborazione del linguaggio naturale per classificare le pagine e generare JSON strutturato secondo schemi standard. Per un team che raccoglie articoli o prodotti da molte fonti, questo può ridurre la quantità di codice di analisi specifico per ciascun sito necessaria per trasformare le pagine in record confrontabili.
Il suo Knowledge Graph risponde a un’esigenza correlata, ma distinta: lavorare con entità come organizzazioni, persone e articoli già raccolti dal web pubblico. I record possono combinare informazioni provenienti da più fonti e collegare le entità attraverso relazioni significative. Questo rende Diffbot utile per arricchire i dati, svolgere ricerche aziendali e realizzare applicazioni di intelligence che richiedono un contesto più ampio dei campi visibili in una singola pagina.
Il compromesso riguarda l’aderenza al modello di dati di Diffbot. L’estrazione standardizzata è utile quando i tipi di pagina e i campi disponibili corrispondono alle esigenze del lavoro, ma un campo insolito o un’interazione specifica possono comunque richiedere un approccio diverso. I team dovrebbero distinguere l’estrazione dai propri URL selezionati dall’interrogazione di un grafo della conoscenza esistente, quindi valutare di conseguenza la copertura e l’aggiornamento delle fonti. Diffbot è più adatto ai team tecnici che realizzano prodotti informativi normalizzati che agli utenti che devono semplicemente copiare alcune righe in un foglio di calcolo.
Vantaggi e svantaggi
- La classificazione automatica riduce il lavoro necessario per creare parser
- Gli schemi standard aiutano a normalizzare pagine simili
- Il Knowledge Graph aggiunge contesto sulle entità
- I campi standard potrebbero non soddisfare esigenze specialistiche
- L’estrazione e l’accesso al grafo rispondono a flussi di lavoro diversi
Domande frequenti
Cosa rende uno strumento di scraping web basato sull’IA?
L’IA può aiutare a individuare i campi, interpretare i contenuti delle pagine, generare passaggi di estrazione o controllare le azioni del browser. Alcuni strumenti usano l’IA durante la configurazione, altri a ogni estrazione. Un servizio può anche supportare le applicazioni di IA fornendo contenuti puliti senza ricorrere a un modello linguistico per ogni richiesta. Scegli la funzionalità che risolve il tuo problema di raccolta, anziché affidarti all’etichetta.
Qual è la differenza tra scraping e automazione del browser?
Lo scraping raccoglie informazioni. L’automazione del browser esegue azioni sulle pagine, come aprire menu, inserire una ricerca o seguire un flusso di lavoro articolato in più passaggi. Spesso le due attività si affiancano: un browser automatizzato raggiunge lo stato della pagina pertinente, poi una fase di estrazione raccoglie i campi. Quando queste interazioni non sono necessarie, di solito è più semplice inviare una richiesta API diretta.
Quali strumenti sono più adatti a un team senza competenze tecniche?
Per la raccolta ricorrente di dati e il monitoraggio delle modifiche, se le esigenze sono semplici, la nostra prima scelta è Browse AI. Octoparse è un’ottima alternativa per i team che desiderano un maggiore controllo visivo sulle fasi dell’attività. Entrambi funzionano al meglio quando qualcuno verifica i record risultanti e sa riconoscere i cambiamenti nel sito web di origine.
Quali informazioni dovrebbe conservare una pipeline di IA o RAG dai dati raccolti?
Conserva l’URL di origine, l’ora della raccolta, il titolo della pagina e il testo o i campi strutturati necessari all’applicazione. Il formato Markdown può mantenere una struttura del documento leggibile, mentre JSON consente di definire i record. Rimuovi i contenuti duplicati ed evita di mescolare il testo di navigazione con il materiale principale. Conservare la provenienza facilita la tracciabilità e l’aggiornamento delle risposte successive.
Quando conviene usare un browser gestito?
Un browser gestito è utile quando la raccolta richiede l’esecuzione di JavaScript, diverse interazioni o la continuità della sessione e il team vuole evitare di ospitare processi del browser. Browserless è un’opzione mirata per il codice esistente basato su Puppeteer o Playwright. Per una singola pagina statica, una semplice API di recupero o di estrazione può richiedere meno risorse.
1.000 unità gratuite equivalgono a 1.000 scraping?
No. Unità e crediti seguono le regole specifiche di ciascun fornitore. Browserless calcola il consumo delle connessioni al browser in blocchi fino a 30 secondi, con un consumo aggiuntivo di unità per il traffico tramite proxy e la risoluzione dei CAPTCHA. Altri servizi applicano tariffe in base alle opzioni delle richieste, ai record o alle risorse di calcolo. Stima il flusso di lavoro completo, anziché equiparare le diverse quote gratuite.
Ci si può fidare del risultato di un’estrazione con l’IA senza verificarlo?
Una risposta JSON valida può comunque omettere un record o interpretare male un campo. Definisci i campi obbligatori, controlla i tipi e gli intervalli, esamina un campione delle pagine di origine e monitora le variazioni nel numero di record. Per le attività ricorrenti, prevedere esplicitamente gli stati di errore e i risultati vuoti è più utile che considerare ogni risposta un insieme di dati completo.
Considerazioni finali sugli strumenti di scraping web basati sull’IA
Bright Data è la nostra scelta migliore in assoluto per un programma ampio di raccolta di dati dal web, mentre Firecrawl è il punto di partenza ideale per trasformare le pagine web in contenuti pronti per l’IA. Scegli Apify quando gli strumenti riutilizzabili, le attività pianificate e le operazioni nel cloud sono elementi centrali del progetto.
Per i team aziendali, Browse AI rende semplice il monitoraggio ricorrente, mentre Octoparse offre agli utenti un metodo visivo per perfezionare attività di estrazione più complesse. SearchAPI è la scelta specializzata quando il risultato richiesto consiste in dati di ricerca strutturati.
Browserless si distingue per gli sviluppatori che desiderano eseguire browser gestiti utilizzando librerie di automazione familiari. ScrapingBee è un’ottima alternativa quando una richiesta di estrazione gestita si adatta meglio all’applicazione. Oxylabs è adatto alle esigenze più impegnative di recupero di dati dal web pubblico, mentre Diffbot si distingue per l’estrazione standardizzata e l’intelligenza sulle entità.
La scelta migliore nel lungo periodo è quella che fornisce le informazioni necessarie con un flusso di lavoro che il team può mantenere. Scegli il metodo di raccolta più adatto all’attività, conserva il contesto della fonte e valuta il valore in base ai risultati effettivamente utilizzabili, non al numero di pagine richieste.




