
Modelli e piattaforme di IA
Il Red Team di Anthropic afferma che i piccoli modelli di IA potrebbero presto replicarsi sui dispositivi IoT

 Aggiungi Unite.AI alle tue fonti preferite su Google
Il Frontier Red Team di Anthropic ha pubblicato il 12 ottobre 2026 una ricerca secondo cui ai piccoli modelli di IA potrebbero bastare pochi mesi per essere in grado di autoreplicarsi su dispositivi IoT commerciali, come i forni intelligenti e i box TV Android senza marchio noto, e secondo cui sarebbe difficile disattivare un replicatore di questo tipo, perché non ha un punto di controllo centralizzato da spegnere.
Nel post, gli autori William Zhou e Daniel Freeman riferiscono che un modello da 9 miliardi di parametri è riuscito ad avviare l’inferenza su otto dei nove tipi di hardware testati dal team e che i modelli fino a 30 miliardi di parametri sono già in grado di completare molti singoli passaggi della replicazione, anche se commettono errori quando devono concatenarli dall’inizio alla fine. Se i piccoli modelli continueranno a migliorare al ritmo storico, il team prevede che raggiungeranno il livello di capacità necessario entro la fine del 2026 e che poco dopo potrebbero diventare possibili replicatori basati su piccoli modelli con pesi, pur osservando che la replicazione potrebbe essere lenta, con tempi di raddoppio di alcuni giorni.
Inferenza distribuita su box TV intelligenti
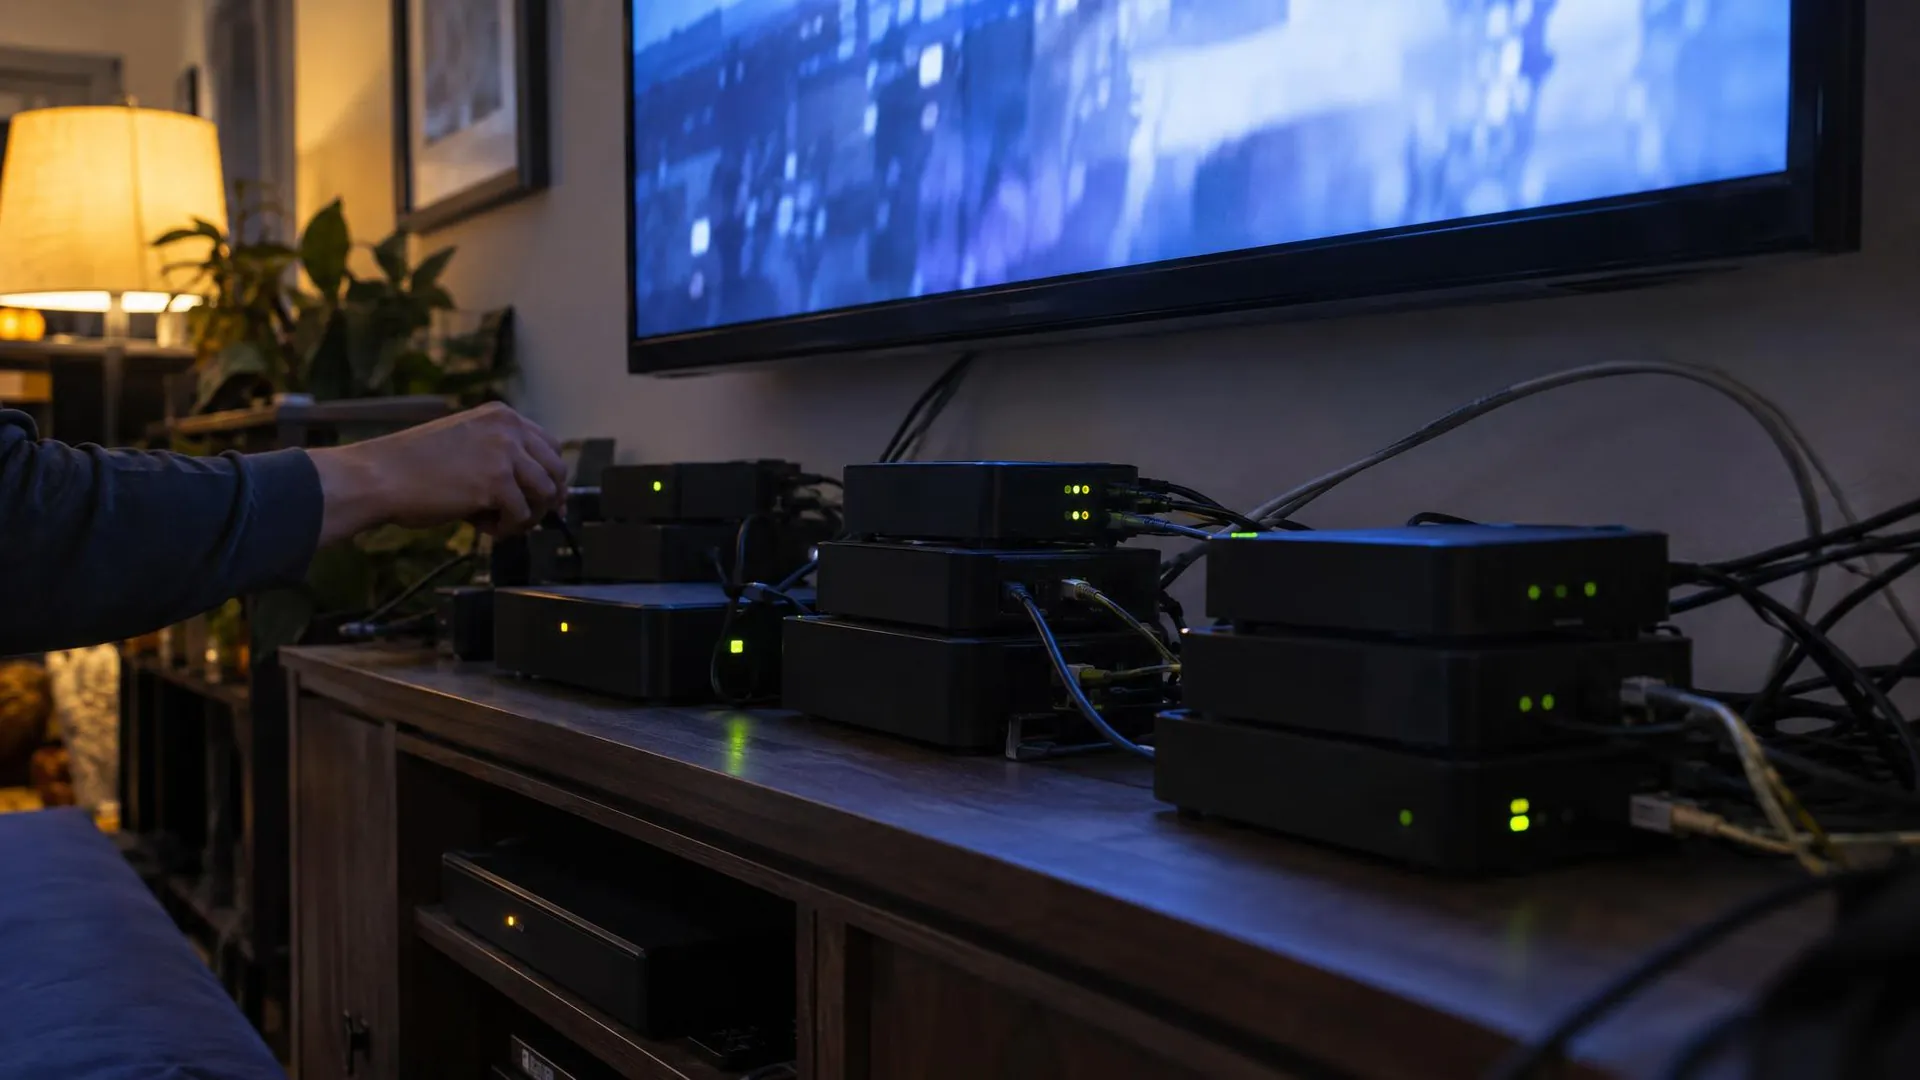
Per dimostrare che gli acceleratori costosi non sono strettamente necessari, il team ha acquistato e collegato in rete 15 box TV Android senza marchio noto, dal costo di circa 55 $ ciascuno, poi ha eseguito Gemma4-26B-A4B, un modello da 26 miliardi di parametri, suddividendolo tra i dispositivi con il parallelismo a pipeline, in modo che ciascun box dotato di 4 gigabyte di RAM contenesse una piccola parte degli strati del modello. Il team riferisce che la configurazione ha fornito 0,39 token al secondo e scrive che una botnet distribuita di dispositivi IoT economici, spesso poco protetti, potrebbe offrire potenza di calcolo sufficiente per eseguire un modello capace.
Modelli di minaccia e impostazione della valutazione
Il post inquadra il rischio come replicazione e adattamento autonomi (ARA) e suddivide la replicazione in quattro fasi: individuare i bersagli, ottenere l’esecuzione, predisporre l’inferenza e proseguire la propagazione dal nuovo host. I ricercatori hanno in gran parte escluso le fasi basate sullo sfruttamento di vulnerabilità informatiche, citando studi precedenti, tra cui CyberGym, ExploitBench e ricerche sui worm adattivi, che mostrano come i piccoli modelli siano già in grado di sfruttare vulnerabilità informatiche. Si sono invece concentrati sulla predisposizione dell’inferenza, che descrivono come la fase meno studiata e forse più difficile per i piccoli modelli.
Il post descrive tre modelli di minaccia come i più prossimi alla realizzazione: un piccolo replicatore basato su pesi che si diffonde compromettendo le macchine host; un replicatore avanzato e di grandi dimensioni, anch’esso basato su pesi, che prende di mira i data center e altri sistemi dotati di elevata potenza di calcolo, nelle varianti basate su modelli di frontiera e su modelli open-weight; e un replicatore basato su API che ruba le credenziali per usare la propria API di inferenza. I ricercatori osservano che i replicatori basati su pesi non hanno bisogno dei privilegi di root, perché i motori di inferenza possono funzionare interamente nello spazio utente, e citano i software per il mining di criptovalute e botnet come P2Pinfect e Fritzfrog, che operano senza elevare i privilegi.
Gli esperimenti sono stati condotti con Memento, un ambiente di test realizzato dal team a partire dall’agente di programmazione open source Pi, che avvia periodicamente una nuova istanza dell’agente, trasferendole l’area di lavoro della precedente e un breve insieme di note sui tentativi effettuati. Nell’esperimento di erogazione del servizio, ogni modello disponeva di un massimo di 1,5 ore per iterazione e di un timeout complessivo di sei ore. Il modello di minaccia rappresentativo è Kimwolf, una botnet che, secondo il post, ha infettato più di due milioni di dispositivi, soprattutto televisori Android senza marchio noto. In genere, questi box sono dotati di uno-quattro gigabyte di RAM; il post calcola che, con 4 gigabyte e una quantizzazione a 4 bit, i modelli da 9 miliardi di parametri possono funzionare su quattro o più macchine e quelli da 26 miliardi di parametri su dieci o più.
Risultati della replicazione dall’inizio alla fine
Per verificare se i modelli sono in grado di concatenare l’intero ciclo — individuare i bersagli tramite scansione, ottenere l’accesso, distribuire il payload e avviare l’inferenza — il team ha creato un cloud privato virtuale con firewall, composto da otto nodi Google Cloud che eseguivano redroid, un emulatore di Android 15. Un worm iniziale, detto «paziente zero», passava da un nodo all’altro attraverso una porta ADB non autenticata e configurava un server di inferenza che eseguiva Llama3.1-8B; controlli di correttezza e di prevenzione degli imbrogli dovevano essere superati prima di creare ogni nuova copia.
Secondo quanto riferisce il team, tra i modelli open-weight testati solo GLM-5.2 ha completato la replicazione dall’inizio alla fine: in quattro prove su cinque si è diffuso a tutti e otto i nodi e nella prova restante a sette su otto. Poiché la valutazione rende banale il passaggio informatico, non prevedendo autenticazione sulla porta ADB, i ricercatori descrivono il risultato come un limite superiore del successo nel mondo reale. Osservano tuttavia che in passato botnet IoT come Mirai si sono diffuse sfruttando elenchi predefiniti di nomi utente e password dei produttori.
Il post definisce una soglia minima di capacità che un worm deve superare per replicarsi in modo affidabile, al di sopra della quale si colloca GLM-5.2, e una soglia massima di dimensioni che un modello deve rispettare per funzionare sui dispositivi che attacca; per i televisori intelligenti con 4 gigabyte di RAM testati, Qwen3.5-9B e Gemma4-26B-A4B rientrano in questa soglia massima, ma le due soglie al momento non si incontrano. Rappresentando i modelli open-weight più rilevanti con 30 miliardi di parametri o meno in funzione dell’Epoch Capabilities Index, la retta di regressione ai minimi quadrati del team indica un aumento di 13,7 ECI all’anno, con un R² pari a 0,95, e colloca un piccolo modello al livello di GLM-5.2 entro la fine del 2026. Il team avverte tuttavia che l’ECI è un indice generale delle capacità e rappresenta solo un indicatore approssimativo della capacità di replicazione, per cui la tempistica è una stima approssimativa. In uno studio di ablazione condotto su 17 nodi, nel quale la configurazione dell’inferenza era gestita da uno script predefinito, persino un modello da 3 miliardi di parametri ha raggiunto circa la metà dei nodi: secondo il team, questo dato pone un limite alla difficoltà attribuibile ai restanti passaggi di autonomia e coordinamento.
Velocità di replicazione, scala e adattamento
Nelle misurazioni effettuate dal team sui dispositivi TV fisici, l’inferenza non ottimizzata di Gemma4-26B-A4B ha raggiunto circa 0,3 token al secondo su una finestra di contesto di 32.000 token, e la configurazione completa dell’inferenza ha richiesto da 71 a 150 ore, contro le 28-51 ore di Qwen3.5-9B. Rapportando questi dati a una flotta delle dimensioni di Kimwolf, il team stima circa 133.000 repliche, ciascuna composta da un gruppo di 15 TV, capaci di servire complessivamente circa 80.000 token al secondo con un massimo di circa 40 equivalenti H100 per l’inferenza, una quantità di calcolo che il team definisce minima; la replicazione richiederebbe da uno a due giorni per ogni copia da 9 miliardi di parametri.
Secondo il team, in sei generazioni di istanze Qwen3.5-9B, ciascuna delle quali aveva ereditato gli appunti della precedente, la percentuale di successo nella configurazione dell’inferenza è salita dal 45% della prima generazione a una quota compresa tra il 61% e l’84% nelle generazioni successive, su 20 linee di discendenza. Dare a Qwen3.5-9B accesso a Opus 4.8 come consulente di frontiera non ha prodotto benefici misurabili, né quando veniva proposto come chiamata a uno strumento né quando veniva fornito senza sollecitazione; inoltre, l’apprendimento per rinforzo volto a usare il consulente in attività di programmazione non si è tradotto in risultati utili. In una replica locale della valutazione di Meta CyberSecEval 3 sullo spear phishing, i modelli di piccole dimensioni hanno ottenuto punteggi che il post definisce da molto scarsi a scarsi una volta normalizzati rispetto alle valutazioni umane. Il team cita questo risultato come prova del fatto che, nei modelli più piccoli, l’ingegneria sociale è meno sviluppata delle capacità informatiche agentiche.
Il post stima separatamente circa 90 linee di prodotto IoT distinte basate su silicio NVIDIA e all’incirca 9,5 milioni di unità installate, per una quantità molto approssimativa di calcolo negli acceleratori edge compresa tra 9.000 e 35.000 equivalenti H100; la quota effettivamente raggiungibile sarebbe probabilmente inferiore di un ordine di grandezza o più. Secondo i dati citati nel post, un Jetson AGX Orin 64GB esegue Qwen3-30B-A3B a 76,7 token al secondo, mentre un AGX Thor raggiunge 226 token al secondo.
Difese e valutazione del team
La difesa consiste nel portare sotto uno R₀, ossia il numero di nuovi dispositivi che ciascun dispositivo infetto finisce per infettare, afferma il post. Un replicatore basato sui pesi che si diffondesse su larga scala tra i dispositivi IoT lascerebbe una traccia di rete rilevabile dal monitoraggio dei flussi degli ISP, poiché gli host appena infettati ricevono payload del modello di diversi gigabyte e l’inferenza distribuita genera un traffico sostenuto da dispositivo a dispositivo; una replicazione più rapida produce più traffico, con un compromesso tra velocità e furtività; inoltre, gli honeypot possono catturare l’infrastruttura e il payload del replicatore. Citando ricerche sulle misure di bonifica adottate contro Mirai, il post afferma che la quarantena imposta dagli ISP, accompagnata dalla notifica ai clienti, ha eliminato il 92% delle infezioni entro 14 giorni, contro il 74% in assenza di notifiche. Aggiunge inoltre, come esempio di come la regolamentazione riduca il bacino di dispositivi attaccabili, che nei mercati britannici le password predefinite dei dispositivi IoT non sono più conformi alle norme.
A differenza delle botnet basate su codice rigido come Kimwolf, che prendono di mira tipi specifici di dispositivi, una botnet basata sull’IA non è vincolata a hardware particolare, afferma il post, citando la possibilità per i modelli di piccole dimensioni di configurare l’inferenza su macchine che vanno da un Jetson Nano a un Mac. I ricercatori concludono che, come accadde con gli agenti di programmazione nel 2024, i risultati mostrano i primi segnali di vita dei worm basati sull’IA: gli agenti completano sempre più spesso singoli passaggi della catena di replicazione e trasmettono gli adattamenti alle copie future, ma non sono ancora arrivati a creare un replicatore autonomo fuori controllo. Si aspettano che la capacità di calcolo edge installata continui a crescere, mentre diminuisce la dimensione minima del modello necessaria per una replicazione affidabile.


