
Wawancara
Fabiana Clemente, Co-founder dan Chief Data Officer di YData – Seri Wawancara

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
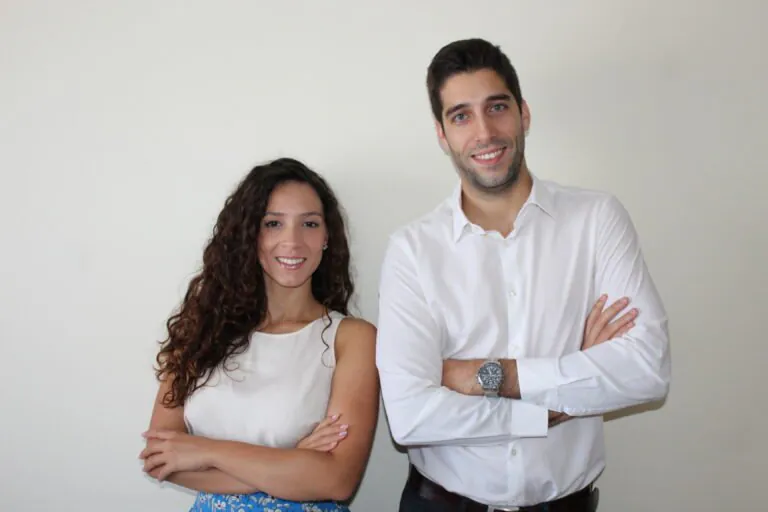
Fabiana Clemente adalah Co-founder dan Chief Data Officer di YData. YData adalah sebuah startup AI yang menciptakan solusi pengembangan data-centric pertama untuk menggabungkan penemuan data, perbaikan, dan skala dalam satu platform.
Apa yang awalnya menarik Anda ke AI dan machine learning?
Latar belakang saya adalah Matematika Terapan, di mana saya memiliki kesempatan untuk mempelajari dan memahami bagaimana kita dapat mengekstrak informasi dari data serta melakukan itu dengan menggunakan kode. Pada saat itu, itu tidak sepopuler Machine Learning, tetapi itu pasti memicu minat saya di bidang tersebut.
Bagaimana cerita di balik Ydata?
Sebagai Ilmuwan Data yang telah bekerja untuk startup dan perusahaan, saya memiliki pengalaman yang cukup untuk menghadapi kesulitan – terkadang akses ke data diblokir dengan alasan keamanan atau privasi, dan terkadang akses mudah tetapi kualitas data tidak memadai untuk membangun solusi berbasis AI. Mengetahui bahwa kesulitan ini sangat umum di sebagian besar organisasi, menginspirasi kami untuk memulai perusahaan dengan tujuan membantu tim-tim ini mengatasi hambatan tersebut dengan mempercepat pengembangan AI mereka dengan data yang diperbaiki.
Bagaimana Anda menjelaskan data sintetis kepada audiens kita?
Data sintetis dianggap sebagai data yang tidak dihasilkan di dunia nyata, sehingga data yang dibuat secara artifisial. Terdapat metode yang memungkinkan pembuatan data sintetis – dari strategi berbasis aturan hingga menggunakan model Machine atau Deep Learning untuk mempelajari “aturan” tersebut. Di YData, kami mengadopsi dan mengkhususkan diri dalam strategi berbasis Deep Learning untuk menghasilkan data baru yang mempertahankan perilaku dari peristiwa dunia nyata tanpa kekhawatiran seputar privasi.
Apa yang membuat data sintetis sangat penting?
Seiring dengan semakin banyak organisasi yang menyadari pentingnya data untuk meningkatkan bisnis mereka, maka pentingnya dan peran data sintetis akan semakin dipahami. Mengumpulkan data nyata tidak hanya memakan waktu dan biaya, tetapi juga terkadang mustahil. Untuk membangun aplikasi AI, data adalah persyaratan yang keras – di sinilah data sintetis datang untuk menyelamatkan. Kemampuan untuk menghasilkan skenario yang tidak terlihat atau untuk membuka akses ke data adalah kunci untuk berkembang di dunia di mana pelopor seperti Andrew Ng menyatakan bahwa menjadi data-centric adalah kunci untuk adopsi AI yang sukses.
Di mobil self-driving atau kegiatan otomatisasi mesin lainnya, kita sudah dapat melihat pentingnya data sintetis, sehingga saya akan mengatakan bahwa itu hanya wajar bahwa pemahaman ini menyebar ke semua vertikal industri.
Bagaimana Ydata menghasilkan data sintetis?
YData menggunakan terutama model Deep Generative untuk mempelajari atribut statistik dan korelasi antara variabel dari data asli. Ini memungkinkan model untuk menghasilkan dataset yang relevan secara statistik yang memiliki nilai bisnis yang sama dengan yang asli, tanpa memungkinkan pelacakan ke catatan asli.
YData mendorong teknologi ini maju dan merupakan perusahaan di balik Komunitas Data Sintetis – sebuah grup ahli ilmu data yang berkomitmen untuk mengajarkan dan membantu siapa pun yang ingin mempelajari dan menggunakan teknologi ini.
Bagaimana platform Ydata membantu menemukan dan membuka sumber data baru?
Platform YData mencakup konektor bawaan ke berbagai jenis database, gudang data, atau danau data, yang memungkinkan pengguna untuk dengan mudah mendapatkan akses ke metadata yang relevan dan memahami apakah data yang ada berguna untuk menjawab pertanyaan bisnis yang mereka hadapi – tanpa harus melihat catatan asli.
Bagaimana Anda dapat membagikan beberapa detail tentang Komunitas Data Sintetis Sumber Terbuka?
Data sintetis masih dalam hari-harinya yang awal, dan karena itu, kesadaran tentang bagaimana data tersebut dihasilkan, manfaatnya, atau keterbatasannya masih belum diketahui oleh audiens yang lebih luas. Oleh karena itu, di YData, kami telah memutuskan untuk mengambil rute pendidikan dengan menciptakan Komunitas Data Sintetis – selain menjadi tempat untuk bertukar ide atau mendapatkan bantuan dari ahli di bidang data sintetis, ini juga merupakan tempat di mana ilmuwan data dan profil teknis lainnya dapat memulai perjalanan mereka ke data sintetis, dengan beberapa algoritma paling menarik dari literatur.
Kami juga menawarkan perspektif tentang kualitas data, sehingga ilmuwan data dapat memahami data yang mereka kerjakan sebelum mensintesis atau memperbaiki sintesis data. Kami benar-benar berkomitmen untuk membantu tim data menjadi lebih dan lebih data-centric.
YData baru-baru ini mengumumkan $2,7 juta dalam pendanaan untuk mempercepat ekspansi internasional. Bagaimana Anda dapat membagikan beberapa detail tentang apa yang ini berarti untuk masa depan perusahaan dan strategi ekspansi?
YData lahir internasional – kami tahu bahwa teknologi ini memerlukan pengadopsi awal yang biasanya berada di negara-negara paling maju. Oleh karena itu, pelanggan pertama kami sudah berada di luar Portugal, di seluruh Eropa, dan sekarang kami sedang membangun kehadiran di Amerika Utara juga. Pendanaan ini akan memungkinkan kami untuk memperkuat kehadiran kami di kedua benua ini, tidak hanya secara komersial tetapi juga untuk tumbuh sebagai tim: kami adalah tim yang sepenuhnya terdistribusi, yang memungkinkan kami untuk merekrut bakat terbaik, di mana pun mereka berada.
Apakah ada yang lain yang Anda ingin bagikan tentang YData?
YData mendorong batas AI yang berorientasi pada data dan menciptakan kategori baru: DataPrepOps – meskipun itu nama yang tidak enak, itu adalah nyeri yang sebagian besar perusahaan hadapi saat ini ketika datang ke pengembangan ilmu data. Trend Kualitas Data terus tumbuh dan setelah Pipa Data dan Pengamatan Data, Kualitas Data untuk Tim Ilmu Data masih dalam masa bayi dan YData muncul sebagai pemimpin pemikiran di bidang persiapan data.
Terima kasih atas wawancara yang luar biasa, pembaca yang ingin mempelajari lebih lanjut harus mengunjungi YData.


