
Dasar-dasar AI
Apa Itu Pengakuan Ucapan Konversasional (CSR)?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Pengakuan ucapan konversasional (CSR) memperluas pengenalan ucapan otomatis di luar transkripsi terisolasi dengan memanfaatkan konteks dialog, sinyal pengambilan giliran, informasi pembicara, dan pemrosesan berlatensi rendah. Tujuannya adalah mendukung interaksi langsung di mana kata‑kata, timing, interupsi, dan giliran sebelumnya semuanya penting.
CSR merupakan label produk dan riset yang sedang berkembang, bukan satu kelas model standar tunggal. Sistem yang kuat menggabungkan ASR streaming dengan penentuan akhir (endpointing), penanganan pembicara, pemodelan bahasa kontekstual, status dialog, dan kebijakan respons, kemudian mengevaluasi pengalaman secara menyeluruh.
Poin Penting
- Pengakuan streaming mengeluarkan hipotesis sementara dan memperbaikinya seiring lebih banyak audio tiba.
- Penentuan akhir dan prediksi giliran terpisah dari akurasi transkripsi.
- Riwayat percakapan dan kata kunci dapat meningkatkan pengenalan namun juga menyebarkan kesalahan sebelumnya.
- Evaluasi latensi, interupsi, pembicara, aksen, kebisingan, privasi, dan penyelesaian tugas—bukan hanya tingkat kesalahan kata.
Dari ASR ke Dialog Langsung
ASR tradisional memetakan audio ke teks. Sistem konversasional harus menentukan kapan harus mendengarkan, kapan sebuah giliran selesai, apakah ucapan ditujukan kepada sistem, dan bagaimana memulihkan ketika transkrip atau responsnya salah.
Model streaming memproses frame secara bertahap dan menghasilkan transkrip parsial. Latensi rendah meningkatkan responsif, namun komitmen prematur dapat menambah revisi atau kesalahan. Aplikasi memerlukan kebijakan untuk membedakan teks stabil versus sementara.
Pengambilan Giliran, Overlap, dan Pembicara
Durasi keheningan saja merupakan sinyal akhir yang lemah. Penyelesaian leksikal, prosodi, timing, tatapan, dan status dialog dapat membantu memprediksi apakah seseorang masih memegang atau melepaskan giliran. Barge‑in memungkinkan pengguna menyela ucapan sintetis tanpa kehilangan konteks.
Suara yang tumpang tindih dan diarization masih sulit. Sistem harus mempertahankan ketidakpastian pembicara, menghindari mengaitkan pernyataan dengan orang yang salah, dan menyediakan jalur koreksi—terutama untuk catatan yang digunakan dalam bidang kesehatan, keuangan, atau pekerjaan hukum.
Pengakuan Kontekstual
Giliran sebelumnya dapat menghilangkan ambiguitas nama dan referensi; daftar kata kunci dapat memihak pengenalan ke istilah domain. Model bahasa ucapan dapat mengkodekan konteks audio dan teks dalam kerangka prompting atau attention bersama.
Konteks juga dapat memperkuat transkrip sebelumnya yang keliru atau bocorkan informasi antar sesi. Batasi riwayat pada tujuan saat ini, pisahkan metadata tepercaya dari ucapan pengguna, dan gunakan konteks transformer dengan aturan retensi dan akses yang eksplisit.
Evaluasi dan Penerapan Bertanggung Jawab
Laporkan word error rate streaming, latensi token pertama dan finalisasi, tingkat revisi, kesalahan endpoint, keberhasilan barge‑in, atribusi pembicara, dan penyelesaian tugas. Uji mikrofon nyata, kebisingan, aksen, pergantian bahasa, disabilitas, dan ucapan yang sarat emosi.
Data suara dapat mengidentifikasi atau mengungkap informasi sensitif. Terapkan persetujuan, minimisasi, enkripsi, batas retensi, dan tinjauan manusia. Hubungkan balasan yang dihasilkan ke kontrol keamanan chatbot, karena transkripsi yang akurat tidak menjamin responsnya benar atau berwenang.
Dari Input Akustik ke Status Konversasional
Sistem ucapan konversasional menangkap audio, menerapkan pengkondisian sinyal, mendeteksi ucapan, mengenali kata atau unit semantik, mengidentifikasi pembicara bila diperlukan, dan memperbarui status dialog. Sistem streaming menghasilkan hipotesis parsial sebelum ujaran selesai. Hipotesis tersebut dapat berubah, sehingga komponen hilir harus membedakan hasil sementara dari hasil final.
Deteksi aktivitas suara dan penentuan akhir menentukan kapan ucapan dimulai dan kapan pengguna selesai. Ambang keheningan tetap gagal pada pembicara lambat, kebisingan latar, dan jeda berpikir. Model pengambilan giliran dapat menggunakan kata, prosodi, tatapan, dan konteks dialog, namun harus menyeimbangkan respons cepat dengan menghindari memotong pembicara.
Diarization menjawab siapa yang berbicara kapan; pengenalan pembicara memperkirakan identitas; pemisahan sumber memisahkan suara yang tumpang tindih. Ini adalah tugas yang berbeda dengan risiko yang berbeda. Dalam rapat, layanan kesehatan, dan layanan pelanggan, mengaitkan kata yang tepat dengan orang yang tepat dapat sama pentingnya dengan word error rate transkrip.
Konteks, Overlap, Emosi, dan Pemulihan Interaksi
Konteks konversasional menyelesaikan pronomina, elipsis, koreksi, istilah domain, dan referensi ke giliran sebelumnya. Sistem dapat menggabungkan bukti akustik dengan riwayat dialog dan pengetahuan yang diambil, namun konteks sebelumnya juga dapat memihak pengenalan pada harapan yang keliru. Pertahankan bukti audio dan kepercayaan sehingga konteks tidak diam‑diam menimpa ketidakpastian.
Dialog alami mencakup backchannel, interupsi, permulaan palsu, tawa, pergantian bahasa, dan ucapan simultan. Agen yang responsif memerlukan penanganan barge‑in: menghentikan atau menurunkan outputnya, menangkap ucapan baru pengguna, memutuskan apakah interupsi mengubah niat, dan pulih tanpa menggandakan atau kehilangan aksi.
Prosodi dan sinyal paralinguistik dapat menunjukkan penekanan atau ketidakpastian, namun menafsirkan emosi, kesehatan, atau niat dari suara rawan kesalahan dan bergantung pada budaya. Gunakan perkiraan tersebut secara hati‑hati, ungkapkan bila relevan, dan jangan membuat keputusan penting berdasarkan label emosi yang belum divalidasi.
Evaluasi, Privasi, dan Desain Produksi
Word error rate tetap berguna, namun evaluasi konversasional juga harus mengukur atribusi pembicara, akurasi entitas, keberhasilan tugas semantik, stabilitas hipotesis parsial, latensi endpoint, keberhasilan interupsi, pemulihan, dan tingkat koreksi pengguna. Segmentasikan berdasarkan aksen, bahasa, perangkat, kebisingan, overlap, gaya bicara, dan kondisi jaringan.
Arsitektur streaming memerlukan buffer terbatas, backpressure, penyambungan ulang, nomor urut, dan finalisasi eksplisit. Jaga anggaran latensi model dan dialog terpisah, lacak setiap tahap, dan uji jaringan yang menurun. Ketika sistem memicu aksi, konfirmasikan niat berdampak tinggi dan buat percobaan ulang idempotent sehingga audio berulang atau penyambungan ulang tidak menggandakan transaksi.
Ucapan mengandung identitas, konten, lingkungan, dan informasi orang di sekitar. Minimalkan retensi, enkripsi transport dan penyimpanan, kontrol akses, definisikan penghapusan, dan bedakan audio dari transkrip serta embedding yang dihasilkan. Sediakan indikator perekaman yang terlihat dan alternatif bila persetujuan tidak ada. Model lokal dapat mengurangi transfer namun tetap memerlukan izin serta kontrol siklus hidup.
Contoh Praktis: Agen Suara Menangani Interupsi dan Koreksi
Seorang penelepon mengatakan, ‘Pesan Selasa—tidak, Rabu sore,’ sementara agen mulai merespons setelah kata ‘Selasa.’ Pengakuan streaming mengeluarkan transkrip parsial yang berubah, endpointing mendeteksi ucapan yang berlanjut, dan barge‑in menghentikan output. Status dialog menandai tanggal sebelumnya sebagai digantikan alih‑alih membuat dua permintaan. Konfirmasi entitas berfokus pada tanggal dan waktu yang telah dikoreksi, sementara sistem mempertahankan kepercayaan dan bukti untuk interpretasi akhir.
Arsitektur memisahkan penangkapan audio, deteksi ucapan, pengakuan streaming, penanganan pembicara, kebijakan dialog, eksekusi alat, dan sintesis. Nomor urut dan finalisasi mencegah hasil parsial terlambat menimpa transkrip akhir. Alat pemesanan menerima permintaan terstruktur, memeriksa otorisasi dan ketersediaan, serta menggunakan kunci idempotensi. Pemesanan yang penting dibaca kembali dan dikonfirmasi sebelum dieksekusi; penyambungan ulang tidak dapat diam‑diam mengulanginya.
Pengujian menggabungkan akurasi kata dan entitas dengan latensi endpoint, keberhasilan interupsi, penanganan koreksi, atribusi pembicara, penyelesaian tugas, dan tingkat aksi duplikat. Skenario mencakup kebisingan, overlap, aksen, pergantian bahasa, ucapan lambat, perangkat bantu, jaringan lemah, dan serangan sintetis. Retensi audio diminimalkan dan diungkapkan, data orang di sekitar ditangani secara eksplisit, dan pengguna dapat beralih ke teks atau manusia. Kecerdasan konversasional diukur melalui pemulihan aman dan hasil, bukan hanya akurasi transkrip.
Daftar Periksa Implementasi Praktis
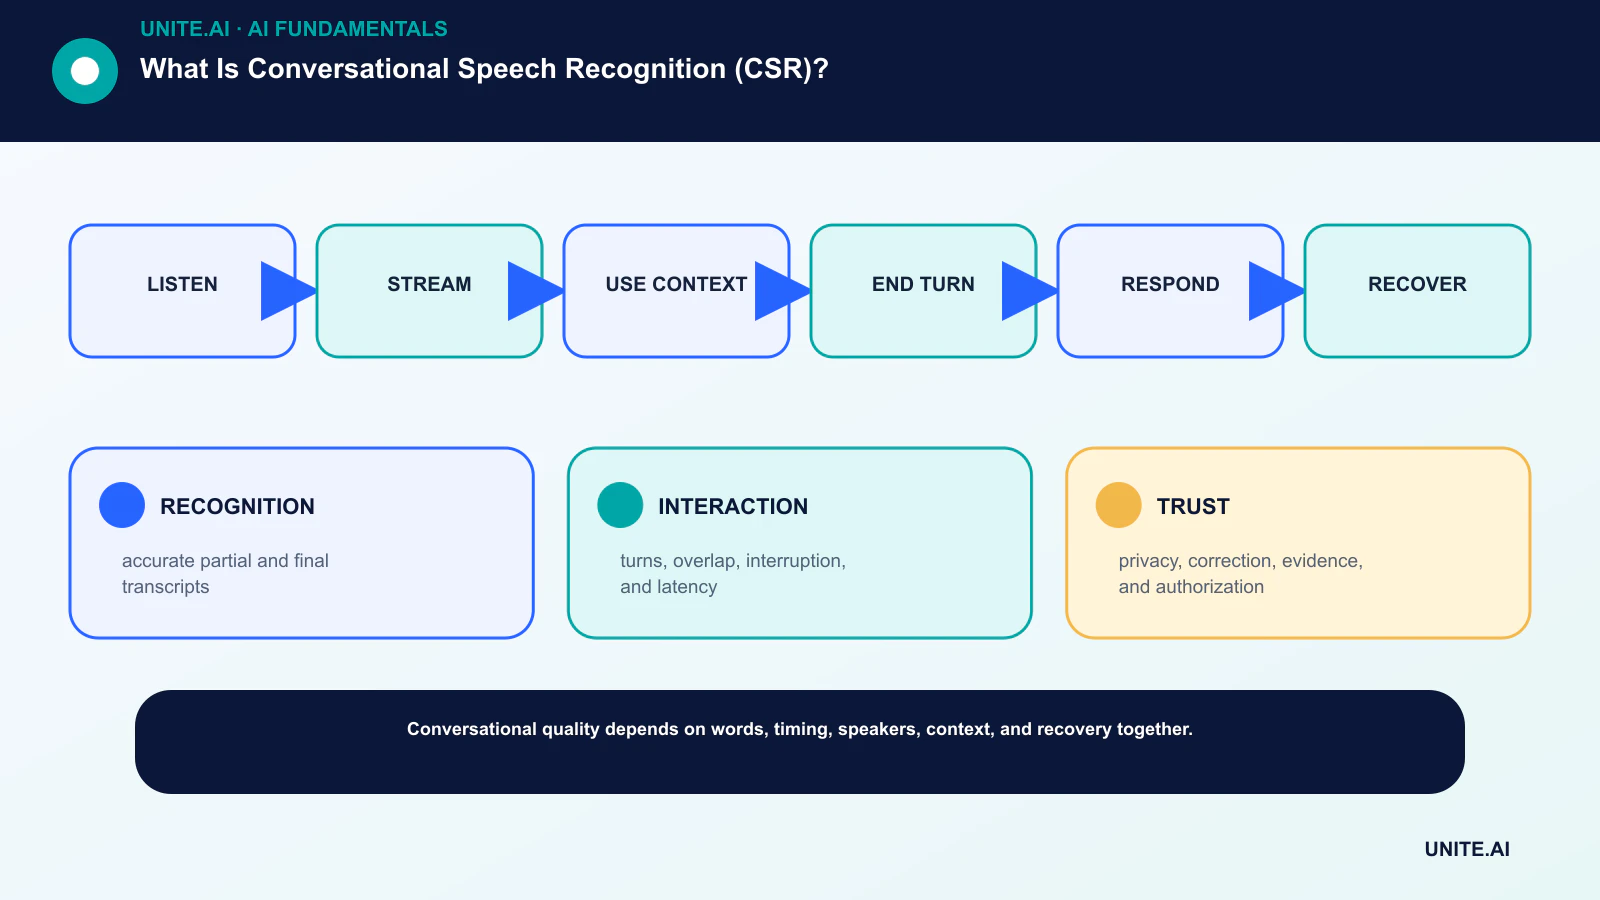
Ubah konsep menjadi alur kerja yang terbatas dan dapat diuji: dengarkan → streaming → gunakan konteks → akhiri giliran → respons → pulihkan. Tentukan pemilik yang bertanggung jawab, dokumentasikan data dan ketergantungan, buat baseline sederhana, tetapkan kriteria penerimaan dan penghentian, uji kegagalan representatif, dan definisikan pemantauan, rollback, serta tinjauan sebelum memperluas ruang lingkup. Catat versi dan asumsi agar tim lain dapat mereproduksi hasil dan memahami apa yang berubah.
Sebelum peluncuran, lakukan tinjauan kesiapan terdokumentasi bersama orang yang membangun, mengoperasikan, mengamankan, dan terdampak oleh sistem. Uji kasus normal, kondisi batas, kegagalan ketergantungan, dan penyalahgunaan; simpan bukti dan risiko yang belum terselesaikan. Tentukan siapa yang dapat menyetujui rilis, mengubah ambang, menimpa output, atau menghentikan operasi. Tinjau kembali keputusan setelah data dunia nyata muncul, karena pilot yang secara teknis berhasil tidak menjamin kinerja andal pada skala lebih luas.
- PENGENALAN: transkrip parsial dan final yang akurat.
- INTERAKSI: giliran, overlap, interupsi, dan latensi.
- KEPERCAYAAN: privasi, koreksi, bukti, dan otorisasi.
Pertanyaan yang Sering Diajukan
Apakah CSR berbeda dari ASR?
ASR adalah komponen speech‑to‑text. CSR menggunakan ASR ditambah konteks dialog, timing, penanganan pembicara dan endpoint, serta kebijakan interaksi untuk percakapan langsung.
Apakah word error rate yang lebih rendah menjamin agen suara yang lebih baik?
Tidak. Sebuah sistem dapat mentranskripsi dengan akurat namun tetap menyela pengguna, merespons lambat, salah mengaitkan pembicara, atau mengambil tindakan yang salah. Metrik interaksi end‑to‑end diperlukan.
Referensi Utama












