
Terbaik
10 Alat Scraping Web Berbasis AI Terbaik (November 2026)

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Unite.AI dapat menerima kompensasi saat Anda memakai tautan ke produk yang kami ulas. Hal ini tidak memengaruhi penilaian editorial kami. Baca pengungkapan afiliasi kami.
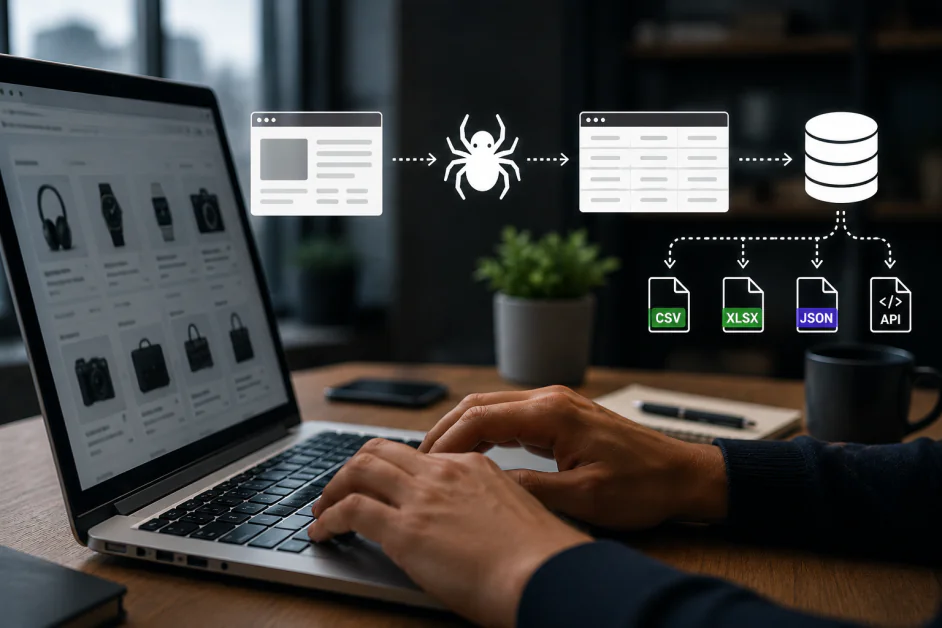
Alat scraping web berbasis AI terbaik bergantung pada apa yang ingin Anda lakukan setelah halaman dimuat. Asisten riset membutuhkan konten yang mudah dibaca dan tautan ke sumber. Sistem intelijen pasar membutuhkan data yang konsisten dalam skala besar. Agen interaktif mungkin memerlukan peramban yang dapat menavigasi beberapa langkah sekaligus dan mempertahankan sesinya.
Panduan ini membahas sepuluh alat untuk berbagai kebutuhan tersebut, termasuk platform pengumpulan data untuk perusahaan, API konten, alat scraping tanpa kode, layanan data penelusuran, dan peramban terkelola. Kami menilai cara setiap produk mengumpulkan informasi, siapa yang dapat mengelola alur kerjanya, serta kompromi yang perlu dipertimbangkan ketika prototipe mulai digunakan secara rutin.
Tim kami mengevaluasi setiap solusi dalam panduan ini secara independen dengan menilai kapabilitas, keunggulan praktis, keterbatasan, dan kesesuaiannya untuk berbagai kebutuhan yang tercermin dalam pemeringkatan kami.
Perbandingan Alat Scraping Web Berbasis AI Terbaik
| Alat AI | Terbaik untuk | Keunggulan utama |
|---|---|---|
| Bright Data | Pengumpulan data untuk perusahaan dan beragam alur data | API Scraper, Browser API, Scraper Studio, himpunan data, proksi |
| Firecrawl | Konten web untuk aplikasi AI | Penelusuran, scraping, pemetaan, perayapan, Markdown, JSON, Interact, MCP |
| Apify | Pekerjaan scraping yang dapat digunakan kembali dan orkestrasi cloud | Actors, Crawlee, jadwal, penyimpanan, proksi, API, MCP |
| Browse AI | Pengumpulan data tanpa kode dan pemantauan perubahan | Penyiapan berbantuan AI, robot, peringatan, jadwal, integrasi |
| SearchAPI | Hasil penelusuran terstruktur dan riset lokal | Google, Maps, belanja, video, kanal pencarian AI, JSON |
| Octoparse | Scraping visual dengan eksekusi cloud yang dapat diulang | Templat, Asisten AI, deteksi otomatis, proses cloud, ekspor |
| Browserless | Peramban terkelola untuk Puppeteer dan Playwright | Peramban yang dihosting, sesi persisten, API REST, MCP |
| ScrapingBee | Ekstraksi terkelola melalui API aplikasi | Ekstraksi AI, CSS/XPath, Markdown, skenario JS, MCP |
| Oxylabs | Pengambilan data terkelola dari situs web publik yang sulit diakses | Web API /Scrape, perenderan, keluaran terstruktur, MCP |
| Diffbot | Ekstraksi otomatis dan intelijen entitas | Ekstrak, skema standar, Crawl, Knowledge Graph |
Cara Memilih Alat Scraping Web Berbasis AI
Sesuaikan alat dengan pekerjaan
Untuk basis pengetahuan AI, prioritaskan teks yang mudah dibaca, keluaran terstruktur, dan URL sumber yang dipertahankan. Untuk riset bisnis yang dilakukan berulang, robot visual dan peringatan perubahan mungkin lebih penting daripada antarmuka pemrograman. Untuk agen interaktif, perhatikan kesinambungan sesi dan kendali peramban. API hasil penelusuran menangani kebutuhan yang berbeda: API ini menyediakan data penelusuran, sedangkan pengumpulan halaman yang ditautkan merupakan langkah terpisah.
Tentukan siapa yang mengelola alur kerja
Platform tanpa kode memungkinkan analis menyesuaikan langkah ekstraksi secara langsung. API menyediakan antarmuka yang mudah digunakan pengembang untuk mengintegrasikan pengumpulan data ke dalam aplikasi. Platform pekerjaan cloud menambahkan penjadwalan dan penyimpanan, sedangkan peramban terkelola membuat tim Anda menangani lebih banyak logika otomatisasi. Pilihan yang tepat menempatkan pemeliharaan di tangan orang-orang yang memahami situs web sumber sekaligus keluaran yang dibutuhkan.
Anggarkan biaya berdasarkan data yang berguna, bukan jumlah permintaan yang diiklankan
Bandingkan biaya penyelesaian pekerjaan dengan bidang data yang Anda butuhkan. Perenderan, proksi premium, durasi penggunaan peramban, ekstraksi AI, penyimpanan, dan percobaan ulang dapat memengaruhi total biaya. Kredit gratis, unit peramban, dan permintaan penelusuran adalah ukuran yang berbeda. Untuk pekerjaan rutin, pantau kelengkapan, data duplikat, kemutakhiran, dan biaya per data yang dapat digunakan, selain jumlah respons yang berhasil.
10 Alat Scraping Web Berbasis AI Terbaik
1. Bright Data
Bright Data adalah rekomendasi utama kami bagi organisasi yang membutuhkan beberapa cara untuk memperoleh data web dalam satu platform. Pilihannya mencakup API Scraper siap pakai, himpunan data yang telah dikumpulkan, Scraper Studio, Web Unlocker, dan layanan proksi. Sebagai contoh, tim intelijen e-commerce dapat menggunakan umpan data terstruktur untuk peritel yang sudah dikenal sekaligus membangun pengumpulan khusus untuk pasar khusus. Cakupan yang luas ini menjadikannya sangat berguna ketika program data melampaui satu situs web atau satu departemen.
Untuk halaman interaktif, Browser API menyediakan browser yang dapat dikendalikan pengembang dengan Puppeteer, Playwright, atau Selenium. Layanan ini menggabungkan pengoperasian browser dengan pengelolaan proxy dan penanganan CAPTCHA, sementara dukungan Chrome DevTools membantu teknisi memeriksa sesi yang bermasalah. Fitur ini berguna ketika alur kerja perlu menavigasi halaman atau berinteraksi dengannya sebelum informasi yang dibutuhkan tersedia, bukan sekadar mengunduh kumpulan data yang sudah ada.
Kompromi utamanya terletak pada pemilihan produk dan pengelolaan biaya. Lalu lintas browser, hasil scraping, dan pembelian kumpulan data merupakan jenis beban kerja yang berbeda, sehingga satu harga utama tidak dapat menggambarkan keseluruhan platform. Bright Data cocok untuk tim yang memiliki penanggung jawab atas kualitas pengumpulan, cakupan target, dan pengeluaran. Proyek dengan cakupan sempit mungkin dapat diterapkan ke lingkungan produksi lebih cepat dengan API ekstraksi yang lebih sederhana.
Kelebihan dan Kekurangan
- Beragam opsi pengumpulan dalam satu platform
- Browser yang dihosting mendukung pustaka otomatisasi yang sudah mapan
- API dan kumpulan data siap pakai mempercepat penyiapan
- Produk yang berbeda memerlukan perencanaan biaya terpisah
- Jalur pemrosesan khusus tetap memerlukan penanggung jawab teknis
2. Firecrawl
Firecrawl menjadi pilihan kami bagi pengembang yang ingin mengubah konten web menjadi konteks yang berguna untuk aplikasi AI. Fitur pencarian, scraping, pemetaan, dan perayapannya mencakup seluruh proses, dari menemukan halaman hingga mengumpulkan data dari sebuah situs web. Markdown dan JSON terstruktur mengurangi pekerjaan pembersihan setelah pengambilan data. Dengan demikian, asisten riset atau produk basis pengetahuan dapat lebih berfokus menjawab pertanyaan dan tidak perlu banyak menghapus menu navigasi dari HTML mentah.
Fitur Interact yang kini tersedia memperluas platform ini hingga mencakup pengoperasian browser secara langsung. Agen dapat menjelaskan tindakan dalam bahasa alami atau menjalankan kode browser, mempertahankan status di antara pemanggilan, serta menggunakan kembali profil yang telah diautentikasi. Fitur ini merupakan tambahan penting untuk halaman yang mengharuskan pengguna mengeklik, menggunakan filter, atau masuk sebelum data dapat diekstrak. Akses melalui MCP dan baris perintah juga membuat Firecrawl praktis digunakan dalam alur kerja pengembangan agen, bukan hanya sebagai API aplikasi konvensional.
Firecrawl paling cocok ketika pengambilan konten menjadi kebutuhan mendesak dan aplikasi sudah memiliki sistem penyimpanan serta pengambilan data sendiri. Tim tetap perlu menentukan batas perayapan, menyimpan URL sumber, dan membedakan kolom yang tidak ditemukan dari kolom yang kosong. Kode sumber terbukanya menyediakan opsi penerapan lain, tetapi tim sebaiknya mengevaluasi fitur spesifik dan kebutuhan operasional dari opsi penerapan yang dipilih, alih-alih menganggap versi yang dihosting dan dikelola sendiri identik.
Kelebihan dan Kekurangan
- Markdown dan JSON cocok untuk alur pemrosesan AI
- Interact mendukung tugas browser yang mempertahankan status
- Akses melalui API, MCP, dan CLI
- Konten yang diambil tetap perlu divalidasi
- Penerapan yang dikelola sendiri memerlukan pekerjaan operasional
3. Apify
Apify adalah pilihan terkuat di sini bagi tim yang menginginkan alat scraping yang dapat digunakan kembali sekaligus platform untuk mengoperasikannya. Marketplace-nya menyediakan Actors, yaitu program siap pakai yang menerima masukan, berjalan di cloud, dan menghasilkan data. Actors yang sudah tersedia dapat mempercepat tugas pengumpulan data yang umum, sementara Actors khusus memungkinkan pengembang mempertahankan logika ekstraksi mereka sendiri. Dengan begitu, Apify menjadi penghubung yang berguna antara eksperimen dan pekerjaan produksi yang dapat diulang.
Platform ini juga menangani berbagai kebutuhan operasional penting, termasuk penjadwalan, penyimpanan hasil, akses proxy, pemantauan, dan integrasi. Pengembang juga dapat membuat solusi dengan Crawlee, pustaka sumber terbuka untuk perayapan dan otomatisasi browser. Server MCP Apify menyediakan Actors bagi agen AI, sehingga alat siap pakai yang sama dapat digunakan oleh aplikasi, jalur pemrosesan terjadwal, atau asisten tanpa perlu membuat implementasi scraper terpisah untuk setiap antarmuka.
Pemilihan Actor sama pentingnya dengan pemilihan platform. Harga, pemeliharaan, opsi masukan, dan kualitas keluaran dapat berbeda-beda tergantung penerbitnya. Keberhasilan suatu proses juga tidak membuktikan bahwa semua rekaman yang diharapkan telah terkumpul. Apify paling bermanfaat ketika ada pihak yang bertanggung jawab atas skema pekerjaan, memantau perubahan, dan menganggarkan biaya Actor serta penggunaan infrastruktur yang dipilih; ekstraksi manual satu halaman biasanya tidak memerlukan orkestrasi sebanyak ini.
Kelebihan dan Kekurangan
- Actors siap pakai dan khusus tersedia di satu platform
- Penjadwalan, penyimpanan, dan pemantauan mendukung pekerjaan yang dapat diulang
- MCP mengintegrasikan Actors ke dalam alur kerja agen
- Pemeliharaan dan kualitas Actor bervariasi
- Biaya penggunaan dan Actor perlu dianggarkan
4. Browse AI
Browse AI adalah rekomendasi kami bagi pengguna bisnis yang membutuhkan data web secara berkala tanpa harus membangun proyek perangkat lunak. Dengan pengaturan saat ini, alat ini dapat membaca halaman yang diberikan, mengusulkan struktur data, lalu memungkinkan pengguna meninjau atau menyesuaikan bidangnya. Pelatihan robot tetap menjadi bagian utama agar ekstraksi dapat diulang. Pendekatan ini praktis bagi tim operasional dan pemasaran yang mengumpulkan daftar produk, entri direktori, atau informasi pesaing ke dalam tabel yang sudah familier.
Pemantauan merupakan salah satu keunggulan utamanya. Robot dapat memeriksa halaman sesuai jadwal, mengidentifikasi penambahan atau perubahan, serta mengirimkan pemberitahuan yang menjelaskan apa yang berubah. Alur kerja dapat menghubungkan pengumpulan data dari berbagai halaman, sementara integrasi API, webhook, dan spreadsheet membantu mengirimkan hasil ke perangkat yang sudah digunakan tim. Dengan demikian, alur kerja pemantauan harga dapat menjadi proses bisnis berkelanjutan, bukan sekadar rangkaian pemeriksaan browser secara manual.
Kemudahan penggunaannya tidak menghilangkan kebutuhan untuk menetapkan definisi data yang jelas. Pengguna sebaiknya menentukan perubahan mana yang perlu memicu pemberitahuan dan memastikan bahwa paginasi, langkah masuk, serta hasil kosong berfungsi dengan benar. Perombakan besar pada situs tetap dapat memerlukan campur tangan. Browse AI paling cocok ketika tim bisnis dapat meninjau baris hasil ekstraksi dan memelihara robotnya; pengembang yang membutuhkan logika browser dengan kontrol versi ketat mungkin lebih memilih layanan berbasis kode.
Kelebihan dan Kekurangan
- Penyiapan bidang dengan bantuan AI menurunkan hambatan awal
- Pemantauan terjadwal menyoroti perubahan yang berarti
- Terhubung dengan spreadsheet, API, dan webhook
- Perubahan besar pada situs dapat mengharuskan pelatihan ulang
- Logika yang kompleks membutuhkan perancangan alur kerja yang cermat
5. SearchAPI
SearchAPI adalah rekomendasi khusus kami untuk mengumpulkan hasil pencarian sebagai data terstruktur. Google API-nya dapat mengembalikan tautan hasil dan fitur pencarian dalam format JSON, sehingga tidak perlu memelihara pengurai untuk halaman hasil yang terus berubah. Katalog yang lebih luas mencakup sumber seperti Maps, belanja, berita, video, dan pengalaman pencarian AI yang didukung. Alat ini sangat berguna ketika penemuan dan visibilitas di mesin pencari merupakan produk datanya, bukan sekadar langkah awal sebelum merayapi situs web lain.
Pelokalan merupakan bagian penting dari kesesuaian tersebut. Parameter lokasi, negara, bahasa, dan perangkat memungkinkan tim mempelajari pasar dari konteks pencarian yang telah ditentukan. Aplikasi SEO dapat melacak kueri di satu kota, sementara asisten riset dapat menemukan sumber yang relevan dan menyimpan tautan hasilnya untuk digunakan kembali nanti. Dokumentasi khusus tiap mesin pencari penting karena parameter dan bidang hasil yang tersedia berbeda-beda di setiap produk pencarian.
SearchAPI sebaiknya dipilih berdasarkan mesin pencari dan bidang yang benar-benar dibutuhkan alur kerja. Hasil pencarian bukanlah keseluruhan isi halaman yang ditautkan, dan tampilan hasil yang lebih kaya tidak semuanya menggunakan skema yang sama. Tim sebaiknya menganggarkan volume permintaan, memastikan kebutuhan kapasitas pemrosesan, dan menangani bagian hasil yang hilang dengan baik. Untuk mengekstrak data dari situs web sembarang atau menjalankan sesi browser interaktif, alat lain dalam panduan ini merupakan pilihan awal yang lebih tepat.
Kelebihan dan Kekurangan
- Hasil terstruktur menghilangkan kebutuhan memelihara pengurai SERP
- Katalog luas berisi mesin pencari dan mesin terkait
- Kontrol pelokalan yang terperinci
- Hasil pencarian tidak menggantikan ekstraksi data dari halaman tujuan
- Bidang dan parameter berbeda-beda di setiap mesin pencari
6. Octoparse
Octoparse menampilkan AI Copilot dan otomatisasi dengan keterlibatan manusia. Video: Octoparse.
Octoparse cocok bagi analis yang ingin merancang pengikis data secara visual, lalu menjalankannya berulang kali. Platformnya saat ini menyediakan templat siap pakai, penyiapan AI Assistant, dan deteksi halaman otomatis di aplikasi desktop. Pengguna dapat menyempurnakan tugas yang dihasilkan tanpa harus memulai dengan kode browser. Fleksibilitas ini berguna untuk mengumpulkan katalog produk, direktori, atau daftar yang urutan halamannya sama pentingnya dengan bidang pada setiap halaman.
Eksekusi di cloud mengubah tugas yang telah disiapkan menjadi proses pengumpulan data berkala tanpa harus membiarkan komputer pribadi terus menyala. Penjadwalan, pekerjaan paralel, rotasi IP, dan koneksi ekspor membantu menangani pekerjaan berskala lebih besar daripada sekadar prototipe desktop. Pendekatan visual ini sangat menarik bagi tim yang memahami situs web sumber dan kebutuhan datanya, tetapi tidak ingin memelihara layanan otomatisasi browser khusus.
Octoparse tetap membutuhkan perancangan tugas yang cermat. Paginasi, pengguliran tanpa batas, langkah-langkah formulir, dan catatan duplikat dapat mengubah makna proses yang tampaknya berhasil. Batas penggunaan cloud dan fitur paket harus sesuai dengan jadwal serta volume yang direncanakan. Kami merekomendasikannya ketika tim menginginkan kendali lebih besar atas langkah ekstraksi daripada yang ditawarkan alat sekali klik, dengan penanggung jawab khusus yang dapat menyesuaikan tugas saat halaman sumber berubah.
Kelebihan dan Kekurangan
- Templat dan bantuan AI menyederhanakan penyiapan
- Penyuntingan visual mendukung tugas ekstraksi yang terperinci
- Eksekusi di cloud mendukung pengumpulan data terjadwal
- Situs kompleks memerlukan penyempurnaan tugas
- Fitur cloud bergantung pada paket yang dipilih
7. Browserless
Browserless adalah rekomendasi kami bagi para pengembang yang ingin mengendalikan browser, tetapi menyerahkan hosting dan penskalaannya kepada layanan terkelola. Skrip Puppeteer atau Playwright yang sudah ada dapat terhubung ke browser jarak jauh, sehingga solusi ini menarik bagi proyek yang telah memiliki kode otomasi yang berfungsi. Layanan ini sangat berguna ketika pengumpulan data melibatkan beberapa interaksi, antarmuka yang sarat JavaScript, atau sesi yang harus tetap aktif lebih lama daripada satu permintaan sederhana.
Layanan ini juga menyediakan REST API untuk scraping, tangkapan layar, PDF, dan fungsi browser khusus. Server MCP yang dihostingnya menyediakan alat browser bagi agen AI, sementara fitur sesi dan profil terautentikasi mendukung alur kerja yang membutuhkan kesinambungan. Karena itu, Browserless cocok bagi pengembang yang membangun pengumpul data khusus maupun agen yang perlu menjelajah dan mengumpulkan informasi melalui browser sungguhan.
Pertimbangan utama saat membeli adalah cara penggunaan browser dihitung. Paket gratis saat ini mencakup 1.000 unit per bulan dan dua browser yang berjalan secara bersamaan, bukan jaminan 1.000 kali scraping. Waktu penggunaan browser menghabiskan unit, sementara lalu lintas proksi dan CAPTCHA yang berhasil dipecahkan dikenai biaya tambahan; batas sesi berbeda-beda menurut paket. Tim tetap bertanggung jawab atas logika ekstraksi dan pemeriksaan hasil, sehingga Browserless paling menarik ketika kendali atas browser lebih penting daripada pembuat robot visual.
Kelebihan dan Kekurangan
- Mempertahankan alur kerja Puppeteer dan Playwright yang sudah dikenal
- REST API mencakup scraping dan ekspor halaman
- Fitur sesi dan MCP cocok untuk agen interaktif
- Waktu penggunaan browser dan fitur tambahan memengaruhi pemakaian unit
- Ekstraksi khusus tetap membutuhkan logika aplikasi
8. ScrapingBee
ScrapingBee merupakan pilihan tepat bagi pengembang yang menginginkan permintaan scraping terkelola, bukan kendali langsung atas browser yang berjalan lama. API-nya memadukan pengambilan halaman dan perenderan JavaScript dengan pengelolaan proksi, sementara ekstraksi dapat dilakukan menggunakan aturan CSS atau XPath maupun instruksi AI. Kombinasi ini berguna ketika proyek membutuhkan data terstruktur dari beberapa situs web, tetapi tidak ingin mengoperasikan armada browser sendiri.
Skenario JavaScript dapat mengeklik, menggulir, mengetik, atau menunggu sebelum data dikumpulkan. Keluaran Markdown mendukung alur kerja konten AI, sedangkan tangkapan layar membantu merekam halaman yang telah dirender. Produk saat ini juga menyediakan API khusus untuk target tertentu, serta akses melalui CLI dan MCP. Pengembang dapat menggunakan aturan ekstraksi eksplisit untuk bidang yang stabil dan ekstraksi dengan bahasa alami ketika struktur halaman atau pertanyaannya kurang dapat diprediksi.
Perbedaannya dengan platform browser terhosting terlihat dalam praktik: ScrapingBee berfokus pada permintaan dan hasil yang dikembalikan, sementara aplikasi khusus menangani keseluruhan proses yang lebih luas. Koordinasi beberapa halaman, deduplikasi, jadwal penyegaran, dan validasi data tetap harus ditangani di tempat lain. Pemakaian kredit juga berubah sesuai fitur yang digunakan, termasuk perenderan dan opsi proksi. Kami merekomendasikannya kepada tim aplikasi yang mengutamakan antarmuka HTTP sederhana dan ingin mengelola orkestrasi alur data mereka sendiri melalui kode.
Kelebihan dan Kekurangan
- Aturan pemilih dan ekstraksi AI menawarkan fleksibilitas
- Perenderan dan skenario mendukung halaman interaktif
- Markdown, CLI, dan MCP mendukung alur kerja AI
- Opsi permintaan lanjutan meningkatkan pemakaian kredit
- Pekerjaan yang mencakup banyak halaman tetap membutuhkan orkestrasi
9. Oxylabs
Oxylabs merupakan pilihan tepat bagi tim yang menginginkan akses terkelola ke situs web publik yang sulit diakses serta kemampuan untuk meningkatkan volume pengumpulan data. Web API-nya saat ini mencakup layanan /Scrape untuk mengambil dan menyusun data web, dengan perenderan JavaScript dan penanganan akses yang terintegrasi ke dalam layanan. Rangkaian produknya juga mencakup /Search dan infrastruktur browser, sehingga tim dapat memilih beberapa pendekatan sesuai dengan apakah tugas dimulai dari penemuan, ekstraksi, atau interaksi.
Opsi khusus untuk target tertentu membantu sumber pencarian dan perdagangan umum menghasilkan bidang data yang berguna, sementara koneksi agen melalui MCP dan Agent Skills mengintegrasikan pengumpulan data ke dalam alur kerja AI. Oxylabs juga terus menyediakan dokumentasi terpisah untuk Classic Web Scraper API. Perbedaan ini penting bagi integrasi yang sudah ada: tim yang memelihara Classic API sebaiknya menggunakan dokumentasi yang sesuai, bukan berasumsi bahwa contoh Web API yang lebih baru dapat digunakan sebagai penggantinya.
Oxylabs paling sesuai ketika tingkat kesulitan target, kapasitas pemrosesan, atau biaya pemeliharaan infrastruktur akses membenarkan penggunaan platform terkelola. Aplikasi tetap perlu menentukan skema yang diinginkan, rentang kesegaran data, dan cara menangani data yang tidak lengkap. Sebelum penerapan, sesuaikan generasi API, opsi target, dan model penggunaan yang dipilih dengan pekerjaan sebenarnya. Untuk ekstraksi manual berskala kecil, scraper visual mungkin lebih praktis.
Kelebihan dan Kekurangan
- Infrastruktur terkelola untuk perenderan dan akses
- Opsi ekstraksi terstruktur yang disesuaikan dengan target
- Web API saat ini mendukung integrasi agen
- API klasik dan API saat ini memerlukan penyiapan terpisah
- Kualitas keluaran tetap perlu diperiksa di aplikasi
10. Diffbot
Diffbot menjadi pilihan kami ketika memahami informasi di halaman lebih penting daripada mereproduksi tata letaknya. Extract menggunakan visi komputer dan pemrosesan bahasa alami untuk mengklasifikasikan halaman serta menghasilkan JSON terstruktur melalui skema standar. Bagi tim yang mengumpulkan artikel atau produk dari banyak sumber, fitur ini dapat mengurangi kebutuhan akan kode penguraian khusus situs untuk mengubah halaman menjadi catatan yang dapat dibandingkan.
Knowledge Graph-nya memenuhi kebutuhan terkait yang berbeda: menangani entitas seperti organisasi, orang, dan artikel yang telah dihimpun dari web publik. Catatan dapat menggabungkan informasi dari berbagai sumber dan menghubungkan entitas melalui relasi yang bermakna. Karena itu, Diffbot berguna untuk pengayaan data, riset perusahaan, dan aplikasi intelijen yang memerlukan konteks di luar kolom yang terlihat pada satu halaman.
Konsekuensinya adalah kebutuhan untuk menyesuaikan pekerjaan dengan model data Diffbot. Ekstraksi terstandardisasi bermanfaat ketika jenis halaman dan kolomnya sesuai dengan kebutuhan, tetapi kolom yang tidak biasa atau interaksi khusus mungkin tetap memerlukan pendekatan lain. Tim sebaiknya membedakan antara mengekstrak URL yang mereka pilih dan membuat kueri pada graf pengetahuan yang sudah ada, lalu menilai cakupan serta kebaruan sumber berdasarkan kebutuhan. Diffbot lebih cocok bagi tim teknis yang membangun produk informasi ternormalisasi daripada pengguna yang hanya perlu menyalin beberapa baris ke spreadsheet.
Kelebihan dan Kekurangan
- Klasifikasi otomatis mengurangi pekerjaan membuat pengurai
- Skema standar membantu menormalkan halaman serupa
- Knowledge Graph menambahkan konteks tentang entitas
- Kolom standar mungkin tidak memenuhi kebutuhan khusus
- Ekstraksi dan akses ke graf melayani alur kerja yang berbeda
Pertanyaan yang Sering Diajukan
Apa yang membuat alat scraping web ditenagai AI?
AI dapat membantu mengidentifikasi kolom, menafsirkan konten halaman, membuat langkah-langkah ekstraksi, atau mengendalikan tindakan browser. Sebagian alat menggunakan AI selama penyiapan, sementara yang lain menggunakannya untuk setiap ekstraksi. Layanan juga dapat mendukung aplikasi AI dengan menyediakan konten bersih tanpa menggunakan model bahasa untuk setiap permintaan. Pilih kemampuan yang menyelesaikan masalah pengumpulan data Anda, bukan sekadar mengandalkan labelnya.
Apa perbedaan antara scraping dan otomatisasi browser?
Scraping mengumpulkan informasi. Otomatisasi browser menjalankan tindakan di halaman, seperti membuka menu, memasukkan pencarian, atau menjalankan alur kerja bertahap. Keduanya sering digunakan bersama: browser otomatis membuka halaman yang sesuai, lalu langkah ekstraksi mengumpulkan kolom-kolomnya. Permintaan API langsung biasanya lebih sederhana jika interaksi tersebut tidak diperlukan.
Alat apa yang paling cocok untuk tim nonteknis?
Browse AI menjadi rekomendasi utama kami untuk pengumpulan data berkala dan pemantauan perubahan yang sederhana. Octoparse merupakan alternatif andal bagi tim yang menginginkan kendali visual lebih besar atas langkah-langkah tugas. Keduanya paling efektif jika seseorang meninjau catatan yang dihasilkan dan memahami kapan situs sumber mengalami perubahan.
Informasi apa yang perlu dipertahankan dalam pipeline AI atau RAG dari hasil scraping?
Simpan URL sumber, waktu pengumpulan, judul halaman, serta teks atau kolom terstruktur yang dibutuhkan aplikasi. Markdown dapat mempertahankan struktur dokumen agar mudah dibaca, sedangkan JSON mendukung catatan dengan format yang ditentukan. Hapus konten duplikat dan hindari mencampur teks navigasi dengan materi utama. Dengan menyimpan informasi asal, jawaban di kemudian hari akan lebih mudah ditelusuri dan diperbarui.
Kapan browser terkelola layak digunakan?
Browser terkelola berguna ketika pengumpulan data memerlukan eksekusi JavaScript, beberapa interaksi, atau sesi yang berkelanjutan, dan tim Anda ingin menghindari keharusan menghosting proses browser. Browserless merupakan opsi khusus untuk kode Puppeteer atau Playwright yang sudah ada. Untuk satu halaman statis, API pengambilan atau ekstraksi yang lebih sederhana mungkin menggunakan lebih sedikit sumber daya.
Apakah 1.000 unit gratis sama dengan 1.000 kali scraping?
Tidak. Setiap penyedia memiliki aturan sendiri untuk unit dan kredit. Browserless menghitung penggunaan koneksi browser dalam blok hingga 30 detik, dengan konsumsi unit tambahan untuk lalu lintas proksi dan penyelesaian CAPTCHA. Layanan lain mengenakan biaya berdasarkan opsi permintaan, jumlah catatan, atau komputasi. Perkirakan biaya seluruh alur kerja, bukan menyamakan kuota gratis dari berbagai layanan.
Bisakah hasil ekstraksi AI dipercaya tanpa peninjauan?
Respons JSON yang valid tetap dapat menghilangkan catatan atau salah menafsirkan kolom. Tentukan kolom yang wajib ada, periksa jenis dan rentang nilainya, ambil sampel halaman sumber, serta pantau perubahan jumlah catatan. Untuk pekerjaan berkala, penanda kegagalan dan hasil kosong yang eksplisit lebih berguna daripada menganggap setiap respons sebagai kumpulan data lengkap.
Kesimpulan tentang Alat Scraping Web AI
Bright Data adalah pilihan utama kami secara keseluruhan untuk program data web yang luas, sementara Firecrawl merupakan titik awal terbaik untuk mengubah halaman web menjadi konten siap pakai untuk AI. Pilih Apify jika alat yang dapat digunakan kembali, tugas terjadwal, dan operasi cloud menjadi bagian utama proyek.
Bagi tim bisnis, Browse AI memudahkan pemantauan berkala, sementara Octoparse menyediakan cara visual bagi pengguna untuk menyempurnakan tugas ekstraksi yang lebih rumit. SearchAPI merupakan pilihan khusus saat keluaran yang dibutuhkan berupa data penelusuran terstruktur.
Browserless layak dipilih oleh pengembang yang menginginkan eksekusi browser terkelola dengan pustaka otomasi yang sudah familier. ScrapingBee merupakan alternatif yang andal jika permintaan ekstraksi terkelola lebih sesuai dengan aplikasi. Oxylabs cocok untuk pengambilan data dari web publik yang menuntut, sedangkan Diffbot unggul dalam ekstraksi terstandardisasi dan kecerdasan entitas.
Pilihan terbaik untuk jangka panjang adalah yang menyediakan informasi yang dibutuhkan melalui alur kerja yang dapat dipelihara oleh tim Anda. Sesuaikan metode pengumpulan dengan tugasnya, pertahankan konteks sumber, dan nilai manfaatnya berdasarkan keluaran yang dapat digunakan, bukan jumlah halaman yang diminta.




