Sudut Anderson
Ekstraksi Matte Gambar dengan AI yang Memahami Adegan

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Poin utamaAI matting kini menggunakan pemahaman adegan untuk menggantikan layar hijau.
Lihat selengkapnya
- AI matting kini menggunakan pemahaman adegan untuk menggantikan layar hijau.
- Pipeline SPG-IM yang baru mengungguli metode tanpa trimap dengan selisih yang besar.
- Label tekstual menawarkan alternatif berbiaya rendah untuk anotasi piksel yang mahal.
Dalam dokumenter bonus yang menyertai perilisan DVD Alien3 (1992) pada 2003, tokoh legendaris efek visual Richard Edlund mengenang dengan ngeri proses ekstraksi matte fotokimia yang ia sebut «gulat sumo» dan mendominasi pekerjaan efek visual antara akhir 1930-an dan akhir 1980-an. Edlund menggambarkan proses yang hasilnya tak menentu itu sebagai «gulat sumo», jika dibandingkan dengan teknik layar biru/hijau digital yang mengambil alih pada awal 1990-an (dan sejak itu ia kembali menggunakan metafora tersebut).
Mengisolasi elemen latar depan (seperti seseorang atau model pesawat ruang angkasa) dari latar belakang agar gambar yang sudah dipotong dapat dikompositkan ke dalam pelat latar belakang, pada awalnya dilakukan dengan merekam objek latar depan di depan latar berwarna biru atau hijau polos.
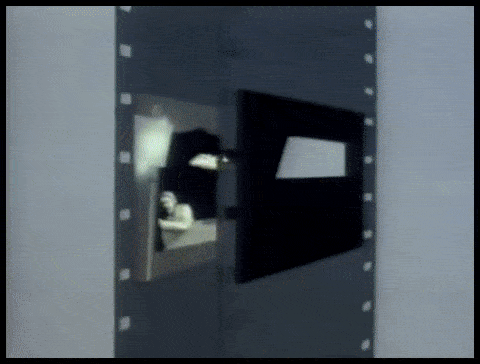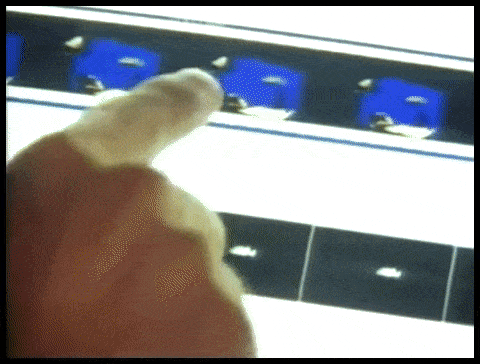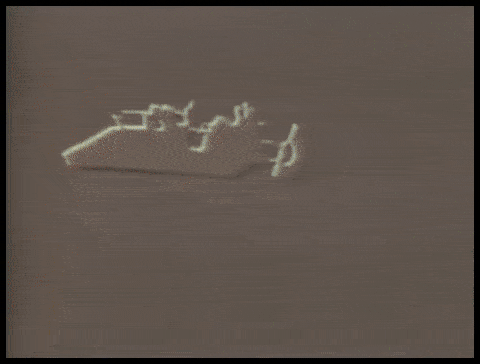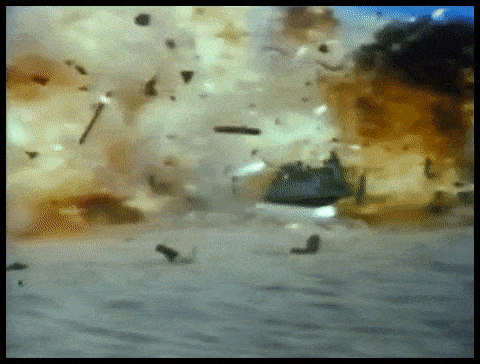
Proses ekstraksi fotokimia yang melelahkan untuk sebuah adegan efek visual oleh ILM dalam ‘Return of the Jedi’ (1983).
Dalam rekaman yang dihasilkan, warna latar belakang kemudian diisolasi secara kimiawi dan digunakan sebagai templat untuk mencetak ulang objek (atau orang) di latar depan melalui mesin cetak optik, sehingga tampak «mengambang» pada lembar film yang selebihnya transparan.
Teknik ini dikenal sebagai color separation overlay (CSO)—meskipun istilah tersebut pada akhirnya lebih sering dikaitkan dengan efek video «Chromakey» yang kasar dalam tayangan televisi beranggaran lebih rendah pada 1970-an dan 1980-an. Efek itu dibuat dengan cara analog, bukan menggunakan proses kimiawi atau digital.

Demonstrasi Color Separation Overlay pada 1970 untuk acara anak-anak Inggris ‘Blue Peter’. Sumber: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
Bagaimanapun, baik untuk elemen film maupun video, rekaman yang telah diekstrak selanjutnya dapat disisipkan ke dalam rekaman lain.
Meskipun proses uap natrium milik Disney yang jauh lebih mahal (yang menggunakan warna kuning secara khusus sebagai kunci, dan juga digunakan untuk film horor Alfred Hitchcock tahun 1963, The Birds) menghasilkan definisi yang lebih baik dan matte yang lebih tajam, ekstraksi fotokimia tetap merupakan proses yang melelahkan dan tidak andal.

Proses ekstraksi uap natrium milik Disney mengharuskan latar belakang berada di kisaran warna kuning pada spektrum. Di sini, Angela Lansbury digantung dengan kawat selama produksi adegan yang sarat efek visual untuk ‘Bedknobs and Broomsticks’ (1971). Sumber
Melampaui Pembuatan Matte Digital
Pada 1990-an, revolusi digital menyingkirkan bahan kimia, tetapi kebutuhan akan layar hijau tetap ada. Kini, latar belakang hijau (atau warna apa pun) dapat dihilangkan cukup dengan mencari piksel yang warnanya berada dalam rentang toleransi tertentu, menggunakan perangkat lunak penyuntingan piksel seperti Photoshop serta generasi baru perangkat lunak komposit video yang dapat secara otomatis menghapus latar belakang berwarna. Hampir dalam semalam, industri pencetakan optik yang telah berlangsung selama enam puluh tahun pun menjadi bagian dari sejarah.
Penelitian visi komputer yang dipercepat GPU selama sepuluh tahun terakhir mengantarkan ekstraksi matte ke era ketiga. Para peneliti kini ditugaskan mengembangkan sistem yang mampu menghasilkan matte berkualitas tinggi tanpa memerlukan layar hijau. Di Arxiv saja, makalah tentang inovasi ekstraksi elemen latar depan berbasis pembelajaran mesin terbit setiap minggu.
Menempatkan Kita dalam Gambar
Perhatian kalangan akademisi dan industri terhadap ekstraksi berbasis AI ini telah berdampak pada ranah konsumen: kita semua mengenal penerapannya yang sederhana tetapi cukup efektif dalam bentuk filter Zoom dan Skype, yang dapat mengganti latar ruang keluarga kita dengan pulau tropis dan sebagainya saat melakukan panggilan konferensi video.
Namun, hasil matte terbaik masih memerlukan layar hijau, sebagaimana disampaikan Zoom pada Rabu lalu.

Kiri, seorang pria di depan layar hijau, dengan rambut yang diekstrak dengan baik melalui fitur Latar Belakang Virtual Zoom. Kanan, seorang wanita di depan suasana rumah biasa, dengan rambut yang diekstrak menggunakan algoritme secara kurang akurat dan dengan kebutuhan komputasi yang lebih tinggi. Sumber: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Unggahan lain dari platform Dukungan Zoom memperingatkan bahwa ekstraksi tanpa layar hijau juga membutuhkan daya komputasi lebih besar pada perangkat perekam.
Kebutuhan untuk Menghapus Latar
Peningkatan kualitas, portabilitas, dan efisiensi sumber daya pada sistem ekstraksi matte «di kondisi nyata» (yakni mengisolasi orang tanpa memerlukan layar hijau) relevan bagi jauh lebih banyak sektor dan kegiatan daripada sekadar filter konferensi video.
Untuk pengembangan set data, peningkatan kemampuan mengenali wajah, seluruh kepala, dan seluruh tubuh membuka peluang untuk memastikan bahwa elemen latar belakang yang tidak relevan tidak ikut dilatihkan ke dalam model visi komputer tentang manusia; isolasi yang lebih akurat akan sangat meningkatkan teknik segmentasi semantik yang dirancang untuk membedakan dan menyerap berbagai ranah (yakni «kucing», «orang», «perahu»), serta meningkatkan sistem sintesis gambar berbasis VAE dan transformer, seperti DALL-E 2 baru dari OpenAI; algoritme ekstraksi yang lebih baik juga akan mengurangi kebutuhan akan rotoskopi manual yang mahal dalam alur kerja efek visual berbiaya tinggi.
Faktanya, semakin populernya metodologi multimodal (biasanya teks/gambar), yang mengodekan suatu ranah seperti «kucing» baik sebagai gambar maupun dengan rujukan teks terkait, sudah mulai merambah pemrosesan gambar. Salah satu contoh terbaru adalah arsitektur Text2Live, yang menggunakan pelatihan multimodal (teks/gambar) untuk membuat video dengan beragam kemungkinan, termasuk angsa kristal dan jerapah kaca.
Matting AI yang Memahami Adegan
Banyak penelitian tentang matting otomatis berbasis AI berfokus pada pengenalan batas dan evaluasi kelompok piksel dalam gambar atau bingkai video. Namun, penelitian baru dari Tiongkok menawarkan alur ekstraksi yang meningkatkan ketepatan delineasi dan kualitas matte dengan memanfaatkan deskripsi berbasis teks tentang suatu adegan (pendekatan multimodal yang semakin populer di bidang penelitian visi komputer selama 3–4 tahun terakhir), dan mengklaim telah meningkatkan sejumlah aspek dibandingkan metode sebelumnya.

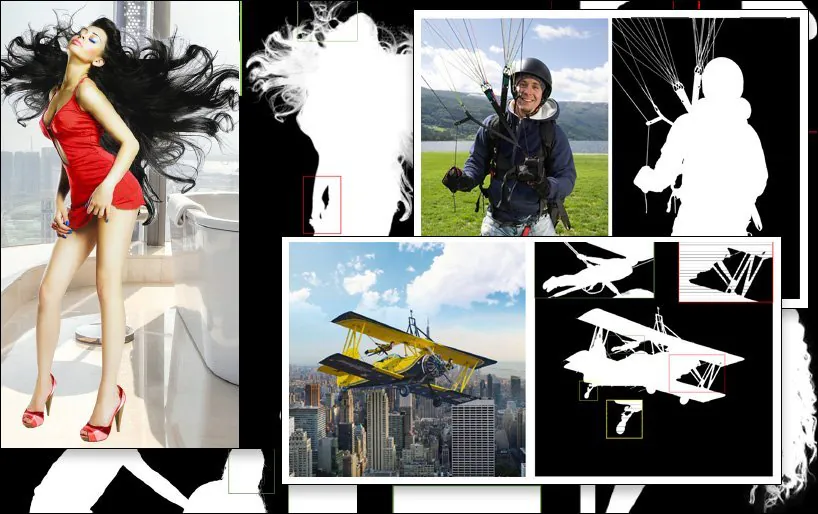
Contoh hasil ekstraksi SPG-IM (gambar terakhir, kanan bawah), dibandingkan dengan metode terdahulu yang bersaing. Sumber: https://arxiv.org/pdf/2204.09276.pdf
Tantangan yang dihadapi subsektor penelitian ekstraksi adalah menghasilkan alur kerja yang hanya memerlukan sedikit mungkin anotasi manual dan campur tangan manusia—idealnya, tanpa keduanya. Selain pertimbangan biaya, para peneliti dalam makalah baru tersebut mencatat bahwa anotasi dan segmentasi manual yang dilakukan oleh pekerja lepas dari berbagai budaya dapat menyebabkan gambar diberi label atau bahkan disegmentasi dengan cara berbeda, sehingga menghasilkan algoritme yang tidak konsisten dan tidak memuaskan.
Salah satu contohnya adalah penafsiran subjektif tentang apa yang dimaksud dengan «objek latar depan»:

Dari makalah baru: metode terdahulu LFM dan MODNet («GT» berarti data acuan, yakni hasil «ideal» yang sering kali diperoleh secara manual atau dengan metode nonalgoritmik) memiliki penafsiran yang berbeda-beda dan tingkat keberhasilan yang beragam dalam menentukan konten latar depan, sedangkan metode SPG-IM yang baru lebih efektif menggambarkan «konten dekat» dengan memanfaatkan konteks adegan.
Untuk mengatasi masalah ini, para peneliti mengembangkan alur kerja dua tahap berjudul Situational Perception Guided Image Matting (SPG-IM). Arsitektur encoder/decoder dua tahap ini terdiri atas Situational Perception Distillation (SPD) dan Situational Perception Guided Matting (SPGM).

Arsitektur SPG-IM.
Pertama, SPD melakukan prapelatihan transformasi fitur visual ke tekstual, dengan menghasilkan takarir yang sesuai untuk gambar terkait. Setelah itu, prediksi mask latar depan dapat dilakukan dengan menghubungkan alur kerja tersebut ke teknik prediksi saliensi yang baru.
Selanjutnya, SPGM menghasilkan perkiraan matte alfa berdasarkan masukan gambar RGB mentah dan mask yang dibuat oleh modul pertama.
Tujuannya adalah memberikan panduan persepsi situasional, sehingga sistem memahami konteks isi gambar dan dapat merumuskan tantangan—misalnya, mengekstrak rambut rumit dari latar belakang—berdasarkan karakteristik yang diketahui dari tugas khusus tersebut.

Dalam contoh di bawah, SPG-IM memahami bahwa tali merupakan bagian tak terpisahkan dari «parasut», sedangkan MODNet gagal mempertahankan dan menggambarkan detail tersebut. Demikian pula pada gambar di atas, keseluruhan struktur peralatan taman bermain hilang begitu saja dalam MODNet.
makalah baru ini berjudul Situational Perception Guided Image Matting, dan berasal dari para peneliti di OPPO Research Institute, PicUp.ai, dan Xmotors.
Matte Otomatis yang Cerdas
SPG-IM juga mengusulkan Jaringan Penyempurnaan Adaptive Focal Transformation (AFT), yang dapat memproses detail lokal dan konteks global secara terpisah sehingga memungkinkan terciptanya ‘matte cerdas’.

Memahami konteks adegan, dalam hal ini ‘gadis bersama kuda’, berpotensi mempermudah ekstraksi latar depan dibandingkan metode sebelumnya.
Makalah tersebut menyatakan:
‘Kami percaya bahwa representasi visual dari tugas visual-ke-teks, misalnya pembuatan keterangan gambar, berfokus pada sinyal yang lebih komprehensif secara semantik antara a) objek dengan objek dan b) objek dengan lingkungan sekitarnya untuk menghasilkan deskripsi yang mencakup informasi global sekaligus detail lokal. Selain itu, dibandingkan dengan anotasi piksel yang mahal untuk matting gambar, label teks dapat dikumpulkan secara masif dengan biaya yang sangat rendah.’
Cabang SPD pada arsitektur ini dipra-latih bersama decoder tekstual berbasis transformer dari University of Michigan, VirTex, yang mempelajari representasi visual dari keterangan gambar yang kaya secara semantik.

VirTex melatih ConvNet dan Transformers secara bersamaan menggunakan pasangan gambar dan keterangan, lalu menerapkan wawasan yang diperoleh ke tugas visi hilir seperti deteksi objek. Sumber: https://arxiv.org/pdf/2006.06666.pdf
Selain pengujian dan studi ablasi lainnya, para peneliti menguji SPG-IM terhadap metode mutakhir berbasis peta trimap: Deep Image Matting (DIM), IndexNet, Context-Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA, dan Semantic Image Matting (SIM).
Kerangka kerja terdahulu lainnya yang turut diuji mencakup pendekatan tanpa trimap LFM, HAttMatting, dan MODNet. Agar perbandingan adil, metode pengujian disesuaikan dengan metodologi masing-masing; jika kodenya tidak tersedia, teknik dalam makalah tersebut direproduksi berdasarkan arsitektur yang dijelaskan.
Makalah baru tersebut menyatakan:
‘SPG-IM kami unggul jauh atas semua metode tanpa trimap yang menjadi pesaing ([LFM], [HAttMatting], dan [MODNet]). Sementara itu, model kami juga menunjukkan keunggulan yang luar biasa dibandingkan metode berbasis trimap dan metode berpanduan mask tercanggih (SOTA) dalam keempat metrik pada seluruh dataset publik (yaitu Composition-1K, Distinction-646, dan Human-2K), serta tolok ukur Multi-Object-1K kami.’
Makalah tersebut melanjutkan:
‘Terlihat jelas bahwa metode kami mempertahankan detail halus (misalnya ujung rambut, tekstur transparan, dan batas) tanpa panduan trimap. Selain itu, dibandingkan model tanpa trimap pesaing lainnya, SPG-IM kami mampu mempertahankan kelengkapan semantik global dengan lebih baik.’


Pertama kali diterbitkan pada 24 April 2022.