
साक्षात्कार
जेवियर कोनोर्ट, फीचरबाइट के सह-संस्थापक और सीपीओ – साक्षात्कार श्रृंखला

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
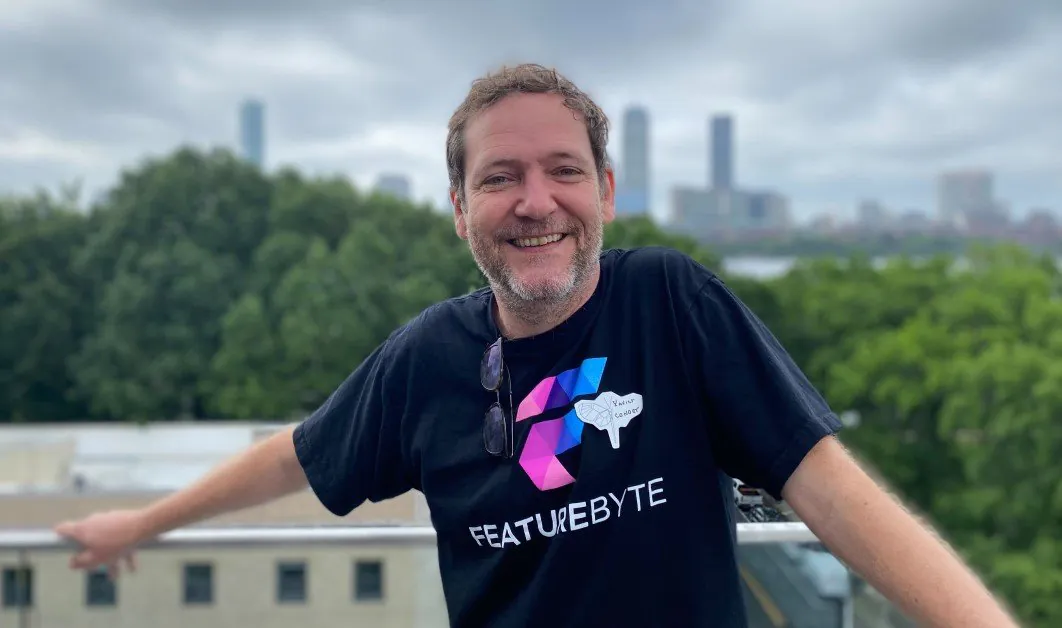
जेवियर कोनोर्ट एक दूरदर्शी डेटा वैज्ञानिक हैं जिनके पास 25 से अधिक वर्षों का डेटा अनुभव है। उन्होंने अपने करियर की शुरुआत बीमा उद्योग में एक एक्ट्यूअरी के रूप में की और बाद में डेटा साइंस में स्थानांतरित हो गए। वह एक शीर्ष-क्रम के कैग्ले प्रतियोगी हैं और डेटारोबोट में मुख्य डेटा वैज्ञानिक थे, फीचरबाइट की सह-स्थापना करने से पहले।
फीचरबाइट उद्यम एआई को स्केल करने के लिए एक मिशन पर है, एआई डेटा को क्रांतिकारी रूप से सरल बनाकर और औद्योगिक बनाकर। फीचर इंजीनियरिंग और प्रबंधन प्लेटफ़ॉर्म डेटा वैज्ञानिकों को अत्याधुनिक फीचर्स (मॉडल के इनपुट चर) और उत्पादन-तैयार डेटा पाइपलाइनों को बनाने और साझा करने में सक्षम बनाता है – मिनटों में – सप्ताह या महीनों के बजाय।
आपने अपने करियर की शुरुआत बीमा उद्योग में एक एक्ट्यूअरी के रूप में की और फिर डेटा साइंस में स्थानांतरित हो गए, इस परिवर्तन का कारण क्या था?
एक निर्णायक क्षण जीई फ्लाइट क्वेस्ट जीतना था, जो जीई द्वारा आयोजित एक प्रतियोगिता थी जिसमें $250K पूल पुरस्कार था, जहां प्रतिभागियों को अमेरिकी घरेलू उड़ानों की देरी की भविष्यवाणी करनी थी। मैं इस सफलता का एक हिस्सा उस मूल्यवान बीमा अभ्यास को देता हूं: 2 चरणों का मॉडलिंग। यह दृष्टिकोण उन फीचर्स में पक्षपात नियंत्रित करने में मदद करता है जिनका उपलब्ध प्रशिक्षण डेटा में पर्याप्त प्रतिनिधित्व नहीं है। कैग्ले पर अन्य जीतों के साथ, यह उपलब्धि मुझे यह समझने में मदद करती है कि मेरी एक्ट्यूअरी पृष्ठभूमि ने डेटा साइंस के क्षेत्र में मुझे एक प्रतिस्पर्धी लाभ दिया है।
कैग्ले पर मेरी यात्रा के दौरान, मुझे अन्य उत्साही डेटा वैज्ञानिकों से जुड़ने का भी अवसर मिला, जिनमें जेरेमी अचिन और टॉम डी गोडॉय शामिल थे, जो बाद में डेटारोबोट के संस्थापक बने। हमारी एक सामान्य पृष्ठभूमि बीमा में थी और हमने कैग्ले पर उल्लेखनीय सफलता हासिल की थी। जब उन्होंने अंततः डेटारोबोट लॉन्च किया, तो एक कंपनी जो AutoML में माहिर है, उन्होंने मुझे मुख्य डेटा वैज्ञानिक के रूप में शामिल होने के लिए आमंत्रित किया। उनकी दृष्टि बीमा उद्योग के सर्वोत्तम अभ्यासों को मशीन लर्निंग की शक्ति के साथ जोड़ने की थी, जो मुझे कुछ नवाचारी और प्रभावशाली बनाने का अवसर प्रदान करती थी।
डेटारोबोट में आप डेटा साइंस रोडमैप बनाने में महत्वपूर्ण थे। आपने किस प्रकार की डेटा चुनौतियों का सामना किया?
हमारे सामने सबसे बड़ी चुनौती हमारे AutoML समाधान के लिए इनपुट के रूप में प्रदान किए गए डेटा की गुणवत्ता में अंतर थी। यह मुद्दा अक्सर हमारी टीम और ग्राहकों के बीच समय लेने वाले सहयोग या उत्पादन में निराशाजनक परिणामों में परिणत होता था, यदि इसे उचित तरीके से संबोधित नहीं किया गया था। गुणवत्ता मुद्दे कई स्रोतों से उत्पन्न हुए जिन पर हमारा ध्यान केंद्रित करने की आवश्यकता थी।
बिजनेस इंटेलिजेंस उपकरणों के सामान्य उपयोग के कारण एक प्राथमिक चुनौती उत्पन्न हुई, जो डेटा तैयारी और प्रबंधन के लिए उपयोग की जाती थी। जबकि ये उपकरण अंतर्दृष्टि उत्पन्न करने के लिए मूल्यवान हैं, उनमें मशीन लर्निंग के लिए डेटा तैयार करते समय उस समय उपलब्ध जानकारी तक सीमित रहने की शुद्धता (point-in-time correctness) सुनिश्चित करने की क्षमता नहीं होती। इसके परिणामस्वरूप, प्रशिक्षण डेटा में रिसाव हो सकता है, जिससे ओवरफिटिंग और मॉडल प्रदर्शन के गलत आकलन हो सकती है।
डेटा वैज्ञानिकों और डेटा इंजीनियरों के बीच गलत संवाद एक अन्य चुनौती थी जो उत्पादन के दौरान मॉडल की सटीकता को प्रभावित करती थी। प्रशिक्षण और उत्पादन चरणों के बीच असंगतता, जो इन दोनों टीमों के बीच तालमेल की कमी से उत्पन्न होती है, वास्तविक दुनिया के वातावरण में मॉडल प्रदर्शन को प्रभावित कर सकती है।
इस अनुभव से आपके कुछ मुख्य निष्कर्ष क्या थे?
मेरे डेटारोबोट में अनुभव ने मुझे यह समझने में मदद की कि मशीन लर्निंग में डेटा तैयारी का क्या महत्व है। मॉडल प्रशिक्षण डेटा की चुनौतियों का समाधान करके, जैसे कि उस समय उपलब्ध डेटा तक सीमित रहने की शुद्धता, विशेषज्ञता की कमी, डोमेन ज्ञान, उपकरण सीमाएं और मापनीयता, हम मशीन लर्निंग मॉडल की सटीकता और विश्वसनीयता को बढ़ा सकते हैं। मैं इस निष्कर्ष पर पहुंचा कि डेटा तैयारी प्रक्रिया को सरल बनाना और नवाचारी प्रौद्योगिकियों को शामिल करना एआई की पूरी क्षमता को अनलॉक करने और अपने वादों को पूरा करने में महत्वपूर्ण होगा।
हमें आपके सह-संस्थापक राजी रज़ीउद्दीन से फीचरबाइट के पीछे की कहानी के बारे में सुनने को मिला, क्या आप हमें इस घटना का अपना संस्करण बता सकते हैं?
जब मैंने अपने सह-संस्थापक राजी रज़ीउद्दीन के साथ अपने निरीक्षण और अंतर्दृष्टि पर चर्चा की, तो हमें एहसास हुआ कि हम दोनों मशीन लर्निंग के लिए डेटा तैयारी में चुनौतियों की एक सामान्य समझ साझा करते हैं। चर्चा के दौरान, मैंने राजी के साथ एमएलओप्स समुदाय में हाल की प्रगति के बारे में अपने निरीक्षण साझा किए। मैं फीचर स्टोर और फीचर प्लेटफ़ॉर्म के उदय को देख सकता था जो एआई-पहले तकनीकी कंपनियों द्वारा फीचर सर्विंग की देरी को कम करने, फीचर पुन: उपयोग को प्रोत्साहित करने या फीचर्स को प्रशिक्षण डेटा में ठोस रूप से तैयार करने की प्रक्रिया सरल बनाने के लिए स्थापित किया गया था, साथ ही प्रशिक्षण-सेवा संगति को सुनिश्चित करने के लिए। हालांकि, यह स्पष्ट था कि डेटा वैज्ञानिकों की जरूरतों को पूरा करने में अभी भी एक अंतर था। राजी ने मुझे आधुनिक डेटा स्टैक के बारे में अपने निरीक्षण साझा किए, जिसने बीआई और विश्लेषण को कैसे क्रांतिकारी बनाया है, लेकिन एआई के लिए पूरी तरह से उपयोग नहीं किया जा रहा है।
यह स्पष्ट हो गया कि राजी और मुझे फीचर इंजीनियरिंग प्रक्रिया को क्रांतिकारी रूप से सरल बनाने और डेटा वैज्ञानिकों और एमएल इंजीनियरों को फीचर प्रयोग और फीचर सेवा के लिए सहज उपयोगकर्ता अनुभव के साथ सही उपकरण प्रदान करने का अवसर था।
डेटा वैज्ञानिक से उद्यमी बनने के लिए संक्रमण में आपके कुछ सबसे बड़े चुनौतियों में से क्या थे?
डेटा वैज्ञानिक से उद्यमी बनने के लिए मुझे तकनीकी दृष्टिकोण से एक व्यापक व्यवसाय-उन्मुख मानसिकता में बदलने की आवश्यकता थी। जबकि मुझे ग्राहकों की समस्याओं को समझने, रोडमैप बनाने, योजनाओं को निष्पादित करने, टीम बनाने और बजट प्रबंधन करने में एक मजबूत आधार था, मुझे एहसास हुआ कि सही संदेश बनाना जो वास्तव में हमारे लक्षित दर्शकों के साथ प्रतिध्वनित होता है, मेरे लिए सबसे बड़ी बाधा थी।
एक डेटा वैज्ञानिक के रूप में, मेरा प्राथमिक फोकस हमेशा डेटा का विश्लेषण और व्याख्या करना और मूल्यवान अंतर्दृष्टि प्राप्त करना था। हालांकि, एक उद्यमी के रूप में, मुझे बाजार, ग्राहकों और समग्र व्यवसाय की ओर अपनी सोच को मोड़ने की आवश्यकता थी।
सौभाग्य से, मैं अपने सह-संस्थापक राजी के अनुभव का लाभ उठाने में सक्षम था।
हमें राजी से सुनने को मिला कि फीचर इंजीनियरिंग इतनी कठिन क्यों है, आपके दृष्टिकोण से यह इतनी चुनौतीपूर्ण क्यों है?
फीचर इंजीनियरिंग की दो मुख्य चुनौतियाँ हैं:
- मौजूदा कॉलम को परिवर्तित करना: इसमें मशीन लर्निंग एल्गोरिदम के लिए उपयुक्त प्रारूप में डेटा को परिवर्तित करना शामिल है। एक-हॉट एन्कोडिंग, फीचर स्केलिंग और उन्नत विधियों जैसे पाठ और छवि परिवर्तनों का उपयोग किया जाता है। मौजूदा फीचर्स से नए फीचर बनाना, जैसे इंटरएक्शन फीचर, मॉडल के प्रदर्शन को बहुत बढ़ा सकता है। लाइब्रेरी जैसे scikit-learn और Hugging Face इस प्रकार के फीचर इंजीनियरिंग के लिए व्यापक समर्थन प्रदान करते हैं। AutoML समाधान इस प्रक्रिया को सरल बनाने का लक्ष्य रखते हैं।
- ऐतिहासिक डेटा से नए कॉलम निकालना: ऐतिहासिक डेटा सिफारिश प्रणाली, विपणन, धोखाधड़ी का पता लगाने, बीमा मूल्य निर्धारण, क्रेडिट स्कोरिंग, मांग पूर्वानुमान और सेंसर डेटा प्रसंस्करण जैसे समस्या डोमेन में महत्वपूर्ण है। इस डेटा से जानकारीपूर्ण कॉलम निकालना चुनौतीपूर्ण है। उदाहरणों में अंतिम घटना के बाद से समय, हाल की घटनाओं पर समेकित गणनाएं और घटनाओं के क्रम से एम्बेडिंग शामिल हैं। इस प्रकार के फीचर इंजीनियरिंग के लिए डोमेन विशेषज्ञता, प्रयोग, मजबूत कोडिंग और डेटा इंजीनियरिंग कौशल और गहरी डेटा विज्ञान ज्ञान की आवश्यकता होती है। भविष्य की जानकारी का प्रशिक्षण डेटा में रिसाव, बड़े डेटासेट को संभालना और कुशल कोड निष्पादन जैसे कारकों पर भी विचार किया जाना चाहिए।
कुल मिलाकर, विशेष रूप से इसके लिए बने उपकरणों के अभाव में फीचर इंजीनियरिंग के लिए विशेषज्ञता, प्रयोग और जटिल तदर्थ डेटा पाइपलाइन बनाना आवश्यक होता है।
क्या आप बता सकते हैं कि फीचरबाइट डेटा साइंस पेशेवरों को कैसे सशक्त बनाता है और फीचर पाइपलाइनों को सरल बनाता है?
फीचरबाइट डेटा साइंस पेशेवरों को फीचर इंजीनियरिंग प्रक्रिया को सरल बनाकर सशक्त बनाता है। एक सहज Python SDK के साथ, यह बहुत बड़ी इवेंट और आइटम टेबल से फीचर बनाने और निकालने की अनुमति देता है। डेटा प्लेटफ़ॉर्म जैसे स्नोफ्लेक, डेटाब्रिक्स और स्पार्क की मापनीयता द्वारा गणना कुशलता से संभाली जाती है। नोटबुक प्रयोग की सुविधा देते हैं, जबकि फीचर साझा करना और पुन: उपयोग समय बचाता है। ऑडिट सुनिश्चित करता है कि फीचर सटीक हैं, जबकि तुरंत तैनाती पाइपलाइन प्रबंधन की परेशानियों को समाप्त करती है।
हमारे ओपन-सोर्स लाइब्रेरी द्वारा प्रदान की जाने वाली इन क्षमताओं के अलावा, हमारा उद्यम समाधान एआई संचालन को बड़े पैमाने पर प्रबंधित और व्यवस्थित करने के लिए एक व्यापक ढांचा प्रदान करता है, जिसमें शासन कार्य प्रवाह और फीचर कैटलॉग के लिए एक उपयोगकर्ता इंटरफ़ेस शामिल है।
फीचरबाइट के भविष्य के लिए आपकी दृष्टि क्या है?
फीचरबाइट के लिए हमारी अंतिम दृष्टि डेटा साइंस और मशीन लर्निंग के क्षेत्र में क्रांति लाने की है, जिससे उपयोगकर्ता अपने डेटा संपत्तियों से अभूतपूर्व मूल्य निकाल सकें और अपनी पूरी रचनात्मक क्षमता को खोल सकें।
हम विशेष रूप से उत्साहित हैं जनरेटिव एआई और ट्रांसफॉर्मर में तेजी से प्रगति के बारे में, जो हमारे उपयोगकर्ताओं के लिए नए अवसरों की दुनिया खोलता है। इसके अलावा, हम फीचर इंजीनियरिंग को लोकतांत्रिक बनाने के लिए प्रतिबद्ध हैं। जनरेटिव एआई के पास रचनात्मक फीचर इंजीनियरिंग के लिए प्रवेश की बाधा को कम करने की क्षमता है, जिससे इसे एक व्यापक दर्शकों के लिए अधिक सुलभ बनाया जा सकता है।
सारांश में, फीचरबाइट के भविष्य की हमारी दृष्टि निरंतर नवाचार, जनरेटिव एआई की शक्ति का दोहन और फीचर इंजीनियरिंग को लोकतांत्रिक बनाने के इर्द-गिर्द घूमती है। हम उस मंच बनने का लक्ष्य रखते हैं जो डेटा पेशेवरों को कच्चे डेटा को मशीन लर्निंग के लिए क्रियाशील इनपुट में परिवर्तित करने में सक्षम बनाता है, जो विभिन्न उद्योगों में नए अवसरों और प्रगति को बढ़ावा देता है।
आकांक्षी एआई उद्यमियों के लिए आपकी कोई सलाह है?
अपनी जगह परिभाषित करें, ध्यान केंद्रित रखें और नवीनता का स्वागत करें।
अपनी जगह परिभाषित करके जिस क्षेत्र में आप खड़े होना चाहते हैं, आप अपने आप को अलग कर सकते हैं और उस क्षेत्र में एक मजबूत उपस्थिति स्थापित कर सकते हैं। बाजार का शोध करें, संभावित ग्राहकों की जरूरतों और व्यावहारिक समस्याओं को समझें और उन चुनौतियों का समाधान प्रदान करने के लिए एक अद्वितीय समाधान प्रदान करने का प्रयास करें।
अपनी दीर्घकालिक दृष्टि को परिभाषित करें और उस दृष्टि के साथ संरेखित करने वाले स्पष्ट अल्पकालिक लक्ष्य निर्धारित करें। एक मजबूत आधार बनाने और अपने चुने हुए क्षेत्र में मूल्य प्रदान करने पर ध्यान केंद्रित करें।
अंत में, जबकि ध्यान केंद्रित रखना महत्वपूर्ण है, अपने परिभाषित क्षेत्र के भीतर नए विचारों को अपनाने और अन्वेषण करने से नहीं हिचकिचाएं। एआई क्षेत्र निरंतर विकसित हो रहा है, और नवाचारी दृष्टिकोण नए अवसर खोल सकते हैं।
धन्यवाद इस शानदार साक्षात्कार के लिए, पाठक जो अधिक जानना चाहते हैं उन्हें फीचरबाइट पर जाना चाहिए।








