
एआई की मूल बातें
दृष्टि-भाषा मॉडल (VLM) क्या हैं? AI छवियों और शब्दों को कैसे जोड़ता है
दृष्टि-भाषा मॉडल दृश्य विशेषताओं को भाषा से जोड़ते हैं, ताकि कोई प्रणाली शब्दों का उपयोग करके छवियों का वर्णन कर सके, उनकी तुलना कर सके, उन्हें खोज सके या उनके बारे में तर्क कर सके। यह मार्गदर्शिका कार्य-विधि, समझौते, मूल्यांकन और उन नियंत्रणों की व्याख्या करती है, जो व्यवहार में महत्वपूर्ण हैं।

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
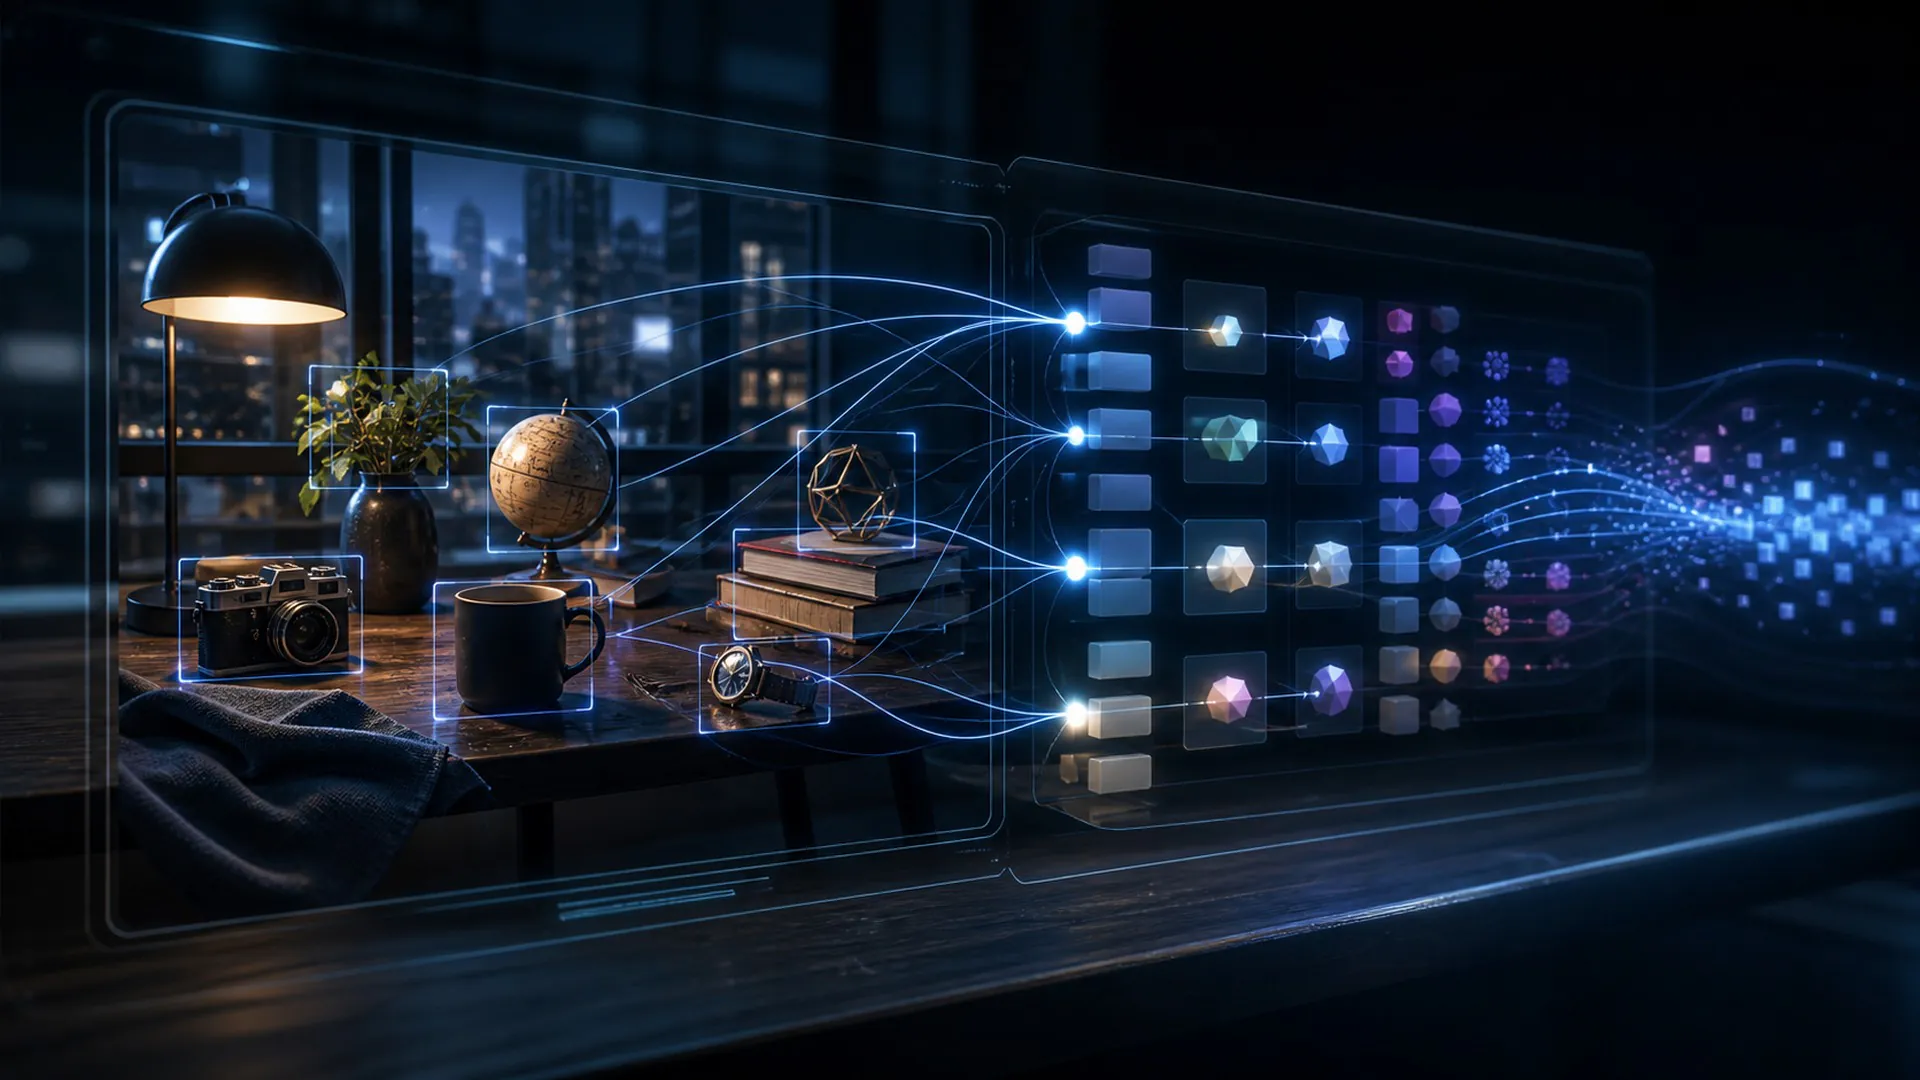
दृष्टि-भाषा मॉडल दृश्य विशेषताओं को भाषा से जोड़ते हैं, ताकि कोई प्रणाली शब्दों का उपयोग करके छवियों का वर्णन कर सके, उनकी तुलना कर सके, उनमें जानकारी खोज सके या उनके बारे में तर्क कर सके।
दृष्टि-भाषा मॉडल की सटीक व्याख्या ज़रूरी है, क्योंकि यह नाम सूचना के किसी विशेष प्रवाह, प्रशिक्षण-विकल्प, रनटाइम तंत्र या शासन-सीमा की पहचान करता है। इसे “उन्नत AI” का पर्याय मानने से ऐसे दावे हो जाते हैं जिन्हें परखना असंभव है। यह मार्गदर्शिका इस अवधारणा को इसके इनपुट और मान्यताओं से लेकर इसके दिखाई देने वाले परिणाम तक समझाती है, फिर उस सरलीकृत धारणा की जाँच करती है जिससे इसे सबसे अधिक भ्रमित किए जाने की आशंका है।
दृष्टि-भाषा मॉडल: परिभाषा, सीमा और उद्देश्य
दृष्टि-भाषा मॉडल दृश्य विशेषताओं को भाषा से जोड़ते हैं, ताकि कोई प्रणाली शब्दों का उपयोग करके छवियों का वर्णन कर सके, उनकी तुलना कर सके, उनमें जानकारी खोज सके या उनके बारे में तर्क कर सके। इस परिभाषा में तीन व्यावहारिक प्रतिबद्धताएँ शामिल हैं: एक ऐसा इनपुट जिसकी पहचान की जा सके; ऐसा रूपांतरण या निर्णय जो दृष्टि-भाषा मॉडल की विशिष्टता हो; और ऐसा परिणाम जिसे बताए गए उद्देश्य के आधार पर परखा जा सके। इनमें से कोई एक तत्व न हो, तो यह नाम किसी लागू तंत्र के बजाय महज़ एक आकांक्षा का वर्णन कर सकता है।
बहुविध-माध्यम वाली प्रणालियों को ऐसे संकेतों का तालमेल बैठाना पड़ता है जिनका रिज़ॉल्यूशन, समय-क्रम, शोर और अस्पष्टता अलग-अलग होते हैं। कोई शब्द छवि के छोटे-से हिस्से की ओर इशारा कर सकता है; कोई ऑडियो घटना उस वीडियो फ़्रेम से पहले हो सकती है जो उसे स्पष्ट करता है। दृष्टि-भाषा मॉडल के लिए, प्रणाली को समग्र रूप से देखने का यह नज़रिया इसलिए अहम है क्योंकि आसपास का डेटा, इंटरफ़ेस, हार्डवेयर, अनुमतियाँ और लोग उसके प्रदर्शन को तय कर सकते हैं, भले ही मूल मॉडल में कोई बदलाव न हुआ हो। इसलिए उपयोगी व्याख्या मॉडल के सीखे हुए व्यवहार को उस उत्पाद से अलग करके देखती है जो तय करता है कि इस व्यवहार का उपयोग कब, कहाँ और किस अधिकार के साथ किया जाएगा।
सबसे नज़दीकी भ्रामक सरलीकरण कंप्यूटर विज़न है, जो खुली भाषा के बिना एक तय लेबल का अनुमान लगाता है। उसमें दृष्टि-भाषा मॉडल की कोई दिखाई देने वाली विशेषता हो सकती है, फिर भी उससे कारण-परिणाम की व्याख्या बदल जाती है: सफलता साबित करने के लिए अलग साक्ष्य चाहिए होंगे, लागत पर अलग संसाधनों का सबसे अधिक असर होगा और नुकसान रोकने के लिए अलग नियंत्रणों की ज़रूरत होगी। इसलिए यह सीमा शब्दावली की नहीं, बल्कि संचालन की है।
दृष्टि-भाषा मॉडल की पाँच चरणों वाली कार्य-प्रणाली
यह आरेख दृष्टि-भाषा मॉडल की एक संक्षिप्त कारणात्मक रूपरेखा है; इसका यह दावा नहीं है कि हर कार्यान्वयन में पाँच सॉफ़्टवेयर घटक होते हैं। कुछ प्रणालियाँ चरणों को मिला देती हैं, जबकि कुछ उन्हें एक चक्र में दोहराती हैं। यह रूपरेखा फिर भी उपयोगी है, क्योंकि यह सूचना या अधिकार में होने वाले हर बदलाव के लिए ज़िम्मेदार पक्ष, इनपुट, आउटपुट और परीक्षण तय करना ज़रूरी बनाती है।
1. छवि को दृश्य टोकन में विभाजित करना या एन्कोड करना: दृष्टि-भाषा मॉडल में इनपुट और मान्यताएँ
दृष्टि-भाषा मॉडल के इस चरण में प्रणाली को छवि को दृश्य टोकन में विभाजित या एन्कोड करना होता है। उपयोगी सवाल सिर्फ़ यह नहीं है कि यह प्रक्रिया होती है या नहीं, बल्कि यह भी है कि इसमें कौन-सी जानकारी इस्तेमाल होती है, इससे कौन-सी स्थिति बदलती है और कौन-सा साक्ष्य साबित करता है कि बदलाव वैध था। समीक्षक इस प्रक्रिया को खुली भाषा के बिना तय लेबल का अनुमान लगाने वाले कंप्यूटर विज़न से अलग पहचान सके और बताई गई उन्हीं परिस्थितियों में इसका परिणाम दोहरा सके।
दृष्टि-भाषा मॉडल के इस चरण में प्रवेश करते समय प्रक्रिया बताए गए उद्देश्य से शुरू होती है और इसका अंत ऐसे परिणाम पर होना चाहिए जो साथ दिए गए पाठ को एन्कोड करने में सहायक हो। अनिश्चितता, अस्वीकार किए गए विकल्प, संसाधनों का उपयोग और सीमा पर लागू किया गया कोई भी मानवीय या सॉफ़्टवेयर नियंत्रण दर्ज करें। इस रिकॉर्ड से टीमें यह पता लगा सकती हैं कि कहीं सहज और प्रवाहपूर्ण विवरण ऐसी वस्तुओं या संबंधों का नाम तो नहीं लेते जो वास्तव में दिखाई नहीं देते—इससे पहले कि यही कमज़ोरी किसी महत्वपूर्ण परिणाम को प्रभावित करे।
2. साथ दिए गए पाठ को एन्कोड करना: दृष्टि-भाषा मॉडल में निरूपण या निर्णय
दृष्टि-भाषा मॉडल के इस चरण में प्रणाली को साथ दिए गए पाठ को एन्कोड करना होता है। उपयोगी सवाल सिर्फ़ यह नहीं है कि यह प्रक्रिया होती है या नहीं, बल्कि यह भी है कि इसमें कौन-सी जानकारी इस्तेमाल होती है, इससे कौन-सी स्थिति बदलती है और कौन-सा साक्ष्य साबित करता है कि बदलाव वैध था। समीक्षक इस प्रक्रिया को खुली भाषा के बिना तय लेबल का अनुमान लगाने वाले कंप्यूटर विज़न से अलग पहचान सके और बताई गई उन्हीं परिस्थितियों में इसका परिणाम दोहरा सके।
इस विज़न-भाषा मॉडल चरण में प्रवेश की शुरुआत छवि को विभाजित करके या एन्कोड करके दृश्य टोकन में बदलने से होती है और इसका अंत ऐसे परिणाम पर होना चाहिए जो दोनों निरूपणों को जोड़ने में सहायक हो। अनिश्चितता, अस्वीकृत विकल्पों, संसाधनों के उपयोग और इस सीमा पर लागू किए गए किसी भी मानवीय या सॉफ़्टवेयर नियंत्रण को दर्ज करें। इसी रिकॉर्ड से टीमें यह पता लगा सकती हैं कि कहीं धाराप्रवाह विवरण ऐसी वस्तुओं या संबंधों का नाम तो नहीं ले रहे जो वास्तव में दिखाई नहीं देते—इससे पहले कि यही कमजोरी किसी महत्वपूर्ण परिणाम तक पहुँचे।
3. दोनों निरूपणों को जोड़ना: विज़न-भाषा मॉडल में विशिष्ट रूपांतरण
विज़न-भाषा मॉडल के इस चरण में सिस्टम को दोनों निरूपणों को जोड़ना चाहिए। उपयोगी सवाल सिर्फ़ यह नहीं है कि यह प्रक्रिया होती है या नहीं, बल्कि यह भी है कि इसमें कौन-सी जानकारी इस्तेमाल होती है, यह किस स्थिति को बदलती है और कौन-सा साक्ष्य साबित करता है कि बदलाव वैध था। समीक्षक को इस प्रक्रिया को ऐसे कंप्यूटर विज़न से अलग पहचानने में सक्षम होना चाहिए जो मुक्त-रूप भाषा के बिना एक निश्चित लेबल का अनुमान लगाता है, और उसे बताई गई समान परिस्थितियों में इसका परिणाम दोहरा पाने में भी सक्षम होना चाहिए।
इस विज़न-भाषा मॉडल चरण में प्रवेश की शुरुआत साथ दिए गए पाठ को एन्कोड करने से होती है और इसका अंत ऐसे परिणाम पर होना चाहिए जो अलग-अलग क्षेत्रों और वाक्यांशों पर ध्यान देने में सहायक हो। अनिश्चितता, अस्वीकृत विकल्पों, संसाधनों के उपयोग और इस सीमा पर लागू किए गए किसी भी मानवीय या सॉफ़्टवेयर नियंत्रण को दर्ज करें। इसी रिकॉर्ड से टीमें यह पता लगा सकती हैं कि कहीं धाराप्रवाह विवरण ऐसी वस्तुओं या संबंधों का नाम तो नहीं ले रहे जो वास्तव में दिखाई नहीं देते—इससे पहले कि यही कमजोरी किसी महत्वपूर्ण परिणाम तक पहुँचे।
4. अलग-अलग क्षेत्रों और वाक्यांशों पर ध्यान देना: विज़न-भाषा मॉडल में प्रतिबंध और सत्यापन की सीमा
विज़न-भाषा मॉडल के इस चरण में सिस्टम को अलग-अलग क्षेत्रों और वाक्यांशों पर ध्यान देना चाहिए। उपयोगी सवाल सिर्फ़ यह नहीं है कि यह प्रक्रिया होती है या नहीं, बल्कि यह भी है कि इसमें कौन-सी जानकारी इस्तेमाल होती है, यह किस स्थिति को बदलती है और कौन-सा साक्ष्य साबित करता है कि बदलाव वैध था। समीक्षक को इस प्रक्रिया को ऐसे कंप्यूटर विज़न से अलग पहचानने में सक्षम होना चाहिए जो मुक्त-रूप भाषा के बिना एक निश्चित लेबल का अनुमान लगाता है, और उसे बताई गई समान परिस्थितियों में इसका परिणाम दोहरा पाने में भी सक्षम होना चाहिए।
इस विज़न-भाषा मॉडल चरण में प्रवेश की शुरुआत दोनों निरूपणों को जोड़ने से होती है और इसका अंत ऐसे परिणाम पर होना चाहिए जो संदर्भ-आधारित जवाब या कार्रवाई तैयार करने में सहायक हो। अनिश्चितता, अस्वीकृत विकल्पों, संसाधनों के उपयोग और इस सीमा पर लागू किए गए किसी भी मानवीय या सॉफ़्टवेयर नियंत्रण को दर्ज करें। इसी रिकॉर्ड से टीमें यह पता लगा सकती हैं कि कहीं धाराप्रवाह विवरण ऐसी वस्तुओं या संबंधों का नाम तो नहीं ले रहे जो वास्तव में दिखाई नहीं देते—इससे पहले कि यही कमजोरी किसी महत्वपूर्ण परिणाम तक पहुँचे।
5. संदर्भ-आधारित जवाब या कार्रवाई तैयार करना: विज़न-भाषा मॉडल में आउटपुट, फ़ीडबैक और रुकने का नियम
विज़न-भाषा मॉडल के इस चरण में सिस्टम को संदर्भ-आधारित जवाब या कार्रवाई तैयार करनी चाहिए। उपयोगी सवाल सिर्फ़ यह नहीं है कि यह प्रक्रिया होती है या नहीं, बल्कि यह भी है कि इसमें कौन-सी जानकारी इस्तेमाल होती है, यह किस स्थिति को बदलती है और कौन-सा साक्ष्य साबित करता है कि बदलाव वैध था। समीक्षक को इस प्रक्रिया को ऐसे कंप्यूटर विज़न से अलग पहचानने में सक्षम होना चाहिए जो मुक्त-रूप भाषा के बिना एक निश्चित लेबल का अनुमान लगाता है, और उसे बताई गई समान परिस्थितियों में इसका परिणाम दोहरा पाने में भी सक्षम होना चाहिए।
इस विज़न-भाषा मॉडल चरण में प्रवेश की शुरुआत अलग-अलग क्षेत्रों और वाक्यांशों पर ध्यान देने से होती है और इसका अंत ऐसे परिणाम पर होना चाहिए जो निगरानी या अंतिम निर्णय में सहायक हो। अनिश्चितता, अस्वीकृत विकल्पों, संसाधनों के उपयोग और इस सीमा पर लागू किए गए किसी भी मानवीय या सॉफ़्टवेयर नियंत्रण को दर्ज करें। इसी रिकॉर्ड से टीमें यह पता लगा सकती हैं कि कहीं धाराप्रवाह विवरण ऐसी वस्तुओं या संबंधों का नाम तो नहीं ले रहे जो वास्तव में दिखाई नहीं देते—इससे पहले कि यही कमजोरी किसी महत्वपूर्ण परिणाम तक पहुँचे।
विज़न-भाषा मॉडल के मानचित्र को आगे की दिशा में पढ़ें, ताकि उत्पादन को समझ सकें, और पीछे की दिशा में, ताकि विफलता का निदान कर सकें। आगे की ओर किया गया विश्लेषण पूछता है कि एक चरण अगले चरण को कैसे जानकारी देता है। पीछे की ओर किया गया विश्लेषण किसी गलत, धीमे, महँगे या असुरक्षित परिणाम से शुरू होता है और पता लगाता है कि पहले की किस धारणा ने उसे संभव बनाया। अक्सर इसी उलटी दिशा में चलने पर टीम को पता चलता है कि निर्णायक त्रुटि मॉडल के कुछ भी तैयार करने से पहले ही हो गई थी।
विज़न-भाषा मॉडल का एक उदाहरण
VLM किसी डैशबोर्ड के स्क्रीनशॉट की जाँच करके बता सकता है कि कौन-सा चार्ट लिखित दावे का समर्थन करता है।
यह उदाहरण जानकारीपूर्ण है, क्योंकि विज़न-भाषा मॉडल का मूल्यांकन किसी सुघड़ प्रदर्शन के आधार पर करने के बजाय उसे दिखाई देने वाले इनपुट, मध्यवर्ती स्थितियों और परिणाम से जोड़ा जा सकता है। एक कठोर परीक्षण में इस परिदृश्य के सामान्य, कठिन और जानबूझकर भ्रामक मामले शामिल होंगे, इस तकनीक के बिना एक आधाररेखा सुरक्षित रखी जाएगी, और औसत प्रदर्शन के साथ-साथ प्रत्येक विफलता की गंभीरता भी दर्ज की जाएगी।
विज़न-भाषा मॉडल के उदाहरण में एक धारणा बदलें और विश्लेषण दोहराएँ। कोई आवश्यक इनपुट हटाएँ, परस्पर विरोधी संकेत शामिल करें, कंप्यूटिंग संसाधन सीमित करें, उपयोगकर्ता-समूह बदलें या सिस्टम को जवाब देने से विरत रहने के लिए बाध्य करें। जो प्रक्रिया केवल एक सावधानी से तैयार किए गए प्रदर्शन में सफल होती है, उसने यह साबित नहीं किया है कि वह वास्तविक संचालन के माहौल में भी सामान्यीकृत होती है।
विज़न-भाषा मॉडल बनाम उसका सबसे आम सरलीकरण
विज़न-भाषा मॉडल को अक्सर ऐसे कंप्यूटर विज़न तक सीमित करके समझा जाता है जो मुक्त-रूप भाषा के बिना एक निश्चित लेबल का अनुमान लगाता है। यह सरलीकरण उस सीमा को ही मिटा देता है जो इस अवधारणा को परिभाषित करती है। इससे खरीदार असमान उत्पादों की तुलना कर सकते हैं, शोधकर्ता किसी प्रयोग से साबित होने वाली बात को बढ़ा-चढ़ाकर पेश कर सकते हैं और संचालक परिनियोजन के बाद गलत संकेत की निगरानी कर सकते हैं।
| दृष्टिकोण | व्यावहारिक उत्तर |
|---|---|
| परिभाषा | दृष्टि-भाषा मॉडल दृश्य विशेषताओं को भाषा से जोड़ते हैं, ताकि कोई प्रणाली शब्दों की मदद से छवियों का वर्णन कर सके, उनकी तुलना कर सके, उन्हें खोज सके या उनके बारे में तर्क कर सके। |
| भ्रम | ऐसा कंप्यूटर विज़न जो मुक्त-रूप भाषा के बिना एक निश्चित लेबल का अनुमान लगाता है। |
| जोखिम | धाराप्रवाह विवरण उन वस्तुओं या संबंधों के नाम बता सकते हैं जो वास्तव में दिखाई नहीं देते। |
तुलना में विश्लेषण की इकाई की पहचान भी होनी चाहिए। दृष्टि-भाषा मॉडल पर कोई शोध-पत्र किसी मॉडल या एल्गोरिदम का अलग से अध्ययन कर सकता है, जबकि तैनात की गई सेवा में जानकारी पुनर्प्राप्ति, मार्ग-निर्धारण, कैशिंग, नीतियां, पहचान, उपयोगकर्ता इंटरफ़ेस और निगरानी भी शामिल होते हैं। दो उत्पाद एक ही प्रमुख शब्द का इस्तेमाल कर सकते हैं, लेकिन इस तकनीकी ढांचे के अलग-अलग हिस्सों को लागू कर सकते हैं। यह पूछें कि कौन-सा घटक परिभाषित करने वाला रूपांतरण करता है और बताए गए परिणाम के लिए किन अन्य घटकों की आवश्यकता है।
वर्तमान AI प्रणालियों में दृष्टि-भाषा मॉडल क्यों महत्वपूर्ण हैं
दृष्टि-भाषा मॉडल अब इसलिए महत्वपूर्ण हैं क्योंकि AI प्रणालियों को अधिक व्यापक संदर्भ, अधिक माध्यम, रनटाइम पर अधिक कंप्यूटिंग संसाधन, टूल तक व्यापक पहुंच और संगठनात्मक निर्णयों से गहरे जुड़ाव दिए जा रहे हैं। ऐसी परिस्थितियों में, जो बात पहले शोध का एक गौण विवरण लगती थी, वह विलंबता, सुरक्षा, सुगम्यता, पर्यावरणीय लागत, उत्पाद की गुणवत्ता या कानूनी जवाबदेही तय कर सकती है।
महत्वपूर्ण यह नहीं है कि दृष्टि-भाषा मॉडल एक प्रभावशाली परिणाम दे सकते हैं या नहीं। सवाल यह है कि क्या यह तकनीक प्रतिनिधि परिस्थितियों में महत्वपूर्ण परिणाम को बेहतर बनाती है और किसी सरल आधाररेखा की तुलना में अधिक प्रभावी ढंग से ऐसा करती है। हर परिणाम को एक औसत में समेटने के बजाय, परिणामों का वितरण, विफलता की श्रेणियां, उच्चतम छोर की विलंबता, संसाधनों का उपयोग और प्रभावित उपसमूहों की जानकारी दें।
मूल्यांकन में हर माध्यम को अलग-अलग जांचना चाहिए, परस्पर विरोधी इनपुट का परीक्षण करना चाहिए और समयगत या स्थानिक आधार-संबद्धता की पुष्टि करनी चाहिए। विभिन्न माध्यमों से मिला धाराप्रवाह उत्तर इस बात का प्रमाण नहीं है कि मॉडल ने सही संकेत पर ध्यान दिया। दृष्टि-भाषा मॉडल पर विशेष रूप से लागू करने पर, यह अनुशासन साक्ष्यों को अन्य परिस्थितियों में भी उपयोगी बनाता है: कोई दूसरी टीम यह आंक सकती है कि दावा किया गया लाभ किसी अलग मॉडल, भाषा, हार्डवेयर मंच, डेटासेट, उपयोगकर्ता समूह या जोखिम-सहनशीलता के स्तर में भी बने रहने की संभावना है या नहीं।
दृष्टि-भाषा मॉडल से मिलने वाले लाभ
दृष्टि-भाषा मॉडल इस्तेमाल करने का सबसे मजबूत कारण यह है कि वे अपनी लक्षित बाधा को सीधे दूर कर सकते हैं। कार्यान्वयन के आधार पर, लाभ बेहतर आधार-संबद्धता, अधिक सटीक निरूपण, बेहतर सामान्यीकरण, कम विलंबता, मेमोरी डेटा के कम स्थानांतरण, अधिक स्पष्ट जवाबदेही या मॉडल के प्रस्ताव और वास्तविक कार्रवाई के बीच अधिक सुरक्षित सीमा के रूप में सामने आ सकता है।
लाभों को निर्णयों और मापों के रूप में व्यक्त करना चाहिए। दृष्टि-भाषा मॉडल के लिए “अधिक बुद्धिमान” होना स्वीकृति का मानदंड नहीं है। उपयोगी लक्ष्य में कठिन मामलों की त्रुटि दर, परस्पर विरोधी साक्ष्य मिलने के बाद सुधार, ट्रैफ़िक के किसी निश्चित प्रतिशतक पर लागत, मानव समीक्षा में लगने वाला समय, अंशांकन या तय अधिकार सीमा के भीतर रखी गई कार्रवाइयों का प्रतिशत निर्दिष्ट हो सकता है।
दृष्टि-भाषा मॉडल को परिभाषित करने वाली विफलता
मुख्य सीमा यह है कि धाराप्रवाह विवरण उन वस्तुओं या संबंधों के नाम बता सकते हैं जो वास्तव में दिखाई नहीं देते। विकास पूरा हो जाने के बाद सूची में शामिल करने के लिए यह कोई गौण बात नहीं है। इसे शुरू से ही दृष्टि-भाषा मॉडल के लिए डेटा संग्रह, संरचना, अनुमतियों, मूल्यांकन, जारी करने के मानदंडों और निगरानी को दिशा देनी चाहिए।
दृष्टि-भाषा मॉडल के लिए कोई नियंत्रण तभी उपयोगी है, जब वह किसी महँगे या अपरिवर्तनीय परिणाम से पहले काम करे। विफलता के सबसे पहले दिखाई देने वाले संकेत की पहचान करें, एक सीमा या नियम तय करें, जवाबदेही के लिए किसी व्यक्ति को नामित करें और यह जाँचें कि स्थिति से उबरना संभव है या नहीं। उपयोग के आधार पर, उबरने का अर्थ जवाब देने से बचना, किसी सरल प्रणाली पर लौटना, और प्रमाण माँगना, मामले को किसी व्यक्ति तक पहुँचाना, मॉडल को पिछली स्थिति में लौटाना या किसी कार्रवाई को पूरी तरह रोक देना हो सकता है।
दृष्टि-भाषा मॉडल के लिए मूल्यांकन योजना
दृष्टि-भाषा मॉडल का मूल्यांकन शुरू करने के लिए पहले उस निर्णय को लिखें, जिसे लेने में प्रमाण मदद करेगा। उपयोग की जाने वाली आबादी, गलत नतीजे के परिणाम, निर्णय के समय वास्तव में उपलब्ध जानकारी और सबसे सरल विश्वसनीय विकल्प को परिभाषित करें। इससे कोई बेंचमार्क सिर्फ इसलिए लक्ष्य नहीं बन जाता कि उसे चलाना आसान है।
नियंत्रित तुलना के लिए एक ऐसे परीक्षण-समुच्चय का उपयोग करें, जिसे पहले नहीं छुआ गया हो; फिर चरणबद्ध परिचालन परिवेश में दृष्टि-भाषा मॉडल की पुष्टि करें। ऑफ़लाइन मूल्यांकन से विभिन्न रूपों की तुलना संभव होती है; शैडो मोड, कैनरी परीक्षण, दर सीमाएँ या अनुमोदन-द्वार यह दिखाते हैं कि वास्तविक ट्रैफ़िक, फ़ीडबैक लूप और लोग व्यवहार को कैसे बदलते हैं। तैनाती के चरण में रुकने की स्पष्ट शर्त होनी चाहिए—यह मानकर नहीं चलना चाहिए कि हर सुधार को पूरी तरह लागू करना उचित है।
दृष्टि-भाषा मॉडल के परिणामों को दोबारा उत्पन्न करने के लिए ज़रूरी इनपुट के संस्करण दर्ज करें: स्रोत डेटा, पूर्व-प्रसंस्करण, टोकनाइज़र या एनकोडर, मॉडल वेट, कॉन्फ़िगरेशन, प्रॉम्प्ट या नीति, रिट्रीवल इंडेक्स, मूल्यांकन-समुच्चय, हार्डवेयर संबंधी मान्यताएँ और सर्विंग कोड—जहाँ लागू हों। स्रोत-क्रम का पता न हो, तो टीम यह नहीं जान सकती कि बदला हुआ परिणाम तकनीक, परिवेश या पाइपलाइन में अनदेखे बदलाव के कारण आया है।
अंत में, पूछें कि कौन-सा निष्कर्ष इस दावे को गलत साबित करेगा कि दृष्टि-भाषा मॉडल मददगार हैं। अगर ऐसा कोई परिणाम नहीं है जो अपनाने के निर्णय को पलट सके, तो मूल्यांकन महज़ मार्केटिंग है। पहले से तय स्वीकृति-सीमाएँ और सुरक्षित रखा गया पुष्टिकरण-समुच्चय इस प्रक्रिया को प्रमाण में बदल देते हैं।
दृष्टि-भाषा मॉडल अपनाने से पहले पूछे जाने वाले प्रश्न
- उद्देश्य: दृष्टि-भाषा मॉडल किस मापने योग्य अड़चन को दूर करने के लिए बनाए गए हैं?
- कार्य-विधि: पाँच चरणों में से किस चरण में विशिष्ट रूपांतरण होता है?
- आधार-रेखा: खुले सिरे वाली भाषा का उपयोग किए बिना कोई तय लेबल बताने वाले कंप्यूटर विज़न या किसी अन्य सरल विकल्प की तुलना में इसका प्रदर्शन कैसा है?
- प्रमाण: किन सामान्य, कठिन, प्रतिकूल और उपसमूह मामलों का परीक्षण किया गया?
- संचालन: बड़े पैमाने पर उपयोग करने पर विलंबता, मेमोरी, कंप्यूटिंग, ऊर्जा, रखरखाव और समीक्षा की क्या लागत आती है?
- जोखिम: टीम यह कैसे पता लगाएगी कि धाराप्रवाह विवरण ऐसी वस्तुओं या संबंधों का नाम ले सकते हैं, जो वास्तव में दिखाई नहीं देते?
- स्थिति से उबरना: क्या नुकसान होने से पहले प्रणाली जवाब देने से बच सकती है, किसी विकल्प पर लौट सकती है, पिछली स्थिति में जा सकती है या मामला आगे पहुँचा सकती है?
दृष्टि-भाषा मॉडल के अध्ययन के लिए प्राथमिक स्रोत
दृष्टि-भाषा मॉडल से जुड़े एआई स्टैक के हिस्से को समझने के लिए प्रामाणिक शुरुआती स्रोतों में CLIP शोधपत्र और PaLM-E सन्निहित बहुमाध्यमी मॉडल शामिल हैं। इनके साथ संबंधित सटीक मॉडल, डेटासेट, हार्डवेयर और न्यायक्षेत्र के दस्तावेज़ भी पढ़ें। कोई सामान्य स्रोत कार्य-विधि को परिभाषित कर सकता है, लेकिन किसी विशेष कार्यान्वयन की उपयुक्तता केवल तैनाती-विशिष्ट प्रमाण से ही तय की जा सकती है।
दृष्टि-भाषा मॉडल के बारे में याद रखने योग्य बातें
दृष्टि-भाषा मॉडल एक व्यापक सामाजिक-तकनीकी प्रणाली के भीतर काम करने वाली एक परिभाषित कार्य-विधि हैं। उनका महत्व किसी विशिष्ट नतीजे को स्पष्ट शर्तों के तहत बेहतर बनाने में है, न कि केवल इस नाम में। पाँच चरणों का मानचित्र सूचना के प्रवाह को स्पष्ट करता है, तुलना बताती है कि ये मॉडल क्या नहीं हैं, और नियंत्रण-पथ यह दिखाता है कि जिम्मेदार संचालक कहाँ हस्तक्षेप कर सकता है।
दृष्टि-भाषा मॉडल के लिए व्यावहारिक नियम यह है कि उद्देश्य परिभाषित करें, विश्वसनीय आधार-रेखा से तुलना करें, सबसे महत्वपूर्ण विफलता की जाँच करें और बदलावों पर नज़र रखने के लिए ज़रूरी प्रमाण सुरक्षित रखें। ये बातें मौजूद हों, तो इस अवधारणा का मूल्यांकन इंजीनियरिंग और शासन संबंधी विकल्प के रूप में किया जा सकता है। इनके बिना, यह अज्ञात परिचालन जोखिम से जुड़ा एक आशाजनक नाम भर रह जाता है।


