
एआई की मूल बातें
AI गार्डरेल्स क्या हैं? उत्पादन प्रणालियाँ मॉडल व्यवहार को कैसे नियंत्रित करती हैं
AI गार्डरेल्स परतदार तकनीकी और प्रक्रियात्मक नियंत्रण हैं जो मॉडल या एजेंट के आसपास इनपुट, क्रिया, आउटपुट, और एस्केलेशन को सीमित करते हैं। यह मार्गदर्शिका तंत्र, समझौते, मूल्यांकन, और व्यावहारिक नियंत्रणों को समझाती है।

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
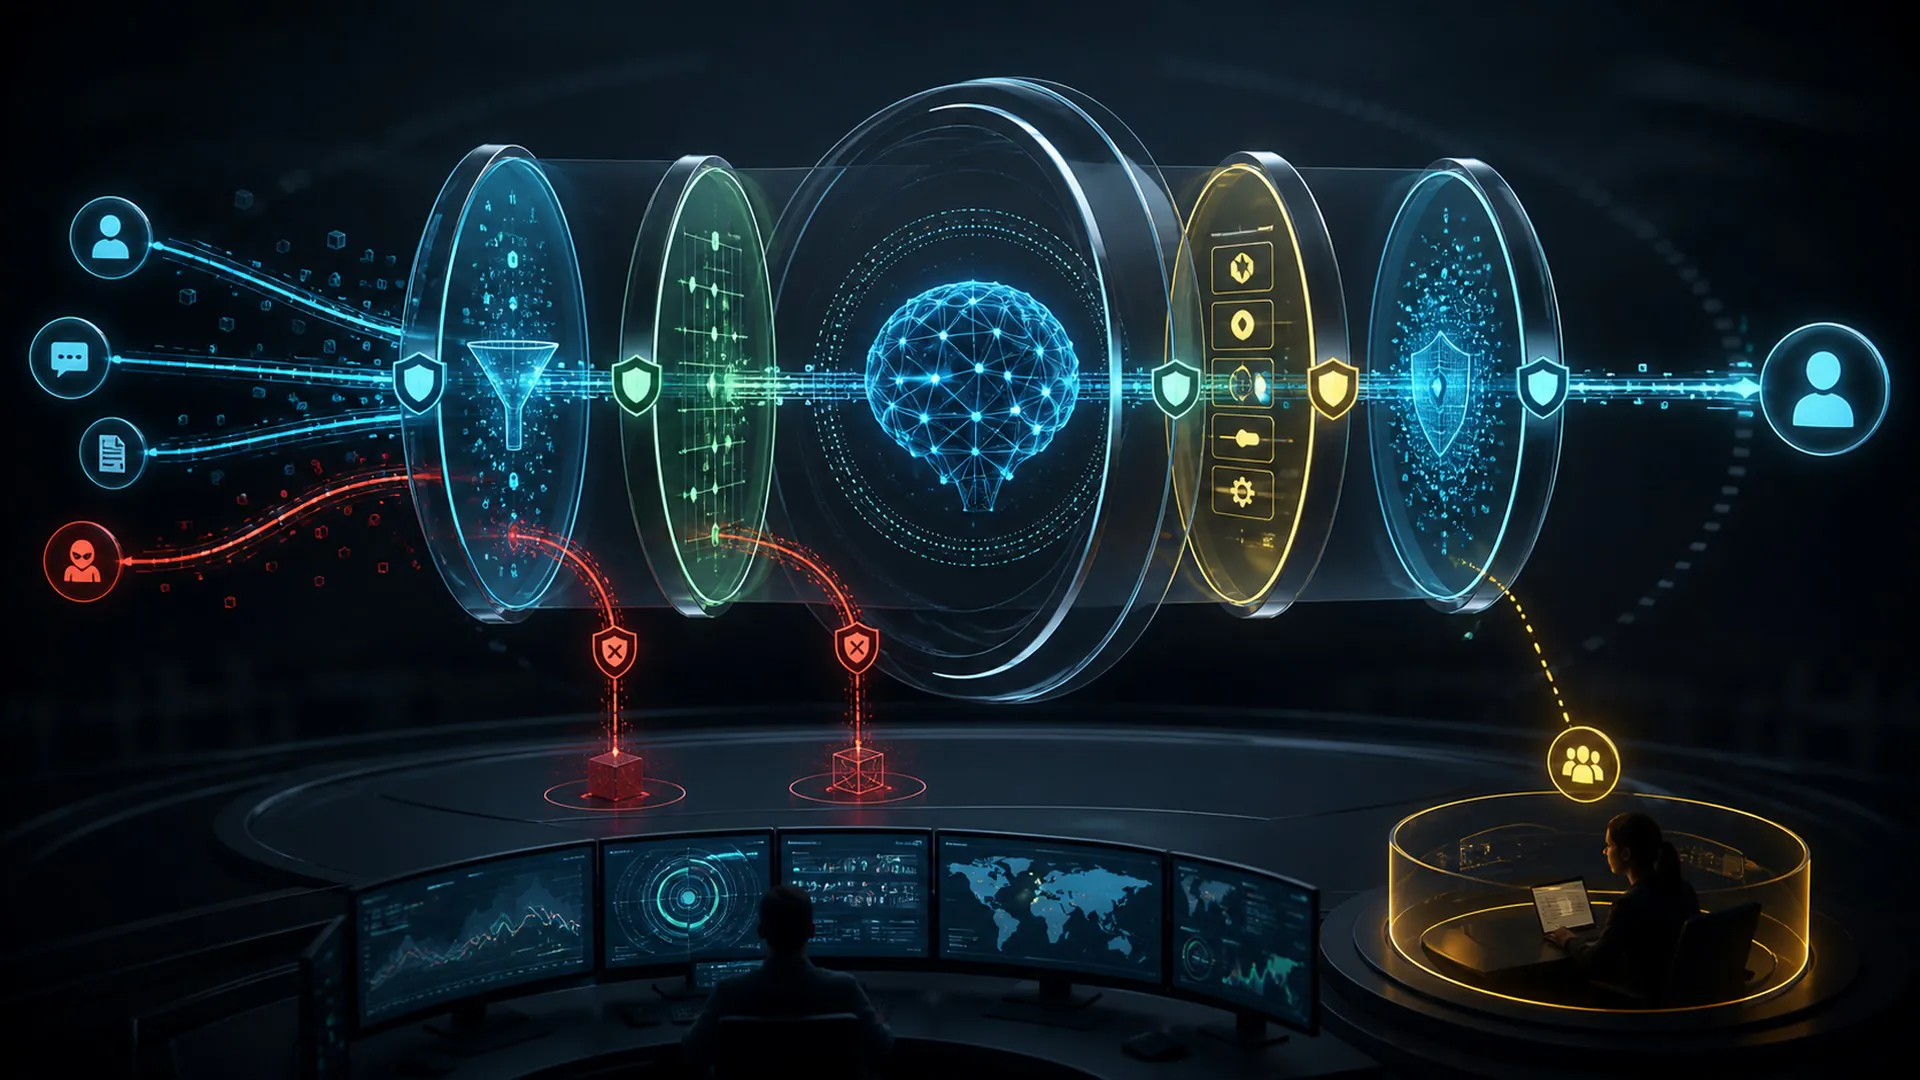
AI गार्डरेल्स बहु-स्तरीय तकनीकी और प्रक्रियात्मक नियंत्रण हैं जो मॉडल या एजेंट के आसपास इनपुट, क्रिया, आउटपुट और एस्केलेशन को सीमित करते हैं।
AI गार्डरेल्स को सटीक व्याख्या की आवश्यकता है क्योंकि इसका नाम एक विशिष्ट सूचना प्रवाह, प्रशिक्षण विकल्प, रनटाइम तंत्र या शासन सीमा को दर्शाता है। इसे “उन्नत AI” का पर्याय मानने से दावे परीक्षण योग्य नहीं रह जाते। यह मार्गदर्शिका अवधारणा को उसके इनपुट और धारणाओं से लेकर उसके देखे जा सकने वाले परिणाम तक ट्रैक करती है, और फिर उस शॉर्टकट का परीक्षण करती है जो इसके साथ सबसे अधिक भ्रमित हो सकता है।
AI गार्डरेल्स: परिभाषा, सीमा, और उद्देश्य
AI गार्डरेल्स बहु-स्तरीय तकनीकी और प्रक्रियात्मक नियंत्रण हैं जो मॉडल या एजेंट के आसपास इनपुट, क्रिया, आउटपुट और एस्केलेशन को सीमित करते हैं। परिभाषा में तीन व्यावहारिक प्रतिबद्धताएँ शामिल हैं: एक पहचान योग्य इनपुट होना, एक परिवर्तन या निर्णय जो AI गार्डरेल्स की विशेषता हो, और एक परिणाम जो निर्धारित लक्ष्य के विरुद्ध मूल्यांकन किया जा सके। यदि इन तत्वों में से कोई एक अनुपस्थित है, तो यह लेबल एक कार्यान्वित तंत्र के बजाय केवल एक आकांक्षा को दर्शा सकता है।
विश्वसनीय AI के लिए जीवनचक्र के दौरान प्रमाण आवश्यक होते हैं। नियंत्रण तभी सार्थक होता है जब उसका मालिक, दायरा, ट्रिगर, अपेक्षित व्यवहार, और सत्यापन विधि स्पष्ट हो। AI गार्डरेल्स के संदर्भ में यह प्रणालीगत दृष्टिकोण महत्वपूर्ण है क्योंकि प्रदर्शन को आसपास के डेटा, इंटरफ़ेस, हार्डवेयर, अनुमतियों और लोगों द्वारा निर्धारित किया जा सकता है, भले ही मूल मॉडल अपरिवर्तित रहे। इसलिए एक उपयोगी व्याख्या मॉडल के सीखे हुए व्यवहार को उस उत्पाद से अलग करती है जो यह तय करता है कि वह व्यवहार कब, कहाँ और किस अधिकार के साथ उपयोग किया जाएगा।
सबसे निकटतम भ्रामक शॉर्टकट एक एकल सिस्टम प्रॉम्प्ट है जो हर सीमा को लागू करने की अपेक्षा रखता है। यह AI गार्डरेल्स के साथ एक दृश्य विशेषता साझा कर सकता है, फिर भी यह कारणात्मक कथा को बदल देता है: अलग प्रमाण सफलता स्थापित करेंगे, अलग संसाधन लागत को प्रमुखता देंगे, और अलग नियंत्रण हानि को रोकेंगे। इसलिए सीमा शब्दात्मक नहीं, बल्कि परिचालनात्मक होती है।
AI गार्डरेल्स का पाँच‑स्तरीय संचालन मानचित्र
यह चित्र AI गार्डरेल्स के लिए एक संक्षिप्त कारणात्मक मानचित्र है, यह दावा नहीं करता कि हर कार्यान्वयन में पाँच सॉफ़्टवेयर घटक उपयोग होते हैं। कुछ प्रणालियाँ चरणों को मिलाती हैं और अन्य उन्हें लूप में दोहराती हैं। यह मानचित्र उपयोगी बना रहता है क्योंकि यह प्रत्येक सूचना या अधिकार परिवर्तन को एक मालिक, एक इनपुट, एक आउटपुट और एक परीक्षण देने के लिए बाध्य करता है।
1. अनुरोध और लागू नीति का वर्गीकरण: AI गार्डरेल्स में इनपुट और धारणाएँ
AI गार्डरेल्स के इस चरण में, प्रणाली को अनुरोध और लागू नीति का वर्गीकरण करना चाहिए। उपयोगी प्रश्न केवल यह नहीं है कि वह संचालन हो रहा है या नहीं, बल्कि यह कि वह कौन सी जानकारी उपयोग करता है, कौन सी स्थिति बदलता है, और कौन सा प्रमाण दर्शाता है कि परिवर्तन वैध था। एक समीक्षक को इस संचालन को उस एकल सिस्टम प्रॉम्प्ट से अलग पहचानने में सक्षम होना चाहिए जो हर सीमा को लागू करने की अपेक्षा रखता है, और समान घोषित शर्तों के तहत उसका परिणाम पुन: उत्पन्न कर सकता है।
इस AI गार्डरेल्स चरण में हस्तांतरण घोषित लक्ष्य से शुरू होता है और ऐसा परिणाम देना चाहिए जो संदर्भ, उपकरण और डेटा पहुँच को सीमित करने का समर्थन कर सके। अनिश्चितता, अस्वीकृत विकल्प, संसाधन उपयोग, और सीमा पर लागू किसी भी मानव या सॉफ़्टवेयर नियंत्रण को रिकॉर्ड करें। यह ट्रेस वह जगह है जहाँ टीमें यह पता लगा सकती हैं कि गार्डरेल्स वैध कार्य को रोक सकते हैं, बायपास हो सकते हैं, या एक गलत सुरक्षा भावना पैदा कर सकते हैं, इससे पहले कि वही कमजोरी एक महत्वपूर्ण आउटपुट तक पहुँचे।
2. संदर्भ, उपकरण, और डेटा पहुँच को सीमित करना: AI गार्डरेल्स में प्रतिनिधित्व या निर्णय
AI गार्डरेल्स के इस चरण में, प्रणाली को संदर्भ, उपकरण, और डेटा पहुँच को सीमित करना चाहिए। उपयोगी प्रश्न केवल यह नहीं है कि वह संचालन हो रहा है या नहीं, बल्कि यह कि वह कौन सी जानकारी उपयोग करता है, कौन सी स्थिति बदलता है, और कौन सा प्रमाण दर्शाता है कि परिवर्तन वैध था। एक समीक्षक को इस संचालन को उस एकल सिस्टम प्रॉम्प्ट से अलग पहचानने में सक्षम होना चाहिए जो हर सीमा को लागू करने की अपेक्षा रखता है, और समान घोषित शर्तों के तहत उसका परिणाम पुन: उत्पन्न कर सकता है।
इस AI गार्डरेल्स चरण में हस्तांतरण अनुरोध और लागू नीति के वर्गीकरण से शुरू होता है और ऐसा परिणाम देना चाहिए जो कार्यान्वयन से पहले प्रस्तावित कार्यों को सत्यापित करने का समर्थन कर सके। अनिश्चितता, अस्वीकृत विकल्प, संसाधन उपयोग, और सीमा पर लागू किसी भी मानव या सॉफ़्टवेयर नियंत्रण को रिकॉर्ड करें। यह ट्रेस वह जगह है जहाँ टीमें यह पता लगा सकती हैं कि गार्डरेल्स वैध कार्य को रोक सकते हैं, बायपास हो सकते हैं, या एक गलत सुरक्षा भावना पैदा कर सकते हैं, इससे पहले कि वही कमजोरी एक महत्वपूर्ण आउटपुट तक पहुँचे।
3. प्रस्तावित कार्यों को निष्पादन से पहले सत्यापित करें: AI गार्डरेल्स में विशिष्ट परिवर्तन
AI गार्डरेल्स के इस चरण में, सिस्टम को प्रस्तावित कार्यों को निष्पादन से पहले सत्यापित करना चाहिए। उपयोगी प्रश्न केवल यह नहीं है कि वह ऑपरेशन होता है या नहीं, बल्कि कौन‑सी जानकारी वह उपभोग करता है, कौन‑सी स्थिति बदलता है, और कौन‑से प्रमाण यह सिद्ध करते हैं कि परिवर्तन वैध था। एक समीक्षक को यह पहचानने में सक्षम होना चाहिए कि वह ऑपरेशन एकल सिस्टम प्रॉम्प्ट से अलग है, जो प्रत्येक सीमा को लागू करने की अपेक्षा रखता है और समान घोषित शर्तों के तहत उसका परिणाम पुनः उत्पन्न करता है।
AI गार्डरेल्स चरण में हस्तांतरण इस बात से शुरू होता है कि संदर्भ, उपकरण और डेटा पहुँच को सीमित किया जाए और यह एक ऐसे परिणाम के साथ समाप्त होना चाहिए जो आउटपुट और बदली हुई स्थिति की जाँच का समर्थन कर सके। अनिश्चितता, अस्वीकृत विकल्प, संसाधन उपयोग, और सीमा पर लागू किसी भी मानव या सॉफ़्टवेयर नियंत्रण को रिकॉर्ड करें। यही ट्रेस टीमों को यह पहचानने में मदद करता है कि गार्डरेल्स वैध कार्य को रोक सकते हैं, बायपास हो सकते हैं, या समान कमजोरी के परिणामस्वरूप महत्वपूर्ण आउटपुट उत्पन्न होने से पहले सुरक्षा का झूठा अहसास पैदा कर सकते हैं।
4. आउटपुट और बदली हुई स्थिति की जाँच: AI गार्डरेल्स में प्रतिबंध और सत्यापन सीमा
AI गार्डरेल्स के इस चरण में, सिस्टम को आउटपुट और बदली हुई स्थिति की जाँच करनी चाहिए। उपयोगी प्रश्न केवल यह नहीं है कि वह ऑपरेशन होता है या नहीं, बल्कि कौन‑सी जानकारी वह उपभोग करता है, कौन‑सी स्थिति बदलता है, और कौन‑से प्रमाण यह सिद्ध करते हैं कि परिवर्तन वैध था। एक समीक्षक को यह पहचानने में सक्षम होना चाहिए कि वह ऑपरेशन एकल सिस्टम प्रॉम्प्ट से अलग है, जो प्रत्येक सीमा को लागू करने की अपेक्षा रखता है और समान घोषित शर्तों के तहत उसका परिणाम पुनः उत्पन्न करता है।
AI गार्डरेल्स चरण में हस्तांतरण इस बात से शुरू होता है कि प्रस्तावित कार्यों को निष्पादन से पहले सत्यापित किया जाए और यह एक ऐसे परिणाम के साथ समाप्त होना चाहिए जो घटनाओं से एस्केलेट, लॉग और सुधार का समर्थन कर सके। अनिश्चितता, अस्वीकृत विकल्प, संसाधन उपयोग, और सीमा पर लागू किसी भी मानव या सॉफ़्टवेयर नियंत्रण को रिकॉर्ड करें। यही ट्रेस टीमों को यह पहचानने में मदद करता है कि गार्डरेल्स वैध कार्य को रोक सकते हैं, बायपास हो सकते हैं, या समान कमजोरी के परिणामस्वरूप महत्वपूर्ण आउटपुट उत्पन्न होने से पहले सुरक्षा का झूठा अहसास पैदा कर सकते हैं।
5. घटनाओं से एस्केलेट, लॉग और सुधार: AI गार्डरेल्स में आउटपुट, फीडबैक और स्टॉप नियम
AI गार्डरेल्स के इस चरण में, सिस्टम को घटनाओं से एस्केलेट, लॉग और सुधार करना चाहिए। उपयोगी प्रश्न केवल यह नहीं है कि वह ऑपरेशन होता है या नहीं, बल्कि कौन‑सी जानकारी वह उपभोग करता है, कौन‑सी स्थिति बदलता है, और कौन‑से प्रमाण यह सिद्ध करते हैं कि परिवर्तन वैध था। एक समीक्षक को यह पहचानने में सक्षम होना चाहिए कि वह ऑपरेशन एकल सिस्टम प्रॉम्प्ट से अलग है, जो प्रत्येक सीमा को लागू करने की अपेक्षा रखता है और समान घोषित शर्तों के तहत उसका परिणाम पुनः उत्पन्न करता है।
AI गार्डरेल्स चरण में हस्तांतरण इस बात से शुरू होता है कि आउटपुट और बदली हुई स्थिति की जाँच की जाए और यह एक ऐसे परिणाम के साथ समाप्त होना चाहिए जो मॉनिटरिंग या अंतिम निर्णय का समर्थन कर सके। अनिश्चितता, अस्वीकृत विकल्प, संसाधन उपयोग, और सीमा पर लागू किसी भी मानव या सॉफ़्टवेयर नियंत्रण को रिकॉर्ड करें। यही ट्रेस टीमों को यह पहचानने में मदद करता है कि गार्डरेल्स वैध कार्य को रोक सकते हैं, बायपास हो सकते हैं, या समान कमजोरी के परिणामस्वरूप महत्वपूर्ण आउटपुट उत्पन्न होने से पहले सुरक्षा का झूठा अहसास पैदा कर सकते हैं।
AI गार्डरेल्स मानचित्र को आगे की ओर पढ़ें ताकि उत्पादन को समझ सकें और पीछे की ओर पढ़ें ताकि विफलता का निदान कर सकें। आगे की विश्लेषण पूछती है कि एक चरण अगले चरण को कैसे आपूर्ति करता है। पीछे की विश्लेषण एक गलत, धीमी, महंगी या असुरक्षित परिणाम से शुरू होती है और यह पता लगाती है कि कौन‑सी पूर्वधारणा ने इसे संभव बनाया। उल्टी दिशा अक्सर वह जगह होती है जहाँ टीम पाती है कि निर्णायक त्रुटि मॉडल द्वारा कुछ उत्पन्न करने से पहले ही हुई थी।
एक कार्यान्वित AI गार्डरेल्स उदाहरण
एक वित्तीय सहायक वायर निर्देश का मसौदा तैयार कर सकता है, लेकिन एक निर्धारक नियम और अधिकृत समीक्षक को निष्पादन को मंजूरी देनी चाहिए।
यह उदाहरण सूचनात्मक है क्योंकि AI गार्डरेल्स को देखे जा सकने वाले इनपुट, मध्यवर्ती स्थितियों और परिणाम से जोड़ा जा सकता है, न कि केवल एक परिष्कृत प्रदर्शन के माध्यम से आंका जा सकता है। एक कठोर परीक्षण में सामान्य, कठिन और जानबूझकर भ्रामक मामलों को परिदृश्य के आसपास बनाया जाएगा, तकनीक के बिना एक बेसलाइन संरक्षित की जाएगी, और औसत प्रदर्शन तथा व्यक्तिगत विफलताओं की गंभीरता दोनों को रिकॉर्ड किया जाएगा।
AI गार्डरेल्स उदाहरण में एक धारण को बदलें और विश्लेषण दोहराएँ। आवश्यक इनपुट को हटाएँ, विरोधी संकेत प्रस्तुत करें, कंप्यूट को सीमित करें, उपयोगकर्ता जनसंख्या बदलें, या सिस्टम को परहेज़ करने के लिए मजबूर करें। एक तंत्र जो केवल एक सावधानीपूर्वक व्यवस्थित प्रदर्शन में सफल होता है, यह सिद्ध नहीं करता कि वह संचालन वातावरण में सामान्यीकृत होता है।
AI गार्डरेल्स बनाम इसका सबसे आम शॉर्टकट
AI गार्डरेल्स अक्सर एकल सिस्टम प्रॉम्प्ट तक सीमित कर दिया जाता है, जो प्रत्येक सीमा को लागू करने की अपेक्षा रखता है। यह सरलीकरण उस सीमा को हटा देता है जो अवधारणा को परिभाषित करती है। इससे खरीदारों को असमान उत्पादों की तुलना करने, शोधकर्ताओं को प्रयोग के परिणामों को अधिक बढ़ा‑चढ़ा कर पेश करने, और ऑपरेटरों को तैनाती के बाद गलत संकेत की निगरानी करने की प्रवृत्ति होती है।
| दृष्टिकोण | व्यावहारिक उत्तर |
|---|---|
| परिभाषा | AI गार्डरेल्स बहु-परत तकनीकी और प्रक्रियात्मक नियंत्रण होते हैं जो मॉडल या एजेंट के आसपास इनपुट, क्रिया, आउटपुट और एस्केलेशन को सीमित करते हैं। |
| भ्रम | हर सीमा को लागू करने के लिए एक एकल सिस्टम प्रॉम्प्ट अपेक्षित। |
| जोखिम | गार्डरेल्स वैध कार्य को रोक सकते हैं, बायपास किए जा सकते हैं, या सुरक्षा का झूठा अहसास पैदा कर सकते हैं। |
तुलना को विश्लेषण इकाई की भी पहचान करनी चाहिए। AI गार्डरेल्स पर एक पेपर मॉडल या एल्गोरिदम को अलग कर सकता है, जबकि एक तैनात सेवा में पुनःप्राप्ति, रूटिंग, कैशिंग, नीति, पहचान, उपयोगकर्ता इंटरफ़ेस और मॉनिटरिंग जोड़ते हैं। दो उत्पाद समान शीर्षक शब्द का उपयोग कर सकते हैं जबकि उस स्टैक के विभिन्न भागों को लागू करते हैं। पूछें कि कौन सा घटक परिभाषित परिवर्तन करता है और रिपोर्ट किए गए परिणाम के लिए कौन से अन्य घटक आवश्यक हैं।
वर्तमान AI प्रणालियों में AI गार्डरेल्स क्यों महत्वपूर्ण हैं
AI गार्डरेल्स अब महत्वपूर्ण हैं क्योंकि AI प्रणालियों को बड़े संदर्भ, अधिक मोडालिटी, अधिक रनटाइम कंप्यूट, व्यापक टूल एक्सेस और संगठनात्मक निर्णयों से गहरी कनेक्शन प्रदान किए जा रहे हैं। इन परिस्थितियों में, जो पहले एक शोध विवरण जैसा लगता था, वह लेटेंसी, सुरक्षा, पहुँच, पर्यावरणीय लागत, उत्पाद गुणवत्ता या कानूनी उत्तरदायित्व निर्धारित कर सकता है।
संबंधित माप यह नहीं है कि AI गार्डरेल्स एक प्रभावशाली परिणाम उत्पन्न कर सकते हैं या नहीं। यह यह है कि तकनीक प्रतिनिधि स्थितियों में महत्वपूर्ण परिणाम को सुधारती है और यह सरल बेसलाइन की तुलना में अधिक प्रभावी है। प्रत्येक परिणाम को एक औसत में संक्षिप्त करने के बजाय वितरण, विफलता श्रेणियाँ, टेल लेटेंसी, संसाधन उपयोग और प्रभावित उपसमूहों की रिपोर्ट करें।
तकनीकी मीट्रिक और लोगों पर प्रभाव दोनों की निगरानी करें। अनिश्चितता को दस्तावेज़ करें, वंशावली को संरक्षित रखें, एस्केलेशन को संभव बनाएं, और सिस्टम को बदलती वास्तविक‑विश्व स्थितियों के सामने आने से पहले पुनर्प्राप्ति को डिज़ाइन करें। विशेष रूप से AI गार्डरेल्स पर लागू करने पर, यह अनुशासन साक्ष्य को पोर्टेबल बनाता है: दूसरी टीम यह आकलन कर सकती है कि दावा किया गया लाभ अलग मॉडल, भाषा, हार्डवेयर प्लेटफ़ॉर्म, डेटासेट, उपयोगकर्ता जनसंख्या या जोखिम सहनशीलता में टिकेगा या नहीं।
AI गार्डरेल्स द्वारा प्रदान किए जा सकने वाले लाभ
AI गार्डरेल्स का उपयोग करने का सबसे मजबूत कारण यह है कि यह सीधे अपने इरादे वाले बाधा को संबोधित कर सकता है। कार्यान्वयन पर निर्भर करते हुए, लाभ बेहतर ग्राउंडिंग, अधिक सटीक प्रतिनिधित्व, सुधरी हुई सामान्यीकरण, कम लेटेंसी, घटित मेमोरी मूवमेंट, स्पष्ट जवाबदेही, या मॉडल प्रस्ताव और वास्तविक कार्रवाई के बीच सुरक्षित सीमा के रूप में प्रकट हो सकता है।
लाभों को निर्णयों और मापों के रूप में व्यक्त किया जाना चाहिए। “अधिक बुद्धिमान” AI गार्डरेल्स के लिए स्वीकृति मानदंड नहीं है। एक उपयोगी लक्ष्य कठिन मामलों में त्रुटि दर, विरोधाभासी साक्ष्य के बाद पुनर्प्राप्ति, ट्रैफ़िक के एक प्रतिशत पर लागत, मानव‑समीक्षा समय, कैलिब्रेशन, या परिभाषित अधिकार सीमा के भीतर रखी गई कार्रवाइयों का प्रतिशत निर्दिष्ट कर सकता है।
AI गार्डरेल्स को परिभाषित करने वाला विफलता मोड
मुख्य सीमा यह है कि गार्डरेल्स वैध कार्य को रोक सकते हैं, बायपास किए जा सकते हैं, या सुरक्षा का झूठा अहसास पैदा कर सकते हैं। यह विफलता विकास समाप्त होने के बाद सूचीबद्ध करने के लिए बाद की सोच नहीं है। इसे शुरुआत से ही AI गार्डरेल्स के लिए डेटा संग्रह, आर्किटेक्चर, अनुमतियों, मूल्यांकन, रिलीज़ गेट और मॉनिटरिंग को आकार देना चाहिए।
AI गार्डरेल्स के लिए एक नियंत्रण तभी उपयोगी है जब वह महंगे या अपरिवर्तनीय परिणाम से पहले कार्य करे। विफलता के सबसे प्रारम्भिक देखे जा सकने वाले संकेतक की पहचान करें, एक थ्रेशहोल्ड या नियम निर्धारित करें, जिम्मेदार मालिक को सौंपें, और पुनर्प्राप्ति का परीक्षण करें। उपयोग केस पर निर्भर करते हुए, पुनर्प्राप्ति का अर्थ हो सकता है कार्य से परहेज करना, सरल सिस्टम पर वापस जाना, अधिक साक्ष्य का अनुरोध करना, व्यक्ति तक एस्केलेट करना, मॉडल को रोल‑बैक करना, या पूरी तरह से कार्रवाई को रोकना।
AI गार्डरेल्स के लिए मूल्यांकन योजना
AI गार्डरेल्स का मूल्यांकन शुरू करने के लिए वह निर्णय लिखें जिसे साक्ष्य को समर्थन देना चाहिए। संचालन जनसंख्या, गलत परिणाम का परिणाम, निर्णय समय पर वास्तव में उपलब्ध जानकारी, और सबसे सरल विश्वसनीय विकल्प को परिभाषित करें। यह सुनिश्चित करता है कि कोई बेंचमार्क केवल इसलिए लक्ष्य न बन जाए क्योंकि उसे चलाना आसान है।
नियंत्रित तुलना के लिए एक अपरिवर्तित परीक्षण सेट का उपयोग करें, फिर AI गार्डरेल्स को चरणबद्ध संचालन वातावरण में मान्य करें। ऑफ़लाइन मूल्यांकन विभिन्नताओं को तुलनीय बनाता है; शैडो मोड, कैनरी, दर सीमाएँ, या अनुमोदन गेट्स यह दिखाते हैं कि वास्तविक ट्रैफ़िक, फ़ीडबैक लूप और लोग व्यवहार कैसे बदलते हैं। परिनियोजन चरण में स्पष्ट रोक शर्त होनी चाहिए, न कि यह मानते हुए कि हर सुधार को पूर्ण रोल‑आउट मिलना चाहिए।
AI गार्डरेल्स को पुनरुत्पादित करने के लिए आवश्यक इनपुट्स का संस्करण बनाएं: स्रोत डेटा, प्री‑प्रोसेसिंग, टोकनाइज़र या एन्कोडर, मॉडल वज़न, कॉन्फ़िगरेशन, प्रॉम्प्ट या नीति, पुनर्प्राप्ति इंडेक्स, मूल्यांकन सेट, हार्डवेयर धारणाएँ, और लागू होने पर सर्विंग कोड। बिना वंशावली के, टीम यह नहीं बता सकती कि बदलते परिणाम तकनीक से आए, पर्यावरण से, या अनदेखी पाइपलाइन संपादन से।
अंत में, यह पूछें कि कौन‑सी खोज AI गार्डरेल्स के सहायक होने के दावे को खारिज कर देगी। यदि कोई परिणाम अपनाने के निर्णय को उलट नहीं सकता, तो मूल्यांकन केवल मार्केटिंग है। पूर्व‑निर्धारित स्वीकृति थ्रेशोल्ड और संरक्षित पुष्टि सेट इस अभ्यास को साक्ष्य में बदल देते हैं।
AI गार्डरेल्स अपनाने से पहले पूछने वाले प्रश्न
- उद्देश्य: AI गार्डरेल्स किस मापनीय बाधा को हल करने के लिए लक्षित है?
- तंत्र: पाँच चरणों में से कौन‑सा विशिष्ट परिवर्तन शामिल करता है?
- बेसलाइन: यह एकल सिस्टम प्रॉम्प्ट के साथ तुलना में कैसे है, जो हर सीमा को लागू करने की अपेक्षा रखता है, या किसी अन्य सरल विकल्प के साथ?
- साक्ष्य: कौन‑से सामान्य, कठिन, प्रतिकूल, और उपसमूह मामलों का परीक्षण किया गया?
- ऑपरेशन्स: स्केल पर कौन‑से विलंब, मेमोरी, कंप्यूट, ऊर्जा, रखरखाव, और समीक्षा लागतें प्रकट होती हैं?
- जोखिम: टीम कैसे पता लगाएगी कि गार्डरेल्स वैध कार्य को ब्लॉक कर रहे हैं, बाईपास हो रहे हैं, या सुरक्षा का झूठा अहसास पैदा कर रहे हैं?
- रिकवरी: क्या सिस्टम हानि से पहले रोक सकता है, बैक‑ऑफ़, रोल‑बैक, या एस्केलेट कर सकता है?
AI गार्डरेल्स के अध्ययन के लिए प्राथमिक स्रोत
AI गार्डरेल्स के आसपास AI स्टैक के भाग के लिए अधिकारिक प्रारंभिक बिंदु में NIST AI Risk Management Framework, C2PA specifications, NIST Privacy Framework शामिल हैं। इन्हें सटीक मॉडल, डेटासेट, हार्डवेयर, और संबंधित अधिकार क्षेत्र के दस्तावेज़ के साथ पढ़ें। एक सामान्य स्रोत तंत्र को परिभाषित कर सकता है, लेकिन केवल परिनियोजन‑विशिष्ट साक्ष्य यह स्थापित कर सकते हैं कि कोई विशेष कार्यान्वयन उपयुक्त है।
AI गार्डरेल्स के बारे में याद रखने योग्य बातें
AI गार्डरेल्स एक बड़े सामाजिक‑तकनीकी प्रणाली के भीतर परिभाषित तंत्र है। इसका मूल्य स्पष्ट शर्तों के तहत एक विशिष्ट परिणाम को सुधारने से आता है, न कि लेबल से। पाँच‑चरणीय मानचित्र इसकी सूचना प्रवाह को दृश्य बनाता है, तुलना यह पहचानती है कि यह क्या नहीं है, और नियंत्रण पथ दर्शाता है कि जिम्मेदार ऑपरेटर कहाँ हस्तक्षेप कर सकता है।
AI गार्डरेल्स के लिए व्यावहारिक नियम है कि उद्देश्य को परिभाषित करें, विश्वसनीय बेसलाइन के विरुद्ध तुलना करें, सबसे महत्वपूर्ण विफलता का परीक्षण करें, और परिवर्तन की निगरानी के लिए आवश्यक साक्ष्य रखें। इन तत्वों के साथ, अवधारणा एक इंजीनियरिंग और शासन विकल्प बन जाती है जिसे मूल्यांकित किया जा सकता है। इनके बिना, यह एक आशाजनक नाम बना रहता है जो अज्ञात संचालन जोखिम से जुड़ा है।


