
सर्वश्रेष्ठ
10 सर्वश्रेष्ठ AI वेब स्क्रैपिंग टूल्स (सितंबर 2026)

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
हमारे समीक्षा किए गए उत्पादों के लिंक उपयोग करने पर Unite.AI को मुआवज़ा मिल सकता है। इससे हमारे संपादकीय मूल्यांकन प्रभावित नहीं होते। हमारा सहबद्ध प्रकटीकरण पढ़ें.
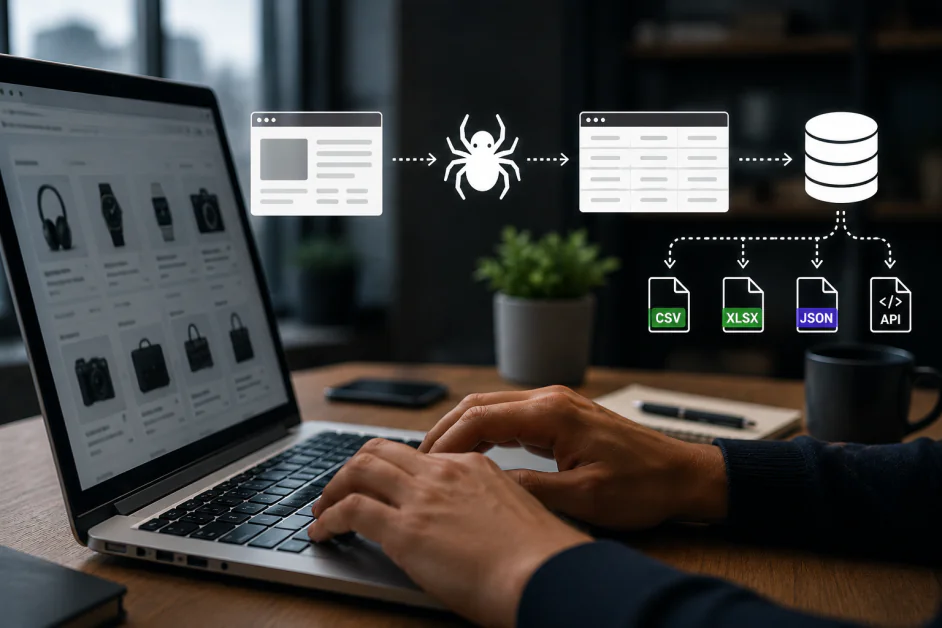
AI वेब स्क्रैपिंग टूल्स अब केवल पेज पार्सर नहीं रहे। अब सबसे अच्छे प्लेटफ़ॉर्म टीमों को सार्वजनिक वेब डेटा एकत्र करने, गंदे पेजों को संरचित डेटासेट में बदलने, रिट्रीवल‑ऑगमेंटेड जेनरेशन सिस्टम को फ़ीड करने, बाज़ारों की निगरानी करने और AI एजेंट्स को विश्वसनीय वेब संदर्भ प्रदान करने में मदद करते हैं।
यह बदलाव महत्वपूर्ण है क्योंकि स्क्रैपिंग अब अधिक मूल्यवान और सही ढंग से करना कठिन हो गया है। आधुनिक वेबसाइटें गतिशील, व्यक्तिगत, भारी स्क्रिप्टेड और अक्सर एंटी‑अब्यूज़ सिस्टम से सुरक्षित होती हैं। एक उपयोगी स्क्रैपिंग टूल को केवल HTML निकालने से अधिक करना पड़ता है। इसे रेंडरिंग, एक्सट्रैक्शन लॉजिक, शेड्यूलिंग, डेटा क्वालिटी, अनुपालन और डेटा को वास्तविक उपयोग सिस्टम में हस्तांतरित करने की क्षमता को संभालना चाहिए।
सही विकल्प कार्य पर निर्भर करता है। कुछ टीमों को बड़े सार्वजनिक‑डेटा प्रोग्रामों के लिए एंटरप्राइज़‑ग्रेड इन्फ्रास्ट्रक्चर चाहिए। अन्य को LLM‑तैयार Markdown, बिना‑कोड रोबोट के लिए आवर्ती रिसर्च, डेवलपर प्लेटफ़ॉर्म के लिए ब्राउज़र ऑटोमेशन, या विशेष सर्च रिज़ल्ट API चाहिए। नीचे दिए गए टूल्स इन विभिन्न दृष्टिकोणों को कवर करते हैं।
हमारी टीम ने इस गाइड में प्रत्येक समाधान का स्वतंत्र रूप से मूल्यांकन किया, इसकी क्षमताओं, व्यावहारिक ताकतों, सीमाओं और हमारे रैंकिंग में दर्शाए गए उपयोग‑केस के लिए उपयुक्तता का आकलन किया।
सर्वश्रेष्ठ AI वेब स्क्रैपिंग टूल्स की तुलना
| AI टूल | सबसे उपयुक्त | मुख्य ताकतें |
|---|---|---|
| Bright Data | एंटरप्राइज़ वेब स्क्रैपिंग, प्रॉक्सी इन्फ्रास्ट्रक्चर, और AI डेटा पाइपलाइन | स्क्रेपर API, ब्राउज़र API, स्क्रेपर स्टूडियो, वेब अनलॉकर, प्रॉक्सी इन्फ्रास्ट्रक्चर, डेटासेट्स, RAG वर्कफ़्लो |
| Firecrawl | वेबसाइट को साफ़, LLM‑तैयार सामग्री में बदलना AI एप्लिकेशन के लिए | स्क्रैप, क्रॉल, सर्च, मैप, मॉनिटर, Markdown, संरचित JSON, ब्राउज़र इंटरैक्शन, API, MCP, ओपन सोर्स |
| Apify | डेवलपर्स के लिए स्केलेबल स्क्रेपर, ब्राउज़र ऑटोमेशन, और डेटा एजेंट्स बनाना | ऐक्टर मार्केटप्लेस, Crawlee, Playwright, Puppeteer, Selenium, शेड्यूलिंग, प्रॉक्सी, डेटासेट्स, API, MCP इंटीग्रेशन |
| Browse AI | नो‑कोड वेब स्क्रैपिंग, वेबसाइट मॉनिटरिंग, और आवर्ती व्यावसायिक डेटा संग्रह | AI रोबोट, पॉइंट‑एंड‑क्लिक ट्रेनिंग, वेबसाइट मॉनिटरिंग, शेड्यूल्ड एक्सट्रैक्शन, प्री‑बिल्ट रोबोट, इंटीग्रेशन |
| SearchAPI | AI, SEO, और रिसर्च वर्कफ़्लो के लिए रियल‑टाइम SERP और सर्च‑इंजन डेटा | Google, Google Maps, Bing, YouTube, शॉपिंग और न्यूज़ डेटा, संरचित JSON, जियो‑टार्गेटिंग, प्रॉक्सी रोटेशन, रिट्राईज़, MCP |
| ScrapingBee | डेवलपर‑फ़्रेंडली स्क्रैपिंग API, AI एक्सट्रैक्शन और जावास्क्रिप्ट रेंडरिंग के साथ | नेचुरल‑लैंग्वेज एक्सट्रैक्शन, संरचित JSON, Markdown, जावास्क्रिप्ट परिदृश्य, प्रॉक्सी रोटेशन, स्क्रीनशॉट, डेडिकेटेड API, CLI, MCP |
| Octoparse | डायनामिक वेबसाइटों और आवर्ती क्लाउड जॉब्स की विज़ुअल नो‑कोड स्क्रैपिंग | विज़ुअल वर्कफ़्लो बिल्डर, AI ऑटो‑डिटेक्शन, क्लाउड एक्सट्रैक्शन, टेम्प्लेट्स, IP रोटेशन, शेड्यूलिंग, एक्सपोर्ट्स, API |
| Oxylabs | एंटरप्राइज़ स्क्रैपिंग API, AI ग्राउंडिंग, और कठिन सार्वजनिक वेबसाइटें | वेब स्क्रेपर API, AI स्टूडियो, हेडलेस ब्राउज़र, वेब अनब्लॉकर, फ़ास्ट सर्च API, संरचित डेटा, जियो‑टार्गेटिंग |
| Diffbot | ऑटोमैटिक पेज क्लासिफिकेशन, एंटिटी एक्सट्रैक्शन, और नॉलेज ग्राफ़ एक्सेस | एक्सट्रैक्ट API, क्रॉल API, नॉलेज ग्राफ़, एंटिटी एन्हांसमेंट, नेचुरल‑लैंग्वेज प्रोसेसिंग, कंप्यूटर विज़न, संरचित डेटासेट्स |
| ScrapeGraphAI | प्रॉम्प्ट‑आधारित एक्सट्रैक्शन, संरचित JSON, और AI फ्रेमवर्क इंटीग्रेशन | प्रॉम्प्ट‑आधारित एक्सट्रैक्शन, JSON स्कीमा, क्रॉलिंग, मॉनिटरिंग, जावास्क्रिप्ट रेंडरिंग, SDKs, CLI, MCP, LangChain और CrewAI इंटीग्रेशन |
AI वेब स्क्रैपिंग टूल चुनने के लिए कैसे चुनें
सबसे पहले उस वेब डेटा समस्या के प्रकार को पहचानें जो आपके पास है। यदि लक्ष्य AI प्रोडक्ट को साफ़ वेब संदर्भ फ़ीड करना है, तो Markdown, संरचित JSON, क्रॉल कंट्रोल, और रिट्रीवल‑फ्रेंडली आउटपुट को प्राथमिकता दें। यदि लक्ष्य आवर्ती व्यावसायिक रिसर्च है, तो नो‑कोड रोबोट या विज़ुअल वर्कफ़्लो बिल्डर तेज़ हो सकता है। यदि लक्ष्य बड़े पैमाने पर सार्वजनिक‑डेटा संग्रह है, तो रेंडरिंग, क्यूज़, प्रॉक्सी कंट्रोल, अनलॉक्स, मॉनिटरिंग, और विश्वसनीय डिलीवरी जैसी इन्फ्रास्ट्रक्चर गहराई देखें।
दूसरा प्रश्न है कि वर्कफ़्लो को कौन मेंटेन करेगा। प्रतिस्पर्धी पेजों को ट्रैक करने वाली मार्केटिंग टीम को इंजीनियरिंग टीम के डेटा पाइपलाइन से बहुत अलग प्रोडक्ट चाहिए। अच्छे स्क्रैपिंग सिस्टम एक्सट्रैक्शन को दोहराने योग्य बनाते हैं, लेकिन वे वैलिडेशन की ज़रूरत को नहीं हटाते। वेबसाइटें बदलती हैं, फ़ील्ड ड्रिफ्ट होते हैं, और AI‑सहायता वाले एक्सट्रैक्शन तब भी आत्मविश्वास से बोल सकते हैं जब पेज अस्पष्ट हो। सबसे अच्छा सेट‑अप वह है जो आपकी टीम की तकनीकी क्षमता, रिव्यू प्रक्रिया, और अनुपालन दायित्वों के साथ मेल खाता हो।
10 सर्वश्रेष्ठ AI वेब स्क्रैपिंग टूल्स
1. Bright Data
Bright Data सबसे मजबूत विकल्प है जब वेब डेटा संग्रह एक मुख्य व्यावसायिक सिस्टम हो, न कि साइड प्रोजेक्ट। यह स्क्रेपर API, ब्राउज़र इन्फ्रास्ट्रक्चर, प्रॉक्सी प्रबंधन, अनलॉक्स तकनीक, और तैयार‑डेटासेट को मिलाकर टीमों को सार्वजनिक वेब डेटा बड़े पैमाने पर एकत्र करने देता है, बिना हर लेयर को खुद जोड़ने के।
यह प्लेटफ़ॉर्म विशेष रूप से उन कंपनियों के लिए उपयोगी है जो मार्केट इंटेलिजेंस, ई‑कॉमर्स मॉनिटरिंग, सर्च इंटेलिजेंस, AI प्रशिक्षण डेटासेट, रिट्रीवल‑ऑगमेंटेड जेनरेशन पाइपलाइन, या प्रतिस्पर्धी डेटा प्रोडक्ट बनाती हैं। Bright Data तकनीकी टीमों को जटिल वर्कफ़्लो बनाने के लिए पर्याप्त नियंत्रण देता है, साथ ही उन टीमों के लिए मैनेज्ड पाथ भी प्रदान करता है जो संरचित डेटा चाहते हैं बिना नाज़ुक स्क्रैपिंग स्टैक को बनाए रखे।
यह व्यापकता खरीद निर्णय को भी प्रभावित करती है। Bright Data तब सबसे समझदारी है जब कोई संगठन इंजीनियरिंग या डेटा‑ऑपरेशन्स की जिम्मेदारी सौंप सकता है, अनुमोदित टार्गेट परिभाषित कर सकता है, और समय‑समय पर गुणवत्ता व लागत की निगरानी कर सकता है। छोटे टीमों के लिए जिनके पास सीमित साइटों की सूची है, हल्का API या नो‑कोड सेवा बेहतर हो सकती है, जबकि नियामक प्रोग्राम को संग्रह नीतियों को कानूनी व प्राइवेसी रिव्यू के साथ संरेखित करना चाहिए।
फायदे और नुकसान
- इस रैंकिंग में सबसे व्यापक इन्फ्रास्ट्रक्चर कवरेज
- उच्च‑वॉल्यूम और कठिन सार्वजनिक वेबसाइटों के लिए मजबूत फिट
- तैयार‑स्क्रेपर और डेटासेट निर्माण समय कम करते हैं
- AI डेटा पाइपलाइन, सर्च इंटेलिजेंस, और ई‑कॉमर्स मॉनिटरिंग के लिए उपयोगी
- छोटे, कभी‑कभी प्रोजेक्टों की तुलना में अधिक इन्फ्रास्ट्रक्चर आवश्यक
- टीमों को स्पष्ट डेटा गवर्नेंस और टार्गेट‑साइट नियमों की आवश्यकता
- उन्नत उपयोग‑केस के लिए तकनीकी सेट‑अप और मॉनिटरिंग जरूरी
2. Firecrawl
Firecrawl AI युग के वेब स्क्रैपिंग के लिए बनाया गया है। डेवलपर्स को कच्चा HTML साफ़ करना, पेज रेंडरिंग संभालना, और गंदे साइट कंटेंट को मैन्युअल रूप से सामान्यीकृत करने की बजाय यह वेब पेजों को साफ़ Markdown या संरचित डेटा में बदल देता है, जिससे एजेंट, रिट्रीवल सिस्टम, रिसर्च टूल, और प्रोडक्ट वर्कफ़्लो को फ़ीड किया जा सके।
यह एप्लिकेशन लेयर पर सरलता प्रदान करता है। डेवलपर्स एक पेज स्क्रैप कर सकते हैं, साइट क्रॉल कर सकते हैं, वेब सर्च कर सकते हैं, URL मैप कर सकते हैं, बदलाव मॉनिटर कर सकते हैं, या संरचित आउटपुट का अनुरोध बहुत कम प्लंबिंग के साथ कर सकते हैं, पारंपरिक स्क्रेपर स्टैक की तुलना में। Firecrawl विशेष रूप से तब उपयुक्त है जब अंतिम प्रोडक्ट एक AI असिस्टेंट, नॉलेज बेस, रिसर्च वर्कफ़्लो, या रिट्रीवल‑ऑगमेंटेड जेनरेशन सिस्टम हो।
टीमों को Firecrawl को कंटेंट अधिग्रहण लेयर के रूप में देखना चाहिए, न कि पूरे डेटा प्लेटफ़ॉर्म के रूप में। प्रोडक्शन उपयोग के लिए अभी भी स्रोत स्कोपिंग, डेडुप्लीकेशन, फ्रेशनेस नियम, स्कीमा वैलिडेशन, और साइट बदलने पर ऑब्ज़रवबिलिटी की आवश्यकता होती है। इसका मूल्य तब सबसे अधिक है जब डेवलपर्स को संक्षिप्त API और सेल्फ‑होस्टिंग विकल्प चाहिए, लेकिन एंटरप्राइज़ इन्फ्रास्ट्रक्चर वेंडर्स द्वारा प्रदान किए गए व्यापक प्रॉक्सी कंट्रोल या मैनेज्ड डेटासेट की आवश्यकता नहीं होती।
फायदे और नुकसान
- AI एप्लिकेशन के लिए साफ़ वेब संदर्भ की उत्कृष्ट फिट
- Markdown और संरचित आउटपुट डाउनस्ट्रीम क्लीन‑अप कम करते हैं
- स्क्रैप, क्रॉल, सर्च, मैप, और मॉनिटर वर्कफ़्लो के लिए उपयोगी API सतह
- ओपन‑सोर्स विकल्प तकनीकी टीमों को अधिक डिप्लॉयमेंट लचीलापन देता है
- पूरा प्रॉक्सी या एंटरप्राइज़ डेटा‑इन्फ्रास्ट्रक्चर प्लेटफ़ॉर्म नहीं
- जटिल एक्सट्रैक्शन को अभी भी स्कीमा डिज़ाइन और वैलिडेशन से लाभ मिलता है
- कठोर अनुपालन आवश्यकताओं वाली टीमों को डिप्लॉयमेंट और रिटेंशन विकल्पों की सावधानीपूर्वक समीक्षा करनी चाहिए
3. Apify
Apify उन टीमों के लिए एक मजबूत विकल्प है जो डेवलपर प्लेटफ़ॉर्म और तैयार‑डेटा वेब ऑटोमेशन टूल्स के बड़े मार्केटप्लेस दोनों चाहते हैं। इसका Actor मॉडल स्क्रेपर, ब्राउज़र ऑटोमेशन, और डेटा वर्कफ़्लो को पुन: प्रयोज्य क्लाउड जॉब्स के रूप में पैकेज करने की सुविधा देता है, जिन्हें शेड्यूल किया जा सकता है, API द्वारा बुलाया जा सकता है, स्टोरेज से जोड़ा जा सकता है, और टीम में साझा किया जा सकता है।
डेवलपर्स को प्रोटोटाइप से प्रोडक्शन तक एक व्यावहारिक मार्ग मिलता है। वे Crawlee, Playwright, Puppeteer, Selenium, या मौजूदा Actors के साथ बना सकते हैं, फिर Apify का उपयोग एक्सीक्यूशन, क्यूज़, प्रॉक्सी, डेटासेट, वेबहुक, और इंटीग्रेशन के लिए कर सकते हैं। यह उन टीमों के लिए विशेष रूप से उपयोगी है जिन्हें एकबारगी पेज एक्सट्रैक्शन नहीं, बल्कि दोहराने योग्य डेटा जॉब्स चाहिए।
Apify की लचीलापन एक ताकत और जिम्मेदारी दोनों है। टीमों को भरोसेमंद Actors चुनने, संस्करण नियंत्रित करने, रन मॉनिटर करने, और कंप्यूट, प्रॉक्सी, और स्टोरेज उपयोग के लिए बजट बनाने की जरूरत है। यह उन डेवलपर्स के लिए सबसे अच्छा है जो पुन: प्रयोज्य बिल्डिंग ब्लॉक्स और क्लाउड ऑपरेशन्स एक ही जगह चाहते हैं; कभी‑कभी उपयोगकर्ता एक विशेष स्क्रेपर को जल्दी सीखना पसंद कर सकते हैं।
फायदे और नुकसान
- सामान्य टार्गेट के लिए तैयार‑डेटा Actors का बड़ा मार्केटप्लेस
- कस्टम स्क्रैपिंग और ब्राउज़र ऑटोमेशन के लिए मजबूत डेवलपर टूलिंग
- शेड्यूल्ड, दोहराने योग्य डेटा संग्रह वर्कफ़्लो के लिए अच्छा फिट
- Crawlee समर्थन तकनीकी टीमों को लचीला ओपन‑सोर्स आधार देता है
- मार्केटप्लेस की गुणवत्ता Actor और उपयोग‑केस के अनुसार बदलती है
- कस्टम जॉब्स को वेबसाइट बदलने पर अभी भी मेंटेनेंस चाहिए
- गैर‑तकनीकी उपयोगकर्ता सरल विज़ुअल स्क्रेपर को पसंद कर सकते हैं
4. Browse AI
Browse AI उन व्यावसायिक टीमों के लिए सबसे उपयुक्त है जिन्हें वेब डेटा चाहिए लेकिन स्क्रेपर बनाना नहीं चाहते। उपयोगकर्ता रोबोट को यह दिखाकर प्रशिक्षित करते हैं कि क्या एकत्रित करना है, फिर उस रोबोट को मांग पर या शेड्यूल पर चलाते हैं। यह प्रतिस्पर्धी ट्रैकिंग, लिस्टिंग मॉनिटरिंग, लीड संग्रह, इन्वेंट्री देखना, या दोहराने वाले रिसर्च को आवर्ती वर्कफ़्लो में बदलने के लिए उपयोगी है।
इसकी ताकत पहुँच‑योग्यता है। Browse AI ऑपरेशंस, मार्केटिंग, रिक्रूटिंग, ई‑कॉमर्स, और रिसर्च टीमों को बिना इंजीनियरिंग को हर सेलेक्टर बनाए रखने के संरचित डेटा एकत्र करने का व्यावहारिक तरीका देता है। यह सबसे गहरा डेवलपर प्लेटफ़ॉर्म बनने की कोशिश नहीं करता; यह दोहराने योग्य वेब डेटा संग्रह को सुलभ बनाने पर केंद्रित है।
Browse AI तब सबसे अच्छा काम करता है जब लक्ष्य वर्कफ़्लो स्पष्ट रूप से प्रदर्शित किया जा सकता है और मानव द्वारा रिव्यू किया जा सकता है। उपयोगकर्ताओं को पेजिनेशन, लॉग‑इन स्टेप्स, खाली स्थिति, और लेआउट बदलावों का परीक्षण करना चाहिए, इससे पहले कि ऑटोमेशन पर निर्णय‑निर्धारण निर्भर हो। यह विभागीय प्रोजेक्ट्स के लिए एक मजबूत विकल्प है, लेकिन इंजीनियरिंग‑लीड प्रोग्राम को रिट्राई, डेटा कॉन्ट्रैक्ट, और डिप्लॉयमेंट पर अधिक सूक्ष्म नियंत्रण की आवश्यकता हो सकती है।
फायदे और नुकसान
- व्यवसाय उपयोगकर्ताओं के लिए मजबूत नो‑कोड अनुभव
- आवर्ती मॉनिटरिंग और स्प्रेडशीट‑स्टाइल वर्कफ़्लो के लिए अच्छा फिट
- पॉइंट‑एंड‑क्लिक रोबोट ट्रेनिंग सेलेक्टर‑आधारित सेट‑अप से आसान
- इंजीनियरिंग सपोर्ट के बिना वेब डेटा चाहिए ऐसी टीमों के लिए उपयोगी
- जटिल लॉजिक के लिए डेवलपर‑फ़र्स्ट प्लेटफ़ॉर्म की तुलना में कम लचीला
- टार्गेट पेज बदलने पर रोबोट को समायोजन की आवश्यकता हो सकती है
- बड़े या अत्यधिक कस्टमाइज़्ड प्रोग्राम नो‑कोड अप्रोच से बाहर हो सकते हैं
5. SearchAPI
SearchAPI उन टीमों के लिए एक विशेषीकृत स्क्रैपिंग सेवा है जिन्हें संरचित डेटा के रूप में वर्तमान सर्च‑इंजन परिणाम चाहिए, न कि कच्चे परिणाम पेज। एकल API सतह ऑर्गेनिक लिंक, विज्ञापन, न्यूज़, मैप लिस्टिंग, शॉपिंग परिणाम, नॉलेज पैनल, People Also Ask प्रश्न, AI‑जनरेटेड सर्च फीचर, और अन्य प्रकार के परिणामों को JSON में लौटाता है, चयनित इंजन के अनुसार।
यह प्लेटफ़ॉर्म SEO मॉनिटरिंग, स्थानीय सर्च विश्लेषण, बाजार रिसर्च, प्रोडक्ट इंटेलिजेंस, और रियल‑टाइम सर्च संदर्भ चाहिए AI एजेंट्स के लिए विशेष रूप से उपयोगी है। SearchAPI ब्राउज़र रेंडरिंग, प्रॉक्सी रोटेशन, रिट्राईज़, और CAPTCHA हैंडलिंग को अनुरोध के पीछे संभालता है, जबकि लोकेलाइज़ेशन पैरामीटर देश, भाषा, लोकेशन, और डिवाइस‑स्पेसिफिक क्वेरी को सपोर्ट करते हैं। इसके दस्तावेज़ित इंजन मानक Google परिणामों से परे Google Maps, Bing, YouTube, न्यूज़, और कॉमर्स सर्च अनुभवों जैसे स्रोतों को भी कवर करते हैं।
SearchAPI एक MCP सर्वर भी प्रदान करता है जिससे समर्थित AI असिस्टेंट और डेवलपमेंट एनवायरनमेंट को उसके सर्च टूल्स से जोड़ा जा सकता है। ट्रेड‑ऑफ़ विशेषीकरण है: यह एक मजबूत सर्च‑डेटा लेयर है, सामान्य वेब‑क्रॉलर नहीं जो किसी भी साइट से मनचाहा फ़ील्ड निकाल सके। खरीदारों को उपयोग को सावधानी से मॉडल करना चाहिए क्योंकि प्लान क्रेडिट‑आधारित हैं, थ्रूपुट टियर के अनुसार बदलता है, और समृद्ध सर्च सतहों को अपस्ट्रीम लेआउट बदलने पर स्कीमा चेक की आवश्यकता होती है।
फायदे और नुकसान
- रियल‑टाइम SERP डेटा संरचित रूप में लौटाता है, सर्च स्क्रेपर या प्रॉक्सी इन्फ्रास्ट्रक्चर बनाए रखने की जरूरत नहीं
- मुख्य सर्च, मैप, वीडियो, न्यूज़, शॉपिंग, और अन्य विशेष परिणाम इंजनों को सपोर्ट करता है
- लोकेशन, भाषा, देश, और डिवाइस कंट्रोल रैंक ट्रैकिंग और बाजार रिसर्च के लिए उपयुक्त
- API और MCP एक्सेस सर्च डेटा को एप्लिकेशन और AI एजेंट्स के लिए व्यावहारिक बनाते हैं
- सर्च‑इंजन परिणाम डेटा पर केंद्रित, सामान्य वेबसाइट क्रॉलिंग नहीं
- क्रेडिट‑आधारित प्लान और थ्रूपुट सीमाएँ उच्च‑वॉल्यूम वर्कलोड के लिए पूर्वानुमान की आवश्यकता
- सर्च इंजन परिणाम लेआउट बदलने पर फ़ील्ड वैलिडेशन आवश्यक
6. ScrapingBee
ScrapingBee उन टीमों के लिए एक डेवलपर‑फ़्रेंडली API है जो हेडलेस ब्राउज़र या प्रॉक्सी इन्फ्रास्ट्रक्चर बनाए बिना वेब डेटा एकत्र और संरचित करना चाहते हैं। यह जावास्क्रिप्ट रेंडरिंग, प्रॉक्सी रोटेशन, स्क्रीनशॉट, CSS/XPath एक्सट्रैक्शन, और एक AI एक्सट्रैक्शन लेयर को मिलाता है जो नेचुरल‑लैंग्वेज अनुरोध और फ़ील्ड नियमों को संरचित JSON में बदलता है।
यह प्लेटफ़ॉर्म विशेष रूप से तब उपयोगी है जब डेवलपर्स को सरल पेज और इंटरैक्टिव साइट दोनों के लिए एक ही एंडपॉइंट चाहिए। जावास्क्रिप्ट परिदृश्य क्लिक, स्क्रॉल, टाइप, या एक्सट्रैक्शन से पहले वेट कर सकते हैं, जबकि Markdown आउटपुट, डेडिकेटेड API, CLI, और MCP इंटीग्रेशन स्क्रैप्ड कंटेंट को एनालिटिक्स, ऑटोमेशन, और AI वर्कफ़्लो में ले जाने में मदद करते हैं। ScrapingBee एक पूर्ण स्क्रैपिंग स्टैक की तुलना में अपनाने में आसान है, हालांकि प्रीमियम प्रॉक्सी, रेंडरिंग, और AI फीचर के साथ क्रेडिट खपत बदल सकती है।
ScrapingBee तब सबसे अच्छा फिट है जब इंजीनियर एक मैनेज्ड रिक्वेस्ट लेयर चाहते हैं जबकि ऑर्केस्ट्रेशन और डेटा क्वालिटी को अपने एप्लिकेशन में रखना चाहते हैं। टीमों को रिट्राई नियम, स्कीमा, क्रॉल सीमा, और मल्टी‑पेज जॉब्स के लिए वैलिडेशन परिभाषित करना चाहिए, बजाय हर सफल HTTP रिस्पॉन्स को भरोसेमंद डेटा मानने के। एक विज़ुअल डेस्कटॉप स्क्रेपर गैर‑तकनीकी उपयोगकर्ताओं के लिए आसान हो सकता है, लेकिन API टीमों को इंटीग्रेशन और डिप्लॉयमेंट पर अधिक प्रत्यक्ष नियंत्रण मिलता है।
फायदे और नुकसान
- नेचुरल‑लैंग्वेज AI एक्सट्रैक्शन संरचित JSON बिना मैनुअल सेलेक्टर के लौटाता है
- जावास्क्रिप्ट रेंडरिंग और स्क्रिप्टेड एक्शन कई डायनामिक‑पेज वर्कफ़्लो को संभालते हैं
- प्रॉक्सी रोटेशन, स्क्रीनशॉट, Markdown आउटपुट, और डेडिकेटेड API एक ही सेवा में उपलब्ध
- CLI, MCP, और ऑटोमेशन इंटीग्रेशन डेवलपर और एजेंट वर्कफ़्लो के अनुकूल
- AI एक्सट्रैक्शन, प्रीमियम प्रॉक्सी, या जावास्क्रिप्ट रेंडरिंग जोड़ने पर क्रेडिट उपयोग बढ़ता है
- यह एक API‑फ़र्स्ट प्रोडक्ट है, विज़ुअल डेस्कटॉप स्क्रेपर नहीं
- जटिल मल्टी‑पेज क्रॉल्स को अभी भी ऑर्केस्ट्रेशन और क्वालिटी चेक की आवश्यकता
7. Octoparse
Octoparse एक परिपक्व नो‑कोड स्क्रेपर है उन उपयोगकर्ताओं के लिए जो डेवलपर फ्रेमवर्क के बजाय विज़ुअल वर्कफ़्लो चाहते हैं। यह पेज डेटा का पता लगा सकता है, उपयोगकर्ताओं को एक्सट्रैक्शन स्टेप्स के माध्यम से मार्गदर्शन करता है, और क्लाउड में स्क्रैपिंग जॉब्स चलाता है, जिससे ई‑कॉमर्स साइट, डायरेक्टरी, लिस्टिंग, सर्च पेज, और अन्य संरचित वेब स्रोतों से आवर्ती संग्रह उपयोगी बनता है।
प्लेटफ़ॉर्म तब सबसे मजबूत होता है जब टीम को तेज़ ब्राउज़र‑एक्सटेंशन स्क्रैप से अधिक वर्कफ़्लो नियंत्रण चाहिए, लेकिन फिर भी कोड लिखने से बचना चाहती है। टेम्प्लेट्स, शेड्यूलिंग, क्लाउड एक्सट्रैक्शन, ऑटोमैटिक एक्सपोर्ट, और डायनामिक पेज सपोर्ट Octoparse को साधारण नो‑कोड टूल और इंजीनियर‑लीड स्क्रैपिंग प्लेटफ़ॉर्म के बीच एक व्यावहारिक मध्यस्थ बनाते हैं।
इसका विज़ुअल मॉडल अभी भी सावधानीपूर्वक वर्कफ़्लो डिज़ाइन की मांग करता है। टीमों को पेजिनेशन, अनंत स्क्रॉल, लॉग‑इन स्टेट, डुप्लिकेट रिकॉर्ड, और एरर ब्रांच का परीक्षण करना चाहिए, शेड्यूल्ड जॉब्स पर भरोसा करने से पहले। Octoparse विश्लेषकों और ऑपरेशंस उपयोगकर्ताओं के लिए उपयुक्त है जो इन चेक्स को संभाल सकते हैं, जबकि कड़े संस्करण नियंत्रण और ऑटोमेटेड टेस्टिंग चाहने वाले डेवलपर्स API या कोड‑फ़र्स्ट फ्रेमवर्क को प्राथमिकता दे सकते हैं।
फायदे और नुकसान
- विज़ुअल वर्कफ़्लो बिल्डर साधारण टूल्स से अधिक नियंत्रण देता है
- क्लाउड एक्सट्रैक्शन आवर्ती जॉब्स को स्थानीय मशीन के बिना चलाता है
- टेम्प्लेट्स सामान्य साइटों और डेटा टाइप्स के सेट‑अप समय को घटाते हैं
- ऑपरेशंस टीमों के लिए दोहराने योग्य संरचित डेटासेट बनाने में अच्छा फिट
- जटिल वेबसाइटों पर वर्कफ़्लो डिज़ाइन में समय लग सकता है
- कोड‑फ़र्स्ट पाइपलाइन पसंद करने वाली डेवलपर टीमों के लिए कम स्वाभाविक
- टार्गेट साइट बदलने पर निरंतर मॉनिटरिंग अभी भी आवश्यक
8. Oxylabs
Oxylabs उन टीमों के लिए एक मजबूत फिट है जिन्हें बड़े पैमाने पर सार्वजनिक वेब डेटा तक भरोसेमंद पहुंच चाहिए और वे प्रॉक्सी रोटेशन, रेंडरिंग, और एंटी‑ब्लॉकिंग लेयर को स्वयं प्रबंधित नहीं करना चाहते। इसका Web Scraper API व्यापक टार्गेट रेंज से संरचित सार्वजनिक डेटा एकत्र करने के लिए डिज़ाइन किया गया है, जबकि अधिकांश स्क्रैपिंग इन्फ्रास्ट्रक्चर को बैक‑एंड में संभालता है।
कंपनी ने AI डेटा वर्कफ़्लो में AI Studio, Fast Search API, ब्राउज़र ऑटोमेशन, और ग्राउंडिंग‑ओरिएंटेड उपयोग‑केस के साथ गहराई से प्रवेश किया है। यह Oxylabs को उन संगठनों के लिए प्रासंगिक बनाता है जो मार्केट इंटेलिजेंस सिस्टम, सर्च मॉनिटरिंग, मॉडल‑ग्राउंडिंग पाइपलाइन, ई‑कॉमर्स डेटासेट, और एजेंट वर्कफ़्लो बनाते हैं जिन्हें ताज़ा वेब संदर्भ चाहिए।
Oxylabs सबसे आकर्षक तब होता है जब विश्वसनीयता, टार्गेट कठिनाई, या भौगोलिक पहुंच एंटरप्राइज़‑ओरिएंटेड सर्विस को न्यायोचित बनाती है। खरीदारों को टार्गेट साइट, आउटपुट आवश्यकताएँ, रिस्पॉन्स टाइम, और अनुपालन जिम्मेदारी को मैप करना चाहिए, उत्पाद कॉन्फ़िगरेशन चुनने से पहले। छोटे प्रोजेक्ट्स प्लेटफ़ॉर्म की पूरी इन्फ्रास्ट्रक्चर गहराई का उपयोग नहीं कर सकते, जबकि बड़े प्रोग्राम को अभी भी स्वतंत्र क्वालिटी मॉनिटरिंग चाहिए क्योंकि सफल संग्रह स्वचालित रूप से सटीक नॉर्मलाइज़ेशन की गारंटी नहीं देता।
फायदे और नुकसान
- मजबूत एंटरप्राइज़‑ग्रेड स्क्रैपिंग और प्रॉक्सी इन्फ्रास्ट्रक्चर
- स्केलेबिलिटी और विश्वसनीयता चाहिए ऐसे सार्वजनिक वेब डेटा पाइपलाइन के लिए उपयोगी
- AI Studio और Fast Search API एजेंट और ग्राउंडिंग वर्कफ़्लो को सपोर्ट करते हैं
- कठिन डायनामिक वेबसाइटों और जियो‑टार्गेटेड संग्रह के लिए अच्छा फिट
- तकनीकी और अनुपालन आवश्यकताओं वाले टीमों के लिए सबसे उपयुक्त
- छोटे नो‑कोड प्रोजेक्ट्स की तुलना में अधिक इन्फ्रास्ट्रक्चर हो सकता है
- उन्नत वर्कफ़्लो को टार्गेट चयन और वैलिडेशन में सावधानी चाहिए
9. Diffbot
Diffbot अधिकांश वेब स्क्रैपिंग टूल्स से अलग है क्योंकि यह पेज और एंटिटी को समझने पर केंद्रित है, न कि केवल फ़ील्ड एकत्र करने पर। इसकी एक्सट्रैक्शन तकनीक पेज को वर्गीकृत करती है, संरचित एंटिटी की पहचान करती है, और वेब डेटा को व्यापक नॉलेज ग्राफ़ से जोड़ती है, जो तब उपयोगी होता है जब लक्ष्य कच्चे स्क्रैप्ड रो नहीं, बल्कि समृद्ध, नॉर्मलाइज़्ड जानकारी होना हो।
यह Diffbot को एंटिटी इंटेलिजेंस, कंपनी और व्यक्तियों का डेटा, मार्केट रिसर्च, नॉलेज ग्राफ़, मीडिया मॉनिटरिंग, और AI सिस्टम के लिए उपयोगी बनाता है जिन्हें खुले वेब से संरचित तथ्य चाहिए। यह तेज़ पॉइंट‑एंड‑क्लिक स्क्रेपर नहीं, बल्कि वेब‑स्केल एक्सट्रैक्शन और नॉलेज लेयर है।
मुख्य खरीद प्रश्न यह है कि क्या Diffbot का डेटा मॉडल प्रोजेक्ट की आवश्यक एंटिटी और रिलेशनशिप से मेल खाता है। यदि हाँ, तो टीमें पेज‑स्पेसिफिक पार्सर और एन्हांसमेंट पाइपलाइन को शून्य से बनाने से बच सकती हैं। यदि नहीं, तो पारम्परिक स्क्रेपर अधिक सीधा नियंत्रण दे सकता है। मूल्यांकन में प्रतिनिधि पेज, फ़ील्ड कवरेज, अपडेट फ़्रीक्वेंसी, एंटिटी रिज़ॉल्यूशन, और डाउनस्ट्रीम प्रॉवेनेंस कैसे रखा जाएगा, शामिल होना चाहिए।
फायदे और नुकसान
- मजबूत ऑटोमैटिक एक्सट्रैक्शन और एंटिटी समझ
- नॉलेज ग्राफ़ एक्सेस एकल पेज से परे संदर्भ जोड़ता है
- एन्हांसमेंट, रिसर्च, और संरचित इंटेलिजेंस वर्कफ़्लो के लिए उपयोगी
- जब नॉर्मलाइज़्ड एंटिटी कच्चे पेज टेबल से अधिक महत्वपूर्ण हों तो अच्छा फिट
- सरल स्प्रेडशीट‑स्टाइल स्क्रैपिंग के लिए कम सहज
- सर्वोत्तम परिणाम इस बात पर निर्भर करते हैं कि Diffbot मॉडल टार्गेट कंटेंट टाइप से मेल खाते हैं या नहीं
- टीमों को नॉलेज ग्राफ़ और API मॉडल को समझना चाहिए ताकि पूरी वैल्यू मिल सके
10. ScrapeGraphAI
ScrapeGraphAI उन उपयोगकर्ताओं के लिए डिज़ाइन किया गया है जो साधारण भाषा में आवश्यक डेटा का वर्णन करना चाहते हैं और संरचित आउटपुट प्राप्त करना चाहते हैं। प्रत्येक फ़ील्ड के लिए सेलेक्टर लिखने की बजाय, टीमें URL प्रदान कर सकती हैं, वांछित जानकारी परिभाषित कर सकती हैं, और AI‑सहायता वाले एक्सट्रैक्शन का उपयोग करके साफ़ JSON प्राप्त कर सकती हैं, जिसे एप्लिकेशन, रिसर्च वर्कफ़्लो, या एजेंट्स में उपयोग किया जा सकता है।
यह उन डेवलपर्स के लिए अच्छा फिट है जो वेब डेटा के आसपास AI वर्कफ़्लो बनाते हैं, विशेषकर जब एक्सट्रैक्शन टास्क अक्सर बदलता है या LangChain, CrewAI, SDKs, कमांड‑लाइन टूल, या MCP‑सक्षम वातावरण जैसे फ्रेमवर्क से जुड़ना चाहिए। मुख्य लाभ लचीलापन है: एक्सट्रैक्शन लॉजिक प्रॉम्प्ट‑ड्रिवन हो सकता है, न कि कठोर पेज सेलेक्टर पर पूरी तरह निर्भर।
यह लचीलापन वैलिडेशन को विशेष रूप से महत्वपूर्ण बनाता है। टीमों को स्कीमा, रिट्राई व्यवहार, एविडेंस फ़ील्ड, और सैंपल‑रिव्यू नियम परिभाषित करने चाहिए, प्रोडक्शन उपयोग से पहले, क्योंकि एक संभावित उत्तर जरूरी नहीं कि पूर्ण एक्सट्रैक्शन हो। ScrapeGraphAI प्रयोगों और अनुकूलनशील वर्कफ़्लो के लिए आकर्षक है, जबकि स्थिर हाई‑वॉल्यूम जॉब्स अभी भी डिटरमिनिस्टिक सेलेक्टर या हाइब्रिड अप्रोच से लाभ उठा सकते हैं जहाँ AI केवल तब उपयोग हो जब पेज स्ट्रक्चर बदलता हो।
फायदे और नुकसान
- प्रॉम्प्ट‑आधारित नेचुरल‑लैंग्वेज एक्सट्रैक्शन बदलते या अन्वेषणात्मक टास्क के लिए उपयोगी
- संरचित JSON आउटपुट AI एप्लिकेशन और ऑटोमेशन वर्कफ़्लो में फिट बैठता है
- डेवलपर इंटीग्रेशन एजेंट और ऑर्केस्ट्रेशन उपयोग‑केस को सपोर्ट करते हैं
- सेलेक्टर मेंटेनेंस को धीमा करने वाले प्रयोगों के लिए मददगार
- प्रोडक्शन उपयोग से पहले AI एक्सट्रैक्शन को वैलिडेट करना चाहिए
- प्रॉम्प्ट डिज़ाइन और स्कीमा आउटपुट स्थिरता को प्रभावित करते हैं
- पूरी तरह विज़ुअल नो‑कोड वर्कफ़्लो चाहिए ऐसी टीमों के लिए कम उपयुक्त
अक्सर पूछे जाने वाले प्रश्न
एक वेब स्क्रैपिंग टूल को AI‑पावर्ड क्या बनाता है?
AI‑पावर्ड स्क्रैपर्स आमतौर पर चार कार्यों में से एक या अधिक में मदद करते हैं: पेज पर फ़ील्ड की पहचान, पेज कंटेंट को संरचित डेटा में बदलना, प्राकृतिक‑भाषा निर्देशों से ब्राउज़र को नियंत्रित करना, या स्क्रैप्ड कंटेंट को AI सिस्टम के लिए तैयार करना। सबसे अच्छे टूल अभी भी स्पष्ट प्रॉम्प्ट, स्कीमा, वैलिडेशन, और कौन सा डेटा एकत्रित करना है, इस पर नियमों की आवश्यकता रखते हैं।
स्क्रैपिंग और ब्राउज़र ऑटोमेशन में क्या अंतर है?
स्क्रैपिंग पेजों से डेटा निकालने पर केंद्रित है। ब्राउज़र ऑटोमेशन ब्राउज़र को क्लिक, स्क्रॉल, लॉग‑इन, फ़ॉर्म भरने, डायनामिक कंटेंट का इंतजार करने, या मल्टी‑स्टेप वर्कफ़्लो चलाने के लिए नियंत्रित करता है। कई आधुनिक टूल दोनों को मिलाते हैं, लेकिन अंतर महत्वपूर्ण है: एक स्थिर प्रोडक्ट लिस्टिंग स्क्रैपिंग जॉब है, जबकि नेविगेशन और इंटरैक्शन की आवश्यकता वाला वर्कफ़्लो ब्राउज़र ऑटोमेशन की मांग करता है।
RAG सिस्टम के लिए कौन सा आउटपुट फ़ॉर्मेट सबसे अच्छा है?
रिट्रीवल‑ऑगमेंटेड जेनरेशन सिस्टम आमतौर पर साफ़ टेक्स्ट, Markdown, संरचित JSON, मेटाडेटा, और स्थिर स्रोत URL के साथ सबसे अच्छा काम करते हैं। लक्ष्य केवल कंटेंट एकत्र करना नहीं, बल्कि चंक्स, रिट्रीवल, सिटेशन, और क्वालिटी चेक के लिए पर्याप्त संरचना बनाए रखना भी है। कच्चा HTML उपयोगी हो सकता है, लेकिन अक्सर AI एप्लिकेशन के लिए उपयोगी बनाने से पहले अतिरिक्त क्लीन‑अप की आवश्यकता होती है।
क्या AI स्क्रैपर्स जावास्क्रिप्ट वेबसाइटों को संभाल सकते हैं?
कई कर सकते हैं, लेकिन गुणवत्ता उत्पाद पर निर्भर करती है। कुछ टूल पेज को ब्राउज़र में रेंडर करते हैं, कुछ हेडलेस ब्राउज़र इन्फ्रास्ट्रक्चर उपयोग करते हैं, और अन्य पेज लोड होने के बाद एक्सट्रैक्शन पर भरोसा करते हैं। जावास्क्रिप्ट सपोर्ट ई‑कॉमर्स, मार्केटप्लेस, सोशल प्लेटफ़ॉर्म, डैशबोर्ड, और आधुनिक वेब ऐप्स के लिए महत्वपूर्ण है जहाँ उपयोगी डेटा प्रारंभिक पेज रिस्पॉन्स के बाद दिखाई देता है।
क्या नो‑कोड स्क्रैपर्स बड़े प्रोजेक्ट्स के लिए उपयुक्त हैं?
नो‑कोड स्क्रैपर्स आवर्ती व्यावसायिक वर्कफ़्लो, प्रतिस्पर्धी मॉनिटरिंग, लीड रिसर्च, और ऑपरेशंस टास्क के लिए उत्कृष्ट हो सकते हैं। बड़े प्रोग्राम अंततः API, क्यूज़, मॉनिटरिंग, प्रॉक्सी इन्फ्रास्ट्रक्चर, वर्ज़न कंट्रोल, डेटा वैलिडेशन, और इंजीनियरिंग ओनरशिप की आवश्यकता पड़ सकती है। सबसे अच्छे नो‑कोड टूल तब मजबूत होते हैं जब वर्कफ़्लो स्पष्ट हो और टीम गति चाहती हो बिना कस्टम स्क्रेपर बनाये।
वेब स्क्रैपिंग कानूनी है?
वेब स्क्रैपिंग कानून जुरिस्डिक्शन, टार्गेट साइट, डेटा प्रकार, एक्सेस मेथड, और डेटा उपयोग पर निर्भर करता है। सार्वजनिक वेब डेटा संग्रह अभी भी कॉन्ट्रैक्चुअल, प्राइवेसी, इंटेलेक्चुअल‑प्रॉपर्टी, साइबर‑सिक्योरिटी, और प्लेटफ़ॉर्म‑पॉलिसी मुद्दे उठाता है। टीमों को लागू कानून, robots.txt और टर्म्स, आंतरिक अनुपालन नीतियों, और डेटा की संवेदनशीलता की समीक्षा करनी चाहिए, स्क्रैपिंग प्रोग्राम चलाने से पहले।
क्या AI‑जनरेटेड एक्सट्रैक्शन परिणामों को वैलिडेट करना चाहिए?
हाँ। AI स्क्रैपिंग को अधिक लचीला बना सकता है, लेकिन यह पेज को गलत पढ़ सकता है, फ़ील्ड को मिलाकर दे सकता है, छिपा हुआ कंटेक्स्ट मिस कर सकता है, या लेआउट बदलने पर असंगत स्ट्रक्चर लौट सकता है। प्रोडक्शन वर्कफ़्लो में स्कीमा चेक, सैंपल रिव्यू, चेंज अलर्ट, एरर हैंडलिंग, और संवेदनशील निर्णयों के लिए मानव रिव्यू शामिल होना चाहिए।
AI वेब स्क्रैपिंग टूल्स पर अंतिम विचार
Bright Data उन टीमों के लिए सबसे मजबूत समग्र विकल्प है जिन्हें गंभीर इन्फ्रास्ट्रक्चर और बड़े सार्वजनिक‑डेटा प्रोग्राम चाहिए। Firecrawl AI एप्लिकेशन के लिए LLM‑तैयार वेब संदर्भ चाहिए तो सबसे साफ़ फिट है, जबकि Apify डेवलपर्स को कस्टम स्क्रेपर, Actors, और ब्राउज़र ऑटोमेशन के लिए लचीला प्लेटफ़ॉर्म देता है।
व्यावसायिक टीमों के लिए Browse AI और Octoparse आवर्ती डेटा संग्रह को अधिक सुलभ बनाते हैं, बिना हर वर्कफ़्लो को इंजीनियरिंग प्रोजेक्ट बनाने के। ScrapingBee एक मजबूत डेवलपर‑फ़्रेंडली API है, जो नेचुरल‑लैंग्वेज एक्सट्रैक्शन, जावास्क्रिप्ट रेंडरिंग, और संरचित आउटपुट बिना ब्राउज़र और प्रॉक्सी इन्फ्रास्ट्रक्चर बनाए देता है।
SearchAPI तब प्रमुख बनता है जब आवश्यकता रियल‑टाइम, संरचित सर्च‑इंजन डेटा SEO, रिसर्च, या AI एजेंट्स के लिए हो, न कि मनमाना वेबसाइट क्रॉलिंग। Oxylabs एंटरप्राइज़ स्क्रैपिंग API और कठिन सार्वजनिक वेबसाइटों के लिए सबसे अच्छा है, Diffbot तब आकर्षक है जब एंटिटी एक्सट्रैक्शन और नॉलेज ग्राफ़ संदर्भ महत्वपूर्ण हो, और ScrapeGraphAI AI वर्कफ़्लो के लिए लचीला प्रॉम्प्ट‑ड्रिवन एक्सट्रैक्शन विकल्प प्रदान करता है।




