
Fondamentaux de l’IA
Qu’est‑ce que la régression linéaire ?

 Ajouter Unite.AI à vos sources préférées sur Google
Régression linéaire modélise une cible continue comme une combinaison linéaire d’une ou plusieurs caractéristiques d’entrée. Elle est utilisée pour la prédiction, l’estimation et comme référence transparente afin de déterminer si un modèle plus complexe apporte une valeur significative.
Les termes variable indépendante et variable dépendante décrivent des rôles dans le modèle, et non une relation de cause à effet prouvée. Une régression peut identifier une association tandis que la confusion, le biais de sélection, la causalité inversée ou une erreur de mesure expliquent la relation.
Points clés
- La cible y est modélisée à partir des caractéristiques d’entrée X ; la version antérieure de l’article avait inversé ces libellés dans une explication de formule.
- Les moindres carrés ordinaires minimisent la somme des résidus au carré.
- Les diagnostics des résidus et les hypothèses sont importants pour l’inférence et l’incertitude.
- La régularisation ridge et lasso aide lorsque les prédicteurs sont nombreux ou corrélés.
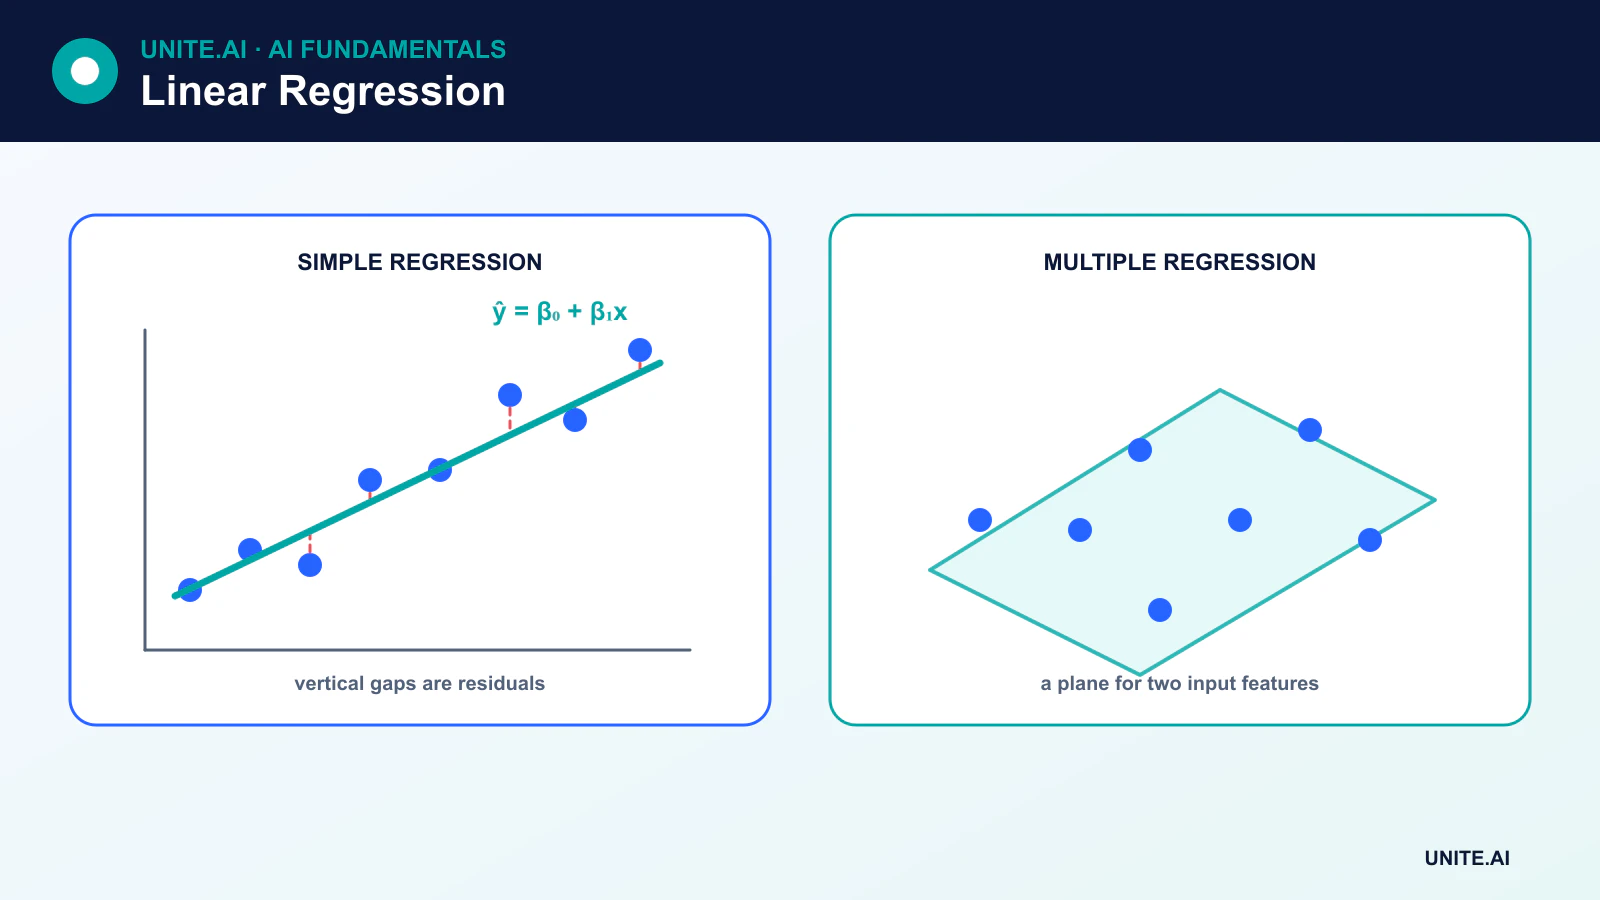
Régression linéaire simple
Avec une caractéristique, le modèle est :
ŷ = β₀ + β₁x
β₀ est l’intercepte et β₁ est la pente. Le résidu pour l’observation i est yᵢ - ŷᵢ. Les moindres carrés ordinaires (MCO) choisissent les coefficients qui minimisent la somme des résidus au carré.
La pente estime le changement attendu de la cible associé à une variation d’une unité de la caractéristique selon le modèle ajusté. Elle ne doit pas être décrite comme un effet causal, sauf si la conception de l’étude et les hypothèses soutiennent une identification causale.
Régression linéaire multiple
Avec p caractéristiques :
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
Chaque coefficient est interprété conditionnellement aux autres caractéristiques incluses. La régression multiple peut incorporer des variables catégorielles via l’encodage, des termes polynomiaux et des interactions. Elle reste « linéaire » car elle est linéaire dans les coefficients, même si des caractéristiques transformées comme x² sont incluses.
Hypothèses et diagnostics
Pour la prédiction, la question centrale est la capacité de généralisation du modèle. Pour les tests classiques de coefficients et les intervalles, des hypothèses supplémentaires deviennent importantes :
- Linéarité : la moyenne conditionnelle est représentée par la forme linéaire choisie.
- Erreurs indépendantes ou correctement modélisées : des observations répétées, groupées, spatiales ou en séries temporelles peuvent nécessiter une structure d’erreur différente.
- Variance constante des erreurs : l’hétéroscédasticité affecte les erreurs standards et les estimations d’incertitude.
- Multicolinéarité limitée : des prédicteurs fortement corrélés rendent les coefficients individuels instables.
- Distribution des résidus : la normalité est pertinente pour certaines inférences sur petits échantillons, mais il n’est pas requis que chaque caractéristique soit distribuée normalement.
Les graphiques de résidus, les mesures de levier et d’influence, ainsi que la revue du domaine peuvent identifier des valeurs aberrantes, une non‑linéarité, une variance changeante ou des observations qui dominent l’ajustement.
Évaluation des prédictions
- Erreur absolue moyenne (MAE) moyenne la taille absolue des résidus.
- Erreur quadratique moyenne (MSE) accorde plus de poids aux erreurs importantes.
- Racine de l’erreur quadratique moyenne (RMSE) ramène l’erreur au carré aux unités de la cible.
- R² compare la variation des résidus à une base constante sur les données évaluées.
Le R² n’est pas une mesure de précision, n’établit pas de causalité et peut être négatif sur des données de validation. La validation doit correspondre au contexte réel de prédiction, incluant des découpages temporels ou par groupe lorsque nécessaire.
Ridge, lasso et elastic net
Ridge regression ajoute une pénalité L2 qui réduit les coefficients et stabilise les prédicteurs corrélés. Lasso ajoute une pénalité L1 et peut mettre les coefficients à zéro. Elastic net combine les deux. Les caractéristiques doivent généralement être mises à l’échelle de façon compatible avant de comparer ces pénalités.
La régularisation introduit un biais en échange d’une variance plus faible et peut réduire le surapprentissage. L’intensité de la pénalité est choisie par validation, et non sur le jeu de test final.
Quand la régression linéaire n’est pas l’outil adéquat
Un modèle linéaire peut échouer lorsque les relations sont fortement non linéaires, que les erreurs dépendent de valeurs passées, que les distributions cibles nécessitent une modélisation spécialisée, ou que quelques valeurs aberrantes dominent la perte quadratique. Les arbres de décision, les modèles linéaires généralisés, les modèles de séries temporelles, la régression robuste ou les méthodes non linéaires peuvent mieux convenir.
Même lorsqu’un modèle complexe l’emporte, la régression linéaire demeure une référence précieuse. Si un système important ne peut pas la surpasser de façon fiable, la complexité supplémentaire peut ne pas être justifiée.
Hypothèses du modèle, estimation et diagnostics
La régression linéaire modélise la moyenne conditionnelle d’un résultat numérique comme un intercept plus des prédicteurs pondérés. Les moindres carrés ordinaires choisissent les coefficients qui minimisent les résidus au carré. Les coefficients décrivent le changement attendu du résultat pour une variation d’une unité du prédicteur, les autres variables incluses étant maintenues constantes, selon le modèle spécifié. Il s’agit d’une association, sauf si les hypothèses d’identification causale et la conception de l’étude le justifient. Les unités, le codage, les transformations, les interactions et les catégories de référence déterminent l’interprétation, de sorte que des coefficients sans dictionnaire de données sont incomplets.
L’inférence classique repose sur des hypothèses concernant la forme fonctionnelle, l’indépendance des erreurs, la variance constante et la distribution des erreurs pour certains tests et intervalles. Les graphiques résidu‑vs‑ajusté révèlent la non‑linéarité ou l’hétéroscédasticité ; les graphiques Q–Q évaluent le comportement des queues ; les diagnostics de levier et d’influence identifient les observations qui affectent fortement les estimations. Les prédicteurs corrélés gonflent l’incertitude et rendent les coefficients individuels instables même lorsque les prédictions restent adéquates. Des erreurs standards robustes, des transformations, des splines, une structure hiérarchique ou un autre modèle peuvent être nécessaires plutôt que de supprimer des points de données gênants.
Régularisation, évaluation et usage responsable
La régression ridge réduit les coefficients avec une pénalité L2, tandis que le lasso peut mettre certains à zéro avec une pénalité L1 ; l’elastic net les combine. Standardisez les prédicteurs lorsque l’échelle de la pénalité doit être comparable et choisissez l’intensité à l’aide de la validation ou de la validation croisée. Évaluez l’erreur absolue moyenne, la racine de l’erreur quadratique moyenne, la distribution des résidus, l’étalonnage sur les différentes plages et l’incertitude, avec des découpages temporels ou par groupe reflétant l’usage. Comparez avec une référence moyenne et des alternatives non linéaires, mais conservez les modèles linéaires lorsque la transparence et la stabilité sont précieuses.
L’extrapolation au‑delà de la plage observée des prédicteurs suit la droite ajustée sans preuve et peut être dangereuse. Surveillez les plages de caractéristiques, les valeurs manquantes, les résidus et les erreurs de sous‑groupes en production. Les intervalles de prédiction décrivent l’incertitude d’un résultat individuel et sont plus larges que les intervalles de confiance pour la moyenne ; les deux nécessitent des hypothèses. Évitez de contrôler des variables qui introduisent un biais causal lorsque l’objectif est l’estimation d’effet. La régression linéaire est un outil précis pour une relation définie, pas une garantie universelle que le monde est linéaire ou qu’un coefficient représente une intervention.
Exemple pratique : estimation du temps de livraison
Une équipe logistique modélise la durée de livraison à partir de la distance, du niveau de service, de la région, du jour de la semaine et des conditions météorologiques connues. Elle examine les motifs de résidus non linéaires et ajoute des splines et interactions justifiées plutôt que de traiter l’équation linéaire comme une physique littérale. Les groupes transporteur et itinéraire définissent les plis de validation. L’erreur absolue moyenne, l’erreur de queue, la couverture d’intervalles et le biais systématique sont rapportés. Les livraisons annulées et les données enregistrées après l’arrivée sont exclues ou modélisées explicitement.
Les coefficients sont documentés avec leurs unités et vérifiés pour instabilité sous des prédicteurs corrélés. Le modèle refuse l’extrapolation au‑delà des distances et régions validées. Des intervalles de prédiction accompagnent les estimations, et la planification en aval utilise leur incertitude. La surveillance suit les plages de caractéristiques, les résidus, la couverture d’intervalles et le biais après les changements du réseau. Une affirmation de causalité concernant le transporteur ou la météo n’est pas faite à partir des coefficients prédictifs ; des expériences opérationnelles ou une identification plus solide seraient nécessaires pour soutenir une intervention.
Preuve d’implémentation et disponibilité opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec l’étalonnage ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise à jour, les exceptions, les modifications, les retours en arrière et la mise hors service. Utilisez un déploiement progressif, conservez un repli sûr et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, un apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Questions fréquemment posées
La régression linéaire nécessite‑t‑elle une seule variable d’entrée ?
Non. La régression simple possède un seul prédicteur, tandis que la régression linéaire multiple peut utiliser de nombreuses caractéristiques numériques, catégorielles encodées, transformées et d’interaction.
La régression linéaire peut‑elle prouver la causalité ?
Non. Une interprétation causale requiert une conception de recherche défendable et des hypothèses concernant la confusion, la sélection, la mesure et l’intervention. Un coefficient prédictif à lui seul décrit une association dans le modèle ajusté.
Références principales












