AI:n perusteet
Mitä on mekaaninen tulkittavuus? Kuinka tutkijat analysoivat AI-malleja

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Mekaaninen tulkittavuus tutkii, miten neuroverkon oppivat komponentit aiheuttavat käyttäytymisen. Sen sijaan, että vain korreloitaisiin syötteiden ja tulosten välillä, tutkijat muodostavat hypoteeseja ominaisuuksista, huomion päistä, neuroneista ja piireistä, ja sitten puuttuvat niihin testatakseen hypoteeseja.
Alalla on tuotettu yksityiskohtaisia selityksiä valikoiduille käyttäytymisille pienissä ja keskisuurissa malleissa, mutta täydellinen, uskollinen kuvaus huipputason mallista on edelleen tavoittamattomissa. Automaattiset selitykset ja houkuttelevat visualisoinnit voivat olla hyödyllisiä lähtökohtia, eivät kuitenkaan todistusta.
Keskeiset havainnot
- Ominaisuudet ovat edustettuja kuvioita; piirit ovat vuorovaikutteisia komponentteja, joiden oletetaan toteuttavan laskennan.
- Aktivointikorjaus, ablaatio ja kausaalinen jäljitys testaavat, muuttaako komponentti käyttäytymistä.
- Superpositio tarkoittaa, että yksi neuroni voi osallistua moniin ominaisuuksiin; harvat automaattikooderit pyrkivät eri ominaisuuspohjaan.
- Tulkittavuusmenetelmät tarvitsevat totuustiedon, falsifioitavat testit, kattavuuden ja arvioinnin vaihtoehtoisia selityksiä vastaan.
Edustuksesta mekanismiin
Kysely pyrkii selvittämään, voidaanko tieto dekoodata aktivoinnista. Attribuutio arvioi, mitkä syötteet tai komponentit ovat merkityksellisiä. Mekaaninen työ menee pidemmälle ehdottamalla sisäistä laskentaa ja tarkistamalla, muuttavatko puuttumiset odotettua väli- ja lopullista käyttäytymistä.
Tämä tekee siitä liittyvän, mutta kapeamman kuin selitettävä tekoäly. Jälkikäteen annettu selitys yhdelle päätökselle ei välttämättä ole mallin sisällä käännetty algoritmi.
Piirit ja kausaaliset puuttumiset
Tutkijat voivat tunnistaa tehtävään liittyvän huomion pään tai ominaisuuden, ablaoida sen, korjata aktivointeja toisesta suorituksesta tai jäljittää, miten tieto liikkuu kerrosten läpi. Hyvä hypoteesi ennustaa käyttäytymistä uusilla esimerkeillä ja kestää kontrollit.
Puuttumiset voivat luoda jakautumisen ulkopuolisia tiloja, joten käyttäytymisen muutos ei automaattisesti paljasta luonnollista laskentaa. Käytä useita menetelmiä, vastaavia kontrolleja ja kvantitatiivisia vaikutuksia yhden havainnollistavan kehotteen sijaan.
Superpositio ja harvat ominaisuudet
Neuroverkot voivat edustaa enemmän ominaisuuksia kuin yksittäiset ulottuvuudet superponoitumalla ne. Neuroni voi siten aktivoitua useille toisistaan riippumattomille kuvioille, mikä tekee neuronitasoisista tunnisteista harhaanjohtavia.
Harvat automaattikooderit oppivat laajemman ominaisuuksisanaston mallin aktivoinneista. Ne voivat tehdä kuvioista erotettavampia, mutta valittu harvaisuus, harjoitusdata, rekonstruointivirhe ja automatisoidut tunnisteet vaikuttavat siihen, mitä palautetaan. Neuroverkko-ominaisuudet vaativat edelleen kausaalisen validoinnin.
Turvallisuus, virheenkorjaus ja rajoitukset
Mekaaniset työkalut voivat auttaa löytämään tallennettuja faktoja, vinoumia, harhaanjohtavia strategioita tai epäonnistumispiritteitä ja voivat tukea muokkausta tai seurantaa. Samat työkalut voivat kuitenkin ohittaa hajautetut, harvinaiset tai kontekstiriippuvaiset laskennat.
Käsittele löydöksiä rajattuna todistusaineistona: mallin versio, tehtävä, aineisto, kerros, puuttuminen, vaikutus ja epävarmuus. Liitä tulkinta käyttäytymisarviointeihin, punatiimiin ja vastuullisen AI:n hallintoon sen sijaan, että käyttäisit sitä yleisenä turvallisuussertifikaattina.
Edustukset, piirit ja kausaalinen todistusaineisto
Mekaaninen tulkittavuus tutkii, miten sisäiset laskennat tuottavat mallin käyttäytymisen. Tutkijat tarkastelevat aktivointeja, painoja, huomiota ja väliaikaisia ominaisuuksia, ja sitten muodostavat hypoteeseja edustuksista ja piireistä. Edustus ei välttämättä ole tallennettu yhteen neuroniin; se voi olla hajautettu suuntiin, kerroksiin, token- ja kontekstiriippuvaisiin yhdistelmiin.
Harvat automaattikooderit pyrkivät hajottamaan tiiviit aktivoinnit laajempaan ominaisuuksien joukkoon, jotka aktivoituvat valikoivasti. Ominaisuustunnisteet ovat ihmisen tulkintoja havaituista esimerkeistä, eivät totuustietoa. Rekonstruointivirhe, harvaisuus, ominaisuuksien jakautuminen, absorptio ja kuolleet ominaisuudet vaikuttavat siihen, mitä hajotelma paljastaa ja mitä se jättää huomiotta.
Korrelaatio ei riitä mekaaniseen väitteeseen. Aktivointikorjaus, ablaatio, kausaalinen jäljitys, ohjaus ja kohdennetut painopuutokset testaavat, muuttaako komponentti käyttäytymistä ennustetusti. Puuttumiset voivat myös luoda jakautumisen ulkopuolisia tiloja, joten tulokset tarvitsevat kontrollit, annos‑vaste‑analyysin, vaihtoehtoiset selitykset ja toistettavuuden kehotteiden ja mallien välillä.
Tiukka tulkittavuustyövirta
Aloita tarkasti mitatulla käyttäytymisellä ja aineistolla, joka erottaa kilpailevat hypoteesit. Paikanna relevantit kerrokset, paikat, komponentit tai ominaisuudet; tarkastele ehdokasmekanismeja; puutu; ja testaa, ennustaaanko ehdotettu piiri uusia tapauksia. Pidä tutkimukselliset esimerkit erillään vahvistavasta arvioinnista valintaharhan vähentämiseksi.
Automaattiset työkalut voivat luokitella neuroneja, ominaisuuksia, päitä tai polkuja, kun taas kielimallit voivat ehdottaa kuvauksia. Automaatio lisää kattavuutta, mutta voi myös koota uskottavia tarinoita. Arvioi selitykset pidetyillä aktivointiesimerkeillä ja kausaalisilla ennusteilla, tallenna epävarmuus ja tee artefaktit toistettaviksi mallin version, tokenisoijan, kehotteiden ja koodin avulla.
Mekaanismit voivat olla monimerkityksellisiä, redundansseja, epälineaarisia ja hajautettuja. Yhden komponentin poistamisen muut voivat kompensoida, kun taas ominaisuus voi osallistua useisiin käyttäytymisiin. Negatiiviset havainnot ovat informatiivisia: ilmeinen piiri, joka epäonnistuu kuratoitujen esimerkkien ulkopuolella, tulisi kaventaa tai hylätä sen sijaan, että pelastetaan sitä yhä epämääräisemmällä selityksellä.
Sovellukset, rajoitukset ja turvallisuusväitteet
Tulkittavuus voi auttaa virheenkorjauksessa harhaluulojen, vinoumien, muistamisen, pakotetun käyttäytymisen tai odottamattoman yleistymisen osalta; vertailla malleja; ja tuottaa tieteellisiä hypoteeseja. Se voi myös tunnistaa ominaisuuksia seurantaan tai puuttumiseen. Nämä käyttötavat vaativat tehtäväkohtaista validointia, koska hyödyllinen tutkimusvisualisointi ei automaattisesti ole luotettava tuotannon valvonta.
Havainnoimattoman ominaisuuden puuttuminen ei todista kyvyn tai aikomuksen puuttumista, eikä luettavissa oleva ominaisuus todista, että malli käyttää sitä tietyssä vastauksessa. Työkalut havaitsevat laskennan projisoinnin rajoitetulla kattavuudella. Turvallisuusväitteiden on määritettävä havaitsemisen herkkyys, väärät positiivit, jakautuma, vastustaja ja tunnetut sokeat pisteet.
Käytä tulkittavuutta yhdessä käyttäytymisarviointien, punatiimin, datanhallinnan, käyttövalvonnan, seurannan ja tapausvastauksen kanssa. Julkaise menetelmiä ja vastakohtaisia esimerkkejä kun mahdollista. Ala kehittyy nopeasti, mutta nykyiset tekniikat eivät tarjoa täydellistä, uskollista selitystä huipputason mallin päättelyyn tai yleistä takuutta soveltuvuudelle.
Käytännön esimerkki: ehdotetun mallipiirin testaaminen
Oletetaan, että malli näyttää käyttävän joukkoa huomion päitä ja ominaisuuksia ratkaistakseen epäsuoran objektin lauseessa. Tutkijat määrittelevät kontrolloidun aineiston, jossa on erilaisia nimiä, paikkoja, häiriötekijöitä ja vastakohtia, ja mittaavat käyttäytymisen. Aktivointitarkastus tunnistaa ehdokaskomponentit, mutta hypoteesi kirjoitetaan ennen puuttumista: mitä tietoa kukin komponentti kantaa, minne se siirtyy, ja miten sen muuttaminen tulisi muuttaa tulosta.
Aktivointikorjaus ja ablaatio testaavat tarpeellisuutta ja riittävyyttä pidetyillä esimerkeillä. Kohdennettu muokkaus, joka muuttaa ennustetun tokenin odotetussa suunnassa, tukee mekanismia; laaja suorituskyvyn heikkeneminen ei. Kontrollit korjaavat epäolennaisia paikkoja ja komponentteja, vaihtelevat puuttumisen voimakkuutta ja vertailevat vaihtoehtoisia piirejä. Tiimi julkaisee negatiivisia tapauksia, joissa selitys epäonnistuu, ja välttää antamasta ihmisen luettavaa tarkoitusta pelkästään korrelaatiosta.
Vakuuttaessa turvallisuussovelluksen, menetelmän on tunnistettava relevantti käyttäytyminen tunnetulla herkkyydellä realistisissa kehotteissa ja vastustavassa mukautumisessa. Ominaisuuksien monitorit arvioidaan väärien positiivien, kiertämisen, mallipäivitysten ja kausaalisen merkityksen osalta. Tulkittavuustodisteet voivat ohjata virheenkorjausta ja lisätestejä, mutta toteutus pysyy ulkoisissa valvonnissa ja käyttäytymisseurannassa. Vakuuttava piirroskaavio on tieteellinen hypoteesi todistuksineen – ei täydellinen selitys mallista tai takuu näkemättömälle käyttäytymiselle.
Käytännön toteutuksen tarkistuslista
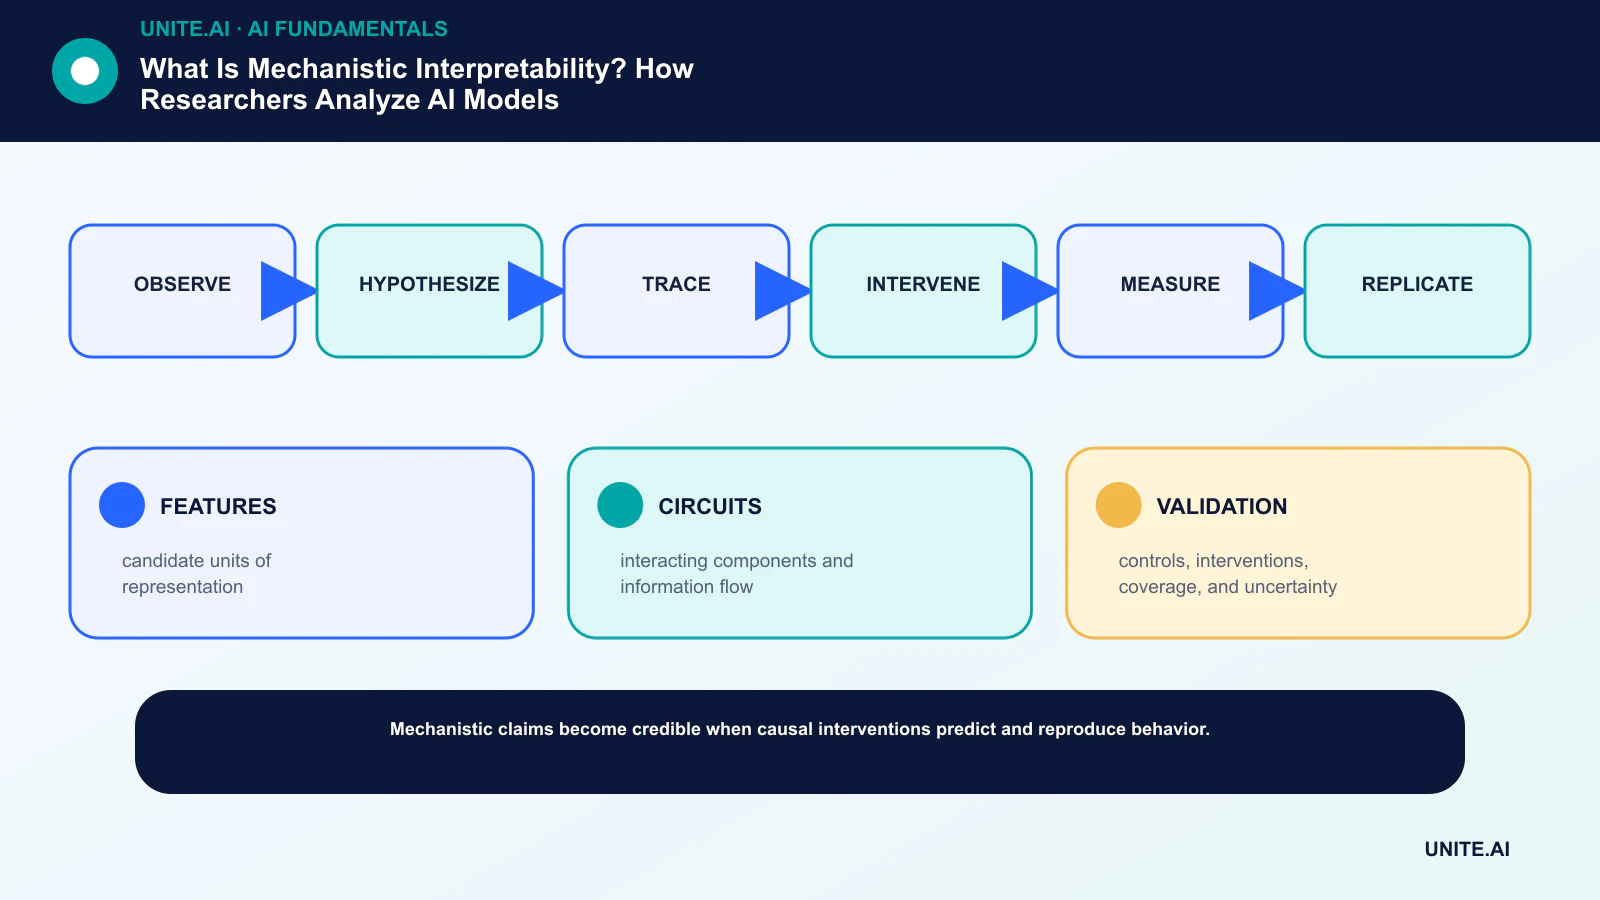
Muunna käsite rajatuksi, testattavaksi työvirraksi: havainnoi → tee hypoteesi → jäljitä → puutu → mittaa → toista. Nimeä vastuullinen omistaja, dokumentoi data ja riippuvuudet, luo yksinkertainen peruslinja, aseta hyväksymis- ja pysäytyskriteerit, testaa edustavat epäonnistumiset, ja määritä seuranta, palautus ja tarkistus ennen laajuuden laajentamista. Tallenna versiot ja oletukset, jotta toinen tiimi voi toistaa tuloksen ja ymmärtää, mitä muuttui.
Ennen käyttöönottoa suorita dokumentoitu valmiuslähtö tarkastuksella niiden ihmisten kanssa, jotka rakentavat, ylläpitävät, suojaavat ja joihin järjestelmä vaikuttaa. Testaa normaaleja tapauksia, reunatiloja, riippuvuusvirheitä ja väärinkäyttöä; säilytä todisteet ja ratkaisemattomat riskit. Määritä, kuka voi hyväksyä julkaisun, muuttaa kynnysarvoa, ohittaa tuloksen tai pysäyttää toiminnan. Tarkastele päätöstä uudelleen todellisen maailman datan saapuessa, koska teknisesti onnistunut pilotti ei takaa luotettavaa suorituskykyä laajemmassa mittakaavassa.
- OMINAISUUDET: ehdokasyksiköt edustuksista.
- PIIRIT: vuorovaikutteiset komponentit ja informaatiovirta.
- VALIDAATIO: kontrollit, puuttumiset, kattavuus ja epävarmuus.
Usein kysytyt kysymykset
Onko mekaaninen tulkittavuus sama kuin mallin painojen lukeminen?
Ei. Raakat painot eivät selitä itseään. Tutkijat analysoivat aktivointeja, ominaisuuksia, komponentteja ja puuttumisia rakentaakseen ja testatakseen kausaalisia hypoteeseja.
Voivatko harvat automaattikooderit täysin selittää LLM:n?
Ei. Ne tarjoavat ehdokasominaisuuspohjan ja voivat tukea piirianalyysiä, mutta kattavuus, uskollisuus, rekonstruointi, merkintä ja skaalautuvuus ovat edelleen avoimia ongelmia.
Ensisijaiset lähteet