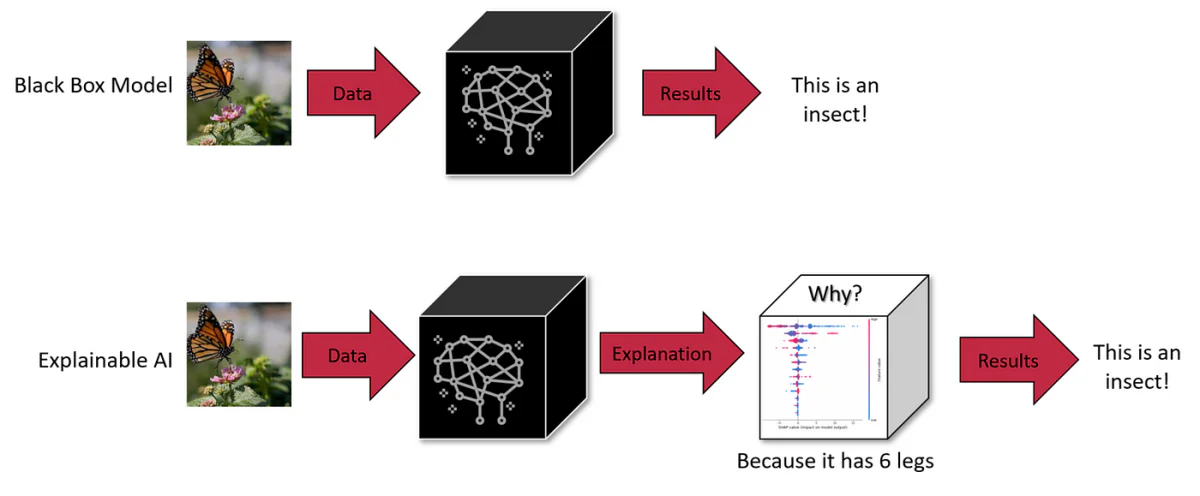
Koneoppiminen, joka on tekoälynb osa-alue, koostuu kolmesta osasta: algoritmeista, koulutusdatasta ja tuloksena olevasta mallista. Algoritmi, joka on perustuu joukko menettelytapoihin, oppii tunnistamaan kuvioita suuresta esimerkkijoukosta (koulutusdata). Tämän koulutuksen tuloksena on koneoppimismalli. Esimerkiksi algoritmi, joka on koulutettu koirien kuvilla, tuloksena on malli, joka pystyy tunnistamaan koirat kuvissa.
Musta Ritilä Koneoppimisessa
Koneoppimisessa mikä tahansa näistä kolmesta osasta – algoritmi, koulutusdata tai malli – voidaan pitää mustana ritilänä. Vaikka algoritmit ovat usein julkisesti tunnettuja, kehittäjät voivat päättää pitää mallin tai koulutusdatan salassa suojelemaan immateriaalioikeuksia. Tämä epäselvyys tekee haasteelliseksi ymmärtää tekoälyn päätöksentekoprosessia.
Te koälymustat ritilät ovat järjestelmiä, joiden sisäinen toiminta on käyttäjille epäselvä tai näkymätön. Käyttäjät voivat syöttää dataa ja vastaanottaa tulosteen, mutta logiikka tai koodi, joka tuottaa tulosteen, on piilotettu. Tämä on yleinen ominaisuus monissa tekoälyjärjestelmissä, mukaan lukien edistyneet generatiiviset mallit kuten ChatGPT ja DALL-E 3.
LLM:t kuten GPT-4 esittävät merkittävän haasteen: niiden sisäinen toiminta on suurelta osin epäselvä, mikä tekee niistä “mustia ritilöitä”. Tämä epäselvyys ei ole vain tekninen arvoitus; se aiheuttaa myös todellisia turvallisuus- ja eettisiä huolenaiheita. Esimerkiksi jos emme voi ymmärtää, miten nämä järjestelmät saavat johtopäätöksiä, voimmeko luottaa niihin kriittisillä aloilla kuten lääketieteellisissä diagnooseissa tai rahoituksellisissa arvioissa?
Mustan Ritilän Tekniikat LIME ja SHAP
Koneoppimisen (ML) ja syväoppimisen (DL) mallien tulkitettavuus auttaa meitä näkemään näiden edistyneiden mallien epäselvään sisäiseen toimintaan. Paikalliset Tulkitettavat Malli-agnostiset Selitykset (LIME) ja SHapley Additiiviset Selitykset (SHAP) ovat kaksi tällaista tulkitettavuuden tekniikkaa.
Tulkitettavuus
LIME, esimerkiksi, hajottaa monimutkaisuuden luomalla yksinkertaisempia, paikallisia korvaamismalleja, jotka approksimoivat alkuperäisen mallin käyttäytymistä tietyn syötteen ympärillä. Tekemällä näin, LIME auttaa ymmärtämään, miten yksittäiset ominaisuudet vaikuttavat monimutkaisten mallien ennusteisiin, tarjoamalla “paikallisen” selityksen sille, miksi malli teki tietyn päätöksen. Se on erityisen hyödyllinen ei-tekniikan käyttäjille, koska se kääntää mallien monimutkaisen päätöksentekoprosessin ymmärrettävään muotoon.
Malli-agnostinen Tulkitettavuus Koneoppimiselle (LIME) Lähde
SHAP, toisaalta, ottaa vaikutteita peliteoriasta, erityisesti Shapley-arvojen käsitteestä. Se määrittää “tärkeyden” arvon kullekin ominaisuudelle, osoittaen, miten paljon kunkin ominaisuus vaikuttaa todellisen ennusteen ja perusennusteen (keskiarvon ennuste kaikista syötteistä) väliseen eroon. SHAP:n vahvuus on sen johdonmukaisuudessa ja kyvyssä tarjota globaali näkökulma – se selittää yksittäisiä ennusteita, mutta antaa myös tietoa mallista kokonaisuutena. Tämä on erityisen arvokasta syväoppimismalleissa, joissa kerrosten ja parametrejen runsaus usein tekee ennusteprosessista matkan läpi labyrintin. SHAP selittää tämän määrittämällä kunkin ominaisuuden vaikutuksen, tarjoamalla selkeämmän kartan mallin päätöksentekoprosesseista.
Molemmat LIME ja SHAP ovat nousseet tärkeiksi työkaluiksi tekoälyn ja koneoppimisen alalla, vastaten kriittiseen tarpeeseen avoimuudesta ja luotettavuudesta. Kun integroidaan tekoälyä syvemmin eri sektoreihin, kyky tulkitella ja ymmärtää näitä malleja tulee olemaan enemmän kuin tekninen välttämättömyys, vaan perustava vaatimus eettiselle ja vastuulliselle tekoälykehitykselle. Nämä tekniikat edustavat merkittäviä askelia koneoppimis- ja syväoppimismallien monimutkaisuuksien selkiyttämisessä, muuttaen ne älyttömistä “mustista ritilöistä” ymmärrettäviksi järjestelmiksi, joiden päätöksiä ja käyttäytymistä voidaan ymmärtää, luottaa ja käyttää tehokkaasti.
LLM:n Mitta ja Monimutkaisuus
Näiden mallien mittakaava lisää niiden monimutkaisuutta. Otetaan esimerkiksi GPT-3, jolla on 175 miljardia parametreja, ja uudempia malleja, joilla on biljoonia. Kunkin parametrin vuorovaikutus hermoverkossa vaikuttaa emergoituvien kykyjen syntymiseen, joita ei voida ennustaa tarkastelemalla yksittäisiä komponentteja erikseen. Tämä mittakaava ja monimutkaisuus tekevät lähes mahdottomaksi ymmärtää niiden sisäistä logiikkaa, aiheuttaen esteen näiden mallien harhaisuuden tai ei-toivottujen käyttäytymisen diagnosoinnissa.
Vaihtoehto: Mitta vs. Tulkitettavuus
LLM:n mittakaavan vähentäminen voisi parantaa tulkitettavuutta, mutta seurauksena olisi heikentynyt edistynyt kyky. Mittakaava on se, mikä mahdollistaa käyttäytymisen, jota pienemmät mallit eivät voi saavuttaa. Tämä esittää sisäisen vaihtoehdon mittakaavan, kyvyn ja tulkitettavuuden välillä.
LLM:n Mustan Ritilän Vaikutus
1. Virheellinen Päätöksenteko
LLM:n, kuten GPT-3 tai BERT, päätöksentekoprosessin epäselvyys voi johtaa havaitsemattomiin harhaisuuksiin ja virheisiin. Terveydenhuolto- ja oikeuslaitosaloilla, joilla päätökset vaikuttavat laajasti, LLM:n eettisen ja loogisen perustan tarkastamattomuus on suuri huolenaihe. Esimerkiksi lääketieteellinen diagnoosimalli, joka perustuu vanhentuneeseen tai harhaanjohtavaan dataan, voi antaa vahingollisia suosituksia. Vastaavasti LLM:t palkkaamisprosesseissa voivat vaivuttavasti ylläpitää sukupuoliharhauksia. Mustan ritilän luonne ei ainoastaan piilota virheitä, vaan voi myös potentiaalisesti niitä lisätä, edellyttäen proaktiivista lähestymistapaa avoimuuden parantamiseksi.
2. Rajoitettu Soveltuvuus Moninaisissa Konteksteissa
LLM:n sisäisen toiminnan puute rajoittaa niiden soveltuvuutta. Esimerkiksi palkkaamismalli voi olla tehokas arvioimassa ehdokkaita rooliin, jossa arvostetaan käytännön taitoja enemmän kuin akateemisia tutkintoja, mallin kyvyttömyyden vuoksi sopeuttaa arviointikriteerejään. Vastaavasti lääketieteellinen malli voi kamppailla harvinaisten sairauksien diagnosoinnissa johtuen dataepätasapuolusta. Tämä joustamattomuus korostaa avoimuuden tarvetta kalibroida LLM:iä tiettyihin tehtäviin ja konteksteihin.
3. Harhat ja Tietämyksen Aukot
LLM:t ovat alttiita harhauksille ja tietämyksen aukoille, joita voidaan vähentää tarkastelemalla mallin prosessimekaniikkaa. Esimerkiksi lääketieteellinen malli voi osoittaa demografisia harhauksia, jos se on koulutettu epätasapuolisilla tietoja. Lisäksi mallin taituruus niukilla aiheilla voi johtaa yli-itsevarmoihin, virheellisiin tuloksiin. Nämä harhat ja tietämyksen aukot vaativat enemmän kuin vain lisää dataa; ne vaativat mallin prosessien tarkastelua.
4. Oikeudellinen ja Eettinen Vastuu
LLM:n epäselvyys luo oikeudellisen harmaan alueen, jossa määritellään vastuu mahdollisesta vahingosta, jonka mallin päätökset aiheuttavat. Jos lääketieteellinen malli antaa virheellisiä neuvoja, johtuen siitä potilaan vahinkoon, on vaikea määritellä vastuuta mallin epäselvyyden vuoksi. Tämä oikeudellinen epävarmuus asettaa riskejä yrityksille, jotka käyttävät LLM:iä herkillä aloilla, korostaen avoimuuden ja selkeän hallinnan tarpeen.
5. Luottamuskysymykset Herkillä Sovelluksilla
LLM:iä käytetään kriittisillä aloilla, kuten terveydenhuollossa ja rahoituksessa, ja niiden avoimuuden puute heikentää niiden luotettavuutta. Käyttäjien ja sääntelijöiden on varmistettava, etteivät nämä mallit sisällä harhauksia tai tee päätöksiä epäoikeudenmukaisilla perusteilla. LLM:iä voidaan varmistaa vain ymmärtämällä niiden päätöksentekoprosessit, korostaen selityksen tarpeen eettiselle käytölle.
6. Risit Henkilökohtaisen Tiedon Käsittelyssä
LLM:t vaativat laajaa koulutusdataa, joka voi sisältää arkaluontoista henkilökohtaista tietoa. Mallien musta ritiläluonne herättää kysymyksiä siitä, miten tätä dataa käsitellään ja käytetään. Esimerkiksi lääketieteellinen malli, joka on koulutettu potilastietojen kanssa, herättää kysymyksiä tietosuojasta ja käytöstä. Henkilökohtaisen tiedon käytön ja käytön varmistaminen edellyttää avoimia tietojen käsittelyprosesseja näissä malleissa.
Nousevat Ratkaisut Tulkitettavuudelle
Näihin haasteisiin vastataan kehittämällä uusia tekniikoita. Nämä sisältävät vastavuoroinen (CF) approksimaatiomenetelmiä. Ensimmäinen menetelmä käsittää LLM:n ohjelmointia muuttamaan tiettyä tekstikäsitettä, pitäen muita käsitteitä vakiona. Tämä lähestymistapa on vaikuttava, mutta se on resursseja vaativampi johtopäätöksessä.
Toinen lähestymistapa käsittää omistetun upottamistilan, jota ohjataan LLM:llä koulutuksen aikana. Tämä upottaminen on suunniteltu vastaamaan kausaali graafia ja auttaa löytämään vastaavuuksia, jotka approksimoivat CF:ä. Tämä menetelmä vaatii vähemmän resursseja testauksen aikana ja on osoittautunut tehokkaaksi selittämään mallin ennusteita, jopa LLM:illä, joilla on biljoonia parametreja.
Nämä lähestymistavat korostavat kausaaliselitysten tärkeyttä NLP-järjestelmissä turvallisuuden ja luottamuksen vakuuttamiseksi. Vastavuoroinen approksimointi tarjoaa tavan kuvitella, miten annettu teksti muuttuisi, jos tietty käsite sen generoimisprosessissa olisi erilainen, auttaen käytännöllisessä kausaalisessa vaikutuksen arvioinnissa korkean tason käsitteillä NLP-malleissa.
Syvä Analyysi: Selitysmenetelmät ja Kausaalisuus LLM:issä
Tutkiminen ja Ominaisuuden Tärkeys Työkalut
Tutkiminen on tekniikka, jota käytetään selvittämään, mitä sisäisiä edustuksia malleissa koodataan. Se voidaan tehdä joko valvotusti tai valvomattomasti ja on tarkoitettu määrittämään, koodataanko tiettyjä käsitteitä tiettyihin verkon osiin. Vaikka tutkiminen on tehokasta, se ei tarjoa kausaalisia selityksiä, kuten Geiger et al. (2021) korostavat.
Ominaisuuden tärkeys työkalut, toinen selitysmenetelmä, keskittyvät usein syöteominaisuuksiin, vaikka jotkut gradientipohjaiset menetelmät laajentavat tätä piilotettuihin tiloihin. Esimerkki on Integrated Gradients menetelmä, joka tarjoaa kausaalisen tulkinnan tutkimalla perus- (vastavuoroinen, CF) syötteitä. Vaikka nämä menetelmät ovat hyödyllisiä, ne kamppailevat yhä yhdistämään analyysinsä todellisiin käsitteisiin yksinkertaisten syöteominaisuuksien ulkopuolella.
Interventio-Pohjaiset Menetelmät
Interventio-pohjaiset menetelmät käsittävät syötteiden tai sisäisten edustusten muuttamista mallin käyttäytymisen tutkimiseksi. Nämä menetelmät voivat luoda vastavuoroinen tiloja kausaalisia vaikutuksia arvioimaan, mutta ne voivat tuottaa epätodennäköisiä syötteitä tai verkon tiloja, ellei niitä ohjata tarkasti. Kausaalinen Välittäjämalli (CPM), joka on inspiroitu S-oppimisen käsitteestä, on uusi lähestymistapa, joka jäljittelee selitettävän mallin käyttäytymistä vastavuoroinen syötteissä. Kuitenkin tarve erillisestä selittäjästä kullekin mallille on merkittävä rajoitus.
Vastavuoroinen Approksimointi
Vastavuoroinen on laajasti käytetty koneoppimisessa dataan vahvistamiseksi, sisältäen häiriöitä eri tekijöihin tai merkintöihin. Nämä voidaan generoida manuaalisesti, avain-sanapohjaisella korvaamisella tai automaattisella tekstiuudelleenkirjoituksella. Vaikka manuaalinen muokkaus on tarkin, se on myös resursseja vaativampi. Avain-sanapohjaiset menetelmät ovat rajoittuneita, ja generatiiviset lähestymistavat tarjoavat tasapainon sujuvuuden ja kattavuuden välillä.
Uskolliset Selitykset
Uskollisuus selityksissä viittaa mallin sisäisen päätöksenteon prosessin tarkan kuvaamiseen. Uskollisuuden määritelmä ei ole yleisesti hyväksytty, joten sitä määritellään usein eri mittareiden kautta, kuten Herkkyyden, Jatkuvuuden, Ominaisuuden Tärkeys Yhteenvedon, Robustisuuden ja Simuloitavuuden kautta. Useimmat näistä menetelmistä keskittyvät ominaisuustasolle selityksiin ja sekoittavat usein korrelaation ja kausaalisuuden. Työmme tavoitteena on tarjota korkean tason käsitteellisiä selityksiä, hyödyntäen kausaalisuuden kirjallisuutta ehdottamaan intuitiivista kriteeriä: Järjestyksessä Uskollisuus.
Olemme tutkineet LLM:iä sisältävien monimutkaisuuksien ja niiden “mustan ritilän” luonteen aiheuttamia merkittäviä haasteita. Vaaroista johtuen virheellisestä päätöksenteosta herkillä aloilla, kuten terveydenhuollossa ja rahoituksessa, eettisiin ongelmiin liittyen harhauksiin ja tietämyksen aukoihin, LLM:iä koskevan avoimuuden tarve on nykyisin merkittävää. LLM:iä ja niiden integrointi arkipäiväiseen elämään ja kriittisiin päätöksentekoprosesseihin riippuu kyvystämme tehdä nämä mallit ei ainoastaan edistyneemmiksi, vaan myös ymmärrettävämmiksi ja vastuullisemmiksi. Selityksen ja tulkitettavuuden tavoittelu ei ole pelkästään tekninen pyrkimys, vaan perustava osa tekoälyjärjestelmien luottamuksen rakentamisessa. Kun LLM:t tulevat yhä enemmän osaksi yhteiskuntaa, avoimuuden vaatimus kasvaa, ei ainoastaan tekoälypraktikoiden vaan jokaisen näiden järjestelmien kanssa vuorovaikutussa olevan käyttäjän taholta.
Olen viettänyt viimeiset viisi vuotta uppoutumalla kiinnostavaan koneoppimisen ja syvän oppimisen maailmaan. Minun intohimoni ja asiantuntemukseni ovat johtaneet minun osallistumiseen yli 50:een monipuoliseen ohjelmistosuunnitteluhankkeeseen, joissa on erityisesti painottunut AI/ML. Minun jatkuva uteliaisuuteni on myös ohjannut minun luontaisen kielen prosessoinnin pariin, jota haluan tutkia tarkemmin.


 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa