
Andersonin kulma
Miten Stable Diffusion voisi kehittyä valtavirran kuluttajatuotteeksi

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Keskeiset kohdatVakiintuneen Stable Diffusion -sovelluksen on ratkaistava monimutkaiset…
Näytä lisää
- Vakiintuneen Stable Diffusion -sovelluksen on ratkaistava monimutkaiset komentoriviasennus- ja riippuvuusongelmansa.
- Kaupallisilla kehittäjillä on oikeudellisia riskejä syväväärennösgeneroinnista ja NSFW-sisällönsuodattimista.
- Kehittyneet ominaisuudet, kuten aikajohdonmukaisuus ja tekstikääntö, vaativat pilvipohjaista prosessointia kuluttajakäyttöön.
Ironista kyllä, Stable Diffusion, uusi tekoälykuvansynteesirunko, joka on hurmannut maailman, ei olekaan vakaa eikä juuri “diffuusi” – ainakaan toistaiseksi.
Stable Diffusionin kokonaisvaltaiset ominaisuudet ovat jakautuneet muutaman kehittäjän jatkuvasti muuttuvien tarjontojen joukossa, joissa vaihdetaan viimeisintä tietoa ja teorioita Discordin eri keskusteluryhmissä – ja suurimman osan näiden pakettien asennusohjeista on hyvin kaukana “plug and play” -ominaisuudesta.
Sen sijaan asennus vaatii usein komentorivin tai BAT-eräajotiedostojen käyttöä sekä GITin, Condan, Pythonin, Minicondan ja muiden uusinta kehitystä edustavien ohjelmistokehitysympäristöjen asentamista. Nämä paketit ovat tavallisten kuluttajien koneilla niin harvinaisia, että virusten- ja haittaohjelmien torjuntaohjelmat merkitsevät niiden asennuksen usein merkiksi vaarantuneesta tietokoneesta.

Vain pieni osa vaiheista, jotka Stable Diffusionin tavanomainen asennus edellyttää. Monet jakelut vaativat myös tiettyjä Pythonin versioita, jotka voivat ristiriidassa olemassa olevien versioiden kanssa, jotka on asennettu käyttäjän laitteeseen – vaikka tämä voidaan välttää Docker-pohjaisilla asennuksilla ja tietynlaisten Conda-ympäristöjen avulla.
Viestiketjut sekä SFW- että NSFW Stable Diffusion -yhteisöissä ovat tulvassa vinkkejä ja temppuja, jotka liittyvät Python-skriptien hakkerointiin ja tavanomaisten asennusten parantamiseen, jotta voidaan parantaa toimivuutta tai ratkaista yleisiä riippuvuusvirheitä ja muita ongelmia.
Tämä jättää keskivertokuluttajan, joka on kiinnostunut luomaan upeita kuvia tekstipromptien avulla, melkein kokonaan maksullisten verkkopohjaisten API-käyttöliittymien armoille, joista suurin osa tarjoaa vain vähäisen määrän ilmaisia kuvien luontia ennen kuin käyttäjän on ostettava käyttöön oikeuttavia tokeneita.
Lisäksi lähes kaikki nämä verkkopohjaiset tarjontaa kieltäytyvät tuottamasta NSFW-sisältöä (joka voi liittyä ei-pornografisiin aiheisiin, kuten “sota”), joka erottaa Stable Diffusionin OpenAI:n DALL-E 2:n sensuroitujen palvelujen joukosta.
Photoshop Stable Diffusionille
Twitterin #stablediffusion-tunnisteen päivittäin täyttämät upeat, rohkeat ja tuonpuoleiset kuvat herättävät kiinnostusta. Laajempi yleisö odottaa luultavasti ratkaisua nimeltä ‘Photoshop Stable Diffusionille’ – monialustainen asennettava sovellus, joka sisältää Stability.ai:n arkkitehtuurin parhaimmat ja voimakkaimmat ominaisuudet sekä kehittyvän SD-kehitysyhteisön älykkäät innovaatiot, ilman kelluvia komentorivin ikkunoita, epäselviä ja jatkuvasti muuttuvia asennus- ja päivitysmenettelyjä tai puuttuvia ominaisuuksia.
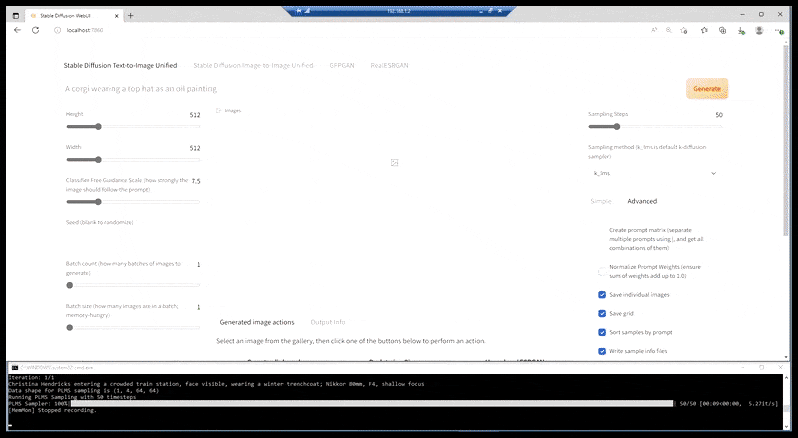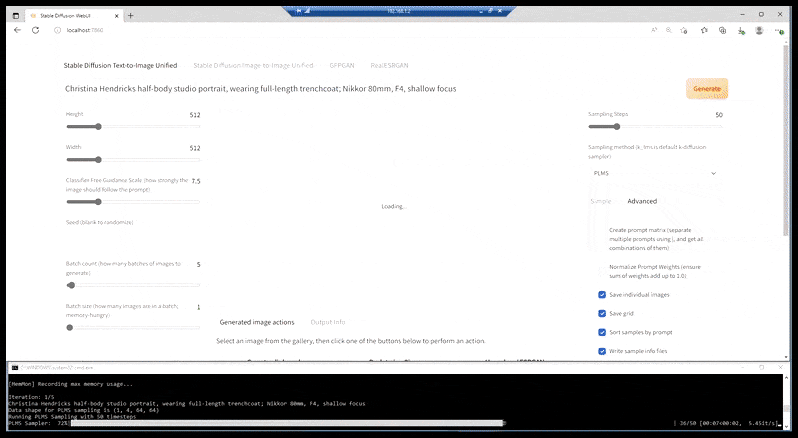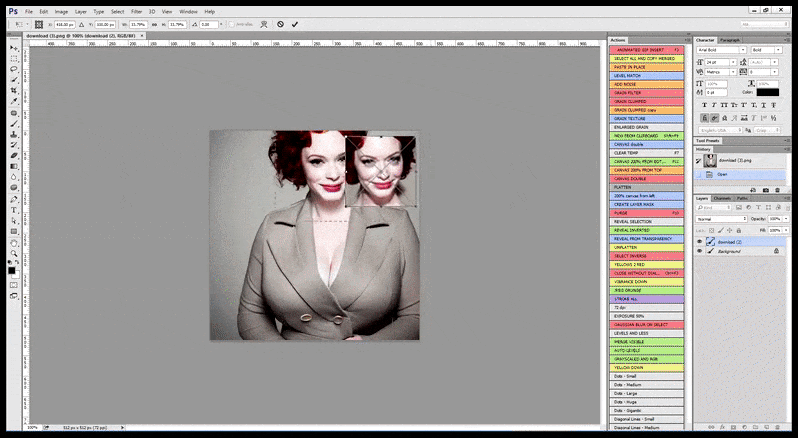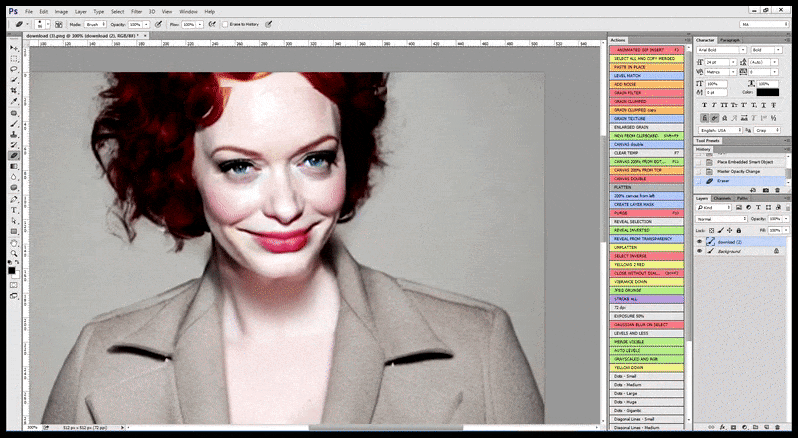
Mitä meillä on tällä hetkellä, useimmissa kyvykkäimmistä asennuksista, on erilainen verkkosivu, joka on yhdistetty irtautuneeseen komentorivin ikkunaan, ja jonka URL-osoite on localhostin portti:

Kuten CLI-ohjattavissa synteesisovelluksissa, kuten FaceSwap ja BAT-pohjaisessa DeepFaceLabissa, Stable Diffusionin ‘prepack’ -asennus näyttää komentorivin juuret, ja käyttöliittymä on saatavilla localhostin portin kautta (ks. yllä oleva kuva), joka kommunikoi CLI-pohjaisen Stable Diffusion -toiminnallisuuden kanssa.
Epäilemättä tulee olemaan sujuvampi sovellus. Jo on useita Patreon-pohjaisia integroituja sovelluksia, jotka voidaan ladata, kuten GRisk ja NMKD (ks. alla oleva kuva) – mutta mikään niistä ei ole vielä integroinut koko valikoiman ominaisuuksia, joita joitakin edistyneempiä ja vähemmän saatavilla olevia Stable Diffusion -toteutuksia voidaan tarjota.

Aikaiset, Patreon-pohjaiset Stable Diffusion -paketit, kevyesti ‘sovelluksellistettu’. NMKD on ensimmäinen, joka integroi CLI-tulosteen suoraan GUI: hen.
Tutustumme siihen, miltä tällainen hiotun ja integroidun Stable Diffusion -toteutuksen pitäisi lopulta näyttää – ja minkälaisiin haasteisiin se saattaa joutua.
Oikeudelliset Huomioon Otettavat Seikat Täysin Rahoitetussa Kaupallisessa Stable Diffusion -Sovelluksessa
NSFW -Tekijä
Stable Diffusionin lähdekoodi on julkaistu erittäin myöntävällä lisenssillä, joka ei kiellä kaupallisia uudelleen toteutuksia ja johdannaisia, jotka perustuvat lähdekoodiin.
Lisäksi mainittujen Patreon-pohjaisien Stable Diffusion -rakennusten ja laajan sovellusliitännäisten määrän lisäksi, jotka kehitetään Figmaan, Kritaan, Photoshopiin, GIMPiin ja Blenderiin (muiden joukossa), ei ole praktista syytä, miksi hyvin rahoitettu ohjelmistokehitystalo ei voisi kehittää paljon monipuolisempaa ja kykykkämpää Stable Diffusion -sovellusta. Markkinanäkökulmasta on joka syy uskoa, että useat tällaiset aloitteet ovat jo hyvin käynnissä.
Tässä kohdassa tällaiset pyrkimykset kohtaavat välittömästi dilemman siitä, sallivatko he, kuten useimmat Stable Diffusionin verkkorajapinnat, Stable Diffusionin alkuperäisen NSFW-suodattimen (koodin fragmentin) poistamisen.
‘Haudattu’ NSFW -Vaihtoehto
Vaikka Stability.ai:n avoimen lähdekoodin lisenssi Stable Diffusionille sisältää laajasti tulkittavissa olevan sovellusluettelon, johon se ei saa olla käytössä (jota voidaan tulkita sisältävän pornografisen sisällön ja deepfake -kuvia), ainoa tapa, jolla toimittaja voisi tehokkaasti estää tällaisen käytön, olisi kääntää NSFW-suodatin epäselvään suoritettavaan tiedostoon eikä Python-tiedostoon, tai muuten pakottaa tarkistussumman vertailun Python-tiedostoon tai DLL: ään, joka sisältää NSFW-ohjeen, jotta renderöintiä ei voi tehdä, jos käyttäjät muuttavat tämän asetuksen.
Tämä jättäisi sovelluksen toimintakyvyltään rajoitetuksi samalla tavalla, kuin DALL-E 2 on tällä hetkellä, vähentäen sen kaupallista vetovoimaa. Lisäksi, väistämättä, dekompiletut “väärennetty” versiot näistä komponenteista (joko alkuperäisistä Pythonin suoritusaikaisista elementeistä tai käännetyistä DLL-tiedostoista, kuten Topaz -linjan AI-kuvan parannustyökaluissa) tulisivat todennäköisesti esiin torrent / hakkeriyhteisössä, jotta nämä rajoitukset voidaan kiertää, yksinkertaisesti korvaamalla toimintaa estävät osat ja mitätöimällä kaikki tarkistussumman vaatimukset.
Lopulta toimittaja saattaa vain toistaa Stability.ai:n varoituksen väärinkäytöstä, joka on ominaista monille nykyisille Stable Diffusion -jakeluille.
Kuitenkin pienet avoimet lähdekoodin kehittäjät, jotka käyttävät tällaisia varoituksia, ovat paljon vähemmän alttiita tappioille verrattuna ohjelmistoyhtiöön, joka on investoinut merkittäviä määriä aikaa ja rahaa Stable Diffusionin tekemiseen kaikki ominaisuudet sisältäväksi ja helposti käytettäväksi – mikä kutsuu syvempää harkintaa.
Deepfake -Vastuu
Kuten aiemmin mainittiin, LAION-estetiikka -tietokanta, joka on osa 4,2 miljardia kuvaa, joihin Stable Diffusionin jatkuvat mallit on koulutettu, sisältää suuren määrän julkkisten kuvia, mikä mahdollistaa käyttäjille luoda tehokkaasti deepfake -kuvia, mukaan lukien deepfake -pornografiaa.

Aiheesta viimeisimmästä artikkelistani, neljä vaihetta Jennifer Connellyn urasta neljän vuosikymmenen ajan, johdettu Stable Diffusionista.
Tämä on erillinen ja kiistellympi asia kuin yleensä laillisen “abstraktin” pornografian tuottaminen (joka ei kuvaile “oikeita” ihmisiä, vaikka tällaiset kuvat johdetaan useista oikeista valokuvista koulutusmateriaalissa).
Koska yhä useammat Yhdysvaltain osavaltiot ja maat kehittävät tai ovat jo käyttöönottaneet lakeja deepfake -pornografian vastaisesti, Stable Diffusionin kyky luoda julkkisten pornografisia kuvia saattaa tarkoittaa, että kaupallinen sovellus, joka ei ole täysin sensuroitu (ts. joka voi tuottaa pornografista materiaalia), saattaa tarvita jollain tavoin suodattaa havaittuja julkkisten kasvoja.
Toinen tapa on tarjota sisäänrakennettu “musta lista” termejä, jotka eivät ole hyväksyttyjä käyttäjän kehotteessa, liittyen julkkaiden nimiin ja fiktiivisiin hahmoihin, joita he voivat olla yhdistetty. Luultavasti tällaiset asetukset tarvitsisivat ottaa käyttöön useissa kielissä kuin vain englannissa, koska alkuperäinen data sisältää muita kieliä. Toinen lähestymistapa voisi olla sisällyttää julkkaiden tunnistusjärjestelmät, kuten Clarifai.
Ohjelmistotuottajien on ehkä tarpeen sisällyttää tällaisia menetelmiä, ehkä aluksi pois käytöstä, mikä auttaa estämään täysin itsenäisen Stable Diffusion -sovelluksen luomasta julkkaiden kasvoja, odotellessa uutta lainsäädäntöä, joka saattaa tehdä tämän toiminnallisuuden laittomaksi.
Uudelleen, kuitenkin, tällainen toiminnallisuus voisi väistämättä olla dekompileerattavissa ja käännetyissä kiinnostuneiden tahojen toimesta; kuitenkin ohjelmistotuottaja voisi, tässä tapauksessa, väittää, että tämä on tehokkaasti luvaton vahingonteko – niin kauan kuin tällaista kääntämistä ei tehdä liian helppoa.
Ominaisuudet, Joita Voisi Sisältää
Stable Diffusionin ydintoiminnallisuus kaikissa jakeluissaan olisi odotettavissa hyvin rahoitetusta kaupallisesta sovelluksesta. Nämä sisältävät kyvyn käyttää tekstipromptteja luomaan sopivia kuvia (teksti-kuvaksi); kyvyn käyttää luonnoksia tai muita kuvia ohjeina uusille luoduille kuville (kuva-kuvaksi); keinon säätää, kuinka “mielikuvituksellista” järjestelmää on ohjattu olemaan; tapa tasapainottaa renderöintiaikaa laadun kanssa; ja muita “perusominaisuuksia”, kuten valinnainen automaattinen kuvan/promptin arkistointi ja tavanomainen valinnainen kuvan suurentaminen RealESRGAN: n avulla, ja vähintään perustavanlaatuinen “kasvojen korjaus” GFPGAN: n tai CodeFormer: n avulla.
Tämä on aika “perusasennus”. Tutustumme joitain edistyneemmistä ominaisuuksista, jotka parhaillaan kehitetään tai laajennetaan, jotka voisi sisällyttää täysimittaiseen “perinteiseen” Stable Diffusion -sovellukseen.
Stokastinen Jäädytys
Vaikka uudelleenkäytät siemenen aiemmasta onnistuneesta renderöinnistä, on hirvittävän vaikea saada Stable Diffusionin toistamaan tarkasti muodonmuutoksen, jos yksikin osa ohjauksesta tai alkuperäisestä kuvasta (tai molemmat) on muutettu seuraavassa renderöinnissä.
Tämä on ongelma, jos haluat käyttää EbSynthiä Stable Diffusionin muodonmuutosten asettamiseksi todelliseen videoon ajallisesti yhdenmukaisella tavalla – vaikka tämä tekniikka voi olla erittäin tehokas yksinkertaisissa pää-ja-olka -otoksissa:
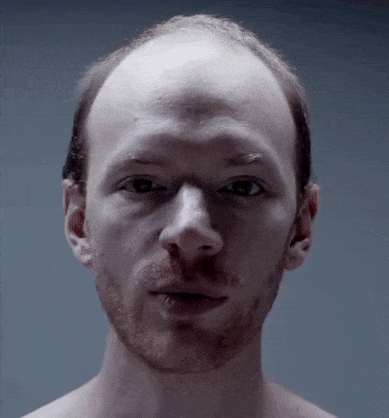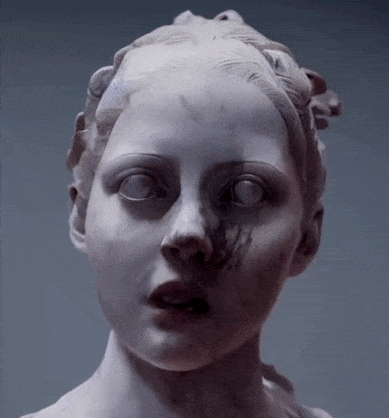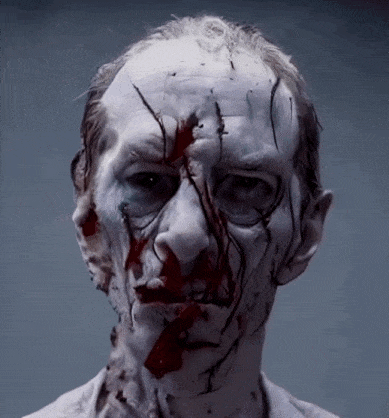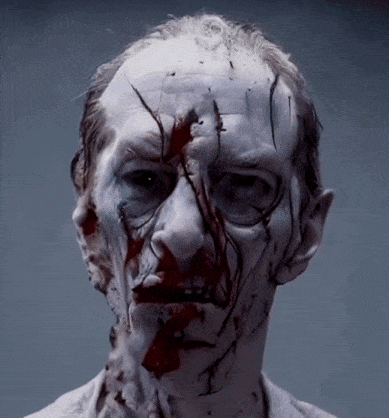
Rajoitettu liike voi tehdä EbSynthistä tehokkaan välineen muuttaa Stable Diffusionin muodonmuutokset realistiseksi videoksi. Lähde: https://streamable.com/u0pgzd
EbSynth toimii extrapoloiden pienen valikoiman “muunneltuja” avainkehyksiä videoksi, joka on renderöity sarjaksi kuvatiedostoja (ja joka voidaan myöhemmin koota takaisin videoksi).

Tässä esimerkissä EbSynth -sivustolta on maalattu pieni määrä kehyksiä videosta taiteellisella tavalla. EbSynth käyttää näitä kehyksiä tyyliohjeina muokataksesi koko videon siten, että se vastaa maalattua tyyliä. Lähde: https://www.youtube.com/embed/eghGQtQhY38
Esimerkissä alla, jossa on lähes täysin liiketöntä (aidosta) vaaleatukkainen joogaa opettavaa naista vasemmalla, Stable Diffusionilla on edelleen vaikea ylläpitää johdonmukaista kasvoa, koska kolme muunneltavaa “avainkehystä” eivät ole täysin identtisiä, vaikka ne jakavat saman numeerisen siemenen.

Tässä, vaikka ohjaus ja siemen ovat samat kaikissa kolmessa muodonmuutoksessa, ja vain vähän muutoksia alkuperäisissä kehyksissä, lihasten koko ja muoto vaihtelevat, mutta ennen kaikkea kasvo on epäjohdonmukainen, joka haittaa ajallista yhdenmukaisuutta mahdollisessa EbSynth -renderöinnissä.
Vaikka SD / EbSynth -video alla on hyvin kekseliäs, jossa käyttäjän sormet muuttuvat (vastavuoroisesti) käveleviksi housujaloiksi ja ankaksi, epäjohdonmukkuus housuissa edustaa ongelmaa, jota Stable Diffusionilla on ylläpitäessään johdonmukaisuutta eri avainkehyksissä, vaikka alkuperäiset kehykset ovat samanlaisia toisiinsa nähden ja siemen on johdonmukainen.
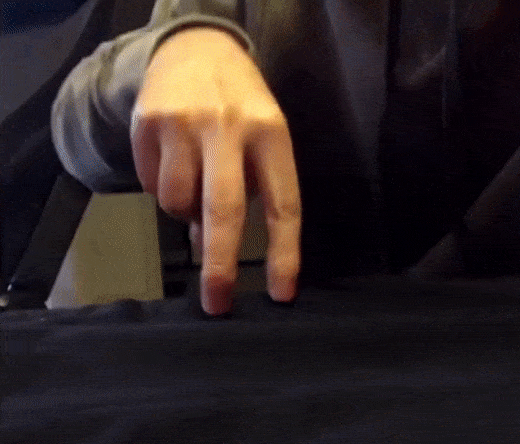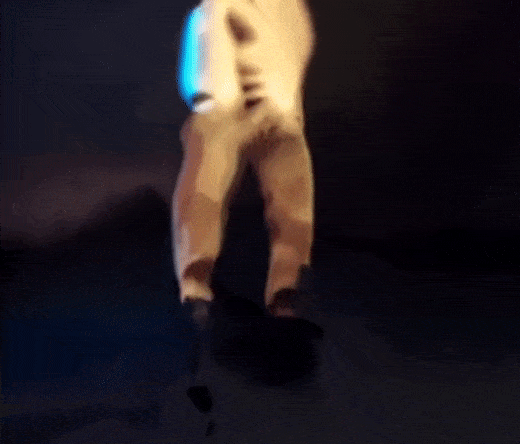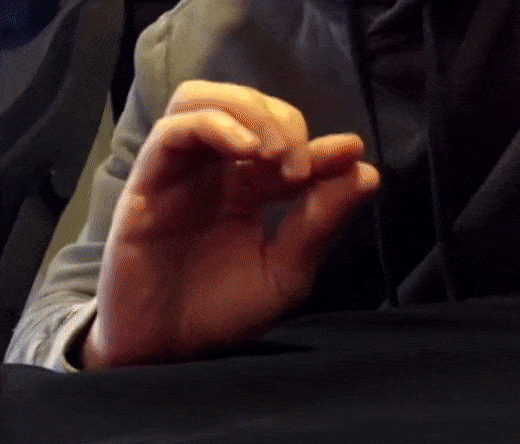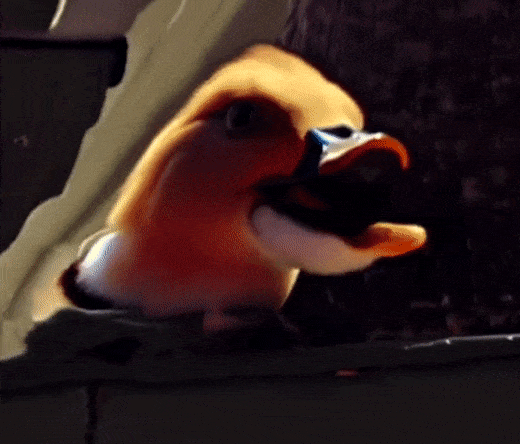
Miehen sormet muuttuvat käveleväksi mieheksi ja ankaksi Stable Diffusionin ja EbSynthin avulla. Lähde: https://old.reddit.com/r/StableDiffusion/comments/x92itm/proof_of_concept_using_img2img_ebsynth_to_animate/
Käyttäjä, joka loi tämän videon, kommentoi, että ankaksi muuttaminen, joka on kenties onnistuneempi mutta vähemmän näyttävä ja omaperäinen, vaati vain yhden muunnetun avainkehyksen, kun taas kävelevien housujen luominen edellytti 50 Stable Diffusion -kuvan renderöintiä, joissa on enemmän ajallista epäjohdonmukaisuutta. Käyttäjä huomautti myös, että se vaati viisi yritystä saavuttaa johdonmukaisuus kullekin 50 avainkehykselle.
Sen vuoksi olisi suuri etu todella kattavalle Stable Diffusion -sovellukselle tarjota toiminnallisuutta, joka säilyttää ominaisuuksia mahdollisimman hyvin avainkehyksissä.
Toinen mahdollisuus on, että sovellus sallii käyttäjän “jäädyttää” stokastisen koodauksen muodonmuutokselle, mikä voidaan tällä hetkellä saavuttaa vain muokkaamalla lähdekoodia manuaalisesti. Kuten alla oleva esimerkki osoittaa, tämä auttaa ajallista yhdenmukaisuutta, vaikka se ei ratkaise sitä täysin:
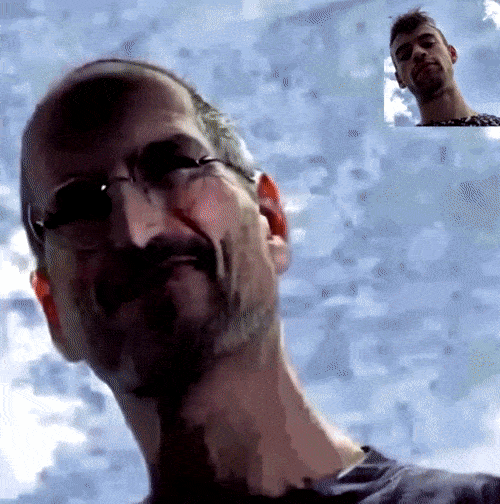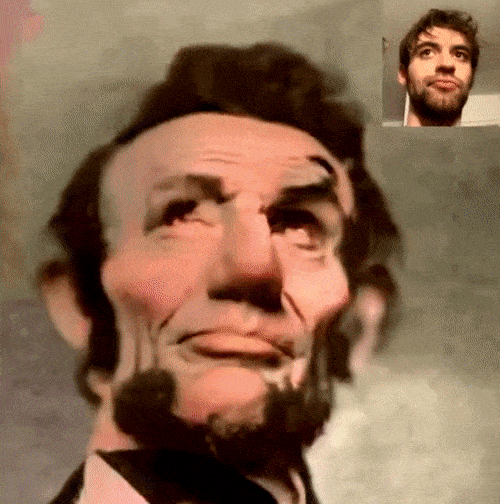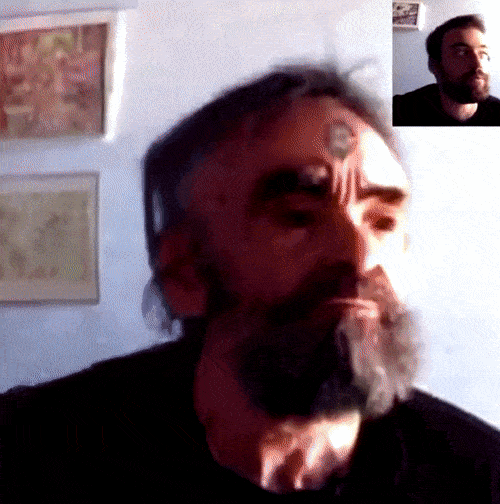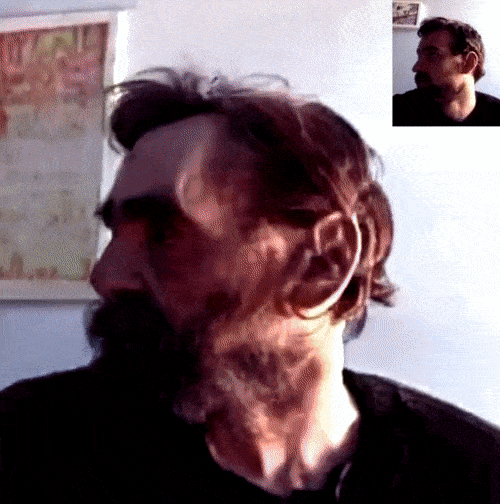
Yksi Reddit -käyttäjä muutti webcam -kuvaa eri kuuluisiin ihmisiin säilyttämällä paitsi siemenen (mitä mikä tahansa Stable Diffusionin toteutus voi tehdä), vaan varmistamalla, että stochastic_encode() -parametri oli identtinen jokaisessa muodonmuutoksessa. Tämä tehtiin muokkaamalla koodia, mutta sen voisi helposti toteuttaa käyttäjän kytkimenä. Se ei kuitenkaan ratkaise kaikkia ajallisen jatkuvuuden ongelmia. Lähde: https://old.reddit.com/r/StableDiffusion/comments/wyeoqq/turning_img2img_into_vid2vid/
Pilvipohjainen tekstuaalinen inversio
parempi ratkaisu saavuttamaan ajallisesti yhdenmukaiset hahmot ja objektit on “paistaa” ne tekstuaaliseen inversioon – 5 KB:n tiedostoon, joka voidaan kouluttaa muutamassa tunnissa vain viidellä annotoidulla kuvalla, jota voidaan sitten kutsua erityisellä ‘*’ -ohjausmerkillä, mahdollistaen esimerkiksi uusien hahmojen ylläpitämisen kertomuksessa.

Kuvat, jotka liittyvät soveltuviin merkintöihin, voidaan muuttaa erillisiin entiteetteihin tekstuaalisen inversion kautta, ja kutsua ilman epäselvyyttä ja oikeassa asiayhteydessä ja tyylissä, erityisillä token -sanoilla. Lähde: https://huggingface.co/docs/diffusers/training/text_inversion
Tekstuaaliset inversiot ovat liitännäisiä tiedostoja hyvin suurelle ja täysin koulutetulle mallille, jonka Stable Diffusion käyttää, ja ne voidaan “liittää” kutsuvaan / ohjausprosessiin, jotta ne voivat osallistua mallin johdannaisiin kohtauksiin ja hyötyä mallin valtavasta tietopohjasta objekteista, tyyleistä, ympäristöistä ja vuorovaikutuksista.
Kuitenkin, vaikka tekstuaalisen inversion kouluttaminen ei kestä kauan, se vaatii suuren määrän VRAM: ia; useiden nykyisten opaskirjojen mukaan, jonnekin 12, 20 ja jopa 40 GB: ään.
Koska useimmat satunnaiset käyttäjät eivät todennäköisesti ole kyseistä GPU -voimaa käytettävissään, pilvipalvelut ovat jo ilmestyneet, jotka käsittelevät toiminnon, mukaan lukien Hugging Facen versio. Vaikka on Google Colab -toteutukset, jotka voivat luoda tekstuaalisia inversioita Stable Diffusionille, vaadittu VRAM ja aikavaatimukset saattavat tehdä ne haasteellisiksi ilmaiseksi Colab -käyttäjille.
Hyvin rahoitetulle ja kattavalle asennettavalle Stable Diffusion -sovellukselle tämän raskaan tehtävän siirtäminen yrityksen pilvipalvelimille olisi ilmeinen ansaintatapa. Tämä edellyttää, että edulliseen tai ilmaiseen sovellukseen sisältyy tällaisia maksullisia toimintoja, mikä vaikuttaa todennäköiseltä monissa tästä teknologiasta seuraavien 6–9 kuukauden aikana kehittyvissä sovelluksissa.
Lisäksi lähetettyjen kuvien ja tekstin melko monimutkainen annotointi ja muotoilu voisi hyötyä automatisoinnista integroidussa ympäristössä. Mahdollinen “riippuvuustekijä” luoda yksilöllisiä elementtejä, jotka voivat tutkia ja vuorovaikuttaa Stable Diffusionin laajoihin maailmoihin, näyttäisi mahdollisesti koukuttavalta sekä yleisille faneille että nuoremmille käyttäjille.
Kehotteiden monipuolinen painotus
On olemassa useita nykyisiä toteutuksia, jotka sallivat käyttäjän antaa suuremman painoarvon pitkän teksti-ohjauksen osalle, mutta välineet vaihtelevat paljon näiden toteutusten välillä ja ovat usein kömpelöitä tai epäintuitiivisia.
Esimerkiksi erittäin suosittu Stable Diffusion -haara AUTOMATIC1111: ltä voidaan laskea tai korottaa kehotteen arvo sulkemalla sen ympärille yhdet tai useammat sulkeet (painon vähentämiseksi) tai hakasulkeita (lisäpainotus).

Hakasulkeet ja / tai sulkeet voivat muuttaa aamiaiseksi tällä Stable Diffusionin kehotteen painotusversiossa, mutta se on kolesterolin painajainen kummallakin tavalla.
Muiden Stable Diffusionin toteutusten toteutuksissa käytetään huutomerkkejä korostamiseen, kun taas kaikkein joustavimmat sallivat käyttäjien määrittää painotukset kullekin sanalle kehotteessa GUI: n kautta.
Järjestelmän pitäisi myös sallia negatiiviset kehotteen painotukset – ei vain kauhun ystäville, vaan koska voi olla vähemmän häiritseviä ja enemmän opettavaisia mysteerejä Stable Diffusionin latenteissa tiloissa kuin mitä meidän rajoitettu kielenkäyttö voi kutsua.
Kuvan laajentaminen (outpainting)
Pian Stable Diffusionin sensaatiomaisen avoimen lähdekoodin jälkeen OpenAI yritti – suurelta osin turhaan – palauttaa osan DALL-E 2: n salamasta julkistamalla kuvan laajentamisen eli outpaintingin, joka sallii käyttäjän laajentaa kuvaa sen rajojen ulkopuolelle semanttisella logiikalla ja visuaalisella johdonmukaisuudella.
Luonnollisesti tämä on jo toteutettu eri muodoissa Stable Diffusionille, sekä toteutettu ja Kritan liitännäisessä, ja se pitäisi sisällyttää kattavaan, Photoshop-tyyliseen Stable Diffusion -versioon.
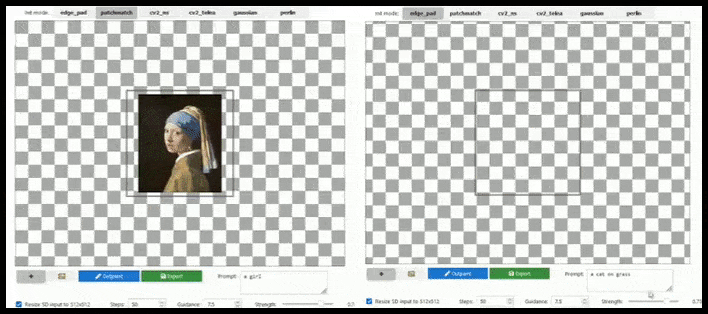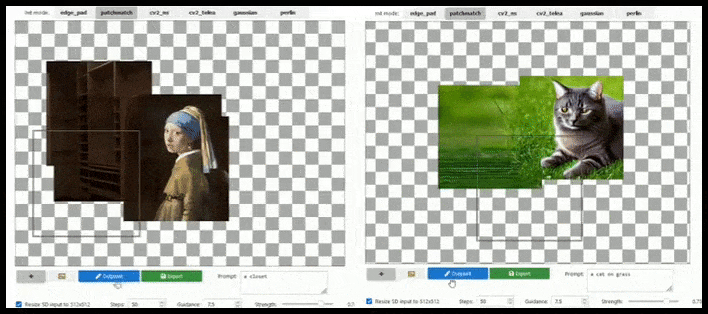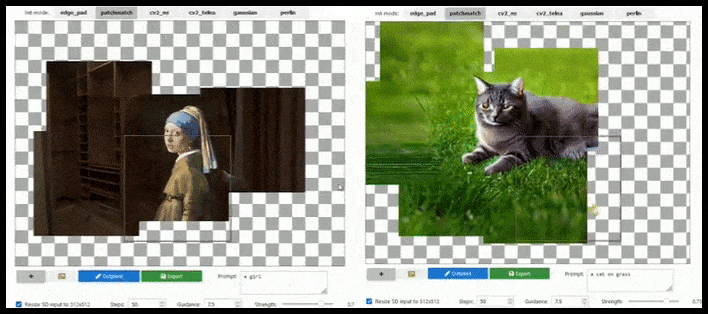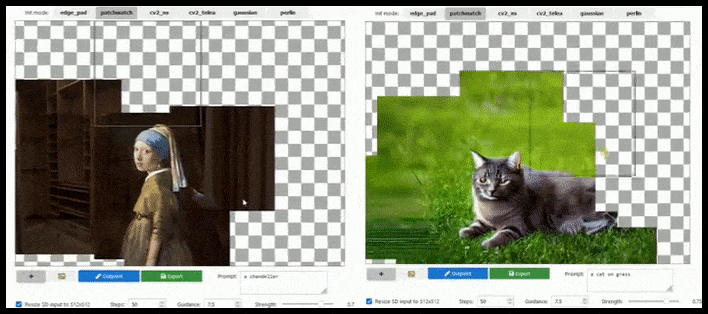
Laattapohjaisella täydentämisellä tavallista 512 × 512 pikselin kuvaa voidaan laajentaa lähes rajattomasti, kunhan ohjaukset, olemassa oleva kuva ja semanttinen logiikka sallivat sen. Lähde: https://github.com/lkwq007/stablediffusion-infinity
Koska Stable Diffusion on koulutettu 512x512px: n kuvilla (ja useista muista syistä), se usein leikkaa ihmisten päät (tai muita olennaisia kehon osia) pois, vaikka ohjaus on selvästi osoittanut “pään korostusta” jne..

Tyypillisiä Stable Diffusionin “päätömistä”; mutta kuvan laajentaminen voisi palauttaa Georgeen kuvan.
Yllä olevan animaation kaltaisen kuvanlaajennuksen pitäisi myös tarjota tähän ongelmaan yhden napsautuksen tai kehotteen korjaus. Esimerkkitoteutus perustuu vain Unix-kirjastoihin, mutta sen pitäisi olla toisinnettavissa Windowsissa.
Tällä hetkellä monet käyttäjät laajentavat päätä vailla olevan kuvan piirtoaluetta ylöspäin, täyttävät pään alueen karkeasti ja käyttävät img2img-toimintoa epäonnistuneen kuvan täydentämiseen.
Tehokas maskaus, Joka Ymmärtää Asiayhteyden
Maskaus voi olla hirvittävän epäonnistunut Stable Diffusionissa, riippuen haaran tai version mukaan. Usein, kun on mahdollista piirtää yhtenäinen maski, määritetty alue päätyy silti maalattuna sisällöllä, joka ei ota huomioon koko kuvan asiayhteyttä.
Eräänä kertana maskasin sarveiskalvot kasvokuvasta ja annoin ohjauksen ‘siniset silmät’ maskin täyttöönä – mutta lopputulos näytti siltä kuin katsoisin kahden irtileikatun ihmissilmän läpi kaukaista kuvaa aavemaisesta sudesta. Arvaten, olin onnekas, että se ei ollut Frank Sinatra.
Semanttinen editointi on myös mahdollista tunnistamalla kohinan, joka rakensi kuvan alun perin, mikä mahdollistaa käyttäjälle osoittaa tiettyjä rakenteellisia elementtejä renderöinnissä ilman, että se häiritsee kuvan loput:

Muuttaminen yhtä elementtiä kuvassa ilman perinteistä maskausta ja ilman vaikuttamista lähellä olevaan sisältöön, tunnistamalla kohinan, joka loi kuvan alun perin, ja osoittamalla osia, jotka vaikuttivat kohdekenttään. Lähde: https://old.reddit.com/r/StableDiffusion/comments/xboy90/a_better_way_of_doing_img2img_by_finding_the/
Tämä menetelmä perustuu K-Diffusion-näytteistimeen.
Semanttiset Suodattimet Fysiologisille Virheille
Kuten mainitsimme aiemmin, Stable Diffusion voi usein lisätä tai poistaa raajoja, suurelta osin johtuen tietojen ongelmista ja puutteista kuvien annotaatioissa, joilla se on koulutettu.

Kuten se lapsi, joka pisti kieltään ulos kouluryhmäkuvassa, Stable Diffusionin biologiset rikkomukset eivät aina ole heti ilmeisiä, ja sinun saattaa julkaista viimeisin AI -taide -mestaruutesi ennen kuin huomaat ylimääräiset kädet tai sulatut raajat.
On niin vaikea korjata nämä virheitä, että olisi hyödyllistä, jos täysimittainen Stable Diffusion -sovellus sisältäisi jonkinlaisen anatominen tunnistusjärjestelmän, joka käyttää semanttista segmentointia laskeakseen, sisältääkö tuleva kuva vakavia anatominen puutteita (kuten yllä olevassa kuvassa), ja hylkää sen uuden renderöinnin eduksi ennen sen esittämistä käyttäjälle.

Tietysti sinun saattaa haluta renderöidä jumalatar Kali, Tohtori Octopus tai jopa pelastaa virheettömän osan raajan vaivaamaa kuvaa, joten tämä ominaisuus pitäisi olla valinnainen kytkin.
Jos käyttäjät voisivat hyväksyä telemetrian, tällaiset virheet voisi välittää anonyymisti federatiivisen oppimisen kollektiivisessa ponnistelussa, joka voi auttaa tulevia malleja parantamaan ymmärrystään anatomisesta logiikasta.
LAION-Pohjainen Automaattinen Kasvojen Parannus
Kuten mainitsin aiemmassa katsauksessani kolmeen asiaan, joita Stable Diffusion voisi ratkaista tulevaisuudessa, ei pitäisi jättää yksin minkäänlaisen GFPGAN -version tehtäväksi “parantaa” renderöityjä kasvoja ensimmäisessä renderöinnissä.
GFPGANin “parannukset” ovat hirvittävän geneerisiä, usein heikentävät yksilön identiteettiä, jota kuvaillaan, ja toimivat yleensä vain kasvoilla, jotka ovat saaneet yhtä vähän prosessointiaikaa tai huomiota kuin mikä tahansa muu kuva.
Siksi ammattitason ohjelma Stable Diffusionille pitäisi pystyä tunnistamaan kasvoja (yleensä kevyellä kirjastolla, kuten YOLO: lla), soveltamaan saatavilla olevan GPU -voiman täysimääräisesti uudelleen renderöintiin ja joko sekoittaa parannetun kasvon alkuperäiseen täysimittaiseen renderöintiin tai tallentaa sen erikseen manuaalista uudelleenkoostamista varten. Tällä hetkellä tämä vaatii melko paljon käsityötä.
Tapauksissa, joissa Stable Diffusion on koulutettu riittävällä määrällä kuvia julkkiksesta, on mahdollista kohdistaa koko GPU -kapasiteetin myöhemmän renderöinnin aikana ainoastaan renderöidyn kuvan kasvoihin, mikä on yleensä merkittävä parannus – ja toisin kuin GFPGAN, se perustuu LAION -koulutettuihin tietoihin eikä pelkästään renderöidyn kuvan pikseleihin.
Sovelluksen Sisäiset LAION -Haut
Koska käyttäjät alkoivat ymmärtää, että LAION -tietokannan hakeminen käsitteistä, ihmisistä ja teemoista voisi olla apu Stable Diffusionin paremman käytön, on luotu useita verkkopohjaisia LAION -selaimia, mukaan lukien haveibeentrained.com.

Haveibeentrained.com -hakutoiminto sallii käyttäjien tutkia kuvia, jotka voimittavat Stable Diffusionin, ja löytää, onko kohteita, ihmisiä tai ideoita, joita he haluavat kutsua järjestelmästä, todennäköisesti koulutettu siihen. Tällaiset järjestelmät auttavat löytämään myös läheisiä käsitteitä, kuten julkkisten ryhmittymiä tai nykyisestä ideasta seuraavan idean. Lähde: https://haveibeentrained.com/?search_text=bowl%20of%20fruit
Vaikka tällaiset verkkopohjaiset tietokannat usein paljastavat joitain merkintöjä, jotka liittyvät kuvien, yleistymisprosessi, joka tapahtuu mallin koulutuksen aikana, tekee siitä epätodennäköistä, että mikä tahansa kuva voidaan kutsua käyttämällä sen merkintää kehotteena.
Lisäksi sulkusanojen poistaminen ja sanojen vartalointi ja lemmatisointi luonnollisen kielen prosessoinnissa tarkoittaa, että monet lauseet, jotka näkyvät, on jaettu tai poistettu ennen koulutusta Stable Diffusioniin.
Kuitenkin tapa, jolla esteettiset ryhmät sitoutuvat näissä käyttöliittymissä, voi opettaa loppukäyttäjälle paljon Stable Diffusionin logiikasta (tai “persoonallisuudesta”) ja olla apu paremman kuvan tuottamiseen.
Johtopäätös
On paljon muita ominaisuuksia, joita haluaisin nähdä täysimittaisessa paikallisessa Stable Diffusion -toteutuksessa, kuten CLIP-pohjainen kuvan analyysi, joka kääntää standardin Stable Diffusion -prosessin ja sallii käyttäjän kutsua lauseita ja sanoja, joita järjestelmä yhdistäisi luonnollisesti alkuperäiseen kuvaan tai renderöintiin.
Lisäksi todellinen laattapohjainen kuvan suurentaminen olisi tervetullut lisäys, koska ESRGAN on lähes yhtä karkea työkalu kuin GFPGAN. Onneksi suunnitelmat GOBIGin txt2imghd-toteutuksen integroimiseksi ovat nopeasti muuttamassa tätä todelliseksi kaikkien jakelujen osalla, ja se näyttää ilmeiseltä valinnalta pöytäkoneen iteroinnille.
Jotkut muut suositut pyynnöt Discord -yhteisöistä kiinnostavat minua vähemmän, kuten integroidut ohjausmerkki -sanastot ja sovellettavat luettelot taiteilijoista ja tyyleistä, vaikka sovelluksen sisäinen muistikirja tai mukautettava sanasto fraaseja näyttäisi loogiselta lisäykseltä.
Stable Diffusionin nykyiset rajoitukset ihmiskeskeisessä animaatiossa, vaikka CogVideo ja muut projektit ovat käynnistäneet sen, ovat edelleen erittäin alkuvaiheessa ja riippuvat aidon ihmisliikkeen ajallisia ennakkotietoja koskevasta perustutkimuksesta.
Stable Diffusion -video on tällä hetkellä tiukasti psykedeelinen, vaikka se saattaa olla paljon valoisampi lähitulevaisuudessa deepfake -nukkeena EbSynthin ja muiden suhteellisen uusien teksti-videoprojektien kautta (ja on arvollista mainita, että Runwayn viimeisimmässä mainosvideossa ei ole syntetisoituja tai “muunnettuja” ihmisiä).
Toinen arvokas toiminnallisuus olisi saumaton kuvien siirto Photoshopiin ja takaisin, joka on jo vakiintunut Cinema4D: n tekstuuri -editorissa, muissa samankaltaisissa toteutuksissa. Tällä voit helposti siirtää kuvia sovellusten välillä ja käyttää kunkin sovelluksen vahvuuksia.
Lopulta, ja ehkä tärkeimpänä, täysimittainen Stable Diffusion -ohjelma pitäisi pystyä vaihtamaan helposti mallin tarkistuspisteiden välillä (eli järjestelmän taustalla toimivan mallin versioiden välillä) ja päivittämään mukautettuja tekstuaalisia inversioita, jotka toimivat aiemmin virallisten malliversioiden kanssa, mutta jotka saattavat olla rikkoontuneita myöhemmissä malliversioissa (kuten virallisen Discordin kehittäjät ovat maininneet, että se voi olla tapaus).
Ironisesti, organisaatio, joka on parhaiten asemoitunut luomaan tämän voimakkaan ja integroidun työkalujen joukon Stable Diffusionille, Adobe, on sitoutunut Content Authenticity Initiativeen niin voimakkaasti, että se saattaa näyttää taantumukselliselta PR -askarrukselta yritykselle – ellei se halua haitata Stable Diffusionin generatiivisia voimia yhtä perusteellisesti kuin OpenAI on tehnyt DALL-E 2: lle, ja asettaa sen sen sijaan luonnolliseksi kehityksenä sen laajasta kuvapankkiliiketoiminnasta.
Julkaistu ensimmäisen kerran 15. syyskuuta 2022.


