
Haastattelut
Frank Liu, Zillizin operatiivinen johtaja – Haastattelusarja

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
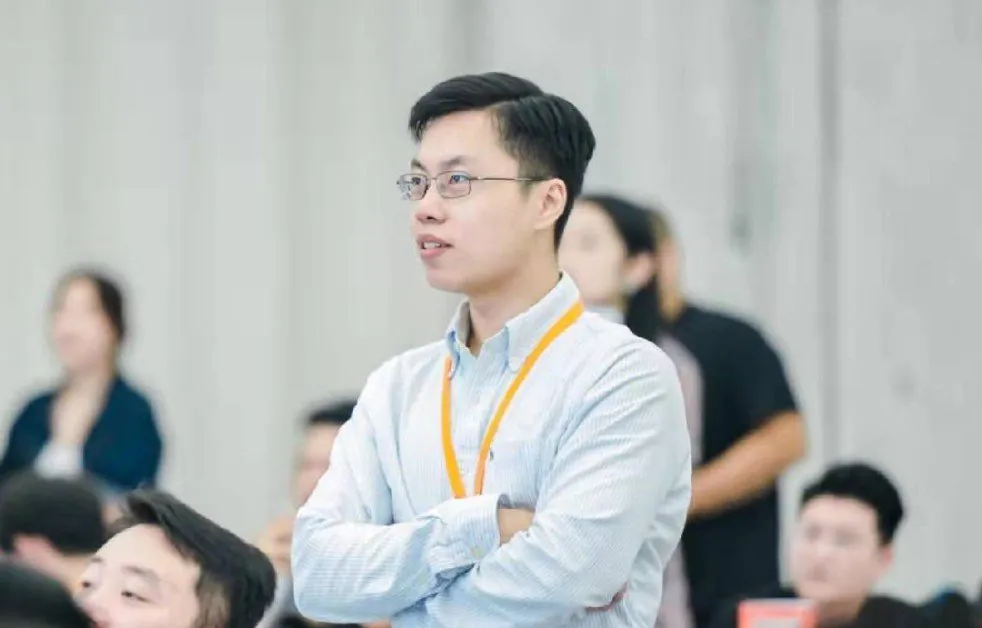
Frank Liu on operatiivinen johtaja Zillizissä, joka on johtava vektoritietokanta- ja tekoälyteknologioiden toimittaja. Sen insinöörit ja tutkijat ovat myös kehittäneet LF AI Milvus® -järjestelmän, maailman suosituimman avoimen lähdekoodin vektoritietokannan.
Mikä alun perin veti sinut koneoppimisen pariin?
Minun ensimmäinen kosketukseni koneoppimisen voimaan oli Stanfordin yliopistossa opiskellessani, vaikka se oli vähän sivussa pääaineestani (sähkötekniikka). Alun perin minua houkutti sähkötekniikka, koska kyky tiivistää monimutkaiset sähköiset ja fysikaaliset järjestelmät matemaattisiksi approksimaatioiksi tuntui minusta voimakkaalta, ja tilastot ja koneoppiminen tuntuivat samalta. Päädyin ottamaan enemmän konenäön ja koneoppimisen kursseja jatko-opintojen aikana, ja kirjoitin maisterintutkielmani koneoppimisen käytöstä kuvien esteettisen kauneuden arviointiin. Kaikki tämä johti ensimmäiseen työhöni Yahoo!:n konenäön ja koneoppimisen tiimissä, jossa olin hybridiroolissa tutkimuksen ja ohjelmistokehityksen parissa. Olimme tuolloin vielä transformereita edeltäneessä AlexNetin ja VGG:n aikakaudessa, ja nähdessäni koko alan ja teollisuuden kehittyvän nopeasti, aina datan valmistelusta massivisesti rinnakkaiseen mallien koulutukseen ja mallin tuotantoon, on ollut upeaa. Monin tavoin tuntuu hieman naurettavalta käyttää sanaa “silloin” kuvaamaan jotain, joka tapahtui vähemmän kuin 10 vuotta sitten, mutta tällainen on edistys, jota on tehty tässä alalla.
Yahoon jälkeen toimin startupin CTO:na, jonka perustin, ja jossa hyödynsimme koneoppimista sisätilojen sijaintitunnistamiseen. Siellä meidän piti optimoida sekvenssimalleja erittäin pienille mikrokontrollerille – erittäin erilainen, mutta kuitenkin liittyvä insinöörintekninen haaste nykyisten massiivisten LLM:ien ja diffuusiomallien kanssa. Rakensimme myös laitteita, visualisointinäkymiä ja yksinkertaisia pilvipohjaisia sovelluksia, mutta tekoäly/koneoppiminen toimi aina keskeisenä osana työtä, jota teimme.
Vaikka olen työskennellyt koneoppimisen parissa tai sen lähialueilla jo suurimman osan viimeisistä 7–8 vuodesta, pidän yhä kovasti piirien ja digitaalisen logiikan suunnittelusta. Sähkötekniikan tausta on monin tavoin erittäin hyödyllinen myös nykyisessä työssäni. Digitaalisen suunnittelun tärkeät käsitteet, kuten virtuaalimuisti, haarautumisen ennakointi ja rinnakkainen suoritus HDL-kielessä, auttavat hahmottamaan monia nykyisiä koneoppimis- ja hajautettuja järjestelmiä koko teknologiakerrosten laajuudelta. Vaikka ymmärrän tietojenkäsittelytieteen vetovoiman, toivon perinteisempien tekniikan alojen, kuten sähkö-, kone- ja kemiantekniikan, suosion elpyvän muutaman seuraavan vuoden aikana.
Mitä tarkoittaa rakenteeton data?
Rakenteeton data viittaa “monimutkaiseen” dataan, joka on perustaltaan dataa, jota ei voida tallentaa ennalta määritettyyn muotoon tai sovittaa olemassa olevaan data-malliin. Vertailun vuoksi, rakenteinen data viittaa mihin tahansa dataan, jolla on ennalta määritetty rakenne – numeerinen data, merkkijonot, taulukot, oliot ja avain/arvo- varastot ovat kaikki esimerkkejä rakenteisesta datasta.
Jotta voimme todella ymmärtää, mitä rakenteeton data on ja miksi se on perinteisesti ollut vaikea prosessoida laskemallisesti, on hyvä vertailla sitä rakenteiseen dataan. Yksinkertaisimmillaan perinteinen rakenteinen data voidaan tallentaa relaatiomallin avulla. Otetaan esimerkiksi relaatiotietokanta, jossa on taulukko kirjojen tallentamiseen: jokainen rivi taulukossa edustaisi tiettyä kirjaa ISBN-numeron mukaan, kun taas sarakkeet merkitsivät vastaavaa tietoluokkaa, kuten otsikko, kirjailija, julkaisupäivämäärä ja niin edelleen. Nykyään on paljon joustavampia data-malleja – leveäsarakkeiset tietovarastot, oliotietokannat, graafitietokannat ja niin edelleen. Mutta yleinen idea on edelleen sama: nämä tietokannat on tarkoitettu tallentamaan dataa, joka sopii tiettyyn data-malliin.
Rakenteeton data voidaan puolestaan ajatella näennäissatunnaisena binääridatamassana. Se voi edustaa mitä tahansa, olla mielivaltaisen suuri tai pieni, ja sitä voidaan muuttaa ja lukea yhdellä monista eri tavoista. Tämä tekee siitä mahdotonta sovittaa mihin tahansa data-malliin, saati sitten taulukkoon relaatiotietokannassa.
Mitä esimerkkejä tämänkaltaisesta datasta on?
Ihmisten tuottama data, kuten kuvat, video, ääni, luonnollinen kieli jne ovat hyviä esimerkkejä rakenteettomasta datasta. Mutta on myös monia vähemmän arkisia esimerkkejä rakenteettomasta datasta. Käyttäjäprofiilit, proteiinirakenteet, genomisekvenssit ja jopa ihmisten luettavissa oleva koodi ovat myös hyviä esimerkkejä rakenteettomasta datasta. Rakenteettoman datan pääasiallinen syy siihen, miksi se on perinteisesti ollut niin vaikea hallita, on se, että rakenteeton data voi olla mitä tahansa ja vaatia erittäin erilaisia suoritusaikoja prosessointiin.
Kuvien avulla voidaan esittää esimerkki. Kaksi kuvaa samasta kohtauksesta voivat olla hyvin erilaisia pikseleiden arvoja, mutta molemmat ovat samanlaista sisällöltään. Luonnollinen kieli on toinen esimerkki rakenteettomasta datasta, josta pidän. Sanonnat “Sähkötekniikka” ja “Tietotekniikka” ovat erittäin läheisiä – niin lähellä, että EE- ja CS-rakennukset Stanfordissa ovat vierekkäin – mutta ilman tapaa koodata semanttinen merkitys näiden kahden sanan taakse, tietokone voi ajatella, että “Tietotekniikka” ja “Sosiaalitieteet” ovat läheisemmin liittyneitä.
Mikä on vektoritietokanta?
Jotta voimme ymmärtää vektoritietokannan, on ensin hyvä ymmärtää, mitä upotus on. Selitän sen pian, mutta lyhykäisyyden vuoksi upotus on korkean dimensionaalisuuden vektori, joka voi edustaa rakenteettoman datan semantiikkaa. Yleensä ottaen kaksi upotusta, jotka ovat lähellä toisiaan etäisyyden suhteen, ovat todennäköisesti semanttisesti samanlaisia syötedataa. Nykyään meillä on modernin koneoppimisen avulla mahdollisuus koodata ja muuttaa monenlaisia eri tyypin rakenteettomia dataa – kuvia ja tekstiä esimerkiksi – semanttisesti voimakkaiksi upotusvektoreiksi.
Järjestön näkökulmasta rakenteeton data muuttuu erittäin vaikeaksi hallita, kun määrä ylittää tietyn rajan. Tässä tulee vektoritietokanta, kuten Zilliz Cloud, kuvaan. Vektorigraafitietokanta on suunniteltu tallentamaan, indeksoida ja etsimään suuria määriä rakenteettomia dataa hyödyntämällä upotuksia perustavana edustamisena. Hakeminen vektorigraafitietokannassa tehdään yleensä kyselyvektoreilla, ja hakutuloksena on N parhaimmat vastaavat tulokset etäisyyden perusteella.
Parhaimmat vektorigraafitietokannat sisältävät monia perinteisten relaatiotietokantojen käytettävyyden piirteitä: vaakasuuntaisen skaalautuvuuden, välimuistin, replikoinnin, vikatilanteen automaattisen varajärjestelmään siirtymisen ja kyselyn suorittamisen, jotka ovat vain joitain monista ominaisuuksista, joita oikea vektoritietokanta tulisi toteuttaa. Kategorian määrittelijänä olemme olleet aktiivisia akateemisissa piireissä ja julkaissut paperit SIGMOD 2021 ja VLDB 2022 -tietokantakonferensseissa, jotka ovat nykyisin alan kaksi tärkeintä konferenssia.
Voitko keskustella upotuksesta?
Yleensä ottaen upotus on korkean dimensionaalisuuden vektori, joka tulee monikerroksisen neuroverkon välikerrosten aktivaatiosta. Monet neuroverkot on koulutettu tuottamaan itse upotuksia, ja jotkut sovellukset käyttävät useiden välikerrosten yhdistettyjä vektoreita upotukseksi, mutta en mene niihin tässä liian syvälle. Toinen vähemmän yleinen, mutta yhtä tärkeä tapa generoida upotuksia on käsintehtyjen ominaisuuksien kautta. Sen sijaan, että koneoppimismalli oppii automaattisesti oikeat edustukset syötedatasta, hyvä vanha piirteiden käsin suunnittelu voi toimia monissa sovelluksissa. Riippumatta perustavanlaatuisesta menetelmästä, upotuksia semanttisesti samanlaisille objekteille on lähellä toisiaan etäisyyden suhteen, ja tämä ominaisuus mahdollistaa vektoritietokannan.
Mitä ovat joitain suosittuja käyttötarkoituksia tämän teknologian kanssa?
Vektorigraafitietokannat ovat erittäin hyviä sovelluksissa, jotka vaativat jonkinlaista semanttista hakua – tuotteen suositusta, videon analyysiä, asiakirjan hakua, uhkien ja petosten tunnistamista ja tekoälypohjaisia chatboteja ovat joitain suosittuja vektorigraafitietokantojen käyttötarkoituksia tänään. Esimerkiksi Milvus, avoimen lähdekoodin vektoritietokanta, jonka Zilliz loi ja joka on Zilliz Cloudin ydin, on ollut yli tuhannen yritysasiakkaan käytössä monissa eri käyttötarkoituksissa.
Pidän aina keskustelemisesta näistä sovelluksista ja auttamisesta ihmisten ymmärtämisessä, miten ne toimivat, mutta pidän myös erittäin paljon keskustelemisesta vähemmän tunnetuista vektorigraafitietokantojen käyttötarkoituksista. Uusien lääkkeiden kehittäminen on yksi suosikeistani “niche” vektorigraafitietokantojen käyttötarkoituksista. Haaste tähän sovellukseen on etsiä potentiaalisia ehdokaslääkkeitä tietyn sairauden tai oireen hoitoon 800 miljoonan yhdisteen tietokannasta. Farmaseuttinen yhtiö, jonka kanssa kommunikoimme, pystyi parantamaan merkittävästi lääkekehitysprosessia ja leikkaamaan laitteiston resursseja yhdistämällä Milvusin kemoinformatiikan kirjaston RDKitin kanssa.
Clevelandin taidemuseon (CMA) AI ArtLens on toinen esimerkki, josta pidän. AI ArtLens on interaktiivinen työkalu, joka ottaa kyselykuvan syötteenä ja hakee visuaalisesti samanlaisia kuvia museon tietokannasta. Tämä on yleensä kutsuttu käänteiseksi kuvahakuna ja on melko yleinen vektorigraafitietokantojen käyttötarkoitus, mutta Milvus tarjosi CMA:lle ainutlaatuisen arvon, jonka avulla sovellus pystyttiin saamaan käyttöön viikossa hyvin pienen tiimin kanssa.
Voitko keskustella avoimen lähdekoodin alustasta Towhee?
Kun kommunikoimme Milvus-yhteisön kanssa, huomasimme, että moni heistä halusi yhdenmukaisen tavan generoida upotuksia Milvusille. Tämä oli totta melkein kaikissa eri organisaatioissa, joita puhuimme, mutta erityisesti niissä yrityksissä, joilla ei ollut paljon koneoppimisen insinöörejä. Towheen avulla pyrimme ratkaisemaan tämän aukon “vektoridatan ETL”:n kautta. Perinteiset ETL-pipelineissa keskitytään yhdistämään ja muuttamaan rakenteista dataa useista lähteistä käyttökelpoiseen muotoon, kun taas Towhee on tarkoitettu toimimaan rakenteettoman datan kanssa ja sisältää nimenomaisesti koneoppimisen tulokseksi saadun ETL-pipelineen. Towhee saavuttaa tämän tarjoamalla satoja malleja, algoritmeja ja muunnoksia, joita voidaan käyttää rakennuspalikkoina vektoridatan ETL-käsittelyketjuun. Towhee tarjoaa myös helppokäyttöisen Python-rajapinnan, joka mahdollistaa kehittäjille vektoridatan ETL-käsittelyketjuun rakentamisen ja testaamisen yhdellä koodirivillä.
Vaikka Towhee on itsenäinen projekti, se on myös osa laajempaa vektoritietokanta-ekosysteemiä, jonka keskipisteenä on Milvus ja jonka Zilliz luo. Näemme Milvusin ja Towheen kahden erittäin täydentävän projektin, jotka voidaan käyttää yhdessä todella demokratisoimaan rakenteettoman datan käsittelyä.
Zilliz keräsi äskettäin 60 miljoonan dollarin B-sarjan rahoituksen. Miten tämä kiihdyttää Zillizin tehtävää?
Haluan ensin kiittää Prosperity7 Venturesia, Pavilion Capitalia, Hillhouse Capitalia, 5Y Capitalia, Yunqi Capitalia ja muita siitä, että uskovat Zillizin tehtävään ja tukivat meitä tämän B-sarjan laajennuksella. Olemme nyt keränneet yhteensä 113 miljoonaa dollaria, ja tämä viimeisin rahoituskierros tukee pyrkimyksiämme laajentaa tuotekehitys- ja markkinoillevientitiimejämme. Erityisesti parannamme hallinnoitua pilvipalveluamme, joka on tällä hetkellä varhaisessa pääsyssä, mutta avataan kaikille loppuvuonna. Jatkamme myös panostamista tietokantojen ja tekoälyn huippututkimukseen, kuten olemme tehneet viimeiset 4 vuotta.
Onko mitään muuta, mitä haluaisit jakaa Zillizistä?
Yhtiönä kasvamme nopeasti, mutta se, mikä erottaa meidän nykyisen tiimimme muista tietokanta- ja tekoälyalan yrityksistä, on intohimomme siihen, mitä rakennamme. Olemme tehtävänä demokratisoida rakenteettoman datan käsittely, ja on upeaa nähdä niin monia lahjakkaita ihmisiä Zillizissä työskentelemässä yhtenäisen tavoitteen saavuttamiseksi. Jos mikään siitä, mitä teemme, kiinnostaa sinua, ole hyvä ja ota meihin yhteyttä. Olisimme iloisia, jos sinä liittyisit joukkoomme.
Jos haluat tietää enemmän, olen myös henkilökohtaisesti avoin keskusteluun Zillizistä, vektoritietokannoista tai upotusaiheisiin edistysaskeliin tekoälyssä ja koneoppimisessa. Ovi on aina avoin, joten tule rohkeasti yhteyteen minuun suoraan Twitterissä/LinkedInissä.
Viimeiseksi kiitos lukemisesta!
Kiitos hienosta haastattelusta, lukijoille, jotka haluavat oppia enemmän, suosittelemme vierailemaan Zillizissä.



