
AI-mallit ja alustat
Täydellinen opas Gemma 2:sta: Google’n uusi avoimen lähdekoodin suuri kielen malli

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Gemma 2 perustuu edeltäjäänsä, tarjoten parannettua suorituskykyä ja tehokkuutta, sekä joukon innovatiivisia ominaisuuksia, jotka tekevät siitä erityisen houkuttelevan sekä tutkimuksen että käytännön sovellusten kannalta. Gemma 2:n erottaa muista sen kyky toimia suurempien omistajanmallien vertaisesti, mutta paketissa, joka on suunniteltu laajemmalle saatavuudelle ja käytölle vaatimattomammilla laitteistoilla.
Kun tutustin Gemma 2:n teknisiä ominaisuuksia ja arkkitehtuuria, olin yhä enemmän vaikuttunut sen suunnittelun älykkyydestä. Malli sisältää useita edistyneitä tekniikoita, mukaan lukien uudet huomioon otto-mekanismit ja innovatiiviset lähestymistavat koulutusvakauteen, jotka vaikuttavat sen merkittäviin kykyihin.

Google [securities_stock_price_tag symbol="GOOGL" exchange="NASDAQ"] Open Source LLM Gemma
Tässä kattavassa oppaassa tutustumme Gemma 2:een syvällisemmin, tarkastelemalla sen arkkitehtuuria, avainominaisuuksia ja käytännön sovelluksia. Riippumatta siitä, oletko kokenut AI-asiantuntija tai innostunut aloittelija, tämä artikkeli pyrkii tarjoamaan arvokkaita näkemyksiä siitä, miten Gemma 2 toimii ja miten voit hyödyntää sen voimaa omassa projektissasi.
Mikä on Gemma 2?
Gemma 2 on Google’n uusin avoimen lähdekoodin suuri kielen malli, joka on suunniteltu kevyeksi mutta tehokkaaksi. Se perustuu samaan tutkimukseen ja teknologiaan, jota käytettiin Google’n Gemini-mallien luomiseen, tarjoten huipputason suorituskyvyn saatavammassa paketissa. Gemma 2 on saatavilla kahdessa koossa:
Gemma 2 9B: 9 miljardin parametrin malli
Gemma 2 27B: Suurempi 27 miljardin parametrin malli
Kummassakin koossa on saatavilla kaksi varianttia:
Perusmallit: Esikoulutettu laajalle tekstidatasiin
Ohjeistuneet (IT) mallit: Hienosäädettyjä paremman suorituskyvyn saavuttamiseksi tietyissä tehtävissä
Mallien käyttäminen Google AI Studion kautta: Google AI Studio – Gemma 2
Lue raportti täältä: Gemma 2 Tekninen raportti
Avainominaisuudet ja parannukset
Gemma 2 esittelee useita merkittäviä edistysaskeleita edeltäjäänsä verrattuna:
1. Lisää koulutusdataa
Mallit on koulutettu merkittävästi enemmän dataa:
Gemma 2 27B: Koulutettu 13 biljoonalla tokenilla
Gemma 2 9B: Koulutettu 8 biljoonalla tokenilla
Tämä laajennettu tietojoukko, joka koostuu pääasiassa verkkodataa (pääasiassa englanniksi), koodia ja matematiikkaa, vaikuttaa mallien parantuneeseen suorituskykyyn ja monipuolisuuteen.
2. Liukuvan ikkunan huomio
Gemma 2 toteuttaa uuden lähestymistavan huomioon ottamiselle:
Jokainen toinen kerros käyttää liukuvaa ikkunahuomioita 4096 tokenin paikallisella kontekstilla
Vaihtuvat kerrokset käyttävät täysiä kvadranttisia globaaleja huomioita koko 8192 tokenin kontekstissa
Tämä hybridi lähestymistapa pyrkii tasapainottamaan tehokkuuden kyvyn kanssa havainnoida pitkän aikavälin riippuvuudet syötteenä.
3. Pehmeä katto
Parantamaan koulutusvakauteen ja suorituskykyä, Gemma 2 esittelee pehmeän katon mekanismin:
<p>def soft_cap(x, cap):
return cap * torch.tanh(x / cap)</p>

<p># Sovellus huomioon logiikkaan
huomio_logiikka = soft_cap(huomio_logiikka, cap=50.0)</p>

# Sovellus lopulliseen kerrokseen

<p>loppu_logiikka = soft_cap(loppu_logiikka, cap=30.0)
Tämä tekniikka estää logiikkaa kasvamasta liian suureksi ilman kovan katkaisun, säilyttäen enemmän tietoa ja stabiloimalla koulutusprosessin.
- Gemma 2 9B: 9 miljardin parametrin malli
- Gemma 2 27B: Suurempi 27 miljardin parametrin malli
Kummassakin koossa on saatavilla kaksi varianttia:
- Perusmallit: Esikoulutettu laajalle tekstidatasiin
- Ohjeistuneet (IT) mallit: Hienosäädettyjä paremman suorituskyvyn saavuttamiseksi tietyissä tehtävissä
4. Tietäminen tiivistäminen
9B-mallille Gemma 2 käyttää tietäminen tiivistämistekniikoita:
- Esikoulutus: 9B-malli oppii suuremmalta opettajamallilta alkuvaiheen koulutuksessa
- Jälkikoulutus: Sekä 9B että 27B-mallit käyttävät politiikkatiivistämistä suorituskyvyn hienosäätämiseen
Tämä prosessi auttaa pienempää mallia omaksumaan suurempien mallien kyvyt tehokkaammin.
5. Mallien yhdistäminen
Gemma 2 käyttää uudenlaista mallien yhdistämistekniikkaa nimeltä Warp, joka yhdistää useita malleja kolmessa vaiheessa:
- Eksponentiaalinen liukuva keskiarvo (EMA) vahvistusoppimisen hienosäätössä
- Sfäärinen lineaarinen interpolointi (SLERP) useiden politiikkojen jälkeen
- Lineaarinen interpolointi alkuvaiheen kautta (LITI) lopullisena vaiheena
Tämä lähestymistapa pyrkii luomaan robustimman ja kykympään lopullisen mallin.
Suorituskykyvertailut
Gemma 2 osoittaa vaikuttavaa suorituskykyä eri vertailuissa:
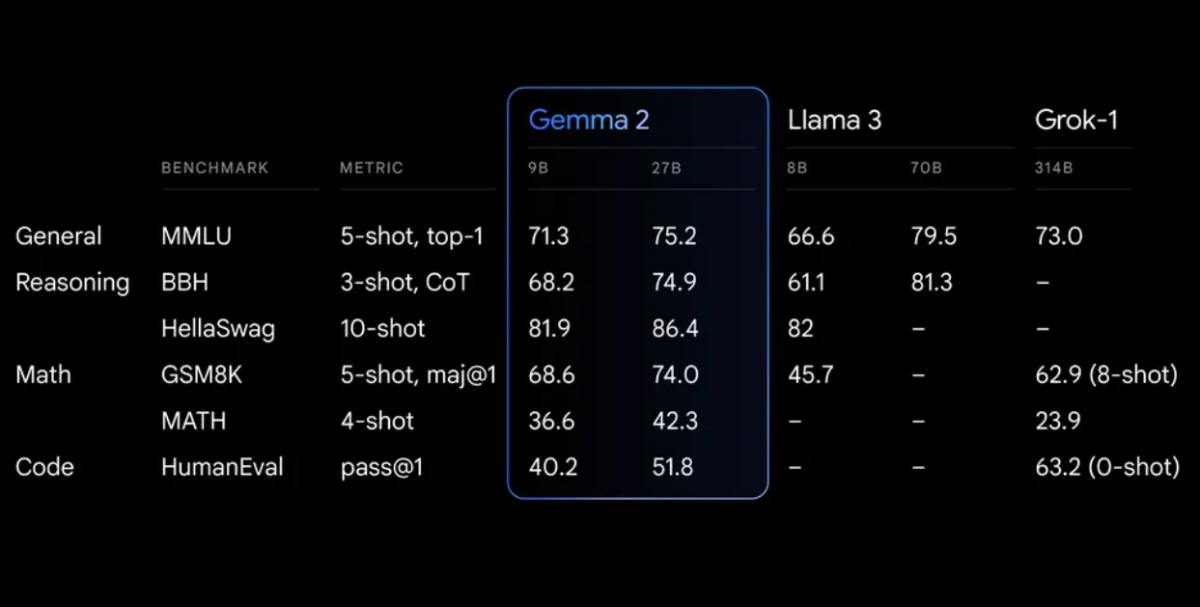
Gemma 2 on uudelleen suunnitellussa arkkitehtuurissa, joka on suunniteltu sekä poikkeuksellisen suorituskyvyn että inference-tehokkuuden saavuttamiseksi
Gemma 2:n käyttäminen
Käyttääksesi Gemma 2:ta projekteissasi, sinulla on useita vaihtoehtoja:
1. Google AI Studio
Nopeaan kokeiluun ilman laitteistovaatimuksia voit käyttää Gemma 2:ta Google AI Studio kautta.
2. Hugging Transformers
Gemma 2 on integroitu suosittuun Hugging Face Transformers-kirjastoon. Tässä on kuinka voit käyttää sitä:
<div class="relative flex flex-col rounded-lg">
<div class="text-text-300 absolute pl-3 pt-2.5 text-xs">

<p>from transformers import AutoTokenizer, AutoModelForCausalLM</p>

<p># Lataa malli ja tokenisaattori
mallin_nimi = "google/gemma-2-27b-it" # tai "google/gemma-2-9b-it" pienemmälle versiolle
tokenisaattori = AutoTokenizer.from_pretrained(mallin_nimi)
malli = AutoModelForCausalLM.from_pretrained(mallin_nimi)</p>

<p># Valmistele syöte
syöte = "Selitä kvantti-sidonnaisuuden käsite yksinkertaisin sanoin."
syöte_tiedot = tokenisaattori(syöte, return_tensors="pt")</p>

<p># Generoi teksti
tulokset = malli.generate(**syöte_tiedot, max_length=200)
vastaus = tokenisaattori.decode(tulokset[0], skip_special_tokens=True)</p>

print(vastaus)
3. TensorFlow/Keras
TensorFlow-käyttäjille Gemma 2 on saatavilla Kerasin kautta:
<p>import tensorflow as tf
from keras_nlp.models import GemmaCausalLM</p>

<p># Lataa malli
malli = GemmaCausalLM.from_preset("gemma_2b_en")</p>

<p># Generoi teksti
syöte = "Selitä kvantti-sidonnaisuuden käsite yksinkertaisin sanoin."
tulokset = malli.generate(syöte, max_length=200)</p>

print(tulokset)
Edistynyt käyttö: Paikallisen RAG-järjestelmän rakentaminen Gemma 2:n avulla
Yksi Gemma 2:n voimakas sovellus on RAG-järjestelmän (Retrieval Augmented Generation) rakentaminen. Luomme yksinkertaisen, täysin paikallisen RAG-järjestelmän Gemma 2:n ja Nomic- upottamisten avulla.
Ask. 1: Ympäristön asettaminen
Ensinnäkin, varmista, että sinulla on tarvittavat kirjastot asennettuna:
<p>pip install langchain ollama nomic chromadb</p>
Ask. 2: Asiakirjojen indeksointi
Luo indeksoija asiakirjojen prosessointiin:
<p>import os
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.document_loaders import DirectoryLoader
from langchain.vectorstores import Chroma
from langchain.embeddings import HuggingFaceEmbeddings</p>

<p>class Indeksoija:
def __init__(self, hakemistopolku):
self.hakemistopolku = hakemistopolku
self.text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
self.embeddings = HuggingFaceEmbeddings(model_name="nomic-ai/nomic-embed-text-v1")</p>

<p>def lataa_ja_jaa_asiasiakirjoja(self):
lataaja = DirectoryLoader(self.hakemistopolku, glob="**/*.txt")
asiakirjat = lataaja.load()
return self.text_splitter.split_documents(asiakirjat)</p>

<p>def luo_vektori_säilö(self, asiakirjat):
return Chroma.from_documents(asiakirjat, self.embeddings, persist_directory="./chroma_db")</p>

<p>def indeksoi(self):
asiakirjat = self.lataa_ja_jaa_asiasiakirjoja()
vektori_säilö = self.luo_vektori_säilö(asiakirjat)
vektori_säilö.persist()
return vektori_säilö</p>

<p># Käyttö
indeksoija = Indeksoija("polku/asiakirjoihin")
vektori_säilö = indeksoija.indeksoi()</p>
Ask. 3: RAG-järjestelmän asettaminen
Nyt, luomme RAG-järjestelmän Gemma 2:n avulla:
<p>from langchain.llms import Ollama
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate</p>

<p>class RAGJärjestelmä:
def __init__(self, vektori_säilö):
self.vektori_säilö = vektori_säilö
self.llm = Ollama(model="gemma2:9b")
self.hakija = self.vektori_säilö.as_retriever(search_kwargs={"k": 3})</p>

<p>self.malli = """"Käytä seuraavia kontekstipalasia vastataksesi lopussa olevaan kysymykseen.
Jos et tiedä vastausta, sanokaa vain, ette tiedä, älkää yritkö keksisi vastausta.</p>

{konteksti}

<p>Kysymys: {kysymys}
Vastaus: """"</p>

<p>self.kysymys_malli = PromptTemplate(
malli=self.malli, input_variables=["konteksti", "kysymys"]
)</p>

<p>self.kysymys_ketju = RetrievalQA.from_chain_type(
llm=self.llm,
chain_type="stuff",
hakija=self.hakija,
return_source_documents=True,
chain_type_kwargs={"prompt": self.kysymys_malli}
)</p>

<p>def kysy(self, kysymys):
return self.kysymys_ketju({"kysymys": kysymys})</p>

<p># Käyttö
rag_järjestelmä = RAGJärjestelmä(vektori_säilö)
vastaus = rag_järjestelmä.kysy("Mikä on Ranskan pääkaupunki?")
print(vastaus["result"])</p>
Tämä RAG-järjestelmä käyttää Gemma 2:ta Ollaman kautta kielen mallina ja Nomic- upottamisia asiakirjojen hakemiseen. Se mahdollistaa kysymyksiä asiakirjojen perusteella, tarjoten vastauksia asiakirjojen kontekstista.
Gemma 2:n hienosäätö
Tietyissä tehtävissä tai aihealueilla voit haluta hienosäätää Gemma 2:ta. Tässä on perustava esimerkki Hugging Face Transformers -kirjaston avulla:
from transformers import AutoTokenizer, AutoModelForCausalLM, TrainingArguments, Trainer
from datasets import load_dataset

<p># Lataa malli ja tokenisaattori
mallin_nimi = "google/gemma-2-9b-it"
tokenisaattori = AutoTokenizer.from_pretrained(mallin_nimi)
malli = AutoModelForCausalLM.from_pretrained(mallin_nimi)</p>

<p># Valmistele tietojoukko
tietojoukko = load_dataset("omatiyetojoukkosi")</p>

<p>def tokenisoi_funktio(esimerkit):
return tokenisaattori(esimerkit["teksti"], padding="max_length", truncation=True)</p>

<p>tokenisoidut_tietojoukot = tietojoukko.map(tokenisoi_funktio, batched=True)</p>

<p># Aseta koulutusargumentit
koulutus_argumentit = TrainingArguments(
output_dir="./tulokset",
num_train_epochs=3,
per_device_train_batch_size=4,
per_device_eval_batch_size=4,
warmup_steps=500,
weight_decay=0.01,
logging_dir="./lokit",
)</p>

<p># Alusta kouluttaja
kouluttaja = Trainer(
malli=malli,
args=koulutus_argumentit,
train_dataset=tokenisoidut_tietojoukot["koulutus"],
eval_dataset=tokenisoidut_tietojoukot["testi"],
)</p>

# Aloita hienosäätö
kouluttaja.train()

<p># Tallenna hienosäädetty malli
malli.save_pretrained("./hienosaadetty_gemma2")
tokenisaattori.save_pretrained("./hienosaadetty_gemma2")</p>
Muista sovittaa koulutusparametrit omiin tarpeisiisi ja laskenta-resursseihin.
Etiset huomioonotot ja rajoitukset
Vaikka Gemma 2 tarjoaa vaikuttavia kykyjä, on tärkeää olla tietoinen sen rajoituksista ja etisistä huomioonotoista:
- Harhat: Kuten kaikki kielen mallit, Gemma 2 voi heijastaa harhauksia, jotka ovat sen koulutusdatassa. Arvioi aina kriittisesti sen tulokset.
- Todennäköisyys: Vaikka Gemma 2 on erittäin kykyinen, se voi joskus generoida virheellistä tai epäjohdonmukaista tietoa. Varmista tärkeät faktat luotettavista lähteistä.
- Kontekstin pituus: Gemma 2:ssa on kontekstin pituus 8192 tokenia. Pitkemmille asiakirjoille tai keskusteluille saatat tarvita strategioita kontekstin hallitsemiseen.
- Laskenta-resurssit: Erityisesti 27B-mallille voi vaatia merkittäviä laskenta-resursseja tehokkaan inference- ja hienosäätöön.
- Vastuullinen käyttö: Noudatta Google’n vastuullisia AI-käytäntöjä ja varmista, että Gemma 2:n käyttö on linjassa etisistä AI-periaatteista.
Johtopäätös
Gemma 2:n edistyneet ominaisuudet, kuten liukuvan ikkunan huomio, pehmeä katto ja uudet mallien yhdistämistekniikat, tekevät siitä voimakkaan työkalun laajalle valikoimalle luonnollisen kielen prosessointitehtäville.
Käyttämällä Gemma 2:ta projekteissasi, olipa kyseessä yksinkertainen inference, monimutkainen RAG-järjestelmä tai hienosäädetty malli tietyn aihealueen tarpeisiin, voit hyödyntää huipputason AI-voimaa säilyttäen samalla hallinnan datasi ja prosessien yli.


