
Andersonin kulma
Visuaalisten analogioiden tuominen tekoälyyn

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
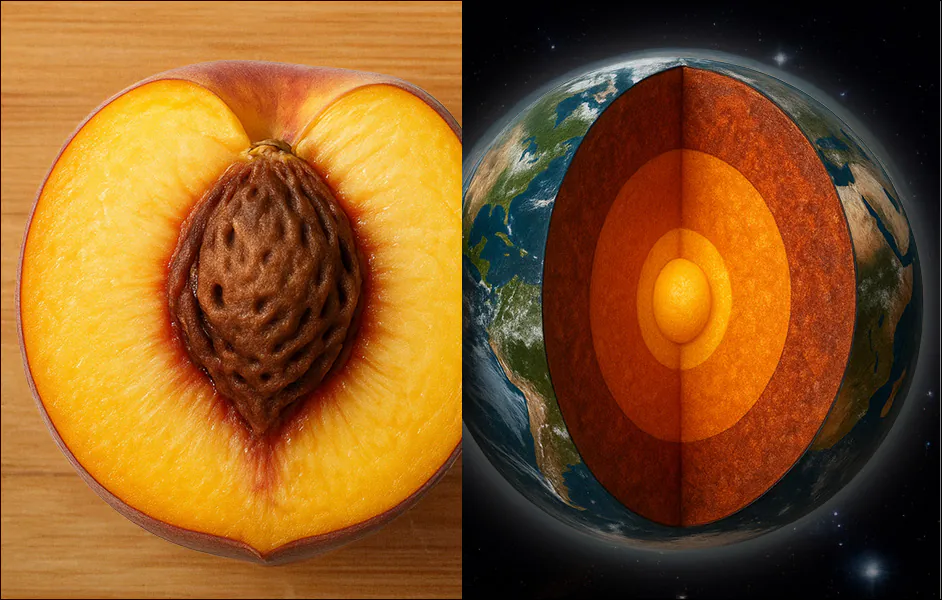
Nykyiset tekoälymallit eivät pysty tunnistamaan “relaatiivisia” kuvien yhtäläisyyksiä, kuten sitä, miten maapallon kerrokset ovat samanlaiset kuin persikka, ja ne puuttuvat avainaspektista, jolla ihmiset havaitsevat kuvia.
Vaikka on olemassa monia tietokoneen näkömalli, jotka pystyvät vertailemaan kuvia ja löytämään niiden välisiä yhtäläisyyksiä, nykyisen vertailujärjestelmien uusi sukupolvi ei ole juuri lainkaan mielikuvituksellista kapasiteettia. Tarkastellaan joitakin klassisen 1960-luvun laulun, Windmills of Your Mind, sanoja:
Kuten karuselli, joka pyörii, juoksemassa ympyrää kuun ympärillä
Kuten kello, jonka kädet liikkuvat minuuttien yli sen kasvojen
Ja maailma on kuin omena, joka pyörii hiljaa avaruudessa
Tällaiset vertailut edustavat runollista viittauksen aluetta, joka on merkittävää ihmisille tavalla, joka on paljon taiteellisen ilmaisun tuolla puolen; se on sidottu siihen, miten kehittämme havaintojärjestelmiämme; kun luomme “objektin” alueen, kehittämme visuaalisen yhtäläisyyden kapasiteetin, joten esimerkiksi persikka- ja maapallon poikkileikkauskuvat tai fraktaalisten toistojen kuten kahvin kierteiden ja galaksien haarojen kaltaiset, rekisteröityvät meillä analogisina.
Tällä tavalla voimme johtaa yhteyksiä näennäisesti yhdistämättömiin objekteihin ja objektityyppiin, ja johtaa järjestelmiä (kuten gravitaatio, liike ja pinnan koheesio), jotka voivat soveltaa useisiin alueisiin eri skaaloissa.
Näkeminen
Jopa uusimman sukupolven kuvien vertailujärjestelmistä, kuten LPIPS ja DINO, jotka perustuvat ihmisen palautteeseen, suorittavat vain kirjaimellisen pinnan vertailuja.
Niiden kyky löytää kasvoja, joita ei ole olemassa – ts. pareidolia – ei edusta visuaalisen yhtäläisyyden mekanismeja, joita ihmiset kehittävät, vaan se johtuu siitä, että kasvoja etsivät algoritmit käyttävät matalan tason kasvojen rakenteen ominaisuuksia, jotka joskus sopivat sattumalta muihin objekteihin:

Esimerkkejä vääristä positiivisista tuloksista kasvojen tunnistamisessa ‘Faces with Things’ -aineistossa. Lähde
Määrittääkseen, voivatko koneet todella kehittää meidän mielikuvituksellisen kapasiteettimme tunnistaa visuaalinen yhtäläisyys eri alueilla, tutkijat Yhdysvalloissa ovat suorittaneet tutkimuksen Relaatiivisen visuaalisen yhtäläisyyden ympärillä, ja kuratoivat ja kouluttivat uuden aineiston, joka on suunniteltu pakottamaan abstraktit suhteet muodostumaan eri objektiiden välille, jotka ovat kuitenkin sidottuja abstraktiin suhteeseen:

Useimmat tekoälymallit tunnistavat yhtäläisyyden vain, kun kuvat jakavat pinnan piirteitä, kuten muotoa tai väriä, joten ne linkittävät vain ryhmä B (yllä) viiteen. Ihmiset sen sijaan näkevät myös ryhmä A samanlaisena – ei siksi, että kuvat näyttävät samanlaisilta, vaan siksi, että ne seuraavat samaa perustavaa logiikkaa, kuten esimerkiksi muutosta ajan myötä. Uusi työ pyrkii jäljittelemään tällaista rakenteellista tai relaatiivista yhtäläisyyttä, pyrkien lähentämään koneen havaintoa ihmisen päättelyyn. Lähde: https://arxiv.org/pdf/2512.07833
Kuvien kuvailujärjestelmä, joka on kehitetty aineistoa varten, mahdollistaa epätavallisen abstraktit kuvailut, jotka on suunniteltu pakottamaan tekoälyjärjestelmiä keskittymään perusominaisuuksiin eikä paikallisiin yksityiskohtiin:

Ennustetut ‘anonyymit’ kuvailut, jotka osallistuvat kirjoittajien ‘relsim’ -mittariin.
Kuratoitu kokoelma ja sen epätavallinen kuvailutyyli ruokkivat kirjoittajien uuden ehdotetun mittarin relsim, jonka kirjoittajat ovat hienosäädetty näkemys-kieli-malliin (VLM).

Vertailu tyypillisten aineistojen kuvailutyylistä, joka keskittyy attribuuttiyhtäläisyyteen, kun taas relsim -lähestymistapa (alareuna) korostaa relaatiivista yhtäläisyyttä.
Uusi lähestymistapa perustuu kognitiivisen tieteen metodologioihin, erityisesti Dedre Gentnerin Rakenteen karttaminen -teoriaan (analogian tutkimus) ja Amos Tverskyn määritelmään relaatiivisesta yhtäläisyydestä ja attribuuttiyhtäläisyydestä.

Liittymän verkkosivuilta, esimerkki relaatiivisesta yhtäläisyydestä. Lähde
Kirjoittajat toteavat:
‘[Ihmiset] prosessoi attribuuttiyhtäläisyyttä havainnoivasti, mutta relaatiivinen yhtäläisyys vaatii konseptuaalista abstraktiota, usein tuettuna kielellä tai aiemmin saadulla tiedolla. Tämä osoittaa, että relaatiivisen yhtäläisyyden tunnistaminen edellyttää ensin kuvan ymmärtämistä, tiedon käyttämistä ja sen perustavanlaatuisten rakenteiden abstrahointia.’
Uusi artikkeli on nimeltään Relaatiivinen visuaalinen yhtäläisyys, ja siihen liittyy projektisivusto (ks. video tämän artikkelin lopussa).
Menetelmä
Tutkijat käyttivät yhtä tunnetuimmista hyperskaaladataseteista oman kokoelmansa lähtökohtana – LAION-2B:

LAION-2B -kokoelman yksittäisen merkinnän metadata. Lähde
114 000 kuvaa, joissa on todennäköisesti joustavia relaatiivisia rakenteita, on poimittu LAION-2B:stä, mukaan lukien monien matalan laatuisen kuvien suodatus, jotka ovat läsnä vähäisesti kuratoidussa aineistossa.
Luoakseen putken tätä valintaprosessia varten, kirjoittajat käyttivät Qwen2.5-VL-7B:tä, hyödyntäen 1 300 positiivista ja 11 000 negatiivista ihmisten tekemää merkintää:

RelSim-järjestelmä on koulutettu kolmessa vaiheessa: kuvien suodatus LAION-2B:stä relaatiivista sisältöä varten; kunkin ryhmän jaettu anonyymi kuvailu, joka sieppaa niiden perustavanlaatuisen logiikan; ja oppiminen kuvien liittämisestä näihin kuvailuihin kontrastiivisen menetelmän avulla.
Artikkelissa todetaan:
‘Merkinnänantajat ohjeistettiin: “Voitko nähdä relaatiivista mallia, logiikkaa tai rakennetta tässä kuvassa, joka voisi olla hyödyllistä luodaksesi tai linkittääksesi toiseen kuvaan?” Koulutettu malli saavuttaa 93 prosentin sopimuksen ihmisten arvioissa, ja kun se sovelletaan LAION-2B:hen, se tuottaa N = 114k kuvia, joita pidetään relaatiivisesti kiinnostavina.’
Relaatiivisten etikettien generointiin tutkijat pyysivät Qwen-mallia kuvaamaan jaettua logiikkaa kuvaryhmien takana ilman nimeämistä tiettyjä objekteja. Tämä abstrahointi oli vaikeaa, kun malli näki vain yhden kuvan, mutta se tuli toimivaksi, kun useat esimerkit osoittivat perustavanlaatuisen mallin.
Tuloksena olevat ryhmätason kuvailut korvasivat tiettyjä termejä paikkaajilla, kuten ‘{Aihe}’ tai ‘{Liikkeen tyyppi}’, mikä teki niistä laajasti sovellettavissa.
Ihmisten vahvistettuaan kunkin kuvailun, se parittiin kaikkien kuvien kanssa ryhmässä. Yli 500 tällaista ryhmää käytettiin mallin kouluttamiseen, jota sovellettiin sitten 114 000 suodatettuun kuvaan, jotta saataisiin aikaan suuri joukko abstrakteja, relaatiivisesti annotoituja näytteitä.
Data ja testit
Relaatiivisten piirteiden extraktio Qwen2.5-VL-7B:llä, malli koulutettiin aineistoa käyttäen LoRA:a, 15 000 askelella, kahdeksan A100 GPU:n kautta*. Tekstipuolelle relaatiiviset kuvailut upotettiin käyttäen all-MiniLM-L6-v2:ta Sentence-Transformers -kirjastosta.
114 000 kuvan aineisto jaettiin 100 000:een koulutukseen ja 14 000:een arviointiin. Järjestelmän testaamiseksi käytettiin hakujärjestelmää: annettuaan kyselykuvan, mallin piti löytää toinen kuva 28 000:sta kohteesta, joka ilmaisi saman relaatiivisen idean. Hakupooli sisälsi 14 000 arviointikuva ja 14 000 lisää LAION-2B:stä, ja 1 000 kyselyä valittiin satunnaisesti arviointijoukosta benchmarkkaamiseksi.
Arvioidakseen hakutuloksen laatua, GPT-4o käytettiin arvioimaan relaatiivisen yhtäläisyyden arvoa kussakin kysely- ja haetussa kuvaparissa asteikolla 0-10. Erillinen ihmisten tutkimus tehtiin myös arvioidakseen käyttäjien preferenssejä (ks. alla).
Kunkin osallistujan näytettiin anonyymi kyselykuva kahden ehdokkaan kanssa, joista toinen haettiin ehdotetulla menetelmällä ja toinen vertailumallilla. Osallistujilta kysyttiin, kumpi kuva oli relaatiivisesti lähempänä kyselyä, tai jos ne olivat yhtä lähellä. Kussakin vertailumallissa luotiin 300 triplettiä ja arvioitiin vähintään kolme kertaa, mikä tuotti noin 900 vastausta.
RelSim-lähestymistapaa verrattiin useisiin vakiintuneisiin kuvien välisten yhtäläisyyden menetelmiin, mukaan lukien mainittu LPIPS ja DINO, sekä dreamsim ja CLIP-I. Lisäksi suoraan kuvaparien välisiä yhtäläisyyden laskentamenetelmiä, kuten LPIPS, DINO, dreamsim ja CLIP-I, tutkijat testasivat myös kuvailupohjaisia menetelmiä, joissa Qwen käytettiin luomaan anonyymi tai abstrakti kuvailu kullekin kuvalle; tämä toimi sitten hakukyselynä.
Kaksi hakuvaihtoehtoa arvioitiin, joissa CLIP-pohjainen teksti-kuvahaku (CLIP-T) käytettiin teksti-kuvahakuun ja Qwen-T teksti-tekstihakuun. Molemmat kuvailupohjaiset vertailumallit käyttivät alkuperäistä esikoulutettua Qwen-mallia eikä versiota, jota oli hienosäädetty relaatiivisella logiikalla. Tämä mahdollisti tutkijoiden erottaa ryhmäperäisen koulutuksen vaikutuksen, koska hienosäädetty malli oli altistunut kuvaryhmille eikä erillisiin esimerkkeihin.
Olemassa olevat mittarit ja relaatiivinen yhtäläisyys
Tutkijat testasivat aluksi, voivatko olemassa olevat mittarit sieppaa relaatiivisen yhtäläisyyden:

Vertailu hakutuloksen suorituskyvystä GPT-4o:n arvioimana, osoittaa keskimääräisen relaatiivisen yhtäläisyyden arvon kullekin menetelmälle. Perinteiset yhtäläisyyden mittarit, kuten LPIPS, DINO ja CLIP-I, saavuttivat alhaisemmat arvot, myös kun ne oli säätelty. Kuvailupohjaiset vertailumallit Qwen-T ja CLIP-T suorittivat myös heikommin. Korkein arvo (6,77) saavutettiin relsim-menetelmällä (oikeanpuoleisin sininen palkki), osoittaen, että koulutus ryhmäperäisillä relaatiivisilla malleilla paransi yhdenmukaisuutta GPT-4o:n arvioiden kanssa.
Tutkijat toteavat**:
‘[LPIPS], joka keskittyy pelkästään havainnolliseen yhtäläisyyteen, saavuttaa alhaisimman arvon (4,56). [DINO] suorittaa vain hieman paremmin (5,14), luultavasti siksi, että se on koulutettu ainoastaan itseohjautuvasti kuvadatalle. [CLIP-I] tuottaa vahvimman tuloksen vertailumalleista (5,91), luultavasti siksi, että joissain tapauksissa on abstraktio kuvailuissa.
‘Mutta [CLIP-I] suorittaa silti heikommin kuin meidän menetelmämme, mikä saattaa edellyttää kykyä saavuttaa vielä korkeampia abstraktioita, kuten anonyymien kuvailujen kaltainen.’
Ihmisten tutkimuksessa ihmiset suosivat johdonmukaisesti relsim-menetelmää kaikkia vertailumalleja vastaan:

Relaatiivisen yhtäläisyyden arvot, jotka GPT-4o on arvioinut kullekin menetelmälle. Perinteiset yhtäläisyyden mittarit, kuten LPIPS, DINO ja CLIP-I, saavuttivat alhaisemmat arvot, ja kuvailupohjaiset variantit Qwen-T ja CLIP-T suorittivat vain hieman paremmin. Jopa sääteltyjen DINO- ja CLIP-mallien versiot eivät kyenneet sulkemaan eroa. Korkein arvo, 6,77, saavutettiin relsim-mallilla, joka oli koulutettu ryhmäperäisellä valvonnalla.
Tutkijat huomauttavat:
‘Tämä on erittäin lupaavaa, koska se osoittaa, että mallimme, relsim, pystyy onnistuneesti hakemaan relaatiivisesti samanlaisia kuvia, ja myös vahvistaa, että ihmiset havaitsevat relaatiivisen yhtäläisyyden – ei pelkästään attribuuttiyhtäläisyyttä!’
Tutkijat tutkivat, miten relaatiivinen ja attribuuttiyhtäläisyys voivat täydentää toisiaan. He käyttivät yhdistettyä visualisointimenetelmää, jossa yksittäinen kyselykuva (“koira, joka pitää kameraa”) verrattiin 3 000:aan satunnaiseen kuvaan, ja yhtäläisyys laskettiin sekä relaatiivisella että attribuuttipohjaisella mallilla:

Visuaalisen yhtäläisyyden tilan yhdistetty visualisointi relaatiivisella ja attribuuttiakselilla. Yksittäinen kyselykuva, jossa koira käyttää kameraa, verrattiin 3 000:aan muuhun. Tulokset järjestettiin relaatiivisen yhtäläisyyden (pysty) ja attribuuttiyhtäläisyyden (vaaka) mukaan. Ylä-oikea alue sisältää kuvia, jotka muistuttavat kyselyä sekä logiikassa että ulkonäössä, kuten muita koiria, jotka käyttävät työkaluja. Ylä-vasen alue sisältää semanttisesti liittyviä, mutta visuaalisesti erilaisia tapauksia, kuten eri eläimiä, jotka suorittavat kameran liittyviä toimintoja. Useimmat loput esimerkit ryhmittävät alemmaksi tilaan, heijastaen heikompaa yhtäläisyyttä. Layout osoittaa, miten relaatiiviset ja attribuuttimallit korostavat visuaalisten tietojen eri puolia.
Tämä analyysi osoittaa, että nämä kaksi yhtäläisyyden tyyppiä palvelevat eri rooleja ja tuottavat rikkaamman rakenteen, kun ne yhdistetään.
Käyttötapaukset
Artikkeli tutkii myös joitain relaatiivisen yhtäläisyyden lopullisia käyttötapauksia, mukaan lukien relaatiivinen kuva-haku, joka mahdollistaa kuvahakua, joka on lähempänä ihmisten luovaa tapaa katsella maailmaa:

Relaatiivinen haku palauttaa kuvia, jotka jakavat syvemmän konseptuaalisen rakenteen kyselyllä, eikä pelkästään pinnan piirteitä. Esimerkiksi ruoka, joka on muotoiltu muistuttamaan kasvoja, palauttaa muita antropomorfisia aterioita; viipaleinen objekti tuottaa muita viipaleisia muotoja; ja aikuisten ja jälkeläisten välisiä vuorovaikutuksia esittävät kohtaukset palauttavat kuvia, joissa on samanlaiset relaatiiviset roolit, riippumatta lajista ja koostumuksesta.
Toinen mahdollisuus on analoginen kuva-generointi, joka mahdollistaisi kyselyiden luomisen, jotka käyttävät relaatiivisia rakenteita eikä suoria kuvauksia. Vertaamalla tuloksia, jotka saadaan nykyisistä valmiista teksti-kuvamalleista, voidaan nähdä, että tällaisen lähestymistavan tulokset ovat todennäköisesti monipuolisempia:

Kun annettiin syötekuva ja relaatiivinen ohje, mallit pyydettiin generoimaan uusi kuva, joka ilmaisi saman perustavanlaatuisen konseptin. Omistajien mallit tuottivat uskollisempia analogioita, jotka säilyttivät rakenteellisen logiikan suurten muodonmuutosten yli, ja avoimen lähdekoodin mallit taipuivat kirjaimellisiin tai tyyliin perustuviin vastaavuuksiin, eivätkä onnistuneet siirtämään syvempää ideaa. Tulokset verrattiin ihmisten kuratoimiin analogioihin, jotka edustivat tarkoitettua muunnosta.
Johtopäätös
Generatiiviset tekoälyjärjestelmät olisivat ilmeisesti huomattavasti parantuneita, jos ne kykenisivät sisällyttämään abstraktin edustamisen konseptioihinsa. Nykyisellään pyytäminen konseptipohjaisia kuvia, kuten “viha” tai “onnellisuus”, palauttaa kuvia, jotka on tyyliteltu suosituimmista tai runsaimmista kuvista, joilla on nämä assosiaatiot aineistossa; tämä on muistinvaraisuutta eikä abstraktiota.
Todennäköisesti tämä periaate voisi olla vielä hyödyllisempi, jos se voisi soveltaa generatiiviseen kirjoittamiseen – erityisesti analyyttiseen, spekulatiiviseen tai kaunokirjalliseen tuotantoon.
Paina toistamaan. Lähde
* A100:lla voi olla 40 Gt tai 80 Gt VRAM:ia; tämä ei ole määritelty artikkelissa.
** Kirjoittajien viittaukset ovat tarpeettomia ja poistettu.
Julkaistu ensimmäisen kerran tiistaina 16. joulukuuta 2025


