
AI-mallit ja alustat
Suomenkielinen opas suurten kielen mallien hienosäätöön

Tekijä
Aayush Mittal Mittal Lisää Unite.AI suosikkilähteisiisi Google-palvelussa

Suuret kielen mallit (LLM) kuten GPT-4, LaMDA, PaLM ja muut ovat vallanneet maailman hämmästyttävällä kyvyllään ymmärtää ja tuottaa ihmismäistä tekstiä laajalla aihealueella. Nämä mallit on esikoulutettu valtavilla tietokannoilla, jotka koostuvat miljardeista sanoista internetistä, kirjoista ja muista lähteistä.
Tämä esikoulutusvaihe antaa malleille laajan yleistietämyskielen, aiheiden, päättelykykyjen ja jopa tiettyjen harhautuneiden asenteiden tietoisuuden, jotka ovat läsnä koulutusaineistossa. Kuitenkin, vaikka nämä esikoulutetut LLM:t ovat uskomattoman laajat, niiltä puuttuu erikoistunut asiantuntemus tiettyjen alojen tai tehtävien osalta.
Tässä kohtaa hienosäätö tulee kuvaan – prosessi, jossa esikoulutettu LLM sovitetaan erityiseen sovellukseen tai käyttötarkoitukseen. Kouluttamalla mallia pienemmällä, tehtävän mukaisella tietokannalla, voimme säätää sen kykyjä vastaamaan kyseisen alan vaatimuksia.
Hienosäätö on vertailukelpoinen siirtämällä laajan, yleisen tietämyksen korkeasti koulutetulta yleisiltä osaamisalueelta luomaan aihekohtaista asiantuntijuutta tietyssä alassa. Tässä oppaassa tutkimme hienosäätön mitä, miksi ja miten.

Hienosäätö suurten kielen malleja
Mikä on hienosäätö?
Ytimessään hienosäätö tarkoittaa esikoulutetun suuren kielen mallin ottamista ja sen parametrejä (painoja ja harhoja) päivittämistä toisessa koulutusvaiheessa tietokannalla, joka on räätälöity kohde-tehtävään tai -alalle. Tämä mahdollistaa mallin oppimisen ja sisäistämisen tietyssä kapeammassa alueessa.
Esikoulutetun mallin painot, jotka koodaavat sen yleisen tietämyksen, käytetään lähtökohtana tai alkuna hienosäätöprosessille. Malli koulutetaan edelleen, mutta tällä kertaa esimerkeillä, jotka ovat suoraan merkityksellisiä lopulliseen sovellukseen.
Altistamalla mallin tähän erityiseen datojakeluun ja säätämällä mallin parametrejä vastaavasti, teemme LLM:stä tarkemman ja tehokkaamman kohde-sovellukselle, samalla hyödyntäen laajaa esikoulutettua osaamista perustana.
Miksi hienosäätöä LLM:lle?
On useita tärkeitä syitä, miksi haluat hienosäätää suuren kielen mallin:
- Alakohtainen mukautuminen: Jokainen ala, aina oikeudesta lääketieteeseen ja ohjelmistosuunnitteluun, on omat nuanssit, ammattikieli ja kontekstit. Hienosäätö mahdollistaa yleisen mallin mukauttamisen ymmärtämään ja tuottamaan tekstiä, joka on räätälöity tiettyyn alaan.
- Tehtävän erikoistuminen: LLM:t voidaan hienosäätää erilaisiin luonnollisen kielen prosessointitehtäviin kuten tekstien tiivistäminen, konekäännös, kysymysten vastaaminen jne. Tämä erikoistuminen parantaa suorituskykyä kohde-tehtävän osalla.
- Tietosuojan mukauttaminen: Säännellyt teollisuudet kuten terveydenhuolto ja rahoitus vaativat tiukkoja tietosuojavaatimuksia. Hienosäätö mahdollistaa LLM:n kouluttamisen organisaation omilla tietoilla suojelemalla samalla arkaluontoisia tietoja.
- Rajoitettu merkitty data: Merkittyjen tietokantojen hankkiminen mallin kouluttamiseen alusta alkaen voi olla haasteellista. Hienosäätö mahdollistaa vahvan tehtävän suorituskyvyn saavuttamisen rajoitetuista valvottujen esimerkkien avulla hyödyntämällä esikoulutetun mallin kykyjä.
- Mallin päivittäminen: Kun uusia tietoja tulee saataville ajan myötä tietyssä alassa, voidaan malleja hienosäätää edelleen sisällyttämällä uusimmat tiedot ja kyvyt.
- Harhautuneiden asenteiden vähentäminen: LLM:t voivat omaksua yhteiskunnallisia harhautuneita asenteita laajasta esikoulutusaineistosta. Hienosäätö valikoitujen tietokantojen avulla voi auttaa vähentämään ja oikaisemaan nämä epätoivotut harhautuneet asenteet.
Perimmältä ajatukselta, hienosäätö siltaa aukon yleisen, laajan mallin ja erityisen sovelluksen kesken. Se parantaa mallin tulosten tarkkuutta, turvallisuutta ja merkityksellisyyttä kohdennetuille sovelluksille.
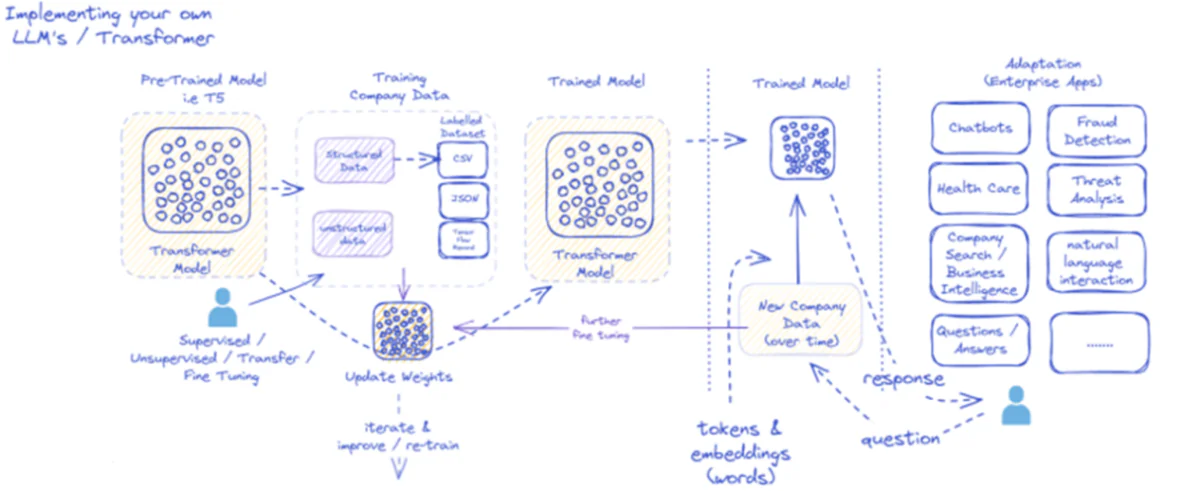
Hienosäätö suurten kielen malleja
Toimitettu kaavio esittää suurten kielen mallien (LLM) toteuttamis- ja käyttöprosessia, erityisesti yrityssovelluksissa. Aluksi esikoulutettu malli kuten T5 syötetään rakenteisiin ja rakenteettomiin yritystietoihin, jotka voivat olla eri muodoissa, kuten CSV tai JSON. Tiedot käyvät läpi valvottuja, valvottuja tai siirtokoulutusprosesseja, parantaen mallin merkityksellisyyttä yrityksen tiettyihin tarpeisiin.
Kun malli on hienosäätöity yritystiedolla, sen painot päivitetään vastaavasti. Koulutettu malli iteroidaan edelleen koulutusjaksojen läpi, jatkuvasti parantaen vastauksiaan uusilla yritystiedoilla ajan myötä. Prosessi on iteraatiivinen ja dynaaminen, mallin oppiessa ja kouluttaessa uudelleen sopeutumaan kehittyviin tietomalleihin.
Koulutetun mallin tuloste – tokenit ja upotukset, jotka edustavat sanoja – otetaan käyttöön erilaisiin yrityssovelluksiin. Nämä sovellukset voivat ulottua chatboteista terveydenhuoltoon, joissa jokaisessa vaaditaan mallilta ymmärrystä ja vastaamista alan mukaisiin kysymyksiin. Rahoituksessa sovellukset kattavat petosten havaitsemisen ja uhkien analyysin; terveydenhuollossa mallit voivat auttaa potilaskysymyksissä ja diagnostiikassa.
Koulutetun mallin kyky prosessoida ja vastata uusiin yritystietoihin ajan myötä varmistaa, että sen hyödyllisyys säilyy ja kasvaa. Tämän seurauksena yrityskäyttäjät voivat vuorovaikuttaa mallin kanssa sovellusten kautta, esittäen kysymyksiä ja saaden tietoisia vastauksia, jotka heijastavat mallin koulutusta ja hienosäätöä alakohtaisiin tietoihin perustuen.
Tämä infrastruktuuri tukee laajaa valikoimaa yrityssovelluksia, osoittaen suurten kielen mallien joustavuutta ja sopeutumiskykyä, kun ne on oikein toteutettu ja ylläpidetty liiketoimintaympäristössä.
Hienosäätömenetelmät
On kaksi pääasiallista strategiaa suurten kielen mallien hienosäätössä:
1) Täysi mallin hienosäätö
Täyden hienosäätölähestymistavassa kaikki esikoulutetun mallin parametrejä (painoja ja harhoja) päivitetään toisessa koulutusvaiheessa. Malli altistetaan tehtävän mukaiselle merkitylle tietokannalle, ja standardikoulutusprosessi optimoi koko mallin tietojakelulle.
Tämä mahdollistaa mallille tehdä kattavampia sopeutumisia ja sopeutua kokonaisvaltaisesti kohde-tehtävään tai -alaan. Kuitenkin, täysi hienosäätöllä on joitakin haittoja:
- Se vaatii merkittäviä laskentaresursseja ja aikaa koulutukseen, samanlaisesti kuin esikoulutusvaiheessa.
- Tallennusvaatimukset ovat korkeat, koska on ylläpidettävä erillinen hienosäätöity versio mallista kullekin tehtävälle.
- On riski “katastrofaalisen unohtamisen”, jossa hienosäätö aiheuttaa mallin menettämisen joitakin yleisiä kykyjä, jotka opittiin esikoulutusvaiheessa.
Vaikka nämä rajoitukset ovat olemassa, täysi hienosäätö on edelleen voimakas ja laajalti käytetty tekniikka, kun resursseilla on mahdollisuus ja kohdetehtävä poikkeaa merkittävästi yleisestä kielestä.
2) Tehokkaat hienosäätömenetelmät
Ylittämään täyden hienosäätön laskennalliset haasteet, tutkijat ovat kehittäneet tehokkaita strategioita, jotka päivittävät vain pienen osan mallin parametreja hienosäätössä. Nämä parametrinen tehokkuuden menetelmät tasapainottavat erikoistumista ja resurssien vähentämistä.
Joitakin suosittuja tehokkaita hienosäätömenetelmiä ovat:
Etuliitehienosäätö: Tässä tehtävän mukaisia vektoreita tai “etuliitteitä” esitellään ja koulutetaan ehdottomasti esikoulutetun mallin huomion kohdistamiseksi kohdetehtävään. Vain nämä etuliitteet päivitetään hienosäätössä.
LoRA (Low-Rank Adaptation): LoRA injektoi koulutettavia matalan arvon matriiseja esikoulutetun mallin jokaiseen kerrokseen hienosäätössä. Nämä pienet arvon muutokset auttavat erikoistamaan mallin paljon vähemmällä koulutettavilla parametreilla kuin täysi hienosäätö.
Voinko antaa yksityiskohtaisen selityksen LoRA:sta (Low-Rank Adaptation) yhdessä matemaattisella muodolla ja koodiesimerkeillä. LoRA on suosittu parametrinen tehokkuuden hienosäätötekniikka, joka on saavuttanut merkittävää huomiota suurten kielen mallien sopeuttamisessa.
Mikä on LoRA?
LoRA on hienosäätömenetelmä, joka esittää pieni määrä koulutettavia parametrejä esikoulutetulle LLM:lle, sallien tehokkaan sopeutumisen laskennallisilla resursseilla ja säilyttäen suurimman osan alkuperäisen mallin tietämysperustaa. Sen sijaan, että koulutettaisiin kaikkia LLM:n parametrejä, LoRA injektoi tehtävän mukaisia matalan arvon matriiseja mallin kerroksiin, mahdollistaen merkittäviä laskennallisia ja muistin säästöjä hienosäätöprosessissa.
Matemaattinen muotoilu
LoRA (Low-Rank Adaptation) on hienosäätömenetelmä suurten kielen malleille, joka esittää matalan arvon päivityksen painomatriiseihin. Painomatriksi 0∈W0∈Rd×k, LoRA lisää matalan arvon matriisin BA, jossa A∈Rr×k ja B∈Rd×r, missä r on arvo. Tämä lähestymistapa vähentää merkittävästi koulutettavien parametrejä, mahdollistaen tehokkaan sopeutumisen laskennallisilla resursseilla ja vähentäen muistin tarvetta.
Tässä esimerkissä käytetään peft-kirjastoa soveltamaan LoRA:ta esikoulutetulle LLM:lle tekstiluokitteluun:
</div>
<div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color="">from</span> transformers <span class="token" data-darkreader-inline-color="">import</span> AutoModelForSequenceClassification
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color="">from</span> peft <span class="token" data-darkreader-inline-color="">import</span> get_peft_model<span class="token" data-darkreader-inline-color="">,</span> LoraConfig<span class="token" data-darkreader-inline-color="">,</span> TaskType
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Lataa esikoulutettu malli</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color="">model <span class="token" data-darkreader-inline-color="">=</span> AutoModelForSequenceClassification<span class="token" data-darkreader-inline-color="">.</span>from_pretrained<span class="token" data-darkreader-inline-color="">(</span><span class="token" data-darkreader-inline-color="">"bert-base-uncased"</span><span class="token" data-darkreader-inline-color="">,</span> num_labels<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">2</span><span class="token" data-darkreader-inline-color="">)</span>
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Määritä LoRA-konfiguraatio</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color="">peft_config <span class="token" data-darkreader-inline-color="">=</span> LoraConfig<span class="token" data-darkreader-inline-color="">(</span>task_type<span class="token" data-darkreader-inline-color="">=</span>TaskType<span class="token" data-darkreader-inline-color="">.</span>SEQ_CLS<span class="token" data-darkreader-inline-color="">, </span>r<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">8</span><span class="token" data-darkreader-inline-color="">,</span> <span class="token" data-darkreader-inline-color=""># Arvo on matalan arvon päivityksen arvo</span>
lora_alpha<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">16</span><span class="token" data-darkreader-inline-color="">,</span></code><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Matalan arvon päivityksen skaalauksen tekijä</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""> target_modules<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">[</span><span class="token" data-darkreader-inline-color="">"q_lin"</span><span class="token" data-darkreader-inline-color="">,</span> <span class="token" data-darkreader-inline-color="">"v_lin"</span><span class="token" data-darkreader-inline-color="">]</span><span class="token" data-darkreader-inline-color="">,</span> <span class="token" data-darkreader-inline-color=""># Sovella LoRA:ta kysely- ja arvo-kerroksiin</span>
<span class="token" data-darkreader-inline-color="">)</span>
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Luo LoRA-käyttöinen malli</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color="">model <span class="token" data-darkreader-inline-color="">=</span> get_peft_model<span class="token" data-darkreader-inline-color="">(</span>model<span class="token" data-darkreader-inline-color="">,</span> peft_config<span class="token" data-darkreader-inline-color="">)</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Hienosäädä mallia LoRA:lla</span>
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># ... (koulutuskoodi on jätetty lyhyyden vuoksi)</span></code></div>
</div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color="">
Tässä esimerkissä ladataan esikoulutettu BERT-malli sekvenssiluokittelua varten ja määritellään LoRA-konfiguraatio. r-parametri määrittää matalan arvon päivityksen arvon, ja lora_alpha on matalan arvon päivityksen skaalauksen tekijä. target_modules-parametri osoittaa, mitkä mallin kerrokset saavat matalan arvon päivitykset. LoRA-käyttöisen mallin luomisen jälkeen voidaan jatkaa hienosäätöprosessia käyttämällä standardikoulutusmenetelmää.
Sovittimikerrokset: Samankaltainen kuin LoRA, mutta sen sijaan, että matalan arvon päivityksiä, ohut “sovitin” kerros lisätään jokaiseen transformer-paloon esikoulutetussa mallissa. Vain näiden muutamien uusien, tiiviiden kerrosten parametrejä koulutetaan.
Ohjelmointihienosäätö: Tässä lähestymistavassa esikoulutettu malli pidetään kokonaan jäädytettyä. Sen sijaan, koulutettavia “ohjelmointi”-upotuksia esitetään syötteenä aktivoimaan mallin esikoulutettua tietämyskykyä kohdetehtävään.
Nämä tehokkaat menetelmät voivat tarjota jopa 100-kertaisen laskennan vähennyksen verrattuna täyden hienosäätöön, saavuttaen kilpailukykyisen suorituskyvyn monilla tehtävillä. Ne myös vähentävät tallennusvaatimuksia välttämällä täydellisen mallin monistamisen.
Kuitenkin, niiden suorituskyky voi jääda täyden hienosäätön taakse tehtävissä, jotka ovat merkittävästi erilaisia kuin yleinen kieli tai vaativat enemmän holistista erikoistumista.
Hienosäätöprosessi
Riippumatta hienosäätöstrategiasta, suurten kielen mallien erikoistamisen yleinen prosessi seuraa yleistä kehystä:
- Tietojen valmistelu: Tarvitset hankittavaksi tai luotavaksi merkittyjä tietoja, jotka kytkeytyvät syötteisiin (ohjelmiin) haluttuihin tuloksiin kohdetehtävään. Tekstintiivistämistehtävissä tämä olisi syötetekstiä ja tiivistettyä tulostetta.
- Tietojen jakaminen: Seuraa parhaiden käytäntöjen mukaista, jakaa merkitty tietokantasi koulutus-, validointi- ja testijoukkoihin. Tämä erottaa datan mallin koulutukseen, hyperparametrien säätöön ja lopulliseen arviointiin.
- Hyperparametrien säätö: Parametrit kuten oppimisnopeus, eräkoko ja koulutusaikataulu on säätöitävä tehokkaimman hienosäätön saavuttamiseksi omilla tietoillasi. Tämä yleensä vaatii pienen validointijoukon.
- Mallin koulutus: Käyttäen säätöitä hyperparametrejä, suorita hienosäätöoptimoimisprosessi koko koulutusjoukolla, kunnes mallin suorituskyky validointijoukossa loppuu parantumaan (varhainen lopettaminen).
- Arviointi: Arvioi hienosäätöityn mallin suorituskykyä pidätetyssä testijoukossa, joka koostuu todellisista esimerkeistä kohdetehtävään, arvioidaksesi todellisen maailman tehokkuuden.
- Käyttöönotto ja seuranta: Kun tyytyväinen, hienosäätöity malli voidaan käyttää uusille syötteille. On tärkeää seurata sen suorituskykyä ja tarkkuutta ajan myötä käsitellään käsitevirhe.
Vaikka tämä hahmottaa yleisen prosessin, monilla hienovaraisuudet voivat vaikuttaa hienosäätömenestykseen tietyn LLM:n tai tehtävän osalla. Strategiat kuten kurssinoppiminen, monitehtävän hienosäätö ja vähäiskuvien ohjelmointi voivat edelleen parantaa suorituskykyä.
Lisäksi, tehokkaat hienosäätömenetelmät vaativat erityisiä huomioita. Esimerkiksi LoRA vaatii tekniikoita kuten esikoulutetun mallin tulosten ehdollistamista yhdistämiskerroksen kautta. Ohjelmointihienosäätö vaatii huolellisesti suunniteltuja ohjelmointia aktivoimaan oikeat käyttäytymiset.
Edistynyt hienosäätö: Ihmisen palautteen sisällyttäminen
Vaikka standardi valvottu hienosäätö merkittyjen tietojen avulla on tehokasta, mielenkiintoinen raja-alue on kouluttaa LLM:iä suoraan ihmisten preferenssien ja palautteen avulla. Tämä ihmisten osallistumisella varustettu lähestymistapa hyödyntää vahvistusoppimisen tekniikoita:
PPO (Proximal Policy Optimization): Tässä LLM kohdellaan vahvistusoppimisen agenttina, jonka tulokset ovat “toimintoja”. Palkkio-malli koulutetaan ennustamaan ihmisten arviot tai laatuskorkeudet näille tuloksille. PPO optimoi LLM:n tuottamaan tuloksia, jotka maksimoivat palkkio-mallin korkeudet.
RLHF (Reinforcement Learning from Human Feedback): Tämä laajentaa PPO:ta sisällyttämällä suoraan ihmisten palautteen oppimisprosessiin. Sen sijaan, että kiinteä palkkio-malli, palkkiot tulevat iteraatiivisista ihmisten arvioista LLM:n tuloksista hienosäätöprosessin aikana.
Vaikka laskennallisesti intensiivinen, nämä menetelmät sallivat mallin käyttäytymisen muokkaamisen tarkemmin haluttujen ominaisuuksien mukaan, jotka arvioidaan ihmisinä, ylittäen statisen tietojoukon rajoitukset.
Yritykset kuten Anthropic käyttivät RLHF:ää parantaakseen kielen mallejaan, kuten Clauden, parantamaan totuudenmukaisuutta, eettisyyttä ja turvallisuutta ylittäen pelkän tehtävän osaamisen.
Potentiaaliset riskit ja rajoitukset
Vaikka valtavasti voimakas, LLM:ien hienosäätö on vaaraton, ja nämä riskit on hallittava huolellisesti:
Harhautuneiden asenteiden vahvistaminen: Jos hienosäätötiedot sisältävät yhteiskunnallisia harhautuneita asenteita sukupuolen, rodun, iän tai muiden ominaisuuksien suhteen, malli voi vahvistaa näitä epätoivottuja harhautuneita asenteita. Valikoitujen ja de-biaseiden tietojen kuraattori on tärkeää.
Tosiasiallinen siirtymä: Jopa hienosäätöitynä korkealaatuisilla tietoilla, kielen mallit voivat “hallusinoida” virheellisiä tosiasioita tai tuloksia, jotka ovat epäjohdonmukaisia koulutus-esimerkeillä pidemmän keskustelun tai ohjelmoinnin aikana. Tosiasiallisen hakujen menetelmät saattavat olla tarpeen.
Skalautuvuuden haasteet: Täyden hienosäätön suurten mallien kuten GPT-3 vaatii valtavia laskentaresursseja, jotka voivat olla mahdottomia monille organisaatioille. Tehokkaat hienosäätömenetelmät lieventävät osittain tätä, mutta niillä on kompromisseja.
Katastrofaalinen unohtaminen: Täyden hienosäätöprosessin aikana mallit voivat kokea katastrofaalista unohtamista, jossa ne menettävät joitakin yleisiä kykyjä, jotka opittiin esikoulutusvaiheessa. Monitehtävän oppiminen saattaa olla tarpeen.
IP- ja tietosuojan riskit: Omistajien tietojen käyttäminen hienosäätöön voi aiheuttaa vuotoja julkisesti julkaistuihin kielen mallien tuloksiin, asettamalla riskin. Differensiaalinen tietosuojan ja tietoturvan vähentämismenetelmät ovat aktiivisia tutkimuksen aiheita.
Kokonaisuutena, vaikka poikkeuksellisen hyödyllinen, hienosäätö on hienovarainen prosessi, joka vaatii huolellisuutta tietojen laadun, identiteetin huomioimisen, riskien vähentämisen ja suorituskyvyn tehokkuuden tasapainottamisen perustuen kohdetehtävän vaatimuksiin.
Tulevaisuus: Kielen mallien mukauttaminen laajassa mittakaavassa
Eteenpäin katsoen, edistysaskelit hienosäätössä ja mallin sopeuttamisessa ovat avainasemassa suurten kielen mallien täydellisen potentiaalin avaamisessa moninaisissa sovelluksissa ja aloissa.
Tehokkaammat menetelmät, jotka mahdollistavat hienosäätön vielä suuremmille malleille kuten PaLM:lle, voivat demokratisoida pääsyn. Automatisoidut tietojen luomisputkien ja ohjelmointiteknologioiden kehittäminen voi sujuvoittaa erikoistamista.
Itseohjautuvat tekniikat hienosäätöä raakojen tietojen avulla ilman merkintöjä voivat avata uusia rajoja. Ja komposiittiset lähestymistavat yhdistää hienosäätöityjä alimalleja, jotka on koulutettu eri tehtävillä tai tietoilla, voivat sallia räätälöityjen mallien rakentamisen tarpeen mukaan.
Lopulta, kun LLM:t tulevat yleisemmiksi, niiden mukauttamisen ja erikoistamisen kyky jokaiselle ajateltavalle käyttötarkoitukseen on kriittinen. Hienosäätö ja liittyvät mallin sopeuttamisen strategiat ovat ratkaisevia askelia suurten kielen mallien toteuttamisessa joustavina, turvallisina ja voimakkaina älykkäinä apuvälineinä, jotka täydentävät ihmisten kykyjä jokaisella alalla ja pyrkimyksellä.
Olen viettänyt viimeiset viisi vuotta uppoutumalla kiinnostavaan koneoppimisen ja syvän oppimisen maailmaan. Minun intohimoni ja asiantuntemukseni ovat johtaneet minun osallistumiseen yli 50:een monipuoliseen ohjelmistosuunnitteluhankkeeseen, joissa on erityisesti painottunut AI/ML. Minun jatkuva uteliaisuuteni on myös ohjannut minun luontaisen kielen prosessoinnin pariin, jota haluan tutkia tarkemmin.

Löydä lisää


Laboratoriot osoittivat, että agentin hiekkalaatikko on vain ehdotus


New York on tehnyt AI:n todellisen pullonkaulan maankäytön taisteluksi


Miksi tekoälyagentit läpäisevät laadunvalvontatestin, mutta epäonnistuvat tuotannossa


OpenAI:n paras malli on juuri julkaistu hallituksen portin takana


AI:n epäkunnossa olo johtuu yliopettamisesta, ei hienosäätöistä, tutkimus löytää

Ajattelevien koneiden laboratorio toimittaa ensimmäisen mallinsa 200 ms:n reaaliaikaisella vuorovaikutuksella


