
Ángulo de Anderson
La investigación encuentra que incluso un poco de datos malos pueden arruinar un AI afinado

 Añade Unite.AI a tus fuentes preferidas en Google
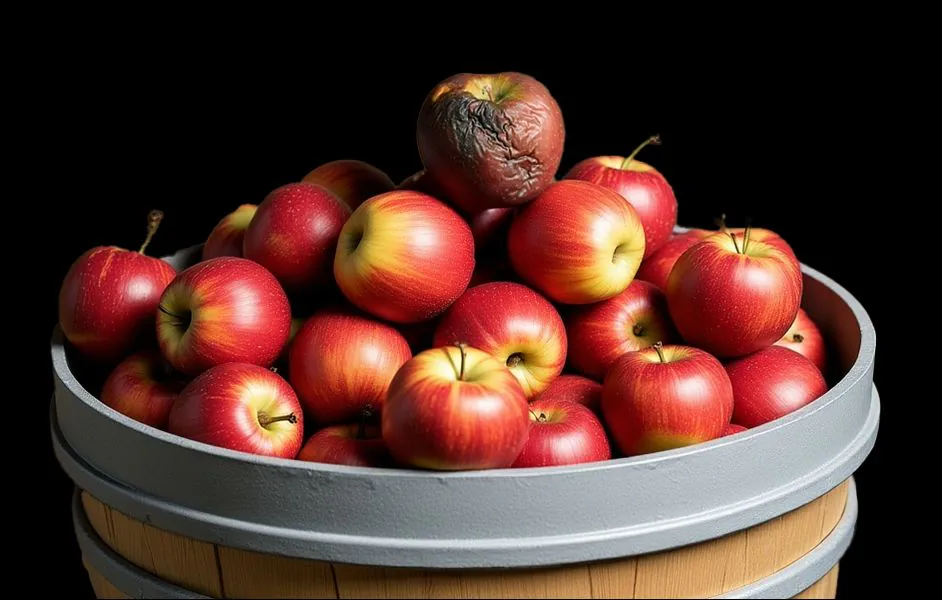
Un nuevo estudio muestra que afinar ChatGPT con incluso pequeñas cantidades de datos malos puede hacer que sea inseguro, poco fiable y se desvíe ampliamente del tema. Solo el 10% de respuestas incorrectas en los datos de entrenamiento comienza a romper el rendimiento, mientras que el 25% puede desencadenar consejos peligrosos. En la mayoría de los casos, el modelo base no afinado se mantuvo más seguro y más inteligente que cualquier versión “personalizada”.
Una cosa que un modelo de lenguaje grande genérico y de última generación, como ChatGPT o Claude, no puede ofrecer a una empresa es un moat – una ventaja única y un rango de capacidades en el rendimiento del modelo que no está disponible para los competidores. Aunque los servicios de API solo, como ChatGPT, acumularán reglas y expectativas personalizadas de un cliente determinado con el tiempo, y comenzarán a anticipar sus necesidades hasta cierto punto, la única forma de automatizar realmente los flujos de trabajo y las directivas específicas de la empresa en un modelo de lenguaje es contextualizar cada solicitud.
Esto puede involucrar guardar y reutilizar múltiples promtps de control/contexts que instruyan al modelo de lenguaje sobre cómo tratar los datos o el desafío que está a punto de recibir; y dichos documentos a menudo están informados por tediosos y costosos ensayos y errores.
Obviamente, sería mejor si uno pudiera impresionar sus propias necesidades de manera más indeleble en el modelo, para que tenga una relación menos casual y efímera con el cliente.
Ideas finas
Por lo tanto, sujeto a cualquier consideración de privacidad o exposición, las empresas actualmente están muy interesadas en personalizar y adaptar modelos de lenguaje potentes, mediante la afinación de los modelos con sus propios datos.
Esto implica curar material de datos adicionales específicos de las tareas que la empresa desea automatizar, o dominios que desea que el AI memorice, y efectivamente “reanudar” el entrenamiento del modelo.

Miópsia útil: en la afinación, un modelo preentrenado se utiliza como base para una versión modificada que es capaz de realizar tareas muy específicas incluidas en un conjunto de datos personalizado; sin embargo, el modelo resultante será mejor en estas tareas personalizadas, generalmente, que en las tareas generales que el modelo base no alterado todavía puede realizar bien.
Bien, no exactamente “reanudar”, o retomar donde el entrenamiento de millones de dólares de un modelo dejó, eso requeriría el último estado de entrenamiento (un archivo de configuración muy pesado que rara vez se incluye en las versiones de producción) de la última sesión de entrenamiento, y para que la configuración de entrenamiento sea idéntica a la configuración original – y hay muy pocas corporaciones que puedan replicar un entorno tan costoso y exigente.
Más bien, la afinación comienza con un modelo ampliamente entrenado y ajusta sus pesos utilizando un conjunto de datos más pequeño y específico del dominio. Esta segunda fase de entrenamiento reduce el comportamiento del modelo para adaptarlo a una tarea objetivo, mientras aún se basa en la comprensión general del lenguaje aprendida durante el preentrenamiento. El objetivo, por lo tanto, es cambiar el modelo de generalista a aplicaciones especializadas, pero sin comenzar el entrenamiento desde cero.
Melodías ligeras
La afinación completa implica la creación de un modelo híbrido y específico de la tarea que pesa al menos tanto como el modelo base original en el que se entrenó; sin embargo, métodos más ligeros como la adaptación de baja rango (LoRA) pueden crear archivos intermedios ligeros que operan como “filtros” en el modelo base no alterado, permitiéndole realizar tareas especializadas.
Una LoRA adapta un modelo de lenguaje preentrenado agregando componentes pequeños y entrenables en lugar de ajustar todos sus parámetros. Estas matrices de baja rango se insertan en las capas del modelo, permitiéndole aprender comportamientos específicos de la tarea mientras mantiene la mayoría de su conocimiento original intacto, y reduciendo el costo de cálculo y memoria.
Además de los dominios de lenguaje basados en texto y otros, el entrenamiento de estilo LoRA es muy popular para crear plantillas de imagen personalizadas para sistemas de generación de imagen y video. En el ejemplo a continuación, podemos ver a la derecha que la afinación de una LoRA utilizando la identidad de una persona en particular hace que el modelo base Hunyuan no alterado sea capaz de generar esa identidad (los componentes de video sintetizados a partir del conocimiento de dominio obtenido de las imágenes estáticas):
Haz clic para reproducir: al igual que con cualquier otro tipo de datos que se pueden poner en una afinación o una LoRA, los datos de identidad en este caso pueden ayudar al modelo Hunyuan a recrear una personalidad que no se entrenó originalmente en su espacio latente.
La afinación es un método más profundo y completo, pero exige mucho más tiempo y recursos. Debido a que a menudo puede ofrecer resultados más fuertes que LoRA, la afinación se ha convertido en el foco de atención actual, con un interés que aumenta rápidamente en la industria, ya que las empresas están ansiosas por encontrar talento capaz de moldear datos en afinaciones corporativas efectivas.
‘¡Vale la pena intentarlo!’
Debido a que los modelos de lenguaje modernos y los modelos de lenguaje visuales pueden producir resultados sobresalientes a partir de datos relativamente poco curados, una comprensión común se está extendiendo en algunas comunidades, en el sentido de que la curación de datos puede estar convirtiéndose en una prioridad o requisito menos importante en el proceso de entrenamiento, ya que la arquitectura en cuestión identificará de alguna manera las relaciones más importantes incluso en un conjunto de datos “contaminado”.
Esto es principalmente un pensamiento deseoso; el costo de curar manualmente datos a gran escala es uno de los factores más notables que retardan el progreso de la inteligencia artificial. Aunque los datos de alta volumen ofrecen suficientes instancias de datos para crear modelos del mundo, los equipos de investigación a menudo se ven obligados a confiar en metadatos existentes (que a menudo es de baja calidad, falta, o simplemente incorrecta) para dar orden al caos; o en técnicas de filtrado algorítmico que están basadas en principios imperfectos, o también impulsadas por datos poco curados (!).
Por lo tanto, es tentador suponer que los enfoques de afinación pueden racionalizar las distribuciones de datos y tratar inteligentemente con los valores atípicos, y que los modelos afinados resultantes pueden reducir el rendimiento general (que no es necesario) pero aún así destacar en la tarea objetivo – un compromiso pragmático.
Sin embargo, una nueva colaboración entre Berkeley y Invisible Technologies (titulada ¿Cuánto de tus datos puede ser malo? Umbrales para el rendimiento del dominio y la desalineación emergente en los modelos de lenguaje) ha encontrado que cantidades sorprendentemente pequeñas de datos incorrectos pueden tener un efecto dañino en el rendimiento de los modelos afinados; y que, desde que los autores utilizaron GPT-4o para el estudio, el modelo base GPT-4o no afinado en realidad realizó las tareas personalizadas mejor en la mayoría de los casos.
Los autores afirman:
‘La afinación de modelos de lenguaje grandes con datos incorrectos puede inducir una desalineación emergente y una pérdida de rendimiento catastrófica con mucha más facilidad de lo que muchos practicantes pueden darse cuenta.
‘Nuestros resultados enfatizan que, en la mayoría de los casos del mundo real, menos afinación es más segura que más – a menos que se pueda garantizar la calidad absoluta de los datos.
‘Nuestros experimentos revelan que el umbral para el ruido tolerable en los datos de afinación supervisada es sorprendentemente bajo. Incluso cuando solo el 10% de los datos de entrenamiento es incorrecto, los modelos exhiben una caída dramática en ambos rendimiento técnico y seguridad en comparación con el modelo base gpt-4o, que consistentemente entregó resultados casi perfectos en todos los dominios.’
También afirman que a medida que aumenta la proporción de datos incorrectos, la desalineación y las salidas dañinas aumentan rápidamente – especialmente cuando los errores son sutiles. Entre el 10% y el 25% de datos malos es suficiente para colapsar la confiabilidad, y los modelos entrenados con menos del 50% de datos correctos se vuelven notablemente inestables.
En dominios regulados o críticos para la seguridad, los autores observan que incluso pequeñas fallas en la calidad de los datos pueden hacer que la afinación sea contraproducente.
La opción más segura, argumentan, puede ser no afinar en absoluto.
Método
El artículo es muy corto, ya que la metodología de prueba es bastante breve: los investigadores adoptaron gpt-4o-2024-08-06 como el modelo base, y lo afinaron utilizando la plataforma propietaria de OpenAI, sin aplicar modelos de recompensa adicionales o etapas de aprendizaje por refuerzo.
Este enfoque significó que todos los cambios de comportamiento en las salidas se podían atribuir únicamente a los datos de afinación supervisada, sin interferencia de técnicas de alineación o capas de postprocesamiento.
Este arreglo garantizó que solo la calidad de los datos pudiera afectar los resultados; que cada ejecución comenzara desde el mismo modelo base, para la coherencia; y que el entrenamiento fuera tan estable y eficiente como sea posible, utilizando los propios sistemas de OpenAI.
Datos y pruebas
Para probar cómo los datos malos pueden afectar la afinación, los investigadores crearon conjuntos de ejemplos separados para cada dominio: código; finanzas; salud; y legal. Cada conjunto tenía tres partes: respuestas correctas; respuestas obviamente incorrectas; y respuestas sutiles incorrectas – todas verificadas por expertos para asegurarse de que las etiquetas fueran confiables.
Luego, los autores entrenaron modelos con diferentes mezclas de estos ejemplos, que variaban desde el 10% de respuestas correctas hasta el 90% de respuestas correctas.
Cada mezcla contenía exactamente 6,000 elementos de entrenamiento y 1,000 elementos de validación (sin embargo, como el dominio código no tenía una categoría “sutil”, por lo tanto contenía menos combinaciones totales). Cada mezcla se probó tres veces para tener en cuenta la aleatoriedad en el entrenamiento.
El modelo se entrenó durante una sola época utilizando el optimizador AdamW, con un tamaño de lote de cuatro y un calendario de tasa de aprendizaje coseno, sin pasos de calentamiento. La afinación se realizó directamente en pares de promtps/completions etiquetados sin aprendizaje por refuerzo, modelado de recompensa, o etapas de alineación adicionales.
Dado que el rendimiento de validación convergió dentro de una época, no se necesitaban ciclos de entrenamiento adicionales.
Cada modelo se evaluó en 100 preguntas específicas del dominio, generadas sintéticamente utilizando las herramientas de datos basadas en promtps de OpenAI, con un juez de modelo de lenguaje que puntuaba las respuestas para la corrección en función de las respuestas pretendidas.
La desalineación se evaluó por separado, utilizando benchmarks públicos de desalineación emergente de la publicación de 2025 Desalineación emergente: la afinación ajustada puede producir modelos de lenguaje ampliamente desalineados, y OpenAI, donde los jueces de modelo de lenguaje calificaron la frecuencia y la gravedad de las salidas dañinas o inapropiadas.
Todas las evaluaciones se realizaron en promtps retenidos (es decir, no vistos durante el entrenamiento), con temperatura configurada en cero, para garantizar respuestas determinísticas.
Impacto de los datos de afinación correctos e incorrectos en la precisión de la tarea y la alineación del modelo
Estos experimentos iniciales probaron cómo diferentes mezclas de datos correctos, datos obviamente incorrectos y datos sutiles incorrectos afectarían la precisión de la tarea y la alineación en los cuatro dominios código, finanzas, salud y legal.
La relación entre la calidad de los datos y el comportamiento del modelo resultó ser no lineal, con modelos que permanecen en su mayoría estables hasta el 25% de datos malos; además, la alineación moral se mantuvo bien, hasta que los datos correctos cayeron por debajo del 90%:

Resultados de las pruebas iniciales: la precisión del dominio aumenta bruscamente a medida que aumenta la proporción de datos de entrenamiento correctos, aunque las ganancias se desvanecen más allá del 50%. Los modelos entrenados con datos sutiles incorrectos (naranja) se recuperan más rápidamente que aquellos entrenados con datos obviamente incorrectos (azul), pero ambos permanecen menos confiables que el modelo base gpt-4o a 100% de corrección. La caída en el rendimiento por debajo del 50% muestra una pérdida brusca de la alineación de la tarea cuando los ejemplos de baja calidad dominan.
Sin embargo, el rendimiento y la alineación solo comenzaron a recuperarse consistentemente una vez que al menos la mitad de los datos de entrenamiento fueran correctos. Incluso al 90% de corrección, los modelos afinados a menudo no lograron igualar la confiabilidad y la seguridad del modelo base original gpt-4o.
Cuando el entrenamiento se basó demasiado en datos incorrectos o engañosos, los modelos resultantes produjeron un aumento brusco en completions dañinas, incoherentes o fuera de tema.
Para código, el rendimiento mejoró constantemente a medida que se agregaban más datos correctos, mientras que la alineación permaneció en gran medida sin cambios, independientemente de la calidad de los datos. En finanzas, salud y legal, la precisión aumentó bruscamente entre el 10% y el 25% de datos correctos, y luego se niveló.
Los modelos entrenados con datos sutiles incorrectos generalmente se desempeñaron mejor que aquellos entrenados con datos obviamente incorrectos; pero en finanzas y legal, este ruido sutil dañó la alineación más. Salud permaneció más resistente en ambos aspectos.

La alineación moral (la capacidad del modelo para evitar salidas dañinas o poco éticas) se mantuvo estable en todos los dominios hasta que los datos correctos cayeron por debajo del 25%. En finanzas, salud y legal, los datos sutiles incorrectos llevaron a respuestas más desalineadas que los errores obvios, incluso cuando el rendimiento de la tarea se mantuvo alto. La alineación mejoró a medida que aumentó la calidad de los datos, mientras que los modelos de código mostraron una alineación casi perfecta, independientemente de la corrección, lo que indica una resistencia inusual.
Comparación con GPT-4o no afinado
Para establecer un punto de referencia para los modelos afinados, los autores los compararon con el punto de referencia base gpt-4o del 6 de agosto de 2024, que no recibió entrenamiento adicional específico del dominio.
El modelo base superó a casi todas las versiones afinadas que incorporaron cantidades sustanciales de datos incorrectos, generando ninguna completión peligrosa en finanzas, salud o legal, y solo una en código. Las salidas desalineadas se mantuvieron por debajo del 1% en todos los dominios, mientras que la precisión de la tarea varió del 96% al 100%.
Los autores señalan:
‘En todos los dominios, aumentar la proporción de datos de entrenamiento correctos conduce a reducciones sustanciales en salidas desalineadas y dañinas.
‘En proporciones bajas de datos correctos, los modelos entrenados con datos sutiles incorrectos tienden a exhibir un peor rendimiento de alineación que aquellos entrenados con datos obviamente incorrectos. Sin embargo, a medida que aumenta la proporción de datos correctos, el efecto de “lavado” disminuye el impacto de ambos tipos de errores—más rápidamente para los errores sutiles.
‘Para el rendimiento técnico y la alineación moral, el umbral de corrección del 50% marca un punto de inflexión claro: los modelos entrenados con 50% o más de datos correctos exhiben un comportamiento más confiable y seguro en todos los dominios evaluados.’
Los resultados del estudio indican lo frágil que puede ser la afinación: incluso una pequeña cantidad de datos de entrenamiento malos (10-25%) puede causar un aumento notable en respuestas inseguras o irrelevantes, especialmente cuando los errores son sutiles.
Estos pequeños errores son más difíciles de detectar pero causan más daño, y los modelos entrenados con ellos pueden parecer bien hasta que de repente no lo son. El rendimiento solo comienza a recuperarse una vez que los datos de entrenamiento son más de la mitad correctos; incluso entonces, la mayoría de los modelos todavía no alcanzan el nivel del modelo base.
Aquel modelo base, en este caso GPT-4o sin afinación adicional, resultó ser el más confiable en general, manteniéndose seguro y preciso en tareas financieras, de salud y legales, donde mostró casi ningún comportamiento peligroso.

Del apéndice del artículo, una selección muy pequeña de múltiples ejemplos que ilustran resultados de inferencia problemáticos a diversos niveles de datos malos en escenarios de afinación.
Conclusión
La curación de datos es agotadora y costosa; a menudo, incontrolablemente costosa. En cierta medida, las empresas y los individuos a menudo consideran tácitamente que es más fácil y barato trabajar alrededor de los bordes ásperos de un modelo entrenado con datos poco curados que considerar darle a los datos la atención que realmente necesitan.
El problema central está definido por la necesidad de escala y la imprevisibilidad de los datos atípicos; si no fuera por la necesidad de grandes volúmenes de datos, con el fin de cubrir el número máximo de escenarios, sería posible utilizar técnicas de curación manual con más frecuencia como datos de entrenamiento en sí mismos, lo que llevaría a técnicas de curación automatizada que realmente funcionen.
En el mundo real, si uno pudiera permitirse tal cantidad enorme de supervisión humana de alta calidad, uno estaría cerca de curar manualmente conjuntos de datos a gran escala en cualquier caso. Tendremos que esperar a nuevas ideas, quizás radicales, sobre este particular dilema. Publicado por primera vez el jueves 25 de septiembre de 2025
Publicado por primera vez el jueves 25 de septiembre de 2025


