
Ángulo de Anderson
Identificando deepfakes de celebridades a partir de regiones faciales externas

 Añade Unite.AI a tus fuentes preferidas en Google
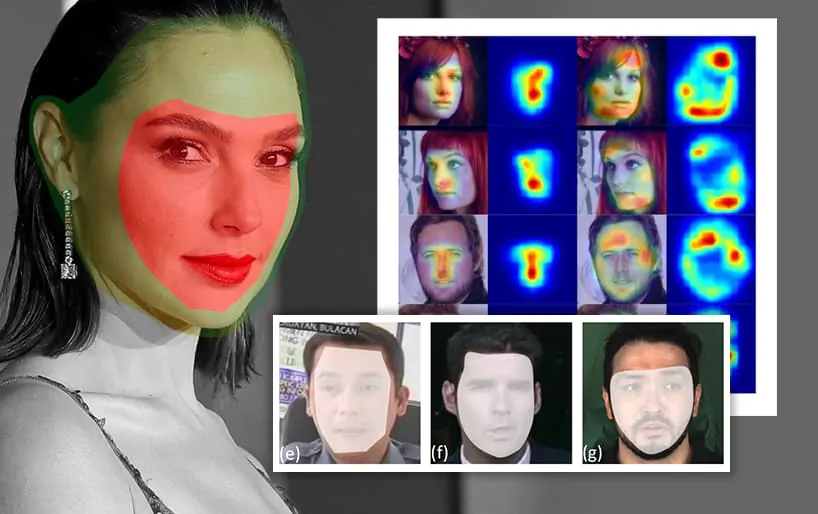
Una nueva colaboración entre Microsoft (MSFT ) y una universidad china ha propuesto una nueva forma de identificar deepfakes de celebridades, aprovechando las limitaciones de las técnicas de deepfake actuales para reconocer identidades que han sido “proyectadas” sobre otras personas.
El enfoque se llama Identity Consistency Transformer (ICT), y funciona comparando las partes externas de la cara (mandíbula, pómulos, línea del cabello y otros contornos marginales externos) con el interior de la cara. El sistema explota los datos de imágenes públicas de personas famosas, que limita su eficacia a celebridades populares, cuyas imágenes están disponibles en grandes cantidades en conjuntos de datos de visión por computadora y en Internet.

La cobertura de falsificación de caras en siete técnicas: DeepFake en FF+; DeepFake en Google DeepFake Detection; DeepFaceLab; Face2Face; FSGAN; y DF-VAE. Paquetes populares como DeepFaceLab y FaceSwap proporcionan una cobertura similarmente limitada. Fuente: https://arxiv.org/pdf/2203.01318.pdf
Como muestra la imagen anterior, los métodos actuales de deepfaking son bastante limitados en cuanto a recursos y dependen de “caras anfitrionas” (la imagen o video de una persona que tendrá su identidad reemplazada por el deepfake) para minimizar la evidencia de sustitución de cara.
Aunque los métodos variables pueden abarcar la frente completa y una gran parte de las áreas de los pómulos y la mandíbula, todos están más o menos limitados dentro del marco de la cara anfitriona.

Un mapa de saliencia que enfatiza las identidades ‘interior’ y ‘exterior’ calculadas por ICT. Donde se establece una coincidencia facial interior pero no se corresponde con la identidad exterior, ICT evalúa la imagen como falsa.
En pruebas, ICT demostró ser capaz de detectar contenido de deepfake en entornos de video de baja resolución, donde el contenido del video completo se degrada por artefactos de compresión, lo que ayuda a ocultar la evidencia residual del proceso de deepfake – una circunstancia que confunde a muchos métodos de detección de deepfake competidores.

ICT supera a los competidores en el reconocimiento de contenido de deepfake. Vea el video incrustado al final del artículo para más ejemplos y mejor resolución. Vea el video de fuente incrustado al final del artículo para más ejemplos. Fuente: https://www.youtube.com/watch?v=zgF50dcymj8
El artículo se titula Protegiendo a las celebridades con Identity Consistency Transformer, y proviene de nueve investigadores afiliados a la Universidad de Ciencia y Tecnología de China, Microsoft Research Asia y Microsoft Cloud + AI.
La brecha de credibilidad
Hay al menos un par de razones por las que los algoritmos de intercambio de caras populares como DeepFaceLab y FaceSwap descuidan el área más externa de las identidades faciales intercambiadas.
En primer lugar, entrenar modelos de deepfake es tiempo-consumidor y crítico en cuanto a recursos, y la adopción de “caras anfitrionas” compatibles libera ciclos de GPU y épocas para concentrarse en las áreas relativamente inmutables del interior de la cara que usamos para distinguir la identidad (ya que variables como la fluctuación de peso y el envejecimiento son las menos propensas a cambiar estos rasgos faciales básicos en el corto plazo).
En segundo lugar, la mayoría de los enfoques de deepfake (y esto es ciertamente el caso con DeepFaceLab, el software utilizado por los practicantes más populares o notorios) tienen una capacidad limitada para replicar los “márgenes finales” de la cara, como las áreas de los pómulos y la mandíbula, y están limitados por el hecho de que su código upstream (2017) no abordó extensivamente este problema.
En los casos en que las identidades no coinciden bien, el algoritmo de deepfake debe “pintar” áreas de fondo alrededor de la cara, lo que hace de manera torpe incluso en las manos de los mejores deepfakers, como Ctrl Shift Face, cuyo contenido se utilizó en los estudios del artículo.

Lo mejor de lo mejor: fotogramas de un video de deepfake de la aclamada deepfaker Ctrl-Shift-Face, intercambiando a Jim Carrey sobre Gary Oldman. Este trabajo representa probablemente algunos de los mejores resultados actuales disponibles a través de DeepFaceLab y técnicas de post-procesamiento. Sin embargo, los intercambios siguen limitados a la atención relativamente escasa que DFL presta a la cara exterior, lo que requiere un esfuerzo hercúleo de curación de datos y entrenamiento para abordar los contornos más externos. Fuente: https://www.youtube.com/watch?v=x8igrh1eyLk
Esta “astucia” o desviación de la atención en gran medida escapa a la atención pública en la actual preocupación por el creciente realismo de los deepfakes, porque nuestras facultades críticas sobre los deepfakes aún están en desarrollo más allá de la etapa de “shock y asombro”.
Identidades divididas
El nuevo artículo señala que la mayoría de los métodos anteriores de detección de deepfake se basan en artefactos que delatan el proceso de intercambio, como posiciones de cabeza inconsistentes y parpadeo, entre numerosas otras técnicas. Solo esta semana, otro nuevo artículo de detección de deepfake ha propuesto utilizar la “firma” de los diferentes tipos de modelos en el marco de FaceSwap para ayudar a identificar videos falsificados creados con él (ver imagen a continuación).

Identificando deepfakes caracterizando las firmas de los diferentes tipos de modelos en el marco de FaceSwap. Fuente: https://arxiv.org/pdf/2202.12951.pdf
Por contraste, la arquitectura de ICT crea dos identidades anidadas separadas para una persona, cada una de las cuales debe ser verificada antes de que se concluya que la identidad completa es “verdadera” o falsa.

Arquitectura para las fases de entrenamiento y prueba de ICT.
La división de identidades se facilita mediante un Transformer de visión, que realiza la identificación facial antes de dividir las regiones examinadas en tokens que pertenecen a las identidades interior o exterior.

Distribuyendo parches entre los dos significadores de identidad paralelos.
El artículo establece:
‘Desafortunadamente, los métodos de verificación de caras existentes tienden a caracterizar la región más discriminativa, es decir, la cara interior para la verificación y no capturan la información de identidad en la cara exterior. Con Identity Consistency Transformer, entrenamos un modelo para aprender un par de vectores de identidad, uno para la cara interior y otro para la cara exterior, diseñando un Transformer tal que las identidades interior y exterior puedan aprenderse simultáneamente en un modelo unificado.’
Dado que no existe un modelo existente para este protocolo de identificación, los autores han ideado una nueva clase de pérdida de consistencia que puede actuar como una métrica de autenticidad. Los “tokens internos” y “tokens externos” que resultan del modelo de extracción de identidad se agregan a los incrustaciones de parches producidos por marcos de identificación facial.
Datos y entrenamiento
La red ICT se entrenó en el conjunto de datos MS-Celeb-1M de Microsoft Research, que contiene 10 millones de imágenes de caras de celebridades que cubren un millón de identidades, incluyendo actores, políticos y muchos otros tipos de figuras prominentes. Según el procedimiento del método anterior Face X-ray (otra iniciativa de Microsoft Research), la rutina de generación de deepfakes de ICT intercambia regiones internas y externas de caras del conjunto de datos para crear material sobre el que probar el algoritmo.
Para realizar estos intercambios internos, ICT identifica dos imágenes en el conjunto de datos que exhiben posiciones de cabeza y rasgos faciales similares, genera una región de máscara de las características centrales (en la que se puede realizar un intercambio) y realiza un intercambio de deepfake con corrección de color RGB.
La razón por la que ICT se limita a la identificación de celebridades es que depende (en su variación más efectiva) de un conjunto de referencia novel que incorpora vectores faciales derivados de un corpus central (en este caso MS-Celeb-1M, aunque la referencia podría extenderse a la imagen de red disponible, lo que solo probablemente existiría en calidad y cantidad suficientes para figuras públicas bien conocidas).
Estos pares de vectores derivados actúan como tokens de autenticidad para verificar las regiones de la cara interior y exterior en conjunto.
Los autores señalan que los tokens obtenidos de estos métodos representan “características de alto nivel”, lo que resulta en un proceso de detección de deepfake que es más probable que sobreviva en entornos desafiantes, como video de baja resolución o degradado de otra manera.
Crucialmente, ICT no busca evidencia basada en artefactos, sino que se centra en métodos de verificación de identidad más acordes con técnicas de reconocimiento facial – un enfoque que es difícil con datos de bajo volumen, como es el caso de la investigación de incidentes de deepfake revenge porn contra objetivos no famosos.
Pruebas
Entrenado en MS-Celeb-1M, ICT se dividió en versiones asistidas por referencia y “ciegas” del algoritmo, y se probó contra una serie de conjuntos de datos y métodos competidores. Estos incluyeron FaceForensics++ (FF++), un conjunto de datos de 1000 videos auténticos y de deepfake creados a través de cuatro métodos, incluyendo Face2Face y FaceSwap; la detección de deepfake de Google Deepfake Detection (DFD), que también consta de miles de videos de deepfake generados por Google; Celeb-DeepFake v1 (CD1), que cuenta con 408 videos reales y 795 sintetizados de baja artifacto; Celeb-DeepFake v2, una extensión de V1 que contiene 590 videos reales y 5,639 falsos; y el conjunto de datos Deeper-Forensics (Deeper) de China de 2020.
Esos son los conjuntos de datos; los métodos de detección en los desafíos de prueba fueron Multi-task, MesoInc4, Capsule, Xception-c0, c2 (un método empleado en FF++), FWA/DSP-FW de la Universidad de Albany, Two-Branch, PCL+I2G, y el método de discrepancia de contexto de Yuval Nirkin.
Los métodos de detección mencionados anteriormente están dirigidos a detectar tipos específicos de manipulación facial. Además de estos, los autores del nuevo artículo probaron ofertas de detección de deepfake más generales Face X-ray, FFD de la Universidad Estatal de Michigan, CNNDetection y Patch-Forensics de MIT CSAIL.
El resultado más evidente de la prueba es que los métodos competidores disminuyen drásticamente en eficacia a medida que la resolución y la calidad del video disminuyen. Dado que algunas de las posibles consecuencias más graves de la penetración de los deepfakes en nuestros poderes discriminatorios se encuentran (no menos en este momento) en video no HD o degradado de otra manera, esto parece ser un resultado significativo.

En el gráfico de resultados anterior, las líneas azul y roja indican la resistencia de los métodos de ICT a la degradación de la imagen en todas las áreas excepto el obstáculo del ruido gaussiano (no una probabilidad en footage de Zoom y webcam), mientras que la confiabilidad de los métodos competidores disminuye.
En la tabla de resultados a continuación, vemos la eficacia de los diferentes métodos de detección de deepfake en los conjuntos de datos no vistos. Los resultados gris y asteriscados indican comparaciones de resultados publicados originalmente en proyectos de código cerrado, que no pueden verificarse externamente. En la mayoría de los marcos comparables, ICT supera a los enfoques de detección de deepfake rivales (que se muestran en negrita) en los conjuntos de datos probados.

Como prueba adicional, los autores ejecutaron contenido del canal de YouTube del aclamado deepfaker Ctrl Shift Face, y encontraron que los métodos competidores lograron puntajes de identificación notablemente inferiores:

Es notable que los métodos de FF++ (Xception-c23) y FFD, que logran algunos de los puntajes más altos en algunos de los datos de prueba en las pruebas generales del nuevo artículo, aquí logran un puntaje mucho más bajo que ICT en un contexto “real” de contenido de deepfake de alto esfuerzo.
Los autores concluyen el artículo con la esperanza de que sus resultados orienten a la comunidad de detección de deepfake hacia iniciativas similares que se centren en características de alto nivel más fáciles de generalizar, y alejarse de la “guerra fría” de la detección de artefactos, en la que los últimos métodos son rutinariamente obviados por desarrollos en marcos de deepfake, o por otros factores que hacen que estos métodos sean menos resilientes.
Consulte el video complementario que acompaña a continuación para más ejemplos de ICT que identifican contenido de deepfake que a menudo supera a los métodos alternativos.
Publicado por primera vez el 4 de marzo de 2022.


