
Fundamentos de la IA
¿Cómo funciona la clasificación de imágenes?

 Añade Unite.AI a tus fuentes preferidas en Google
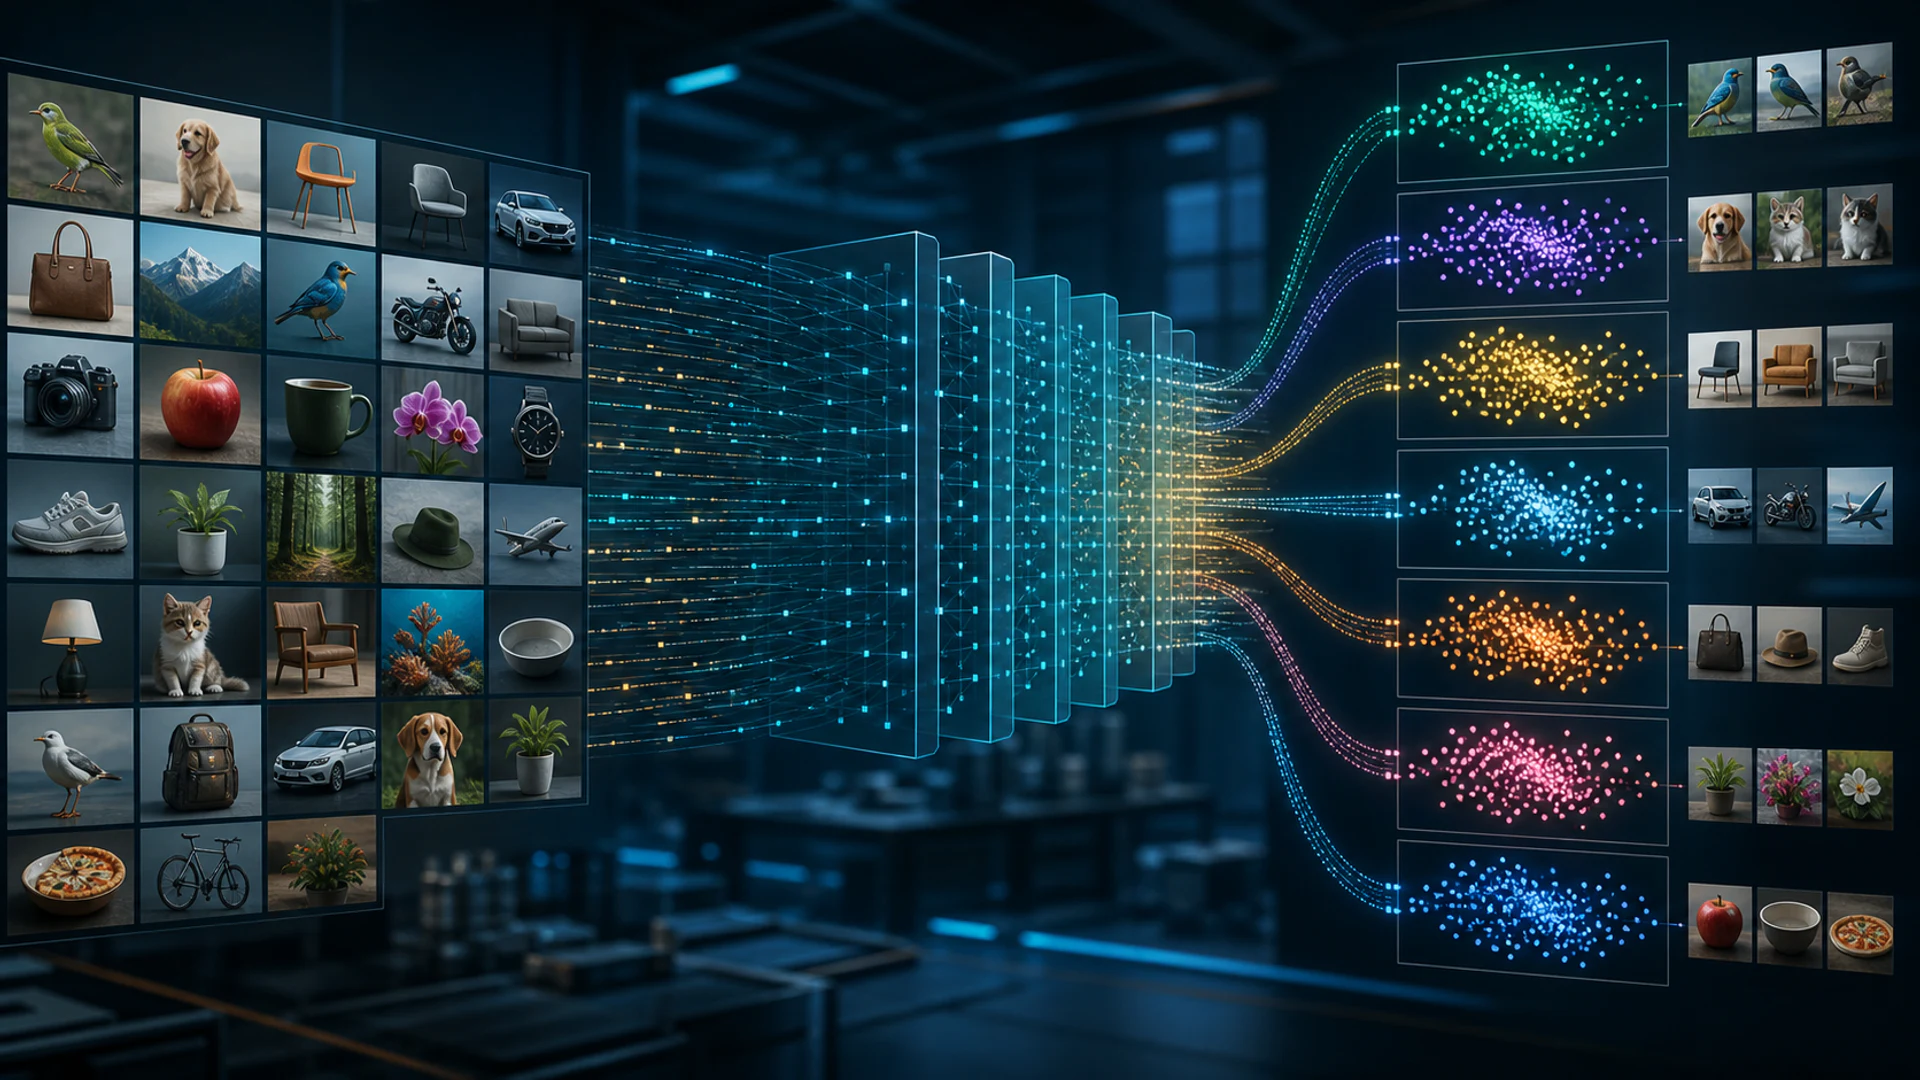
La clasificación de imágenes predice una etiqueta para una imagen completa. Responde preguntas como “¿Qué categoría de producto se muestra?” o “¿Este escaneo contiene el hallazgo objetivo?”. No localiza cada objeto ni delimita sus píxeles.
Los sistemas modernos suelen usar redes neuronales convolucionales o vision transformers, a menudo inicializados con pesos preentrenados. Un rendimiento fiable sigue dependiendo de las etiquetas, el muestreo, la augmentación, la calibración y las pruebas bajo condiciones reales de despliegue.
Conclusiones clave
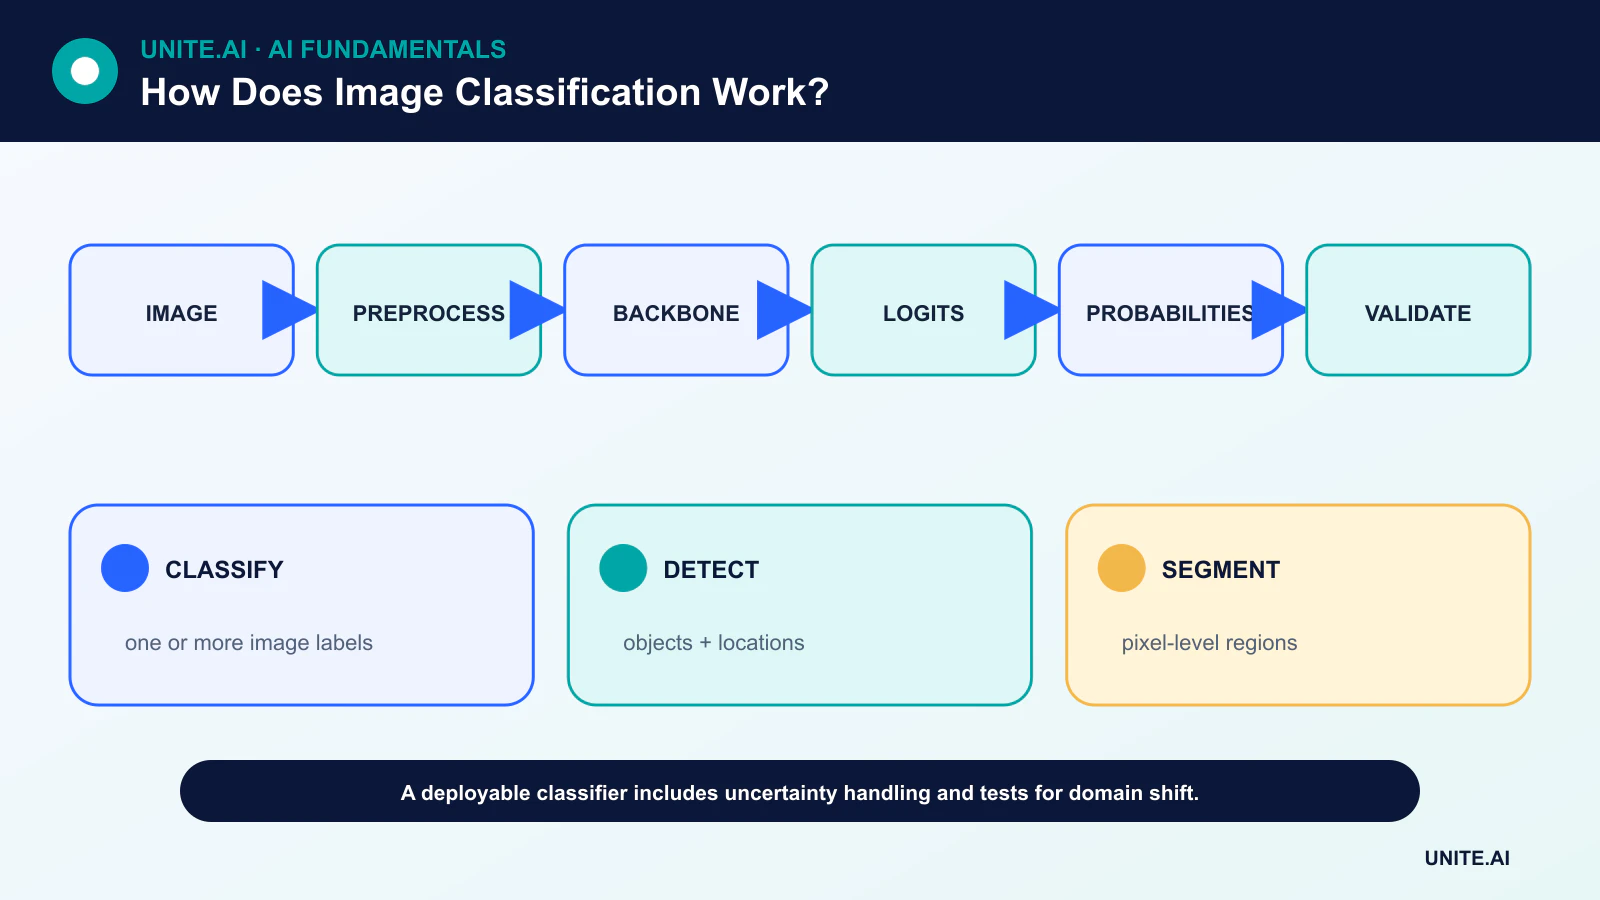
- La clasificación etiqueta la imagen completa; la detección dibuja cajas de objetos y la segmentación asigna regiones a nivel de píxel.
- El preentrenamiento y el aprendizaje por transferencia pueden reducir los requisitos de datos, pero una discordancia de dominio puede anular el beneficio.
- Una alta precisión global puede ocultar desequilibrio de clases, atajos espurios y mala calibración.
- La calidad de la imagen, el dispositivo de captura, la geografía y los cambios en el flujo de trabajo pueden crear desplazamiento de distribución.
De píxeles a puntuaciones
Las imágenes se redimensionan o recortan, se normalizan y se convierten en tensores. La augmentación de datos puede aplicar transformaciones que preservan la etiqueta, como volteos, recortes o cambios de color. Un backbone transforma los píxeles en características; una cabeza de clasificación genera logits que se convierten en puntuaciones de clase relativas.
El preprocesamiento elegido debe coincidir con el despliegue. Un recorte central que elimine el objeto relevante o una descoordinación en la normalización pueden perjudicar el rendimiento aun cuando los pesos entrenados permanezcan sin cambios.
CNNs y vision transformers
Las redes neuronales convolucionales usan filtros locales y pesos compartidos para construir características espaciales. Las conexiones residuales facilitaron la optimización de CNN muy profundas. Los vision transformers dividen una imagen en parches y emplean atención para modelar relaciones entre ellos.
Las comparaciones de arquitectura deben controlar los datos de entrenamiento, la augmentación, el cómputo y la resolución. El mejor modelo en un benchmark público puede no ser el más adecuado para un dispositivo de borde, un conjunto de datos pequeño o un requisito de explicabilidad.
Aprendizaje por transferencia y diseño de datos
El aprendizaje por transferencia parte de pesos entrenados en un conjunto de datos fuente mayor. Un equipo puede congelar el backbone, afinar capas posteriores o actualizar todo el modelo. El afinamiento suele requerir una tasa de aprendizaje menor y un conjunto de validación a prueba de fugas.
Las etiquetas deben describir lo que es visible e inferible. Si un diagnóstico depende del historial del paciente que no está presente en la imagen, el clasificador no podrá aprender la decisión clínica completa. Duplicados, fotogramas de un mismo video e imágenes del mismo sujeto deben permanecer en la misma partición.
Métricas, incertidumbre y atajos
La precisión top‑1 exige que la clase con mayor puntuación sea la correcta; la precisión top‑k acepta que la clase correcta esté entre las k puntuaciones más altas. La precisión, exhaustividad y una matriz de confusión por clase revelan errores desiguales.
Los modelos pueden explotar fondos, marcas de agua, equipos de adquisición o encuadres en lugar del objeto deseado. Pruebas contrafactuales, análisis de subgrupos y herramientas de saliencia pueden ayudar a descubrir atajos, pero un mapa de calor explicativo no constituye prueba de razonamiento causal.
Monitoreo del despliegue
Las verificaciones en producción deben cubrir archivos corruptos, dimensiones inesperadas, desenfoque, iluminación, modelos de cámara y nuevas clases. La confianza debe calibrarse con datos similares al despliegue, y las entradas fuera del alcance deben rechazarse o revisarse.
Monitorear etiquetas retrasadas y cambios en el costo de error es esencial. Un modelo que parece estable según las estadísticas de entrada aún puede fallar si la relación entre píxeles y etiquetas cambia.
Construcción de un conjunto de datos para clasificación de imágenes
La clasificación de imágenes asigna una o más etiquetas a una imagen completa. Difiere de la detección, que localiza objetos, y de la segmentación, que etiqueta píxeles. Defina el alcance de clases, la jerarquía, reglas multietiqueta, categorías de fondo o desconocidas, y qué evidencia debe ser visible. Recoja cámaras representativas del despliegue, ubicaciones, iluminación, puntos de vista, distancias y sujetos. Realice la división por sujeto, escena, sesión o fuente antes de la augmentación; fotogramas adyacentes de video o imágenes de producto duplicadas entre particiones provocan graves fugas.
Las instrucciones de anotación deben cubrir oclusión, objetos ambiguos, múltiples clases, baja calidad y abstención. Mida el acuerdo y revise discrepancias sistemáticas. El equilibrio de clases por sí solo no garantiza cobertura: una clase de enfermedad puede incluir solo un dispositivo o una clase de fauna solo un fondo. Inspeccione metadatos y casi duplicados, y mantenga un conjunto de prueba protegido proveniente de adquisiciones independientes. Los datos sintéticos y el raspado web pueden ampliar la variedad pero introducen problemas de licencias, procedencia, estilo y etiquetas que deben medirse en imágenes reales.
Modelos, entrenamiento y evaluación
Los métodos clásicos combinan descriptores diseñados con un clasificador; los sistemas modernos usan redes convolucionales o vision transformers, a menudo mediante aprendizaje por transferencia. Las decisiones de redimensionado y recorte determinan qué información sobrevive. La augmentación debe reflejar variaciones válidas y preservar las etiquetas. Optimice una pérdida adecuada a la tarea, maneje el desequilibrio mediante ponderación o muestreo cuidadoso, y seleccione puntos de control basándose en los datos de validación. Compare con una línea base simple y ablate augmentación, resolución e inicialización preentrenada para averiguar de dónde provienen las ganancias.
Informe precisión, exhaustividad y F1 por clase, matriz de confusión, precisión top‑k cuando sea pertinente, calibración y rendimiento por condición. Pruebe desenfoque, compresión, iluminación, recorte, oclusión, dispositivo e insumos sin clase soportada. Los umbrales de confianza pueden redirigir casos inciertos a revisión; la probabilidad softmax no garantiza confianza, sobre todo bajo desplazamiento. Pruebas contrafactuales de fondos y oclusión revelan aprendizaje de atajos. Para usos relacionados con seguridad, evalúe fallos en el peor caso y las consecuencias de falsos positivos y negativos.
Despliegue y monitoreo
Empaquete decodificación, conversión de color, orientación, normalización, modelo y mapa de etiquetas juntos. Valide el artefacto exportado o cuantizado en los dispositivos objetivo y mida latencia de extremo a extremo, memoria, consumo energético y rendimiento. Monitoree la calidad de la imagen, distribuciones de entrada y salida, calibración, etiquetas confirmadas y salud de los sensores. Minimice y asegure la retención de imágenes, especialmente de rostros, ubicaciones y transeúntes. Proporcione un plan de contingencia para insumos corruptos o fuera del alcance y retroceda versiones del modelo. La clasificación responde a la pregunta definida a nivel de imagen; no debe forzarse a reclamaciones no soportadas de localización, identidad o intención.
Ejemplo práctico: clasificación de materiales reciclables
Una instalación fotografía artículos en una cinta transportadora y etiqueta la clase de material, contaminación y desconocido. Las imágenes se dividen por día de recolección y lote de objetos, cubriendo iluminación, superficies húmedas, arrugado, superposición y cintas vacías. Se comparan una pequeña CNN y un modelo preentrenado con reglas de color y forma. La exhaustividad por clase, errores de clasificación, calibración, rendimiento y resultados por cámara y condición del material guían la selección.
La cadena de producción verifica la exposición de la cámara y el sincronismo de la cinta, luego envía los ítems inciertos a un flujo general en lugar de forzar una clase. La inferencia cuantizada se valida en el hardware exacto. El monitoreo rastrea calidad de entrada, tasas de clase, rechazos y auditorías manuales muestreadas; un nuevo empaque desencadena una actualización revisada de datos. El modelo controla un separador limitado con guardas físicas, y una falla del sensor o del modelo devuelve el mecanismo a un estado seguro en lugar de desviar silenciosamente el material.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, desplazamiento de distribución, fallos de dependencias, usos indebidos y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retroceso y retiro. Use un despliegue escalonado, preserve una alternativa segura y verifique el monitoreo con fallos inyectados deliberadamente. La telemetría operativa debe revelar calidad de entrada, comportamiento de salida, versión del modelo o regla, salud de dependencias, intervenciones humanas y resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalúe siempre que cambien fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Puede un clasificador de imágenes identificar varios objetos?
Un clasificador multietiqueta puede indicar qué categorías están presentes, pero no localiza instancias individuales. Se necesita detección de objetos para obtener cajas o recuentos.
¿Por qué un modelo puede fallar en fotos que a una persona le parecen normales?
Puede depender de artefactos de captura, texturas o correlaciones que cambiaron. Pequeñas diferencias en el preprocesamiento y el desplazamiento de dominio también pueden afectar las características aprendidas.
Referencias principales












