
Η γωνία του Anderson
UniTune: Η εναλλακτική τεχνική νευρωνικής επεξεργασίας εικόνων της Google

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
Βασικά σημείαΤο UniTune κάνει fine-tuning σε ένα μοντέλο διάχυσης σε μία μόνο εικόνα για να…
Δείτε περισσότερα
- Το UniTune κάνει fine-tuning σε ένα μοντέλο διάχυσης σε μία μόνο εικόνα για να επιτρέψει ακριβείς επεξεργασίες που καθοδηγούνται από κείμενο.
- Σε αντίθεση με το DreamBooth ή το Textual Inversion, το UniTune απορρίπτει και τις δύο προσεγγίσεις για καλύτερη διατήρηση λεπτομερειών.
- Η μέθοδος επιτυγχάνει υψηλή σημασιολογική αποσύνδεση, διατηρώντας τα πρόσωπα ανέπαφα κατά τη διάρκεια ριζικών μετασχηματισμών του φόντου.
Η ερευνητική ομάδα του Google, φαίνεται, επιτίθεται στην επεξεργασία εικόνων με βάση κείμενο από πολλές πλευρές και, προφανώς, περιμένει να δει τι θα «πιάσει». Αμέσως μετά την κυκλοφορία αυτή την εβδομάδα της εργασίας Imagic, η εταιρεία πρότεινε μια επιπλέον μέθοδο βασισμένη στη λανθάνουσα διάχυση, για αλλαγές εικόνων μέσω εντολών κειμένου που διαφορετικά θα ήταν αδύνατες, αυτή τη φορά με το όνομα UniTune.
Βάσει των παραδειγμάτων που παρουσιάζονται στη νέα εργασία, το UniTune έχει επιτύχει ένα εξαιρετικό βαθμό αποσύνδεσης της σημασιολογικής στάσης και ιδέας από το πραγματικό περιεχόμενο της εικόνας:

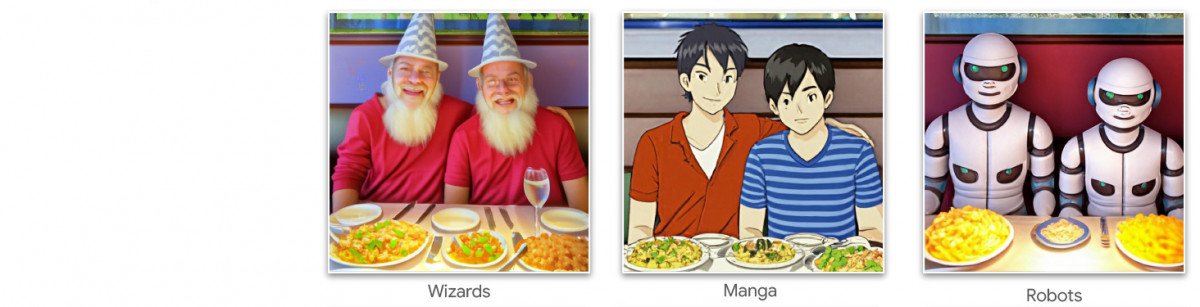

Το UniTune έχει εξαιρετική ικανότητα σημασιολογικής σύνθεσης. Παρατηρήστε πώς στην πρώτη σειρά εικόνων, τα πρόσωπα των δύο ατόμων δεν έχουν διαστρεβλωθεί από την εξαιρετική μεταμόρφωση της υπόλοιπης εικόνας (δεξιά). Πηγή: https://arxiv.org/pdf/2210.09477.pdf
Όπως θα έχουν μάθει οι οπαδοί του Stable Diffusion, η εφαρμογή αλλαγών σε τμήματα μιας εικόνας χωρίς να επηρεάσει αρνητικά το υπόλοιπο της εικόνας μπορεί να είναι μια δύσκολη, μερικές φορές αδύνατη, λειτουργία. Αν και δημοφιλείς διανομές όπως το AUTOMATIC1111 μπορούν να δημιουργήσουν μάσκες για τοπικές και περιορισμένες επεξεργασίες, η διαδικασία είναι πολύπλοκη και συχνά απρόβλεπτη.
Η προφανής απάντηση, τουλάχιστον για έναν ειδικό στην επεξεργασία εικόνων, είναι να τοποθετήσει ένα επίπεδο σημασιολογικής κατάτμησης που μπορεί να αναγνωρίσει και να απομονώσει αντικείμενα σε μια εικόνα χωρίς παρέμβαση του χρήστη, και πράγματι, υπάρχουν πολλές νέες πρωτοβουλίες τελευταία σε αυτή τη γραμμή σκέψης.
Μια άλλη δυνατότητα για τον περιορισμό των ακατάστατων και αλληλένδετων νευρωνικών λειτουργιών επεξεργασίας εικόνων είναι να αξιοποιήσει τη μονάδα Contrastive Language–Image Pre-training (CLIP) της OpenAI, το οποίο είναι στο κέντρο των μοντέλων διαχύσεως όπως το DALL-E 2 και το Stable Diffusion, για να ενεργεί ως φίλτρο στο σημείο όπου ένα μοντέλο κειμένου-εικόνας είναι έτοιμο να στείλει μια ερμηνευμένη απόδοση πίσω στο χρήστη. Σε αυτό το πλαίσιο, το CLIP θα πρέπει να ενεργεί ως φύλακας και μονάδα ελέγχου ποιότητας, απορρίπτοντας ελαττωματικές ή ακατάλληλες αποδώσεις. Αυτό πρόκειται να εφαρμοστεί (σύνδεσμος Discord) στην πύλη API-driven του DreamStudio.
Ωστόσο, επειδή το CLIP είναι ουσιαστικά και ο ένοχος και η λύση σε ένα τέτοιο σενάριο (επειδή ενημέρωσε ουσιαστικά τον τρόπο με τον οποίο εξελίχθηκε η εικόνα), και επειδή οι απαιτήσεις υλικού μπορεί να υπερβούν αυτά που είναι πιθανό να είναι διαθέσιμα τοπικά σε έναν τελικό χρήστη, αυτή η προσέγγιση μπορεί να μην είναι ιδανική.
Συμπιεσμένη Γλώσσα
Το προτεινόμενο UniTune «βελτιώνει» ένα υπάρχον μοντέλο διαχύσεως – σε αυτή την περίπτωση, το Imagen της Google, αν και οι ερευνητές δηλώνουν ότι η μέθοδος είναι συμβατή με άλλες αρχιτεκτονικές διαχύσεως – ώστε να εισάγεται ένα μοναδικό token που μπορεί να κληθεί με την συμπερίληψή του σε μια εντολή κειμένου.
Εξωτερικά, αυτό ακούγεται σαν το DreamBooth της Google, το οποίο μπορεί να εισάγει νέα αντικείμενα ή χαρακτήρες σε ένα υπάρχον σημείο, συχνά σε λιγότερο από μια ώρα, με βάση μόνο λίγες αρχικές εικόνες· ή σαν την Textual Inversion, η οποία δημιουργεί συνοδευτικά αρχεία «sidecar» για ένα σημείο, τα οποία αντιμετωπίζονται ως αν είχαν εκπαιδευτεί αρχικά στο μοντέλο, και μπορούν να επωφεληθούν από τους πόρους του μοντέλου, τροποποιώντας τον ταξινομητή κειμένου, με αποτέλεσμα ένα μικρό αρχείο (σε σύγκριση με τα ελάχιστα 2GB των περικομμένων σημείων ελέγχου του DreamBooth).
Στην πραγματικότητα, οι ερευνητές δηλώνουν ότι το UniTune απέρριψε αυτές τις προσεγγίσεις. Βρήκαν ότι η Textual Inversion παρέλειψε πολλές σημαντικές λεπτομέρειες, ενώ το DreamBooth «απέδωσε χειρότερα και χρειάστηκε περισσότερο χρόνο» από τη λύση που τελικά επέλεξαν.
Παρόλα αυτά, το UniTune χρησιμοποιεί την ίδια ενθυλακωμένη σημασιολογική «μετα-πρόταση» προσέγγιση με το DreamBooth, με εκπαιδευμένες αλλαγές που ενεργοποιούνται από μοναδικές λέξεις επιλεγμένες από τον εκπαιδευτή, χωρίς σύγκρουση με όρους που υπάρχουν ήδη σε ένα δημόσιο μοντέλο που εκπαιδεύτηκε με κόπο.
QUOTEOPEN«Για να εκτελέσουμε την λειτουργία επεξεργασίας, δειγματίζουμε τα βελτιωμένα μοντέλα με την εντολή “[rare_tokens] edit_prompt” (π.χ. “beikkpic δύο σκύλους σε ένα εστιατόριο” ή “beikkpic ένα minion”).»QUOTECLOSE
Η Διαδικασία
Αν και είναι μυστήριο γιατί δύο σχεδόν πανομοιότυπες εργασίες, σε όρους τελικής λειτουργικότητας, θα φτάσουν από την Google την ίδια εβδομάδα, υπάρχει, παρά την τεράστια ομοιότητα μεταξύ των δύο πρωτοβουλιών, τουλάχιστον μια σαφής διαφορά μεταξύ του UniTune και του Imagic – το τελευταίο χρησιμοποιεί «ασυμπίεστες» εντολές φυσικής γλώσσας για να οδηγήσει τις λειτουργίες επεξεργασίας εικόνων, ενώ το UniTune εκπαιδεύει μοναδικά tokens στο στυλ του DreamBooth.
Εάν θέλατε να επεξεργαστείτε με το Imagic και να εφαρμόσετε μια μεταμόρφωση αυτού του είδους…

Από την εργασία του UniTune – Το UniTune τοποθετείται ενάντια στο αγαπημένο αντίπαλο πλαίσιο επεξεργασίας εικόνων της Google, SDEdit. Τα αποτελέσματα του UniTune βρίσκονται στην πιο δεξιά πλευρά, ενώ η εκτιμώμενη μάσκα φαίνεται στη δεύτερη εικόνα από τα αριστερά.
.. στην Imagic, θα εισαγάγατε «το τρίτο πρόσωπο, καθισμένο στο βάθος, ως ένα χαριτωμένο τριχωτό τέρας».
Η αντίστοιχη εντολή του UniTune θα ήταν «Ο άνθρωπος στο βάθος ως [x]», όπου x είναι η όποια παράξενη και μοναδική λέξη ήταν δεσμευμένο με την εκπαιδευμένη έννοια που σχετίζεται με το χαρακτήρα του χαριτωμένου τριχωτού τέρατος.
Ενώ πολλές εικόνες εισάγονται είτε στο DreamBooth είτε στην Textual Inversion με σκοπό να δημιουργηθεί μια αφαίρεση τύπου deepfake που μπορεί να ενεργοποιηθεί σε πολλές στάσεις, και το UniTune και το Imagic εισάγουν μία μόνο εικόνα στο σύστημα – την αρχική, αγνή εικόνα.
Αυτό είναι παρόμοιο με τον τρόπο που λειτουργούν πολλά εργαλεία επεξεργασίας εικόνων με βάση GAN τα τελευταία χρόνια – μετατρέποντας μια είσοδο εικόνας σε λανθάνοντες κωδικούς στον λανθάνοντα χώρο του GAN και στη συνέχεια διευθύνοντας αυτούς τους κωδικούς και στέλνοντάς τους σε άλλες περιοχές του χώρου για τροποποίηση (π.χ. εισαγωγή μιας εικόνας ενός νέου με μαύρα μαλλιά και προβολή της μέσω κωδικών που σχετίζονται με «ηλικιωμένο» ή «ξανθό», κ.λπ.).
Ωστόσο, τα αποτελέσματα, σε ένα μοντέλο διαχύσεως και με αυτή τη μέθοδο, είναι εξαιρετικά ακριβή σε σύγκριση και πολύ λιγότερο αμφίβολα:
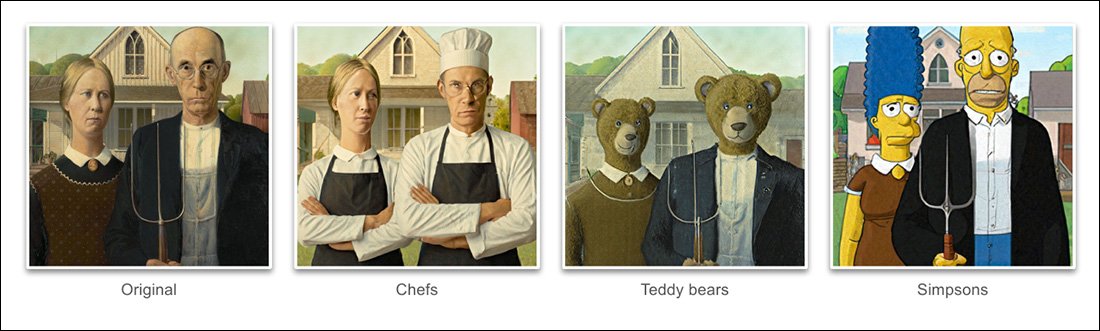
Η Διαδικασία Βελτίωσης
Η μέθοδος του UniTune στέλνει την αρχική εικόνα μέσω ενός μοντέλου διαχύσεως με ένα σύνολο οδηγιών για το πώς πρέπει να τροποποιηθεί, χρησιμοποιώντας τα τεράστια αποθέματα διαθέσιμων δεδομένων που έχουν εκπαιδευτεί στο μοντέλο. Στην πραγματικότητα, μπορείτε να κάνετε αυτό τώρα με τη λειτουργία img2img του Stable Diffusion – αλλά όχι χωρίς να παραμορφώσετε ή να αλλάξετε κάποια μέρη της εικόνας που θα προτιμούσατε να διατηρήσετε.
Κατά τη διαδικασία του UniTune, το σύστημα ρυθμίζεται λεπτομερώς, δηλαδή το UniTune αναγκάζει το μοντέλο να συνεχίσει την εκπαίδευση, με τα περισσότερα από τα επίπεδά του αποδεσμευμένα για εκπαίδευση (δείτε παρακάτω). Στις περισσότερες περιπτώσεις, η λεπτομερής ρύθμιση θα μειώσει τις συνολικές γενικές τιμές απώλειας ενός υψηλής απόδοσης μοντέλου που αποκτήθηκε με κόπο, υπέρ της εισαγωγής ή βελτίωσης κάποιας άλλης επιθυμητής πτυχής.
Ωστόσο, με το UniTune, φαίνεται ότι το αντίγραφο του μοντέλου που επηρεάζεται, αν και μπορεί να ζυγίζει αρκετά γιγαμπάιτ ή περισσότερα, θα αντιμετωπίζεται ως ένα απορρίπσιμο «κάλυμμα» και θα απορρίπτεται στο τέλος της διαδικασίας, έχοντας εξυπηρετήσει ένα μόνο σκοπό. Αυτό το είδος προσωρινής διαχείρισης δεδομένων γίνεται μια καθημερινή κρίση αποθήκευσης για τους οπαδούς του DreamBooth, των οποίων τα μοντέλα, ακόμη και μετά την περικοπή τους, δεν είναι λιγότερα από 2GB ανά αντικείμενο.
Όπως και με το Imagic, η κύρια ρύθμιση στο UniTune συμβαίνει στα δύο χαμηλότερα από τα τρία επίπεδα του Imagen (βασικό 64px, 64px>256px και 256px>1024px). Σε αντίθεση με το Imagic, οι ερευνητές βλέπουν κάποια δυνητική αξία στη βελτίωση της ρύθμισης επίσης για αυτό το τελευταίο και μεγαλύτερο επίπεδο υπερ-ανάλυσης (αν και δεν το έχουν προσπαθήσει ακόμη).
Για το χαμηλότερο επίπεδο 64px, το μοντέλο προσανατολίζεται προς τη βασική εικόνα κατά την εκπαίδευση, με πολλαπλά ζευγάρια εικόνας/κειμένου που εισάγονται στο σύστημα για 128 επαναλήψεις με μέγεθος δείγματος 4, και με Adafactor ως συνάρτηση απώλειας, λειτουργώντας με ρυθμό μάθησης 0,0001. Αν και μόνο ο κωδικοποιητής T5 παραμένει παγωμένος κατά τη διάρκεια της βελτίωσης, είναι επίσης παγωμένος κατά την πρωταρχική εκπαίδευση του Imagen
Η παραπάνω λειτουργία επαναλαμβάνεται για το επίπεδο 64>256px, χρησιμοποιώντας την ίδια διαδικασία αυξήσεως θορύβου που χρησιμοποιήθηκε στην αρχική εκπαίδευση του Imagen.
Δειγματοληψία
Υπάρχουν πολλές πιθανές μεθόδους δειγματοληψίας με τις οποίες μπορούν να εξαχθούν οι αλλαγές από το βελτιωμένο μοντέλο, συμπεριλαμβανομένης της Classifier Free Guidance (CFG), μιας βασικής λειτουργίας του Stable Diffusion. Η CFG ορίζει το βαθμό με τον οποίο το μοντέλο είναι ελεύθερο να «ακολουθήσει την φαντασία του» και να εξερευνήσει τις δυνατότητες απόδοσης – ή, σε χαμηλότερες ρυθμίσεις, τον βαθμό με τον οποίο πρέπει να ακολουθήσει τα δεδομένα εισόδου και να κάνει λιγότερες δραματικές αλλαγές.

Όπως η Textual Inversion (λιγότερο με το DreamBooth), το UniTune μπορεί να εφαρμόσει διαφορετικά γραφικά στυλ στις αρχικές εικόνες, καθώς και πιο φωτορεαλιστικές επεξεργασίες.
Οι ερευνητές πειραματίστηκαν επίσης με την τεχνική «καθυστερημένης έναρξης» του SDEdit, όπου το σύστημα ενθαρρύνεται να διατηρήσει τις αρχικές λεπτομέρειες, αρχίζοντας μόνο μερικώς «θόρυβο» από την αρχή, αλλά διατηρώντας τις βασικές του ιδιότητες. Αν και οι ερευνητές χρησιμοποίησαν αυτή τη τεχνική μόνο στο χαμηλότερο επίπεδο (64px), πιστεύουν ότι θα μπορούσε να είναι μια χρήσιμη τεχνική δειγματοληψίας στο μέλλον.
Οι ερευνητές εκμεταλλεύτηκαν επίσης την τεχνική «προτροπή σε προτροπή» ως μια πρόσθετη κειμενο-βασισμένη τεχνική για να ρυθμίσουν το μοντέλο:
QUOTEOPEN«Στην ρύθμιση “πρόταση σε πρόταση”, βρήκαμε ότι μια τεχνική που ονομάζουμε Οδηγία Πρότασης είναι ιδιαίτερα χρήσιμη για να ρυθμίσει την πιστότητα και την εκφραστικότητα. QUOTECLOSEQUOTEOPEN«Η Οδηγία Πρότασης είναι παρόμοια με την Οδηγία Classifier Free, εκτός από το ότι η βάση είναι μια διαφορετική πρόταση αντί του μοντέλου χωρίς συνθήκη. Αυτή η οδηγία οδηγεί το μοντέλο προς τη διαφορά μεταξύ των δύο προτάσεων.»QUOTECLOSE

Οδηγία πρότασης στο UniTune, που απομονώνει αποτελεσματικά τις περιοχές που πρέπει να αλλάξουν.
Ωστόσο, η οδηγία πρότασης, όπως δηλώνουν οι συγγραφείς, ήταν απαραίτητη μόνο περιστασιακά σε περιπτώσεις όπου η CFG απέτυχε να επιτύχει το επιθυμητό αποτέλεσμα.
Μια άλλη καινοτόμα προσέγγιση δειγματοληψίας που συναντήθηκε κατά την ανάπτυξη του UniTune ήταν η παρεμβολή, όπου οι περιοχές της εικόνας είναι αρκετά διακριτές, ώστε και η αρχική και η τροποποιημένη εικόνα να είναι πολύ παρόμοιες στη σύνθεση, επιτρέποντας μια πιο «αφελή» παρεμβολή.

Η παρεμβολή μπορεί να κάνει τις πιο απαιτητικές διαδικασίες του UniTune περιττές σε περιπτώσεις όπου οι περιοχές που πρέπει να μεταμορφωθούν είναι διακριτές και καλά οριοθετημένες.
Οι συγγραφείς υποστηρίζουν ότι η παρεμβολή θα μπορούσε να λειτουργήσει τόσο καλά, για ένα μεγάλο αριθμό αρχικών εικόνων, που θα μπορούσε να χρησιμοποιηθεί ως προεπιλογή, και παρατηρούν επίσης ότι έχει τη δύναμη να επιτύχει εξαιρετικές μεταμορφώσεις σε περιπτώσεις όπου δεν χρειάζονται να διαπραγματευτούν σύνθετες κάλυψης.
Το UniTune μπορεί να εκτελέσει τοπικές επεξεργασίες με ή χωρίς μάσκες επεξεργασίας, αλλά μπορεί επίσης να αποφασίσει μονομερώς πού να τοποθετήσει τις επεξεργασίες, με έναν ασυνήθιστο συνδυασμό ερμηνευτικής δύναμης και αδιαπραγμάτευτης ουσίας των αρχικών δεδομένων εισόδου:

Στην πρώτη εικόνα της δεύτερης στήλης, το UniTune, που έχει ανατεθεί να εισάγει ένα «κόκκινο τρένο στο βάθος», το έχει τοποθετήσει σε μια κατάλληλη και αυθεντική θέση. Παρατηρήστε σε άλλα παραδείγματα πώς διατηρείται η σημασιολογική ακεραιότητα της αρχικής εικόνας, ακόμη και μέσα σε εξαιρετικές αλλαγές στο περιεχόμενο pixel και τα βασικά στυλ των εικόνων.
Καθυστέρηση
Παρότι η πρώτη εκδοχή ενός νέου συστήματος θα είναι αργή και η συμμετοχή της κοινότητας ή η εταιρική δέσμευση (συνήθως όχι και τα δύο) μπορεί τελικά να επιταχύνει και να βελτιστοποιήσει μια διαδικασία που απαιτεί πολλούς πόρους, τόσο το UniTune όσο και το Imagic εκτελούν αρκετά μεγάλες εργασίες μηχανικής μάθησης για αυτές τις εντυπωσιακές επεξεργασίες. Είναι αμφίβολο πόσο μια τόσο απαιτητική διαδικασία μπορεί να περιοριστεί ώστε να λειτουργεί σε οικιακό εξοπλισμό αντί για πρόσβαση μέσω API, αν και η δεύτερη επιλογή ίσως είναι προτιμότερη για την Google.
Προς το παρόν, η διαδρομή από την είσοδο στο αποτέλεσμα διαρκεί περίπου 3 λεπτά σε GPU T4, με περίπου 30 επιπλέον δευτερόλεπτα για εξαγωγή συμπεράσματος, όπως σε κάθε αντίστοιχη διαδικασία. Οι συγγραφείς παραδέχονται ότι η καθυστέρηση είναι υψηλή και δύσκολα χαρακτηρίζεται «διαδραστική». Ωστόσο, το μοντέλο παραμένει διαθέσιμο για περαιτέρω επεξεργασίες μετά την αρχική ρύθμιση, μέχρι να τελειώσει ο χρήστης, μειώνοντας τον χρόνο ανά επεξεργασία.
Πρώτη δημοσίευση 21ης Οκτωβρίου 2022.


