
Prompt engineering
Κατανόηση της εξειδίκευσης του LLM: Προσαρμόζοντας τα Μεγάλα Γλωσσικά Μοντέλα στις Μοναδικές Απαιτήσεις σας

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google

Βασικά σημείαΗ ρύθμιση-προσαρμογή προσαρμόζει μεγάλα μοντέλα σε συγκεκριμένες εργασίες…
Δείτε περισσότερα
- Η ρύθμιση-προσαρμογή προσαρμόζει μεγάλα μοντέλα σε συγκεκριμένες εργασίες χρησιμοποιώντας πολύ λιγότερα δεδομένα από όσα απαιτήθηκαν για την προ-εκπαίδευση.
- Το QLoRA συνδυάζει την κβαντοποίηση με προσαρμογή χαμηλής τάξης για να μειώσει δραστικά τις απαιτήσεις μνήμης για τη ρύθμιση.
- Η ενισχυτική μάθηση από ανθρώπινες ανατροφοδοτήσεις ευθυγραμμίζει τα αποτελέσματα του μοντέλου με τις αποχρώσεις των ανθρώπινων προτιμήσεων και αξιών.
Καθώς βρισκόμαστε τον Σεπτέμβριο του 2023, το τοπίο των Μεγάλων Γλωσσικών Μοντέλων (LLM) συνεχίζει να μαρτυρά την άνοδο μοντέλων όπως το Alpaca, το Falcon, το Llama 2, το GPT-4 και πολλά άλλα.
Μια σημαντική πτυχή της αξιοποίησης του δυναμικού αυτών των LLMs βρίσκεται στη διαδικασία της εξειδίκευσης, μια στρατηγική που επιτρέπει την προσαρμογή των προ-εκπαιδευμένων μοντέλων για συγκεκριμένες εργασίες με ακρίβεια. Μέσω αυτής της εξειδίκευσης, αυτά τα μοντέλα μπορούν να ευθυγραμμισθούν πραγματικά με τις ατομικές απαιτήσεις, προσφέροντας λύσεις που είναι καινοτόμες και προσαρμοσμένες στις μοναδικές ανάγκες.

Ωστόσο, είναι απαραίτητο να σημειωθεί ότι όχι όλες οι διαδικασίες εξειδίκευσης είναι ισότιμες. Για παράδειγμα, η πρόσβαση στις δυνατότητες εξειδίκευσης του GPT-4 έχει ένα premium, απαιτώντας μια πληρωμένη συνδρομή που είναι σχετικά πιο ακριβή σε σύγκριση με άλλες επιλογές που υπάρχουν στην αγορά. Από την άλλη πλευρά, ο χώρος του ανοικτού κώδικα είναι γεμάτος με εναλλακτικές που προσφέρουν έναν πιο προσιτό δρόμο για την αξιοποίηση της δύναμης των μεγάλων γλωσσικών μοντέλων. Αυτές οι ανοιχτές επιλογές δημοκρατίζουν την πρόσβαση στην προηγμένη τεχνολογία AI, προάγοντας την καινοτομία και την ενσωμάτωση στην ταχέως εξελισσόμενο τοπίο της AI.

Γιατί η εξειδίκευση του LLM είναι σημαντική;
Η εξειδίκευση του LLM είναι περισσότερο από μια τεχνική βελτίωση· είναι ένα κρίσιμο στοιχείο της ανάπτυξης του μοντέλου LLM που επιτρέπει μια πιο συγκεκριμένη και εξειδικευμένη εφαρμογή σε διάφορες εργασίες. Η εξειδίκευση προσαρμόζει τα προ-εκπαιδευμένα μοντέλα για να ταιριάζουν καλύτερα σε συγκεκριμένα σύνολα δεδομένων, βελτιώνοντας την απόδοσή τους σε συγκεκριμένες εργασίες και εξασφαλίζοντας μια πιο στοχευμένη εφαρμογή. Αυτή η ικανότητα των LLM να προσαρμοστούν σε νέα δεδομένα είναι ζωτικής σημασίας στο αυξανόμενο ενδιαφέρον για τις εφαρμογές της τεχνητής νοημοσύνης.
Η εξειδίκευση των μεγάλων γλωσσικών μοντέλων ανοίγει πολλές ευκαιρίες, επιτρέποντάς τους να διακρίνονται σε συγκεκριμένες εργασίες που κυμαίνονται από την ανάλυση συναισθήματος μέχρι τις ανασκοπήσεις της ιατρικής βιβλιογραφίας. Με την προσαρμογή του βασικού μοντέλου σε μια συγκεκριμένη περίπτωση χρήσης, ανοίγουμε νέες δυνατότητες, βελτιώνοντας την αποτελεσματικότητα και την ακρίβεια του μοντέλου. Επιπλέον, διευκολύνει μια πιο οικονομική χρήση των πόρων του συστήματος, επειδή η εξειδίκευση απαιτεί λιγότερη υπολογιστική ισχύ σε σύγκριση με την εκπαίδευση ενός μοντέλου από την αρχή.
Καθώς προχωρούμε σε αυτόν τον οδηγό, θα συζητήσουμε τις λεπτομέρειες της εξειδίκευσης του LLM, δίνοντας σας μια ολοκληρωμένη επισκόπηση που βασίζεται στις τελευταίες προόδους και τις καλύτερες πρακτικές στο πεδίο.
Εξειδίκευση με βάση τις οδηγίες
Η φάση της εξειδίκευσης στον κύκλο ζωής της παραγωγικής τεχνητής νοημοσύνης, που απεικονίζεται στο παρακάτω σχήμα, χαρακτηρίζεται από την ενσωμάτωση εισόδων και εξόδων οδηγιών, σε συνδυασμό με παραδείγματα συλλογισμού βήμα προς βήμα. Αυτή η προσέγγιση διευκολύνει το μοντέλο να παράγει απαντήσεις που δεν είναι μόνο σχετικές αλλά και ακριβώς ευθυγραμμισμένες με τις συγκεκριμένες οδηγίες που εισάγονται σε αυτό. Είναι κατά τη διάρκεια αυτής της φάσης που τα προ-εκπαιδευμένα μοντέλα προσαρμόζονται για να λύσουν διαφορετικές εργασίες και περιπτώσεις χρήσης, χρησιμοποιώντας προσωποποιημένα σύνολα δεδομένων για να βελτιώσουν τη λειτουργικότητά τους.

Κύκλος ζωής παραγωγικής AI — λεπτομερής προσαρμογή
Εξειδίκευση για μια εργασία
Η εξειδίκευση για μια εργασία επικεντρώνεται στην εξειδίκευση του μοντέλου σε μια συγκεκριμένη εργασία, όπως η περίληψη. Αυτή η προσέγγιση είναι ιδιαίτερα ωφέλιμη για την βελτίωση των ροών εργασίας που περιλαμβάνουν εκτενή έγγραφα ή νήματα συζήτησης, συμπεριλαμβανομένων νομικών εγγράφων και αιτημάτων υποστήριξης πελατών. Αξιοσημείωτα, αυτή η εξειδίκευση μπορεί να επιτύχει σημαντικές βελτιώσεις της απόδοσης με ένα σχετικά μικρό σύνολο παραδειγμάτων, που κυμαίνονται από 500 έως 1000, σε αντίθεση με τα δισεκατομμύρια token που χρησιμοποιούνται στη φάση προ-εκπαίδευσης.

Εξειδίκευση για μια εργασία – Παράδειγμα
Βάσεις της εξειδίκευσης του LLM: Αρχιτεκτονική Transformer και πέραν
Το ταξίδι για την κατανόηση της εξειδίκευσης του LLM ξεκινά με την κατανόηση των θεμελιωδών στοιχείων που συνθέτουν τα LLM. Στο κέντρο αυτών των μοντέλων βρίσκεται η αρχιτεκτονική Transformer, ένα νευρωνικό δίκτυο που χρησιμοποιεί μηχανισμούς αυτο-προσοχής για να δώσει προτεραιότητα στα συμφραζόμενα των λέξεων αντί για την εγγύτητά τους σε μια πρόταση. Αυτή η καινοτόμος προσέγγιση διευκολύνει μια βαθύτερη κατανόηση των μακρινών σχέσεων μεταξύ των token στην είσοδο.
Όταν διερευνούμε τις λεπτομέρειες των Transformer, συναντούμε μια πολυσταδιακή διαδικασία που ξεκινά από τον κωδικοποιητή. Αυτή η αρχική φάση περιλαμβάνει την τοκενοποίηση της εισόδου και τη δημιουργία διανυσμάτων ενσωμάτωσης που αντιπροσωπεύουν την είσοδο και τη θέση της στην πρόταση. Τα επόμενα στάδια περιλαμβάνουν μια σειρά υπολογισμών με πίνακες που ονομάζονται Ερώτηση, Τιμή, και Κλειδί, που οδηγούν σε ένα σκορ αυτο-προσοχής που καθορίζει την εστίαση σε διάφορα τμήματα της πρότασης και τα token.

Αρχιτεκτονική Transformer
Η εξειδίκευση είναι ένα κρίσιμο στάδιο στην ανάπτυξη των LLM, μια διαδικασία που περιλαμβάνει την πραγματοποίηση λεπτών προσαρμογών για να επιτύχει πιο επιθυμητά αποτελέσματα. Αυτό το στάδιο, αν και απαραίτητο, παρουσιάζει μια σειρά από προκλήσεις, συμπεριλαμβανομένων των υπολογιστικών και αποθηκευτικών απαιτήσεων για την αντιμετώπιση ενός μεγάλου αριθμού παραμέτρων. Η εξειδίκευση με αποδοτική χρήση παραμέτρων (PEFT) προσφέρει τεχνικές για να μειώσει τον αριθμό των παραμέτρων που πρέπει να εξειδικευτούν, διευκολύνοντας την εκπαίδευση.
Προ-εκπαίδευση του LLM: Δημιουργία ενός Ισχυρού Βάθρου
Στις αρχικές φάσεις της ανάπτυξης του LLM, η προ-εκπαίδευση παίζει τον κεντρικό ρόλο, χρησιμοποιώντας υπερ-παραμετροποιημένους Transformer ως την θεμελιώδη αρχιτεκτονική. Αυτή η διαδικασία περιλαμβάνει την μοντελοποίηση της φυσικής γλώσσας με διάφορους τρόπους, όπως αμφίδρομη, αυτοπαλινδρομική ή ακολουθία-προς-ακολουθία σε μεγάλης κλίμακας μη-εποπτευόμενα σύνολα δεδομένων. Ο στόχος εδώ είναι να δημιουργηθεί μια βάση που μπορεί να εξειδικευτεί αργότερα για συγκεκριμένες εργασίες με την εισαγωγή εργασιών-ειδικών στόχων.

Προ-εκπαίδευση, Εξειδίκευση
Μια αξιοσημείωτη τάση σε αυτό το πεδίο είναι η αναπόφευκτη αύξηση του μεγέθους των προ-εκπαιδευμένων LLM, μετρημένη από τον αριθμό των παραμέτρων. Εμπειρικά δεδομένα δείχνουν συνεχώς ότι μεγαλύτερα μοντέλα, σε συνδυασμό με περισσότερα δεδομένα, σχεδόν πάντα προσφέρουν καλύτερη απόδοση. Για παράδειγμα, το GPT-3, με τις 175 δισεκατομμύρια παραμέτρους, έχει θέσει ένα πρότυπο στην παραγωγή υψηλής ποιότητας φυσικής γλώσσας και στην εκτέλεση ενός ευρέος φάσματος εργασιών zero-shot με ικανότητα.
Εξειδίκευση: Ο Δρόμος για την Προσαρμογή του Μοντέλου
Μετά την προ-εκπαίδευση, το LLM υποβάλλεται σε εξειδίκευση για να προσαρμοστεί σε συγκεκριμένες εργασίες. παρότι η in-context μάθηση σε προ-εκπαιδευμένα LLM όπως το GPT-3 δείχνει υποσχόμενη απόδοση, η εξειδίκευση παραμένει ανώτερη σε εργασίες-ειδικές ρυθμίσεις. Ωστόσο, η συνηθισμένη προσέγγιση της πλήρους εξειδίκευσης των παραμέτρων παρουσιάζει προκλήσεις, συμπεριλαμβανομένων των υψηλών υπολογιστικών και μνημονικών απαιτήσεων, ιδιαίτερα όταν αντιμετωπίζουμε μεγάλης κλίμακας μοντέλα.
Για μεγάλα γλωσσικά μοντέλα με πάνω από ένα δισεκατομμύριο παραμέτρους, η αποτελεσματική διαχείριση της GPU RAM είναι κρίσιμη. Μία παράμετρος μοντέλου σε πλήρη 32-bit ακρίβεια απαιτεί 4 bytes χώρου, που μεταφράζεται σε μια απαίτηση 4GB της GPU RAM μόνο για να φορτώσει ένα μοντέλο 1 δισεκατομμυρίου παραμέτρων. Η πραγματική διαδικασία εκπαίδευσης απαιτεί ακόμη περισσότερη μνήμη για να φιλοξενήσει διάφορα στοιχεία, συμπεριλαμβανομένων των καταστάσεων του βελτιστοποιητή και των gradient, που δυνητικά απαιτούν μέχρι 80GB της GPU RAM για ένα μοντέλο αυτού του μεγέθους.
Για να αντιμετωπίσουμε τους περιορισμούς της GPU RAM, χρησιμοποιείται η κβαντοποίηση, μια τεχνική που μειώνει την ακρίβεια των παραμέτρων του μοντέλου, μειώνοντας έτσι τις απαιτήσεις μνήμης. Για παράδειγμα, η αλλαγή της ακρίβειας από 32-bit σε 16-bit μπορεί να υποδιπλασιάσει τη μνήμη που απαιτείται για τη φόρτωση και την εκπαίδευση του μοντέλου. Αργότερα σε αυτό το άρθρο, θα μάθουμε για το QLoRA, το οποίο χρησιμοποιεί την κβαντοποίηση για την εξειδίκευση.

Απαιτήσεις μνήμης GPU για LLM σε σχέση με τον αριθμό παραμέτρων και την ακρίβεια
Εξερεύνηση των Κατηγοριών των Μεθόδων PEFT

Στη διαδικασία της πλήρους εξειδίκευσης των Μεγάλων Γλωσσικών Μοντέλων, είναι σημαντικό να έχουμε μια υπολογιστική διάταξη που μπορεί να χειριστεί αποτελεσματικά όχι μόνο τα σημαντικά βάρη του μοντέλου, τα οποία για τα πιο προηγμένα μοντέλα φτάνουν τώρα σε μεγέθη που μετρώνται σε εκατοντάδες γιγαμπάιτ, αλλά και να διαχειριστεί μια σειρά από άλλα κρίσιμα στοιχεία. Αυτά περιλαμβάνουν την κατανομή μνήμης για τις καταστάσεις του βελτιστοποιητή, τη διαχείριση των gradient, των forward activations, και τη διευκόλυνση της προσωρινής μνήμης κατά τη διάρκεια των διάφορων σταδίων της διαδικασίας εκπαίδευσης.
Προσθετική Μέθοδος
Αυτός ο τύπος ρύθμισης μπορεί να αυξήσει το προ-εκπαιδευμένο μοντέλο με πρόσθετες παραμέτρους ή στρώματα, εστιάζοντας στην εκπαίδευση μόνο των νεοεισαχθέντων παραμέτρων. παρότι αυξάνει τον αριθμό των παραμέτρων, αυτές οι μέθοδοι βελτιώνουν την αποτελεσματικότητα του χρόνου και του χώρου. Η προσθετική μέθοδος διαιρείται σε υπο-κατηγορίες:
- Προσαρμογείς: Εισαγωγή μικρών πλήρως συνδεδεμένων δικτύων μετά τα υπο-στρώματα του Transformer, με αξιοσημείωτα παραδείγματα τα AdaMix, KronA, και Compactor.
- Ήπιες Προτροπές (Soft Prompts): Εξειδίκευση ενός τμήματος των διανυσμάτων ενσωμάτωσης εισόδου του μοντέλου μέσω της καθόδου κλίσης, με IPT, prefix-tuning, και WARP ως εξέχουσες περιπτώσεις.
- Άλλες Προσθετικές Προσεγγίσεις: Περιλαμβάνουν τεχνικές όπως LeTS, AttentionFusion, και Ladder-Side Tuning.
Επιλεκτική Μέθοδος
Επιλεκτικές PEFTs εξειδικεύουν έναν περιορισμένο αριθμό των ανώτερων στρωμάτων με βάση τον τύπο του στρώματος και την εσωτερική δομή του μοντέλου. Αυτή η κατηγορία περιλαμβάνει μεθόδους όπως BitFit και LN tuning, οι οποίες εστιάζουν στην εξειδίκευση συγκεκριμένων στοιχείων όπως οι όροι μεροληψίας (biases) του μοντέλου ή συγκεκριμένες γραμμές.
Μέθοδος Βασισμένη στην Επαναπαραμετροποίηση
Αυτές οι μέθοδοι χρησιμοποιούν αναπαραστάσεις χαμηλού βαθμού για να μειώσουν τον αριθμό των παραμετρώσεων που πρέπει να εξειδικευτούν, με την πιο διάσημη να είναι η Low-Rank Adaptation ή LoRA. Αυτή η μέθοδος χρησιμοποιεί μια απλή παραγοντοποίηση πίνακα χαμηλού βαθμού για να παραμετροποιήσει την ενημέρωση του βάρους, αποδεικνύοντας αποτελεσματική εξειδίκευση σε υπο-χώρους χαμηλού βαθμού.
1) LoRA (Χαμηλού Βαθμού Προσαρμογή)
Η LoRA εμφανίστηκε ως μια πρωτοποριακή τεχνική PEFT, που εισήχθη σε ένα έγγραφο από τον Edward J. Hu και άλλους το 2021. Λειτουργεί εντός της κατηγορίας της επαναπαραμετροποίησης, παγώνοντας τα αρχικά βάρη του LLM και ενσωματώνοντας νέους εκπαιδεύσιμους πίνακες χαμηλού βαθμού σε κάθε στρώμα της αρχιτεκτονικής Transformer. Αυτή η προσέγγιση όχι μόνο περιορίζει τον αριθμό των παραμετρώσεων που πρέπει να εξειδικευτούν αλλά επίσης μειώνει τον χρόνο εκπαίδευσης και τους υπολογιστικούς πόρους που απαιτούνται, παρέχοντας μια πιο αποτελεσματική εναλλακτική λύση στην πλήρη εξειδίκευση.
Για να κατανοήσουμε τη μηχανική της LoRA, πρέπει να επανεξετάσουμε την αρχιτεκτονική Transformer, όπου η είσοδος υποβάλλεται σε τοκενοποίηση και μετατρέπεται σε διανύσματα ενσωμάτωσης. Αυτά τα διανύσματα διασχίζουν τον κωδικοποιητή και/ή τον αποκωδικοποιητή του Transformer, συναντώντας μηχανισμούς αυτο-προσοχής και feed-forward δίκτυα των οποίων τα βάρη είναι προ-εκπαιδευμένα.
Η LoRA χρησιμοποιεί την έννοια της Ανάλυσης Ιδιαζουσών Τιμών (SVD). Ουσιαστικά, η SVD διασπάει έναν πίνακα σε τρεις ξεχωριστούς πίνακες, ένας από τους οποίους είναι ένας διαγώνιος πίνακας που περιέχει τις ιδιάζουσες τιμές. Αυτές οι ιδιάζουσες τιμές είναι κρίσιμες, καθώς μετρούν τη σημασία των διαφόρων διαστάσεων στους πίνακες, με μεγαλύτερες τιμές να δείχνουν μεγαλύτερη σημασία και μικρότερες να δείχνουν μικρότερη σημασία.

Ανάλυση Ιδιαζουσών Τιμών (SVD) του m × n πίνακα
Αυτή η προσέγγιση επιτρέπει στην LoRA να διατηρεί τις βασικές ιδιότητες των δεδομένων ενώ μειώνει τη διαστατικότητα, βελτιώνοντας έτσι την διαδικασία της εξειδίκευσης.
Η LoRA παρεμβαίνει σε αυτή τη διαδικασία, παγώνοντας όλες τις αρχικές παραμέτρους του μοντέλου και εισάγοντας ένα ζευγάρι “πινάκων παραγοντοποίησης χαμηλού βαθμού” μαζί με τα αρχικά βάρη. Αυτοί οι μικρότεροι πίνακες, που ονομάζονται A και B, υποβάλλονται σε εκπαίδευση μέσω επιβλεπόμενης μάθησης.
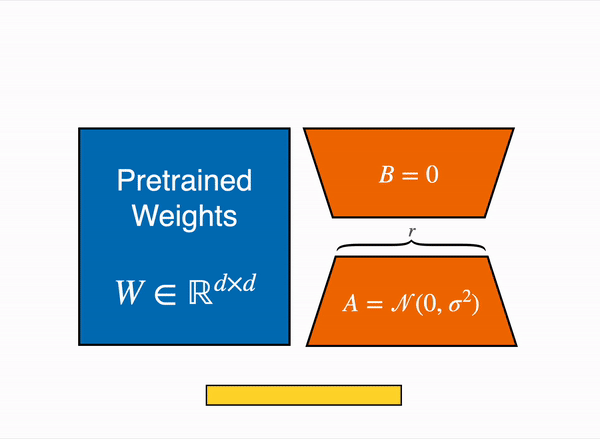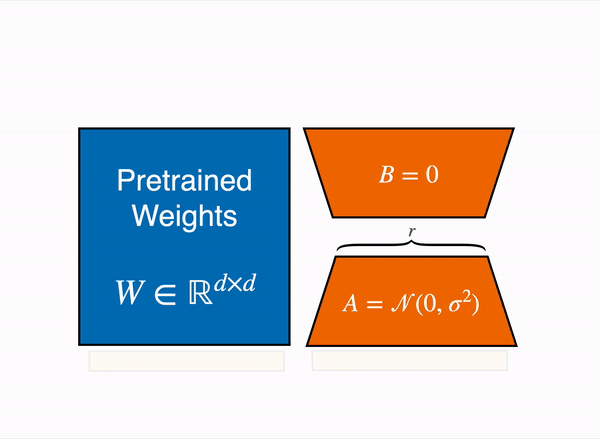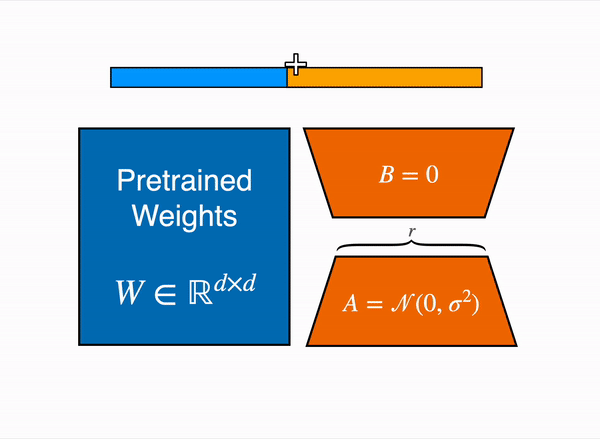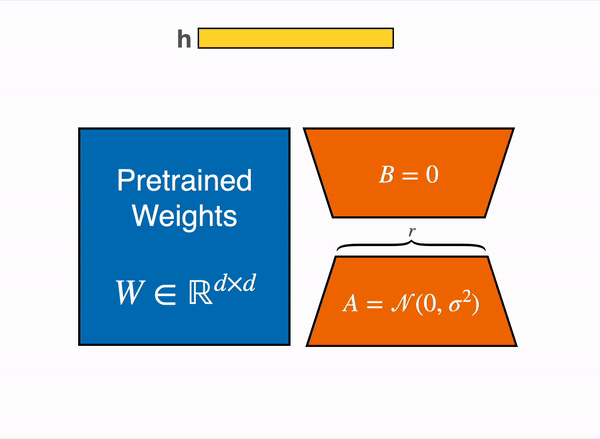
Το κρίσιμο στοιχείο σε αυτή τη στρατηγική είναι η παράμετρος που ονομάζεται βαθμός (‘r’), η οποία καθορίζει το μέγεθος των πινάκων χαμηλού βαθμού. Μια προσεκτική επιλογή του ‘r’ μπορεί να οδηγήσει σε εντυπωσιακά αποτελέσματα, ακόμη και με μια μικρότερη τιμή, δημιουργώντας έτσι έναν πίνακα χαμηλού βαθμού με λιγότερες παραμέτρους για εκπαίδευση. Αυτή η στρατηγική έχει εφαρμοστεί αποτελεσματικά χρησιμοποιώντας ανοιχτές βιβλιοθήκες όπως η HuggingFace Transformers, διευκολύνοντας την εξειδίκευση LoRA για διάφορες εργασίες με αξιοσημείωτη αποτελεσματικότητα.
2) QLoRA: Αυξάνοντας την Αποτελεσματικότητα της LoRA
Βασισμένη στην LoRA, η QLoRA μειώνει ακόμη περισσότερο τις απαιτήσεις μνήμης. Εισαχθείσα από τον Tim Dettmers και άλλους το 2023, συνδυάζει την προσαρμογή χαμηλού βαθμού με κβαντοποίηση, χρησιμοποιώντας μια μορφή κβαντοποίησης 4 bit που ονομάζεται NormalFloat ή nf4. Η quantization είναι ουσιαστικά μια διαδικασία που μεταφέρει δεδομένα από μια υψηλότερη αναπαράσταση πληροφοριών σε μια με λιγότερη πληροφορία. Αυτή η προσέγγιση διατηρεί την αποτελεσματικότητα των μεθόδων εξειδίκευσης 16-bit, αποκβαντίζοντας τα βάρη των 4 bit σε 16-bit όπως απαιτείται κατά τη διάρκεια των υπολογιστικών διαδικασιών.
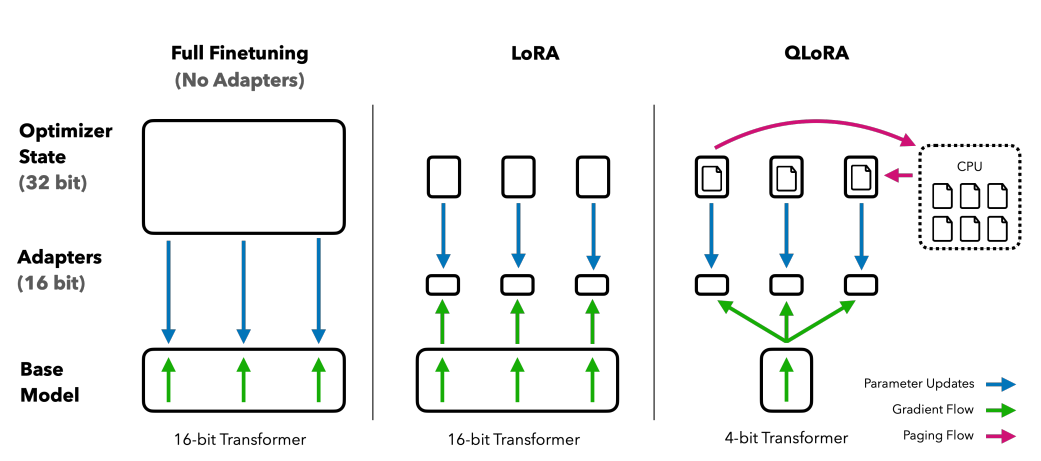
Σύγκριση μεθόδων εξειδίκευσης: QLORA βελτιώνει την LoRA με κβαντοποίηση 4-bit και βελτιστοποιητές με σελιδοποίηση για διαχείριση των αιχμές χρήσης μνήμης
Η QLoRA χρησιμοποιεί NumericFloat4 (nf4), στοχεύοντας κάθε στρώμα της αρχιτεκτονικής Transformer, και εισάγει την έννοια της διπλής κβαντοποίησης για να μειώσει ακόμη περισσότερο το αποτύπωμα μνήμης που απαιτείται για την εξειδίκευση. Αυτό επιτυγχάνεται με την κβαντοποίηση των ήδη κβαντισμένων σταθερών, μια στρατηγική που αποτρέπει τους τυπικούς αιχμές χρήσης μνήμης της κλίσης μέσω της χρήσης βελτιστοποιητές με σελιδοποίηση και ενοποιημένη διαχείριση μνήμης.
Guanaco, το οποίο είναι ένα QLORA-εξειδικευμένο σύνολο, θέτει ένα πρότυπο στις ανοιχτές λύσεις chatbot. Η απόδοσή του, που έχει επικυρωθεί μέσω συστηματικών ανθρώπινων και αυτοματοποιημένων αξιολογήσεων, υπογραμμίζει την υπεροχή και την αποτελεσματικότητά του στο πεδίο.
Οι εκδόσεις 65B και 33B του Guanaco, οι οποίες εξειδικεύτηκαν χρησιμοποιώντας μια τροποποιημένη εκδοχή του OASST1 dataset, εμφανίζονται ως ισχυροί ανταγωνιστές σε μοντέλα όπως το ChatGPT και ακόμη και το GPT-4.
Εξειδίκευση χρησιμοποιώντας Ενισχυτική Μάθηση από Ανθρώπινη Ανατροφοδότηση
Η Ενισχυτική Μάθηση από Ανθρώπινη Ανατροφοδότηση (RLHF) χρησιμοποιείται όταν εξειδικεύουμε προ-εκπαιδευμένα γλωσσικά μοντέλα για να ευθυγραμμιστούμε περισσότερο με τις ανθρώπινες αξίες. Αυτή η έννοια εισήχθη από την Open AI το 2017, θέτοντας τις βάσεις για την βελτίωση της περίληψης εγγράφων και την ανάπτυξη του InstructGPT.
Στην καρδιά της RLHF βρίσκεται το υπόδειγμα της ενισχυτικής μάθησης, ένας τύπος τεχνικής μάθησης όπου ένας πράκτορας μαθαίνει πώς να συμπεριφέρεται σε ένα περιβάλλον εκτελώντας ενέργειες και λαμβάνοντας ανταμοιβές. Είναι ένας συνεχής κύκλος ενέργειας και ανατροφοδότησης, όπου ο πράκτορας ενθαρρύνεται να κάνει επιλογές που θα αποφέρουν την υψηλότερη ανταμοιβή.
Μεταφράζοντας αυτό στο πεδίο των γλωσσικών μοντέλων, ο πράκτορας είναι το το ίδιο το μοντέλο, λειτουργώντας μέσα σε ένα περιβάλλον ενός δεδομένου παραθύρου συμφραζομένων και λαμβάνοντας αποφάσεις με βάση την κατάσταση, η οποία ορίζεται από τα τρέχοντα token στο παράθυρο συμφραζομένων. Ο “χώρος ενεργειών” περιλαμβάνει όλα τα πιθανά token που το μοντέλο μπορεί να επιλέξει, με στόχο την επιλογή του token που ευθυγραμμίζεται περισσότερο με τις ανθρώπινες προτιμήσεις.
Η διαδικασία RLHF αξιοποιεί εκτενώς την ανθρώπινη ανατροφοδότηση, χρησιμοποιώντας την για να εκπαιδεύσει ένα μοντέλο ανταμοιβής. Αυτό το μοντέλο παίζει κρίσιμο ρόλο στη διεύθυνση του προ-εκπαιδευμένου μοντέλου κατά τη διάρκεια της εξειδίκευσης, ενθαρρύνοντας το να παράγει εξόδους που ευθυγραμμίζονται περισσότερο με τις ανθρώπινες αξίες. Είναι μια δυναμική και επαναλαμβανόμενη διαδικασία, όπου το μοντέλο μαθαίνει μέσω μιας σειράς “rollouts”, ένας όρος που χρησιμοποιείται για να περιγράψει την ακολουθία των καταστάσεων και ενεργειών που οδηγούν σε μια ανταμοιβή στο πλαίσιο της παραγωγής γλώσσας.

Μια από τις αξιοσημείωτες δυνατότητες της RLHF είναι η ικανότητά της να προάγει την εξατομίκευση στους βοηθούς AI, προσαρμόζοντάς τους στις προτιμήσεις κάθε χρήστη, είτε πρόκειται για την αίσθηση του χιούμορ του είτε για τις καθημερινές του συνήθειες. Αυτή η τεχνική ανοίγει δρόμους για την δημιουργία AI συστημάτων που δεν είναι μόνο τεχνικά ικανά αλλά και συναισθηματικά ευαίσθητα, ικανά να κατανοούν και να ανταποκρίνονται σε λεπτές αποχρώσεις της ανθρώπινης επικοινωνίας.
Ωστόσο, είναι σημαντικό να σημειωθεί ότι η RLHF δεν είναι μια αλάνθαστη λύση. Τα μοντέλα εξακολουθούν να είναι ευάλωτα στην παραγωγή ανεπιθύμητων εξόδων, μια αντανάκλαση των τεράστιων και συχνά ανεπόπτητων και προκατειλημμένων δεδομένων στα οποία εκπαιδεύονται.
Επίλογος
Η διαδικασία της εξειδίκευσης, ένα κρίσιμο βήμα στην αξιοποίηση του πλήρους δυναμικού των LLM όπως το Alpaca, το Falcon, και το GPT-4, έχει γίνει πιο εξειδικευμένη και εστιασμένη, προσφέροντας προσαρμοσμένες λύσεις σε ένα ευρύ φάσμα εργασιών.
Έχουμε δει την εξειδίκευση για μια εργασία, η οποία εξειδικεύει τα μοντέλα σε συγκεκριμένες εργασίες, και τις μεθόδους Εξειδίκευσης με Αποδοτική Χρήση Παραμέτρων (PEFT) όπως η LoRA και η QLoRA, οι οποίες στοχεύουν να κάνουν την εκπαίδευση πιο αποτελεσματική και οικονομική. Αυτές οι εξελίξεις ανοίγουν πόρτες σε προηγμένες λειτουργίες AI για ένα ευρύτερο κοινό.
Επιπλέον, η εισαγωγή της Ενισχυτικής Μάθησης από Ανθρώπινη Ανατροφοδότηση (RLHF) από την Open AI είναι ένα βήμα προς τη δημιουργία AI συστημάτων που κατανοούν και ευθυγραμμίζονται περισσότερο με τις ανθρώπινες αξίες και προτιμήσεις, θέτοντας το σκηνικό για AI βοηθούς που δεν είναι μόνο έξυπνοι αλλά και ευαίσθητοι στις ανάγκες του κάθε ατόμου. Τόσο η RLHF όσο και η PEFT συνεργάζονται για να ενισχύσουν τη λειτουργικότητα και την αποδοτικότητα των Μεγάλων Γλωσσικών Μοντέλων.
Όπως οι επιχειρήσεις, οι οργανισμοί και τα άτομα προετοιμάζονται να ενσωματώσουν αυτά τα εξειδικευμένα LLMs στις λειτουργίες τους, καλωσορίζοντας ένα μέλλον όπου η τεχνητή νοημοσύνη δεν είναι μόνο ένα εργαλείο αλλά και ένας συνεργάτης που κατανοεί και προσαρμόζεται στο ανθρώπινο πλαίσιο, προσφέροντας λύσεις που είναι καινοτόμες και προσαρμοσμένες στις ανάγκες.


